回归预测 | Matlab实现RIME-CNN-GRU-Attention霜冰优化卷积门控循环单元注意力机制多变量回归预测
目录
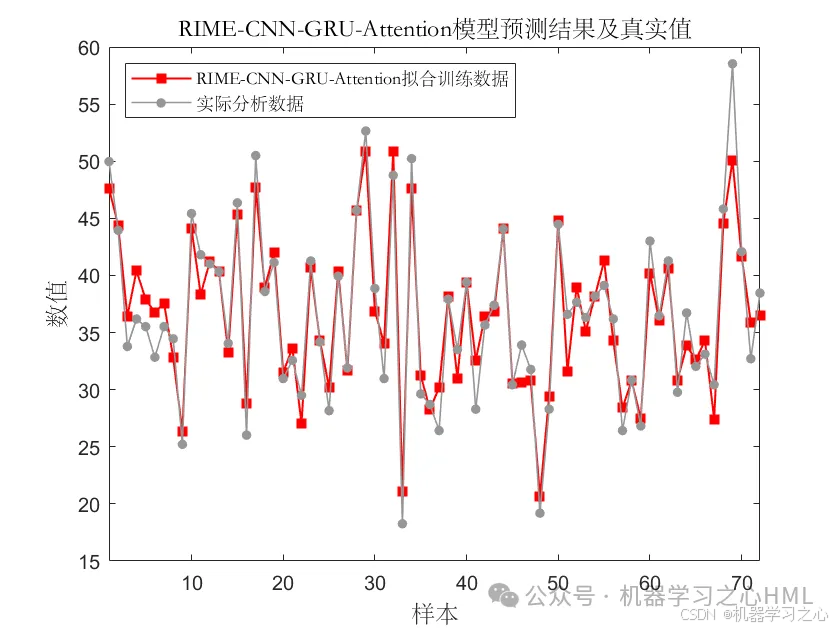
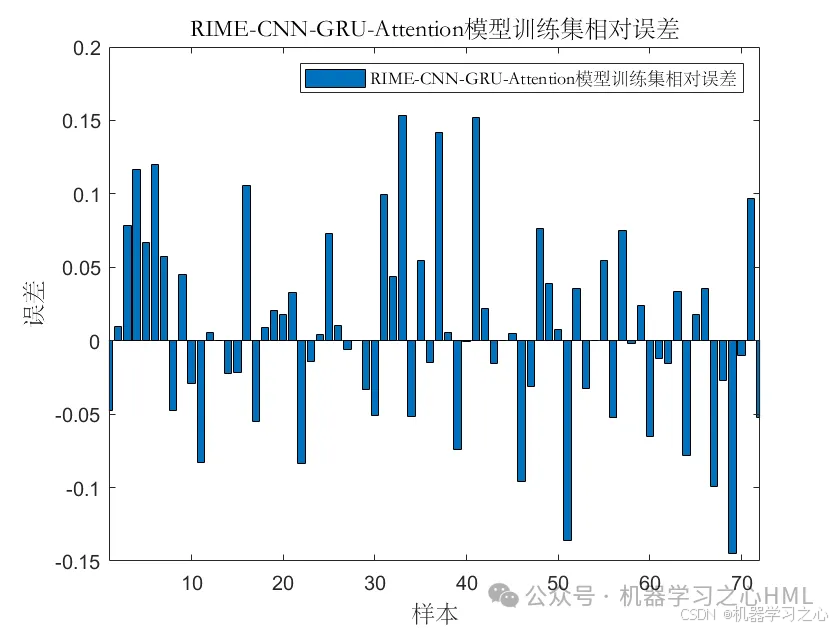
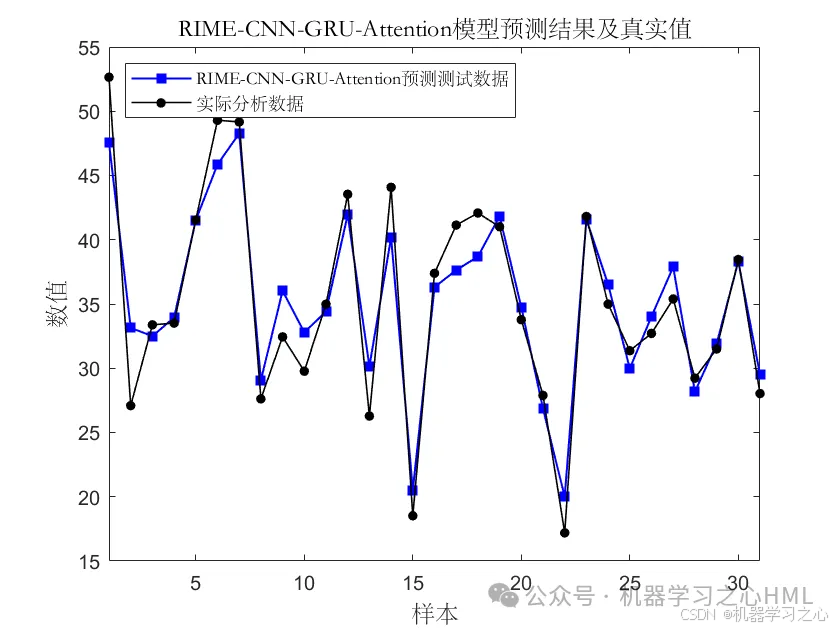
预测效果

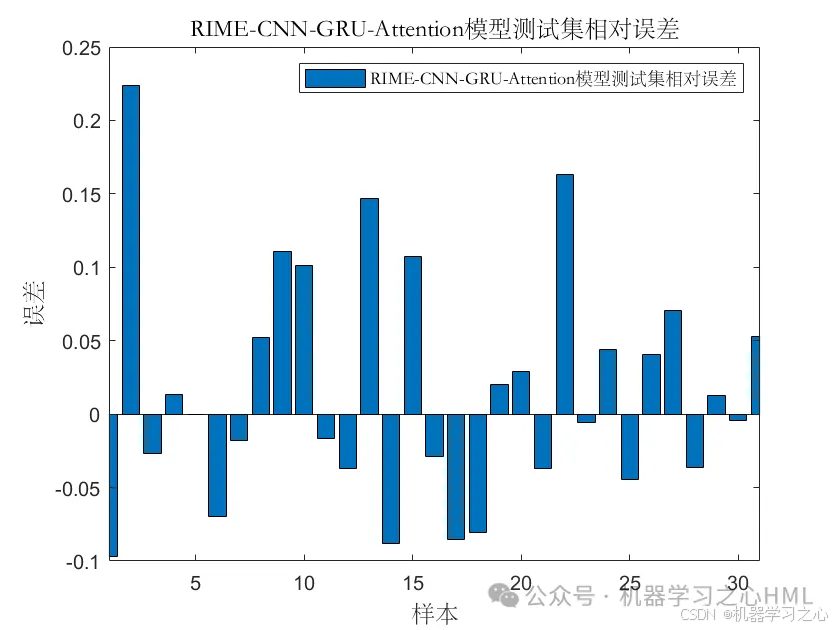
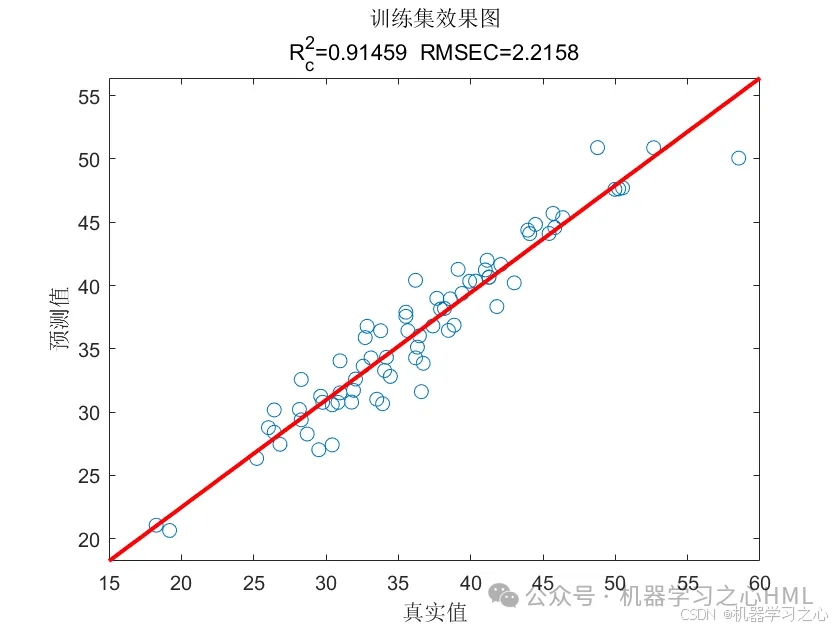
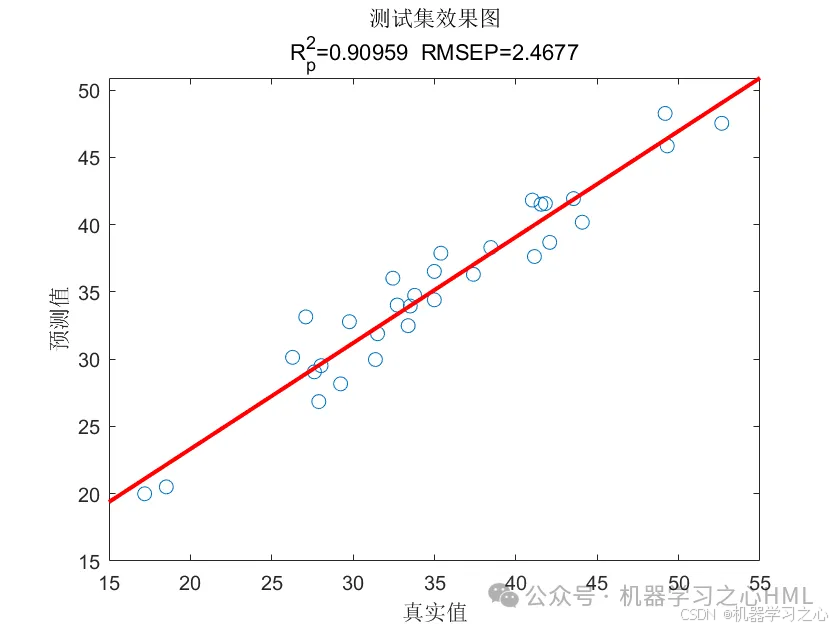
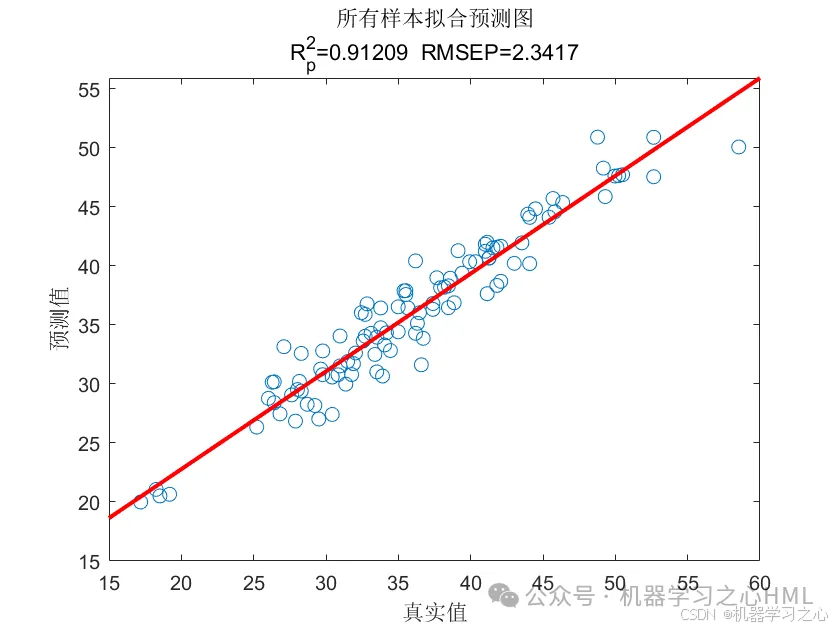
基本介绍
1.Matlab实现RIME-CNN-GRU-Attention霜冰优化卷积门控循环单元注意力机制多变量回归预测;
2.运行环境为Matlab2021b;
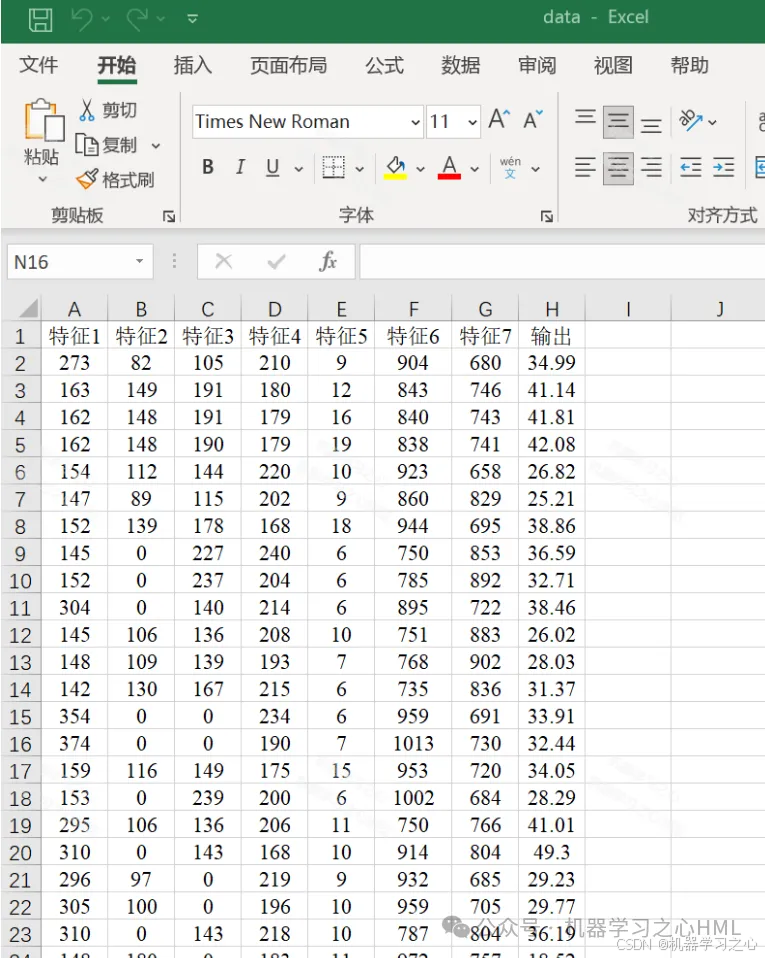
3.data为数据集,excel数据,输入多个特征,输出单个变量,多变量回归预测,
main.m为主程序,运行即可,所有文件放在一个文件夹;
4.命令窗口输出R2、MSE、MAE、MAPE多指标评价;
5.霜冰优化学习率,隐藏层节点,正则化系数;
6.注意力机制模块:
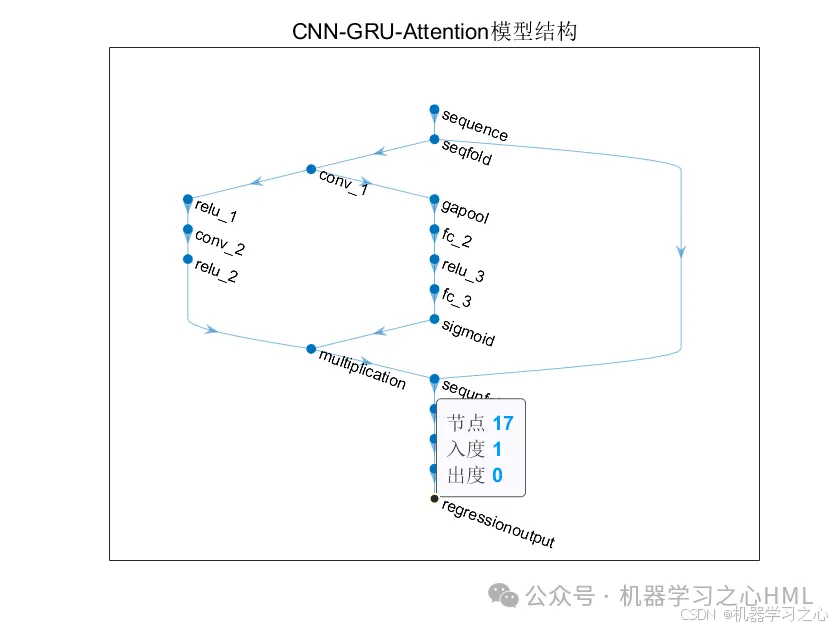
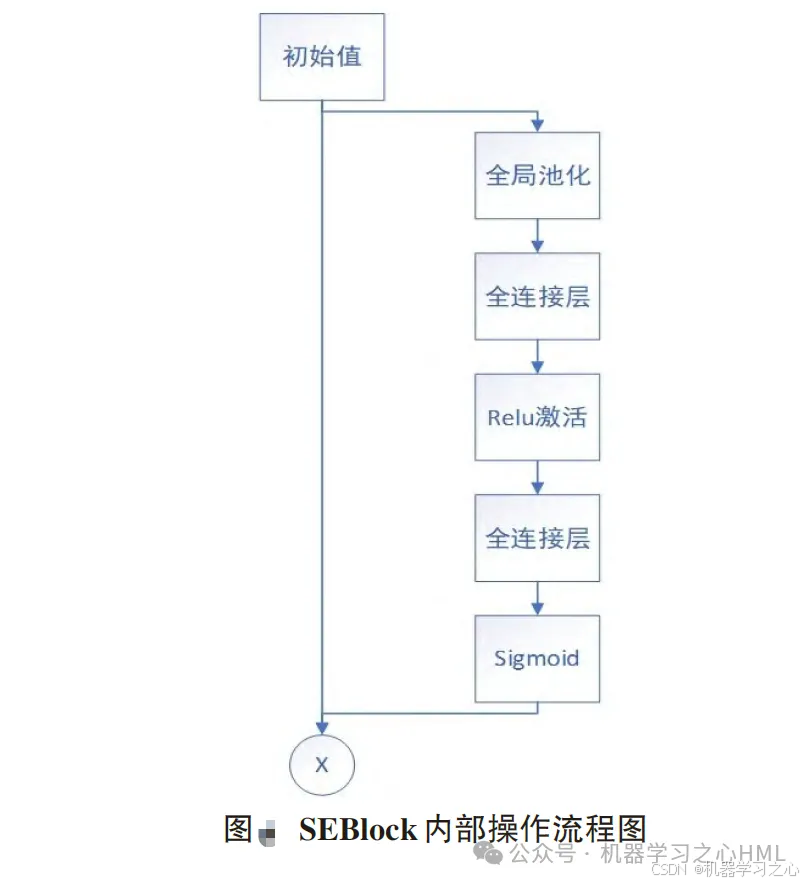
SEBlock(Squeeze-and-Excitation Block)是一种聚焦于通道维度而提出一种新的结构单元,为模型添加了通道注意力机制,该机制通过添加各个特征通道的重要程度的权重,针对不同的任务增强或者抑制对应的通道,以此来提取有用的特征。该模块的内部操作流程如图,总体分为三步:首先是Squeeze 压缩操作,对空间维度的特征进行压缩,保持特征通道数量不变。融合全局信息即全局池化,并将每个二维特征通道转换为实数。实数计算公式如公式所示。该实数由k个通道得到的特征之和除以空间维度的值而得,空间维数为H*W。其次是Excitation激励操作,它由两层全连接层和Sigmoid函数组成。如公式所示,s为激励操作的输出,σ为激活函数sigmoid,W2和W1分别是两个完全连接层的相应参数,δ是激活函数ReLU,对特征先降维再升维。最后是Reweight操作,对之前的输入特征进行逐通道加权,完成原始特征在各通道上的重新分配。
程序设计
- 完整源码和数据获取方式:私信博主回复Matlab实现RIME-CNN-GRU-Attention霜冰优化卷积门控循环单元注意力机制多变量回归预测。
clike
----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
%%  清空环境变量
warning off             % 关闭报警信息
close all               % 关闭开启的图窗
clear                   % 清空变量
clc                     % 清空命令行

%%  导入数据
res = xlsread('data.xlsx');

%%  数据分析
num_size = 0.7;                              % 训练集占数据集比例
outdim = 1;                                  % 最后一列为输出
num_samples = size(res, 1);                  % 样本个数
res = res(randperm(num_samples), :);         % 打乱数据集(不希望打乱时,注释该行)
num_train_s = round(num_size * num_samples); % 训练集样本个数
f_ = size(res, 2) - outdim;                  % 输入特征维度


%%  划分训练集和测试集
P_train = res(1: num_train_s, 1: f_)';
T_train = res(1: num_train_s, f_ + 1: end)';
M = size(P_train, 2);

P_test = res(num_train_s + 1: end, 1: f_)';
T_test = res(num_train_s + 1: end, f_ + 1: end)';
N = size(P_test, 2);
%%  数据归一化
[P_train, ps_input] = mapminmax(P_train, 0, 1);
P_test = mapminmax('apply', P_test, ps_input);

[t_train, ps_output] = mapminmax(T_train, 0, 1);
t_test = mapminmax('apply', T_test, ps_output);


%%  参数设置
options = trainingOptions('adam', ...      % ADAM 梯度下降算法
    'MiniBatchSize', 30, ...               % 批大小,每次训练样本个数30
    'MaxEpochs', 100, ...                  % 最大训练次数 100
    'InitialLearnRate', 1e-2, ...          % 初始学习率为0.01
    'LearnRateSchedule', 'piecewise', ...  % 学习率下降
    'LearnRateDropFactor', 0.5, ...        % 学习率下降因子
    'LearnRateDropPeriod', 50, ...         % 经过100次训练后 学习率为 0.01 * 0.5
    'Shuffle', 'every-epoch', ...          % 每次训练打乱数据集
    'Plots', 'training-progress', ...      % 画出曲线
    'Verbose', false);
参考资料
1 https://blog.csdn.net/kjm13182345320/category_11003178.html?spm=1001.2014.3001.5482
2 https://blog.csdn.net/kjm13182345320/article/details/117378431
3 https://blog.csdn.net/kjm13182345320/article/details/118253644