【图问答】DeepSeek-VL 论文阅读笔记

《DeepSeek-VL: Towards Real-World Vision-Language Understanding》

1. 摘要/引言

基于图片问答(Visual Question Answering,VQA)的任务

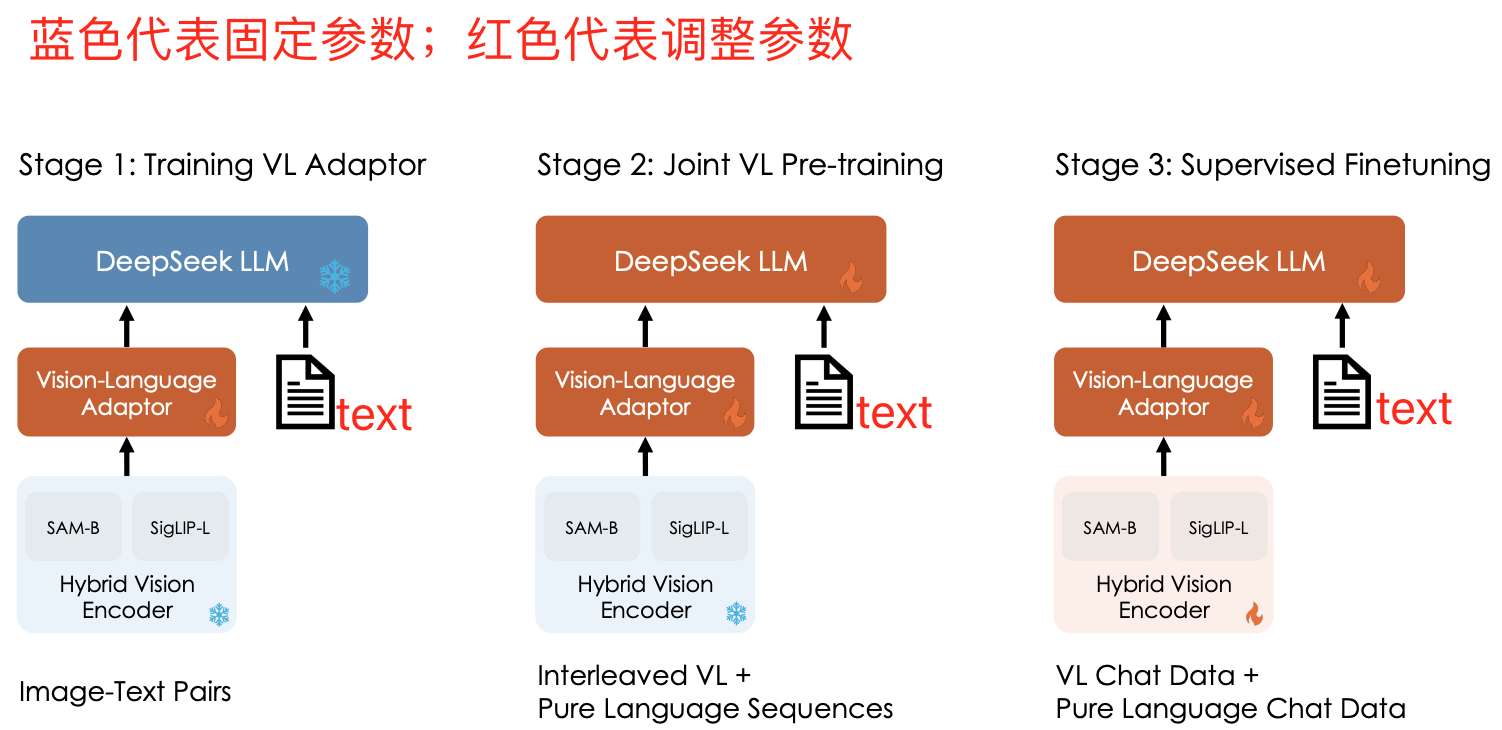
2. 模型结构 和 三段式训练

1)使用 SigLIP 和 SAM 作为混合的vision encoder,也就用的 对比学习 和Segment Anything(有监督学习)的混合vision encoder

2)Vision-Language Adaptor 负责将动态分块后的图像特征转换为语言模型可处理的离散的token-ids
相关推荐
晨间晓15 分钟前
两张图片哪里不一样?用 OpenCV 做图像差异检测工具
人工智能·opencv·计算机视觉
余槐i26 分钟前
Ollama 长文档问答后半段全空:context 默认值与静默截断的代价
性能优化·大模型·api·rag·ollama
酒旅Agent开发实战43 分钟前
10000个MCP Server之后:生态繁荣还是碎片化?
人工智能·大模型·酒店预订·ai agent·mcp
像风一样自由20201 小时前
55.从零搭建一个企业文档问答系统总体架构与技术选型
人工智能·架构·大模型·rag·智能体
波力海苔夹心脆6752 小时前
VisionPro 与 VisionMaster 对比(上):软件定位、开发环境与核心视觉工具对照
图像处理·算法·计算机视觉·c#·视觉检测·个人开发·vp9
richard_yuu2 小时前
OpenCV 实战第 13 篇:工程化收尾,内存拷贝、并行与一条完整流水线
人工智能·opencv·计算机视觉
yunfanleo2 小时前
模型微调(Fine-tuning)详解:原理、Full/LoRA/QLoRA 三种方案对比与 PEFT 工程实践
人工智能·深度学习·机器学习·大模型·人工智能python
语音之家2 小时前
多模态模型的“思考”方式:视觉、通用音频与语音的 CoT 技术路线
人工智能·计算机视觉·语言模型·visual cot
虎鲸不是鱼2 小时前
【虎鲸进化论 02】三阶跃迁:Tab 补全 → Vibe Coding → Agent,人在每一层退到哪里
大数据·人工智能·大模型·llm·自进化agent
爱吃奥利奥_wen2 小时前
机器视觉:九点标定
经验分享·数码相机·计算机视觉