LlamaIndex 生成的本地索引文件和文件夹详解
LlamaIndex 在生成本地索引时会创建一个 storage 文件夹,并在其中生成多个 JSON 文件。以下是每个文件的详细解释:
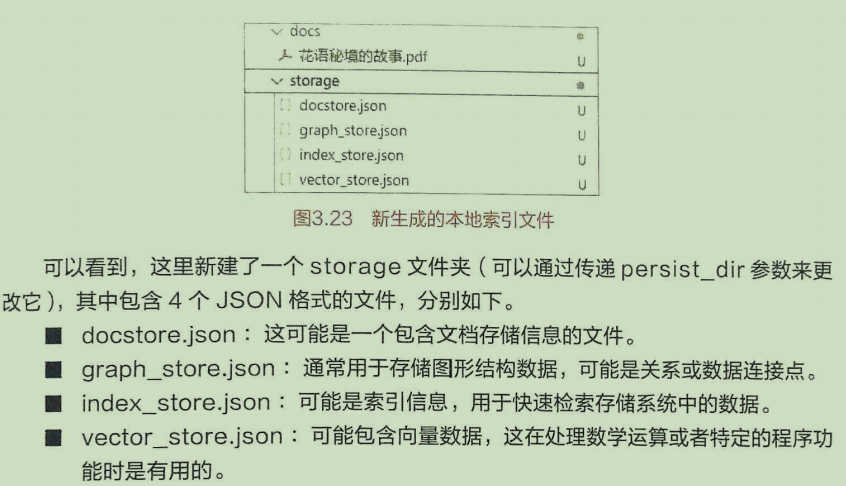
1. storage 文件夹结构
1.1 docstore.json
-
功能:存储文档内容及其相关信息。
-
内容示例:
json{ "doc_id_1": "这是第一个文档的内容。", "doc_id_2": "这是第二个文档的内容。" } -
用途:用于快速检索和访问原始文档内容。
1.2 graph_store.json
-
功能:存储图形结构数据,如节点和边的信息。
-
内容示例:
json{ "nodes": { "node_id_1": {"text": "节点1的内容"}, "node_id_2": {"text": "节点2的内容"} }, "edges": [ {"from": "node_id_1", "to": "node_id_2", "relation": "相关"} ] } -
用途:用于表示文档之间的关系或数据连接点,便于复杂查询。
1.3 index_store.json
-
功能:存储索引信息,加速数据检索。
-
内容示例:
json{ "index_id_1": { "doc_ids": ["doc_id_1", "doc_id_2"], "metadata": {"source": "internal"} } } -
用途:提供高效的数据定位能力,支持快速查找特定文档或片段。
1.4 vector_store.json
-
功能:存储向量数据,用于数学运算或特定功能(如相似度计算)。
-
内容示例:
json{ "vector_1": [0.1, 0.2, 0.3, ...], "vector_2": [0.4, 0.5, 0.6, ...] } -
用途:支持基于向量的检索和分析,如语义搜索、推荐系统等。
2. 文件作用总结
| 文件名 | 功能 | 内容示例 | 主要用途 |
|---|---|---|---|
| docstore.json | 文档存储 | {"doc_id_1": "文档内容1", "doc_id_2": "文档内容2"} |
快速访问原始文档内容 |
| graph_store.json | 图形结构存储 | {"nodes": {...}, "edges": [...]} |
表达文档间关系,支持复杂查询 |
| index_store.json | 索引信息存储 | {"index_id_1": {"doc_ids": [...], "metadata": {...}}} |
加速数据检索,定位特定文档 |
| vector_store.json | 向量数据存储 | {"vector_1": [0.1, 0.2, ...], "vector_2": [0.3, 0.4, ...]} |
支持数学运算和语义搜索 |
3. 实际应用示例
假设我们使用 LlamaIndex 处理一组企业内部文档,以下是各文件的具体应用示例:
场景:企业知识库问答
- docstore.json:存储所有上传的文档内容,如员工手册、项目报告等。
- graph_store.json:记录文档间的引用关系,如某份报告引用了多份标准文档。
- index_store.json:建立文档索引,加快搜索速度,如按部门、关键词分类。
- vector_store.json:存储文档向量,支持语义搜索,如用户提问"去年的财务报告",系统可找到最相关的文档。
4. 注意事项
- 数据安全:存储文件包含敏感信息,需做好权限管理和加密保护。
- 性能优化:大量数据时,合理配置索引和向量存储,避免性能瓶颈。
- 定期更新:文档更新后,及时同步存储文件,保证数据一致性。
5. 总结表格
| 文件名 | 功能 | 内容示例 | 主要用途 | 注意事项 |
|---|---|---|---|---|
| docstore.json | 文档存储 | {"doc_id_1": "文档内容1", "doc_id_2": "文档内容2"} |
快速访问原始文档内容 | 数据安全,定期备份 |
| graph_store.json | 图形结构存储 | {"nodes": {...}, "edges": [...]} |
表达文档间关系,支持复杂查询 | 结构设计合理,避免过度复杂 |
| index_store.json | 索引信息存储 | {"index_id_1": {"doc_ids": [...], "metadata": {...}}} |
加速数据检索,定位特定文档 | 定期更新索引,保持数据一致 |
| vector_store.json | 向量数据存储 | {"vector_1": [0.1, 0.2, ...], "vector_2": [0.3, 0.4, ...]} |
支持数学运算和语义搜索 | 合理配置向量维度,优化存储和计算效率 |
6. 扩展阅读
- LlamaIndex 官方文档:详细了解各组件的高级用法和配置选项。
- 向量数据库 :如 Milvus、Pinecone,可替代
vector_store.json提升大规模数据处理能力。 - 知识图谱技术 :深入研究
graph_store.json的构建和应用,提升复杂关系分析能力。
如果需要更具体的代码示例或应用场景分析,请进一步说明!