1.上传spark安装包到某一台机器(自己在finaShell上的机器)。
2.解压。 把第一步上传的安装包解压到/opt/module下(也可以自己决定解压到哪里)。对应的命令是:tar -zxvf 安装包 -C /opt/module
3.重命名。进入/opt/module/目录下把解压的内容重命名一下。命令是:mv spark-3.1.1-bin-hadoop3.2/ spark-standalone
4.配置环境变量,更新spark路径。命令为:/etc/profile.d/my_env.sh
5.同步环境变量,并使用source命令让它生效。
6.修改 workers.template**文件**。这个文件在spark的安装目录下的conf目录下,先把名字改为workers,然后把内容设置为三台机器的主机名,具体如下。
自己三台机器名字:
hadoop100
hadoop101
hadoop102
7.修改spark-env.sh.template文件 。先把名字改成spark-env.sh,然后修改内容,添加JAVA_HOME环境变量和集群对应的master节点以及通信端口,具体如下。
SPARK_MASTER_HOST=hadoop100(自己所配置下的机器名字)
SPARK_MASTER_PORT=7077
8.同步设置完毕的Spark目录到其他节点。使用我们之前分发的命令:
xsync /opt/module/spark-standalone/
9.启动SPARK集群。进入到hadoop100(自己所配置下的机器名字)机器,切换目录到**/opt/module/spark-standalone/sbin** 下,运行命令 ./start-all.sh。
注意,这里不要省略./,它表示的是当前目录下的start-all命令,如果省略了./,它就会先去环境变量PATH中指定的目录来找这个命令。
10.验收效果。通过jps命令去每台机器上查看运行的进程。请观察是否在hadoop100上看到了master ,worker 在hadoop101,hadoop102上看到了worker。
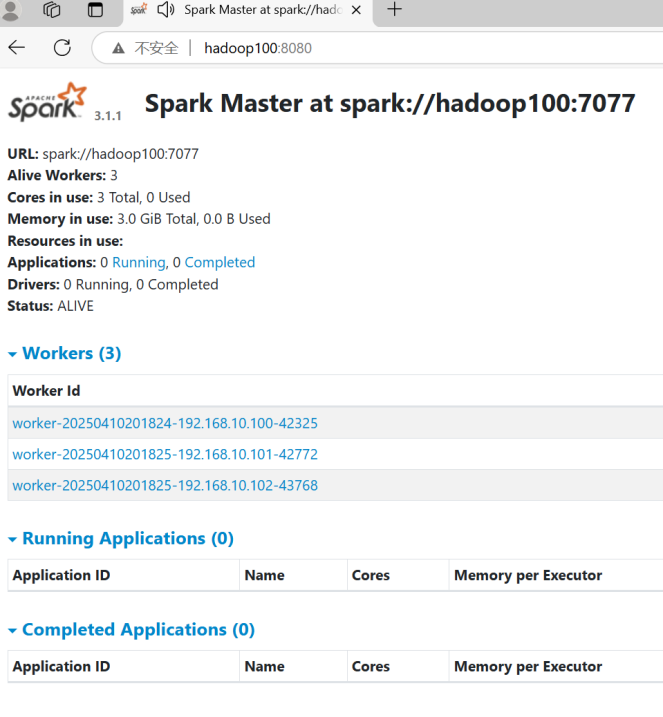
11.查看启动效果。打开浏览器,输入hadoop100:8080。看到效果如下: