一、聚类的概念
根据样本之间的相似性,将样本划分到不同的类别中的一种无监督学习算法。
细节:根据样本之间的相似性,将样本划分到不同的类别中;不同的相似度计算方法,会得到不同的聚类结果,常用的相似度计算方法有欧式距离法。聚类算法的目的是在没有先验知识的情况下,自动发现数据集中的内在结构和模式。计算样本和样本之间的相似性,一般使用欧式距离。
二、聚类算法分类
根据聚类颗粒度分类:细粒度和粗粒度。
根据实现方法分类:
基于划分的聚类:K-means算法->按照质心(一个簇的中心位置,通过均值计算)分类;
基于层次的聚类:DIANA(自顶向下)AGNES(自底向上);
基于密度的聚类: DBSCAN算法
......
三、Kmeans算法流程/原理
K值的含义:表示聚类个数,参数n_clusters就是指定k值的。
API:sklearn.cluster.KMeans
流程:1.事先确定常数k,即最终聚类类别数;
2.随机选择k个样本作为初始聚类中心;
3.计算每个样本到k个中心的距离,选择最近的聚类中心点作为标记类别;
4.根据每个类别中的样本点,重新计算出新的聚类中心点(平均值),如果计算得出的新中心点与原中心点一样则停止聚类,否则重新进行第三步过程,直到聚类中心不在变化或者达到最大迭代次数。
四、聚类评估方法
1.SSE"肘"方法
计算簇内误差的平方和,SSE越小,聚类效果越好
其中:K 表示聚类中心的个数、Ci 表示簇、p 表示样本、mi 表示簇的质心
每次聚类完成要计算SSE,SSE会逐渐变小,变化过程中会出现一个拐点(即下降率突然变缓)认为是最佳n_clusters值。
在决定什么时候停止训练时,肘形判据同样有效,数据通常有更多的噪音,在增加分类无法带来更多回报时,我们停止增加类别。
2.SC轮廓系数
综合考虑簇内的内聚程度与簇间的分离程度,SC越大,聚类效果越好
其中:a是样本i到同一簇内其他不相似程度的平均值(a越小越好);b是样本i到其他簇的平均不相似程度的最小值(b越大越好)
3.CH轮廓系数
综合考虑簇内的内聚程度、簇间的分离程度、质心的个数,CH越大,聚类效果越好
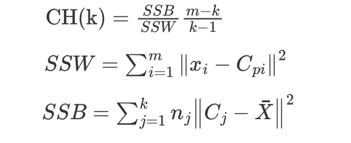
SSW:
Cpi 表示质心、xi 表示某个样本、SSW 值是计算每个样本点到质心的距离,并累加起来、SSW 表示表示簇内的内聚程度,越小越好、m 表示样本数量、k 表示质心个数
SSB:
Cj 表示质心,X 表示质心与质心之间的中心点,nj 表示样本的个数、SSB 表示簇与簇之间的分离度,SSB 越大越好