主要特点:出轨迹是迭代了多次,每次出一条,然后去找和真值最近并且出现最早的轨迹,进行监督。
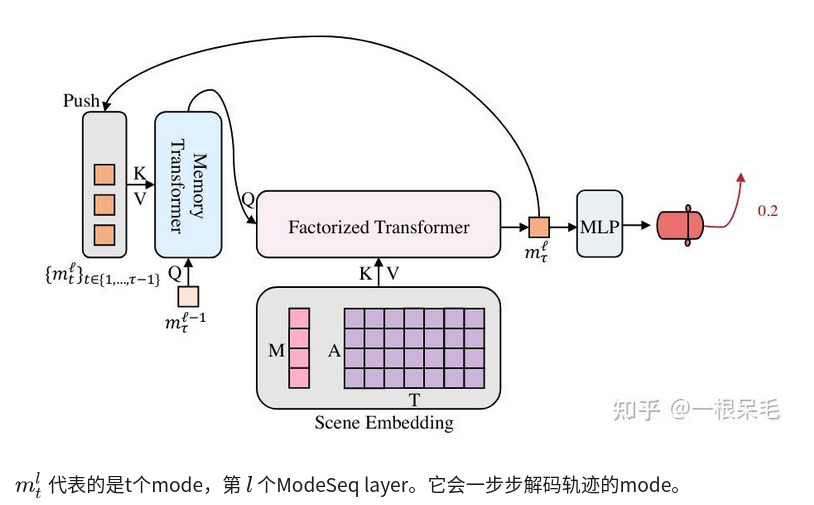 和QCNet一样loss是基于Laplace negative log-likelihood的。传统的WTA的策略只会监督和GT差异最小的那条轨迹。而EMTA策略会监督在RNN结构中找和GT match上的并且是相对更早decode出来的那条轨迹(也就是在RNN结构中认为概率更高的那条)。这里决定是不是match用的是Miss Rate的判定标准。如果没有match上的话,就退回WTA策略。这样就能让model尽早decode出目标的模态,也能提升Miss Rate的表现。
ModeSeq论文阅读
ZHANG8023ZHEN2025-08-03 13:15
相关推荐
天树星智源5 天前
记忆该记「赔率跳变」:机器人长时程十连任务,事件记忆 88.0%,删掉失败记录只剩 1.7%XLYcmy6 天前
ASR 识别任务:两篇论文阅读分析与系统方案技术报告 当前报告的建议和改进方向XLYcmy7 天前
ASR 识别任务:两篇论文阅读分析与系统方案技术报告 当前报告不足feasibility.8 天前
LeCun团队世界模型JEPA首登无人机:9K参数模型,零样本Sim-to-Real飞入100Hz闭环XLYcmy8 天前
ASR识别任务两篇论文阅读分析与系统方案技术报告 上Zucker n9 天前
文献发现、课题组织与证据可追溯的论文阅读。西柚小萌新9 天前
【论文阅读】--可信LLM智能体的威胁与对策 综述Rocky Ding*9 天前
【三年面试五年模拟】2026-11-05_月之暗面大模型算法岗一面、二面面经全解析Rocky Ding*11 天前
REPA-E技术深度解析:解冻 VAE 之后,扩散模型为什么需要选择梯度Rocky Ding*12 天前
【三年面试五年模拟】2026-11-01_字节跳动AI Agent全栈研发一面面经全解析