香橙派 RK3588 部署千问大模型 Qwen2-VL-2B 推理视频

演示视频

香橙派RK3588部署千问大模型Qwen2-VL-2B推理视频

一、场景假设

视频输入为一条网络流,利用大模型对视频中的图像帧进行推理。由于大模型推理耗时长,无法对每帧都进行推理,因此采用跳帧推理的方式:当推理完一帧后,期间会跳过若干帧,然后立即推理最新的一帧。

二、处理流程

1. 拉流

  • 使用 ffmpeg 拉取 rtsp 流,进行解封装得到 h264。

  • 为保证传输稳定,配置为 rtsp over tcp。

2. 视频解码

通过 mpp 解码 h264,得到 nv12 图像。

3. 图像转换

利用 rga 将 nv12 图像进行放缩和转 rgb 操作,此过程采用 letterbox 方式,主要目的是保持宽高等比放缩。

4. 图像编码

使用 rknn 将 rgb 图像编码成大模型能够理解图像所用的图像向量。

5. 推理

借助 rknn 将提示词和图像向量输入大模型进行推理,推理结果直接打印出来。

6. 渲染

将用于推理的图像(即图像编码前的图像),通过 qt 适配 qwidget 和 opengles 的方式进行渲染。

三、使用模型

  • Qwen2-VL-2B_llm_w8a8_rk3588.rkllm

  • Qwen2-VL-2B_vision_rk3588.rknn

四、主要耗时

  • 图像编码模型加载:5s

  • 大模型加载:7s

  • 图像编码:3s

  • 大模型推理:5s

注意:模型加载仅在程序开始时进行一次即可。

五、资源占用

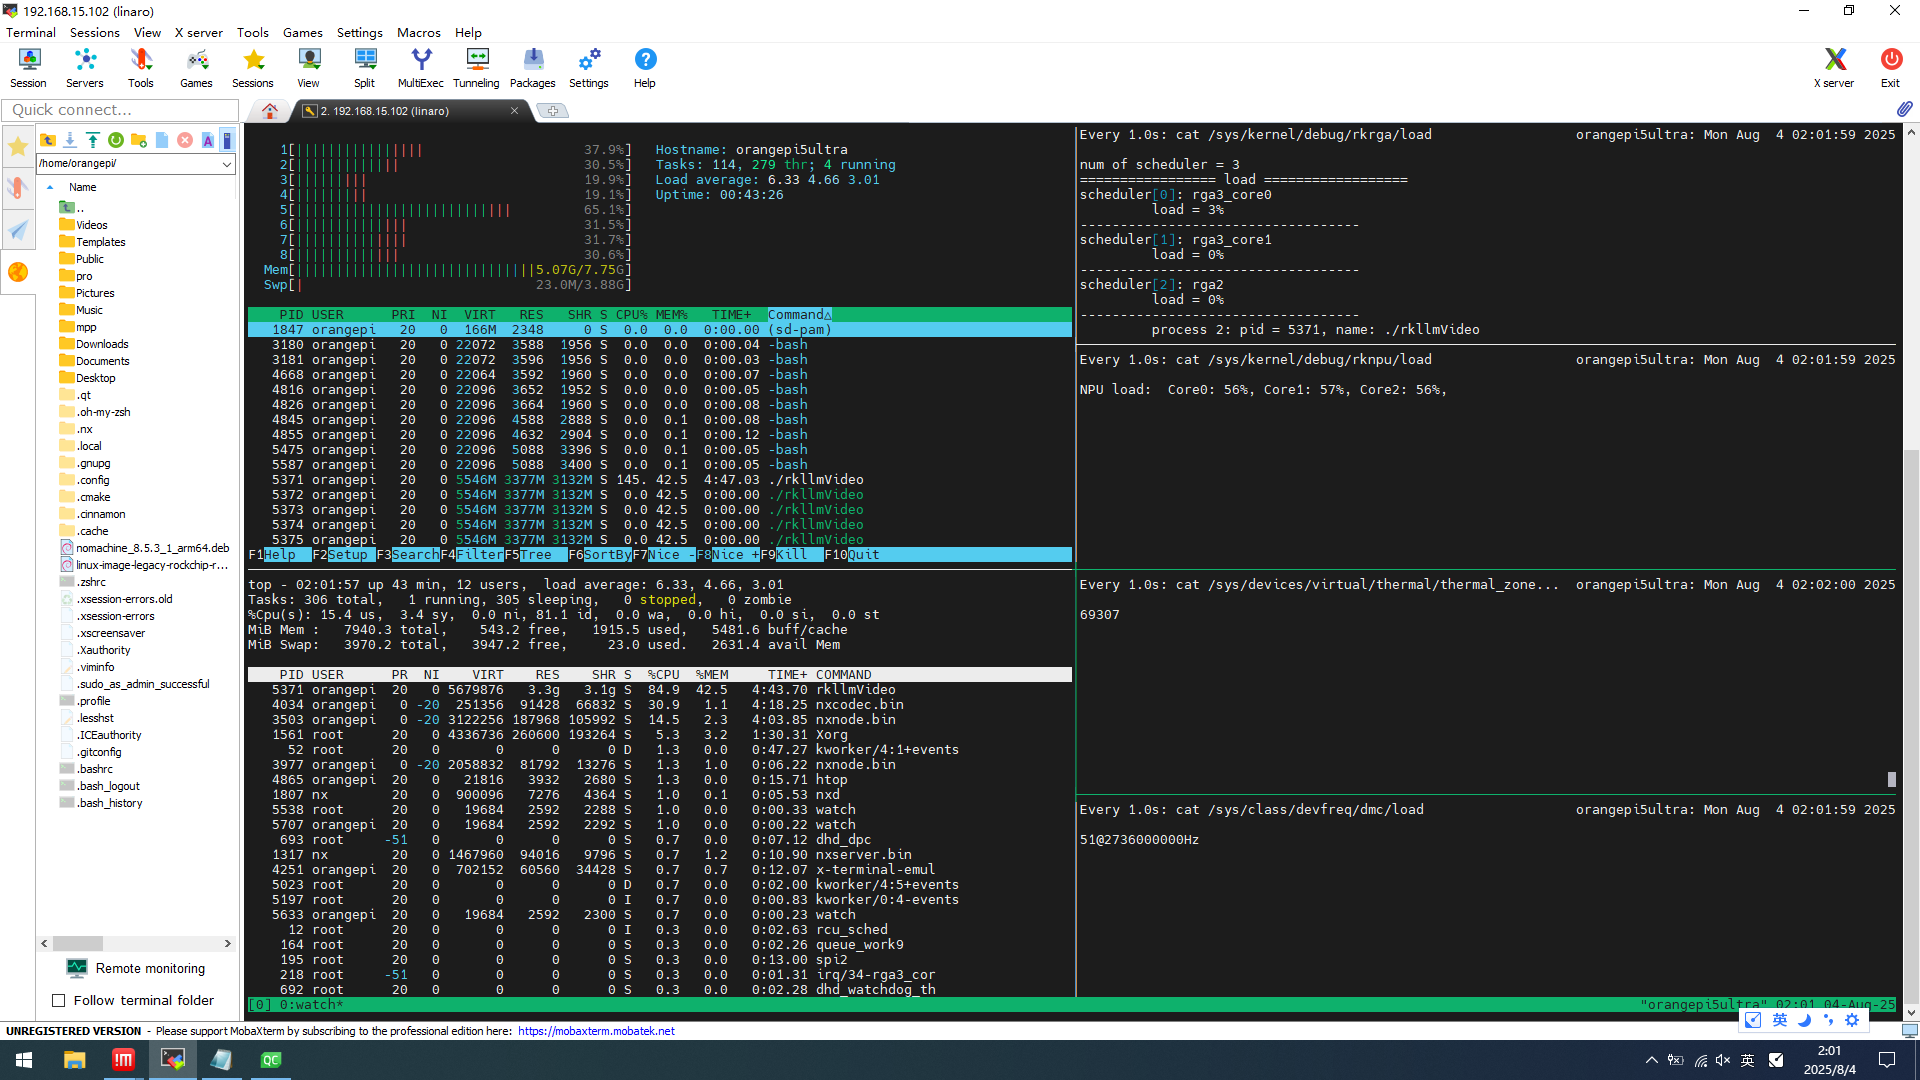
  • CPU:145%(满载 800%)

  • 内存:5GB

  • NPU:50%~99%

  • 温度:69℃

相关推荐
一起学安全技术1 天前
拆大模型 11|大模型面试拷问:12 问逐层拆
人工智能·ai·语言模型·面试·职场和发展·求职招聘
学无止境小袁同学1 天前
LangGraph 深度指南
语言模型·框架·agent·并发·上下文·langgraph·长期记忆
the3clipse1 天前
Windows 11 26H2 声音与音频问题排查指南:没声音、麦克风不收音与蓝牙音频优化
音视频·le audio·windows 11 26h2·win11没声音·麦克风没声音·蓝牙耳机音质·音频服务修复
一起学安全技术2 天前
拆大模型 10|结构化输出:让模型返回数据,而不是一段话
人工智能·语言模型·json
开开心心就好2 天前
PDF水印怎么去掉?勾选对象再点匹配
java·前端·mysql·支持向量机·pdf·音视频·模拟退火算法
RobinDevNotes2 天前
Claude Code 剪视频,不上传、不要 API Key
人工智能·python·音视频·开发工具·ipython
伯奥克客服2 天前
2026年视频综合一体机架构选型:从接口协议到流媒体底层的深度技术解析
架构·音视频
开开心心就好3 天前
两张表格数据对比工具,不用写函数也能查
算法·spring·智能手机·pdf·电脑·intellij-idea·音视频
FansAI_art3 天前
多角色 AIGC 短片的双模型分工:静态生图与图生视频怎么接
aigc·音视频
Dawson Zhu4 天前
【分布式训练⑧】通信优化:NCCL、Ring AllReduce与计算通信重叠
人工智能·语言模型·架构·aigc·agi