一句话总结------"所有架构都为了解决上一代模型的致命缺陷而生:CNN 解决参数爆炸,ResNet 解决梯度消失,Transformer 解决 RNN 无法并行,而 Mamba 则试图一次解决 Transformer 的 O(N²) 与 RNN 的记忆瓶颈。"
1 每种架构的存在理由
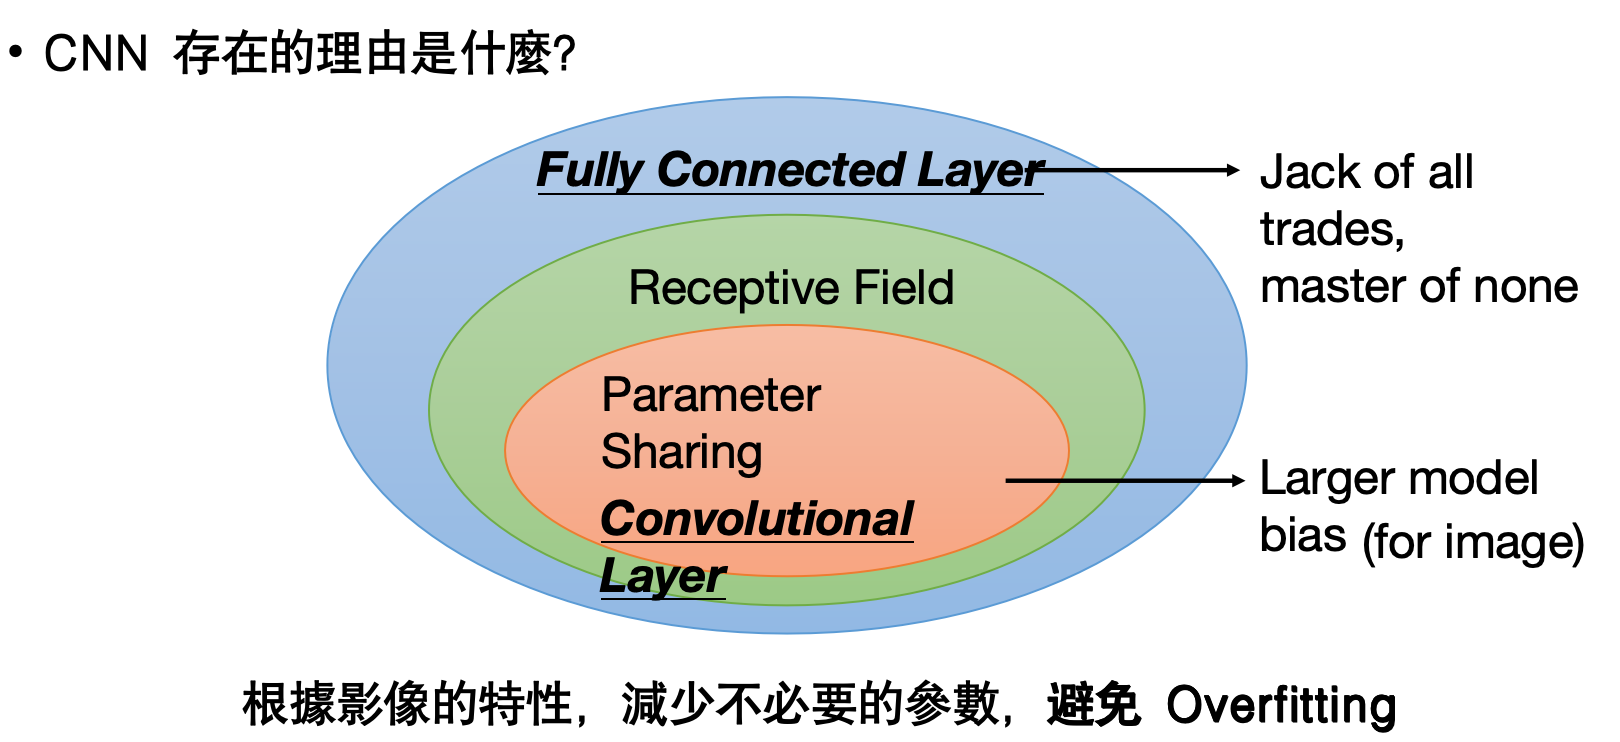
• CNN:局部感受野+参数共享→图像任务参数量骤降,避免过拟合。
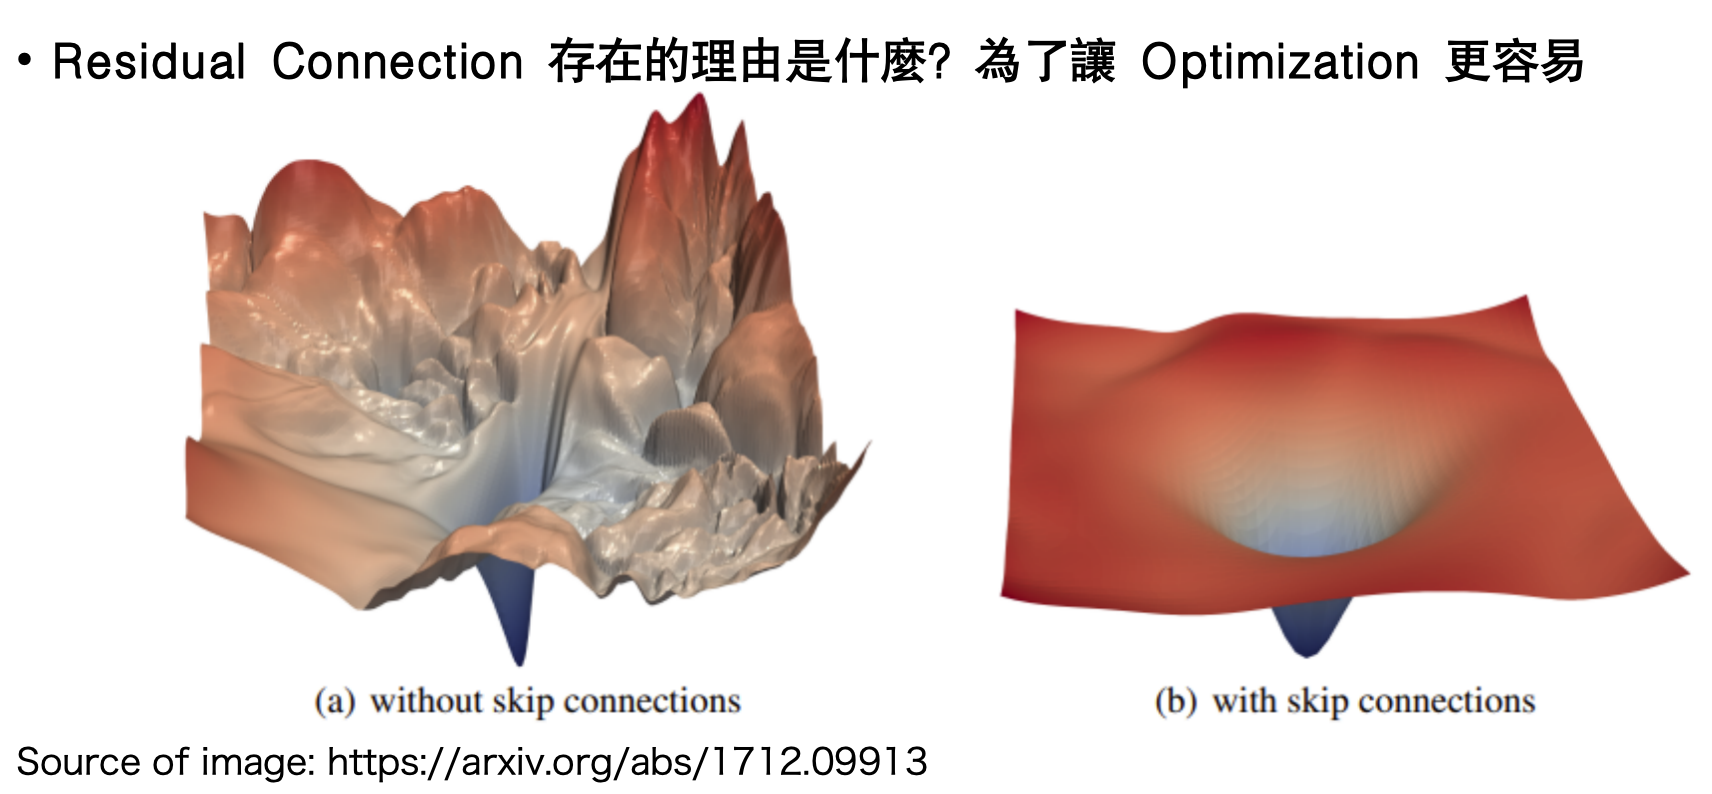
• Residual:跳跃连接→平滑损失曲面,让深层网络可训练。
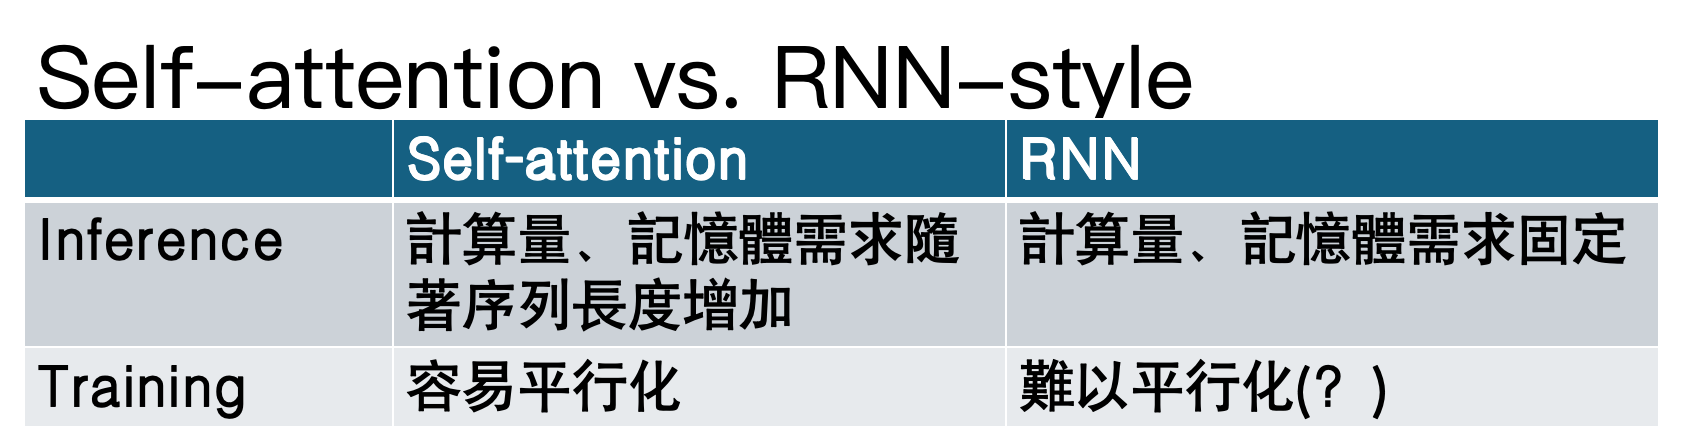
• Transformer:用 Self-Attention 替代 RNN,实现训练期并行化。
2 从 RNN 到 Transformer:为什么改朝换代
1)RNN 的痛点
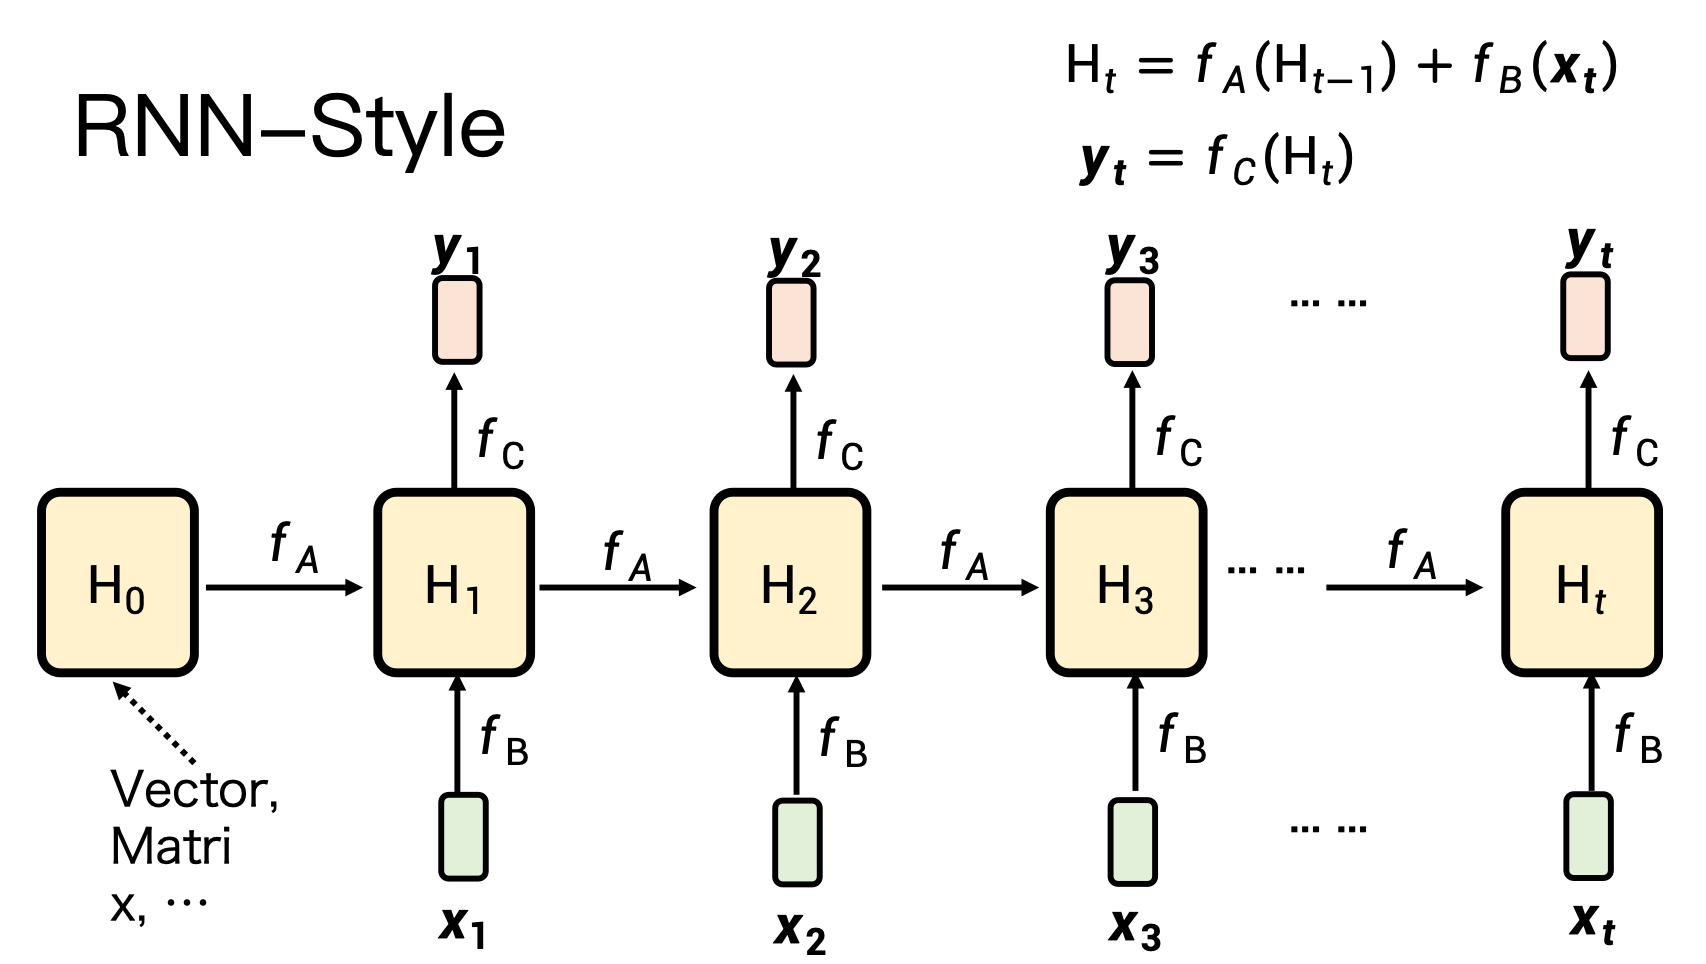
-- 顺序计算:时间步 t 必须等 t-1,训练无法并行。
-- 记忆有限:隐状态维度固定,长序列信息丢失。
2)Self-Attention 的卖点
-- 并行:所有位置一次性计算,GPU 友好。
-- 长程依赖:任意两位置直接相连,信息无损。
代价:推理时 O(N²) 计算/显存随长度爆炸。
self-attention: 并行,一次性给出输出
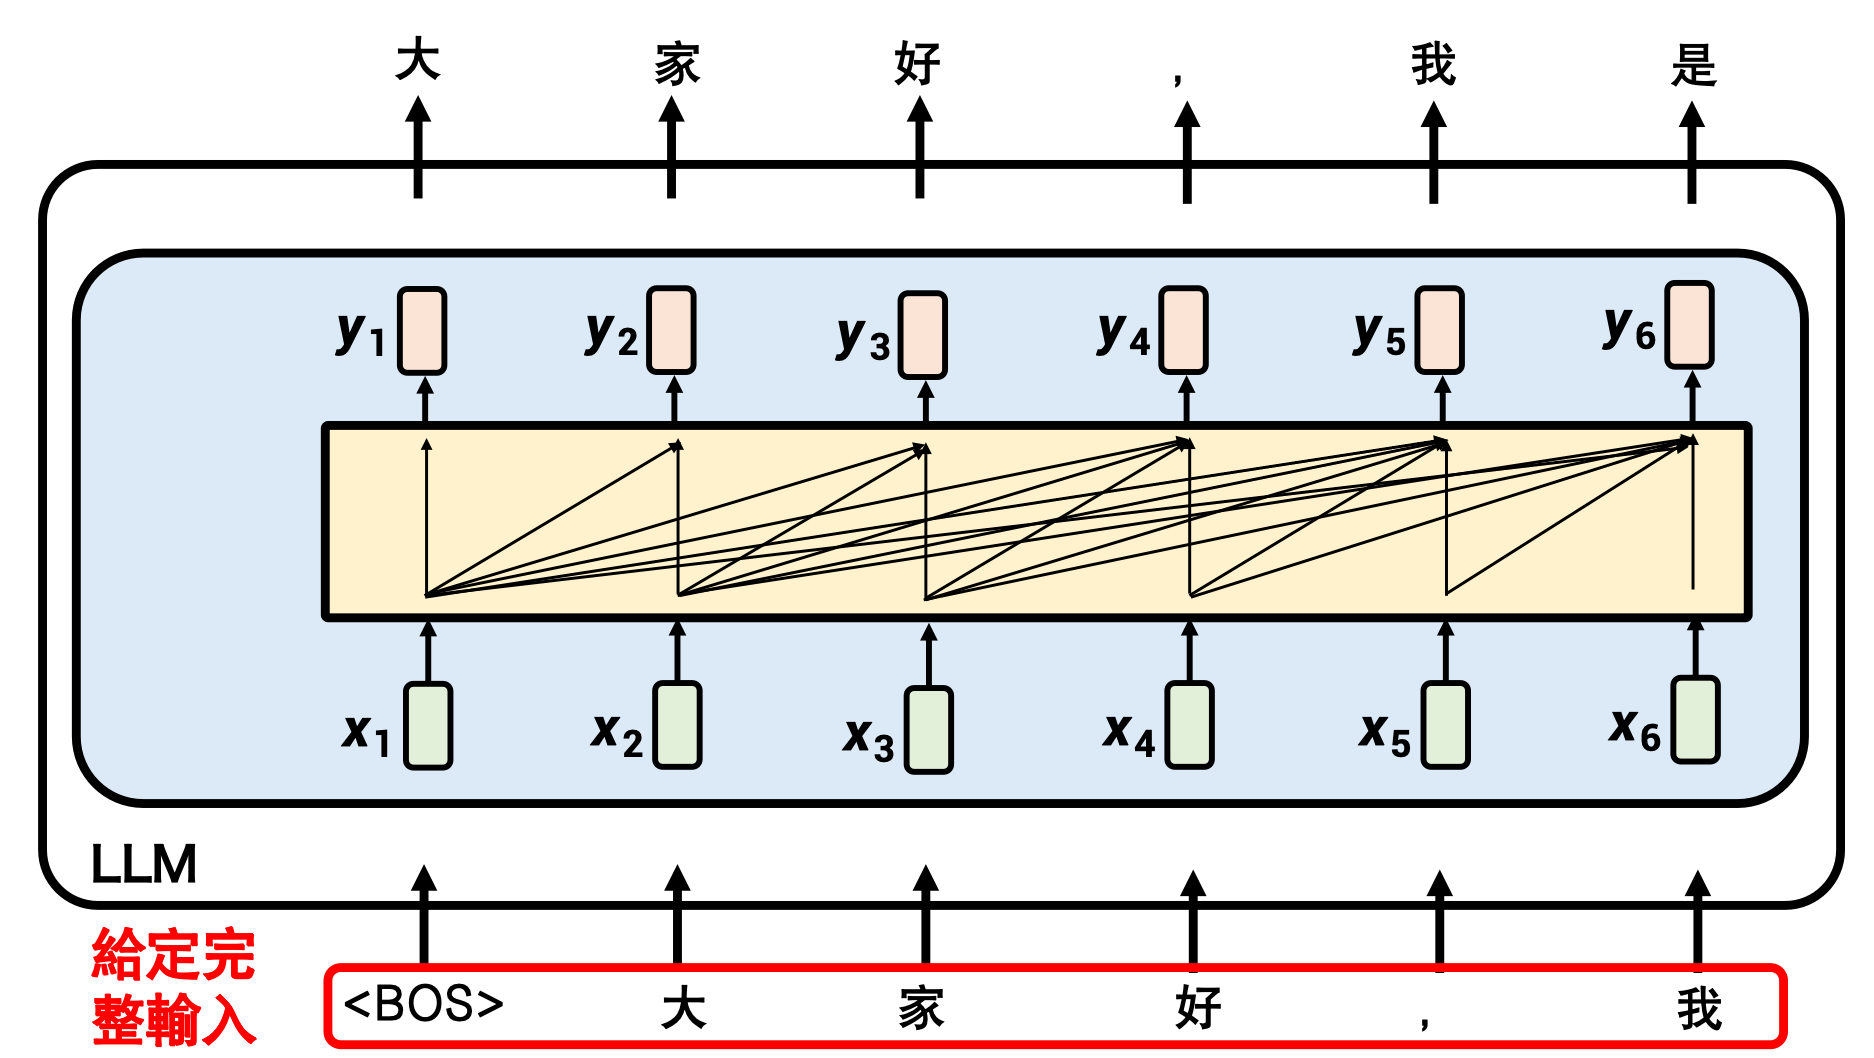
3 绕不过去的 O(N²):Linear Attention
Linear Attention就是没有softmax的Self-attention
把 softmax(QK^T)V 拆成 (Q(K^T V)),复杂度降到 O(N)。
训练并行,推理像 RNN:一路累加 KV 状态即可。
问题:无 softmax 的"归一化"→记忆权重永不更新,长序列"记忆错乱"。
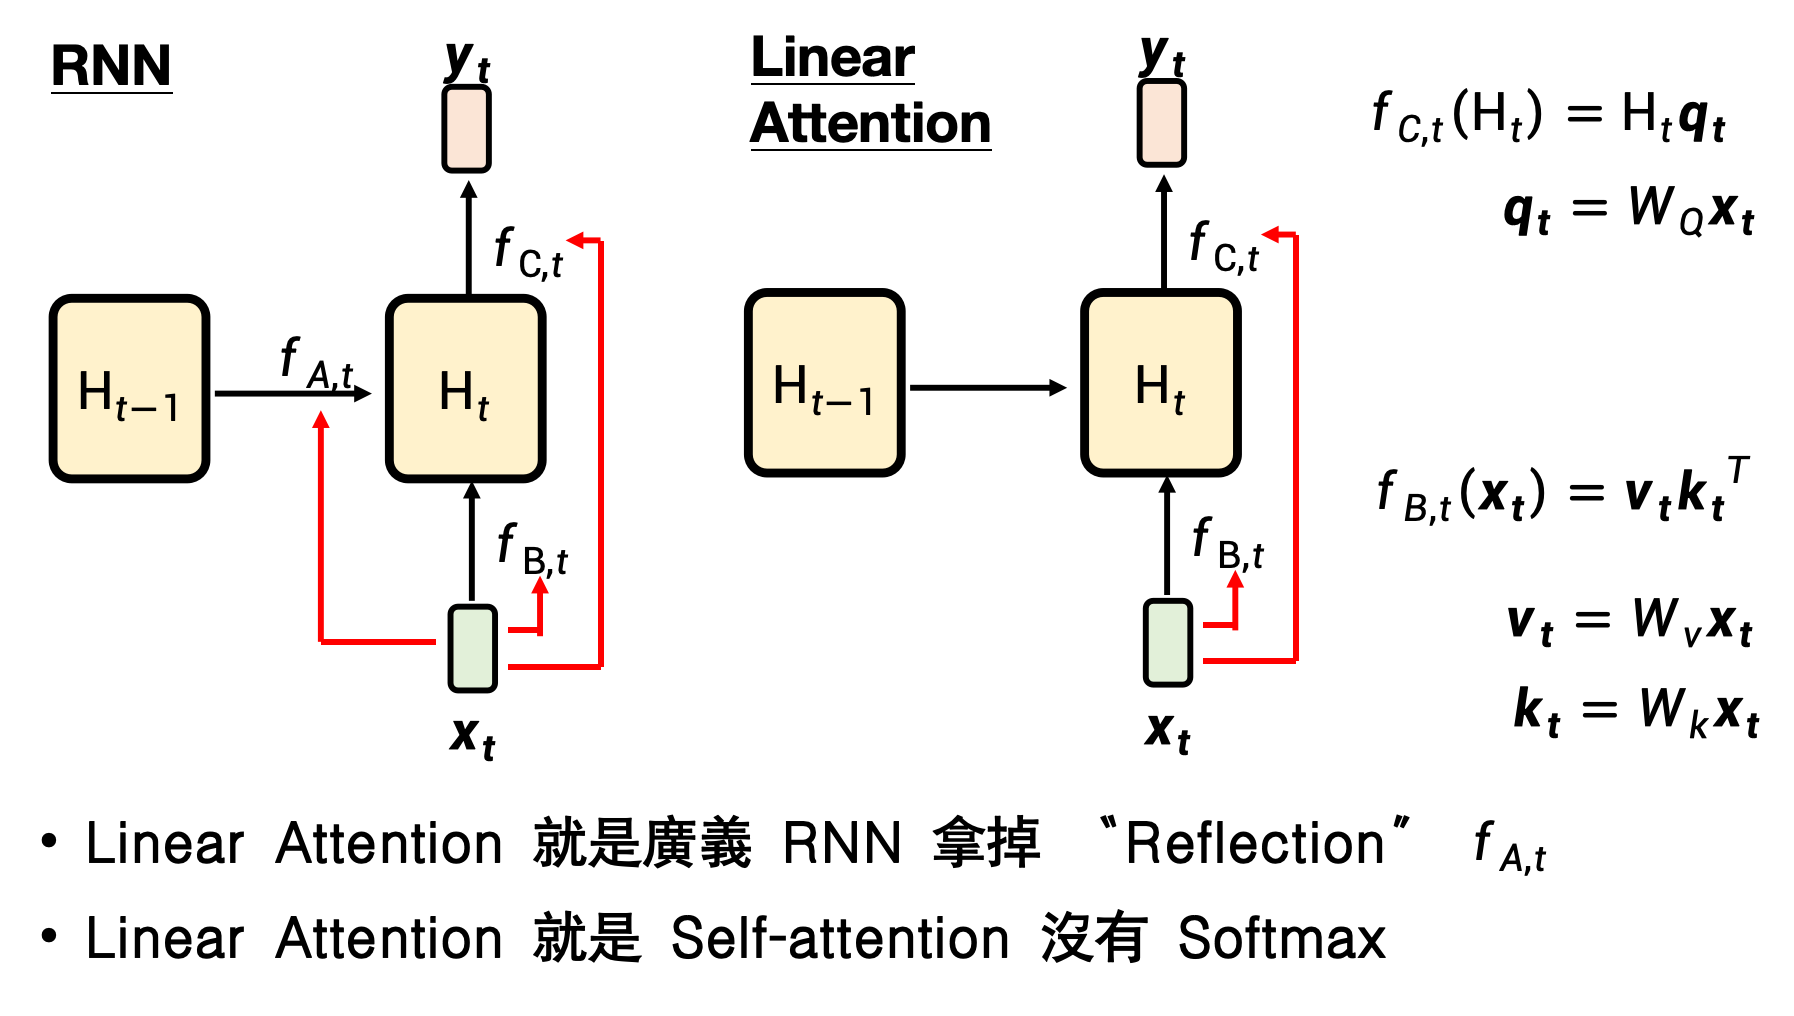
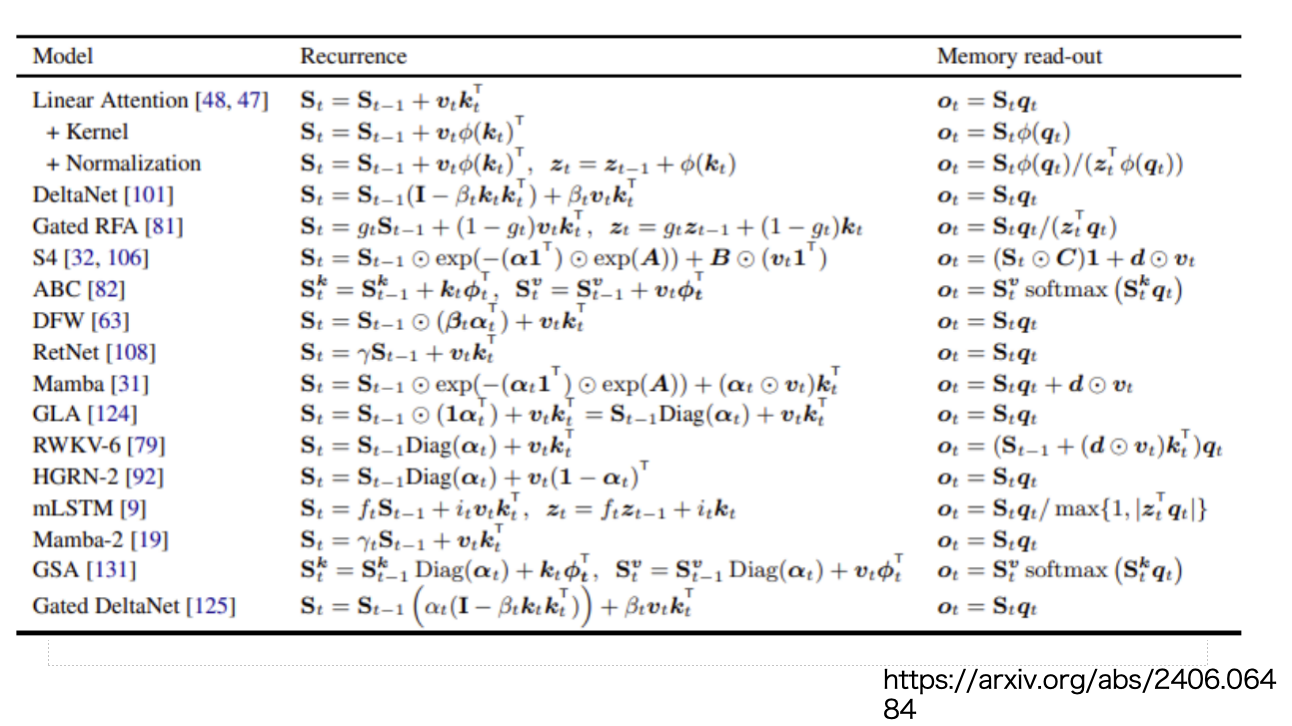
4 "可遗忘"的线性注意力 → RetNet / Gated Retention / DeltaNet
在线性注意力外再加"遗忘门"或"衰减因子",让旧记忆逐渐淡出;效果逼近 Transformer,推理仍是 RNN 形式。
5 新架构候选:Mamba(及其朋友)
核心创新
-
选择性状态空间模型(Selective SSM):让 B,C,Δ 随输入动态变化,实现"内容感知"的读写与遗忘。
-
硬件感知并行算法:扫描(Scan)+ Kernel Fusion,在 GPU 上实现训练期并行、推理期恒定显存。
结果:
-- 训练并行度 ≈ Transformer
-- 推理 O(N) 计算 + O(1) 显存
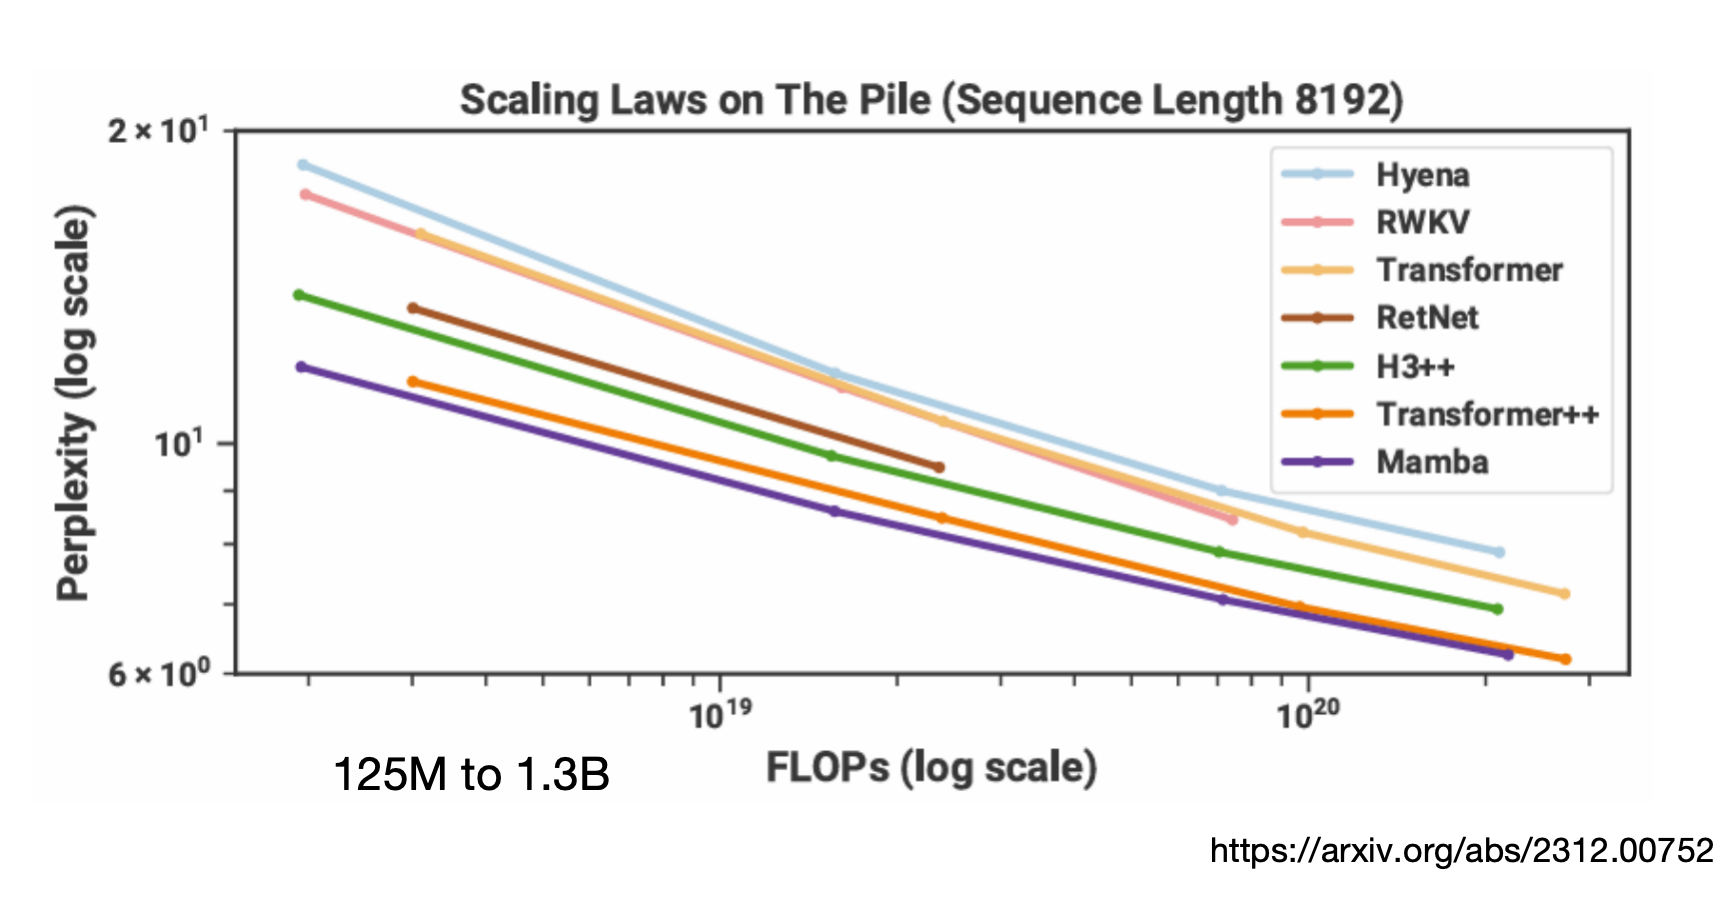
-- 在 1B-7B 规模已追平或超越同尺寸 Transformer(如下图)
6 课程彩蛋 & 延伸
• "MambaOut:视觉任务真需要 Mamba 吗?"------论文结论:不一定。
• "Do not train from scratch"------把现成 Llama 权重蒸馏进 Mamba,节省算力。
• 最新竞技场:Minimax-01、Titans 等继续探索"测试时记忆"与混合架构。
• 一个赌局:到2027年1月,transformer的架构还会是最佳模型的架构吗?
给工程师的 3 句 memo
-
Transformer 仍是通用王者,但长序列场景(语音、视频、RAG)先看 Mamba 类模型。
-
训练期并行 + 推理期 O(1) 显存是终极卖点,适合边缘部署。
-
暂时不要从零训 Mamba;先用 LoLCATs、Linger 等蒸馏方案"白嫖"现成权重。
--------叠甲--------
本篇课程博主也听得一知半解,如有记得不对的地方欢迎指正