总目录 大模型相关研究:https://blog.csdn.net/WhiffeYF/article/details/142132328
https://aclanthology.org/2023.acl-long.837/
速览
ACL 2023论文:会议记录问答新突破,挑战NLP极限
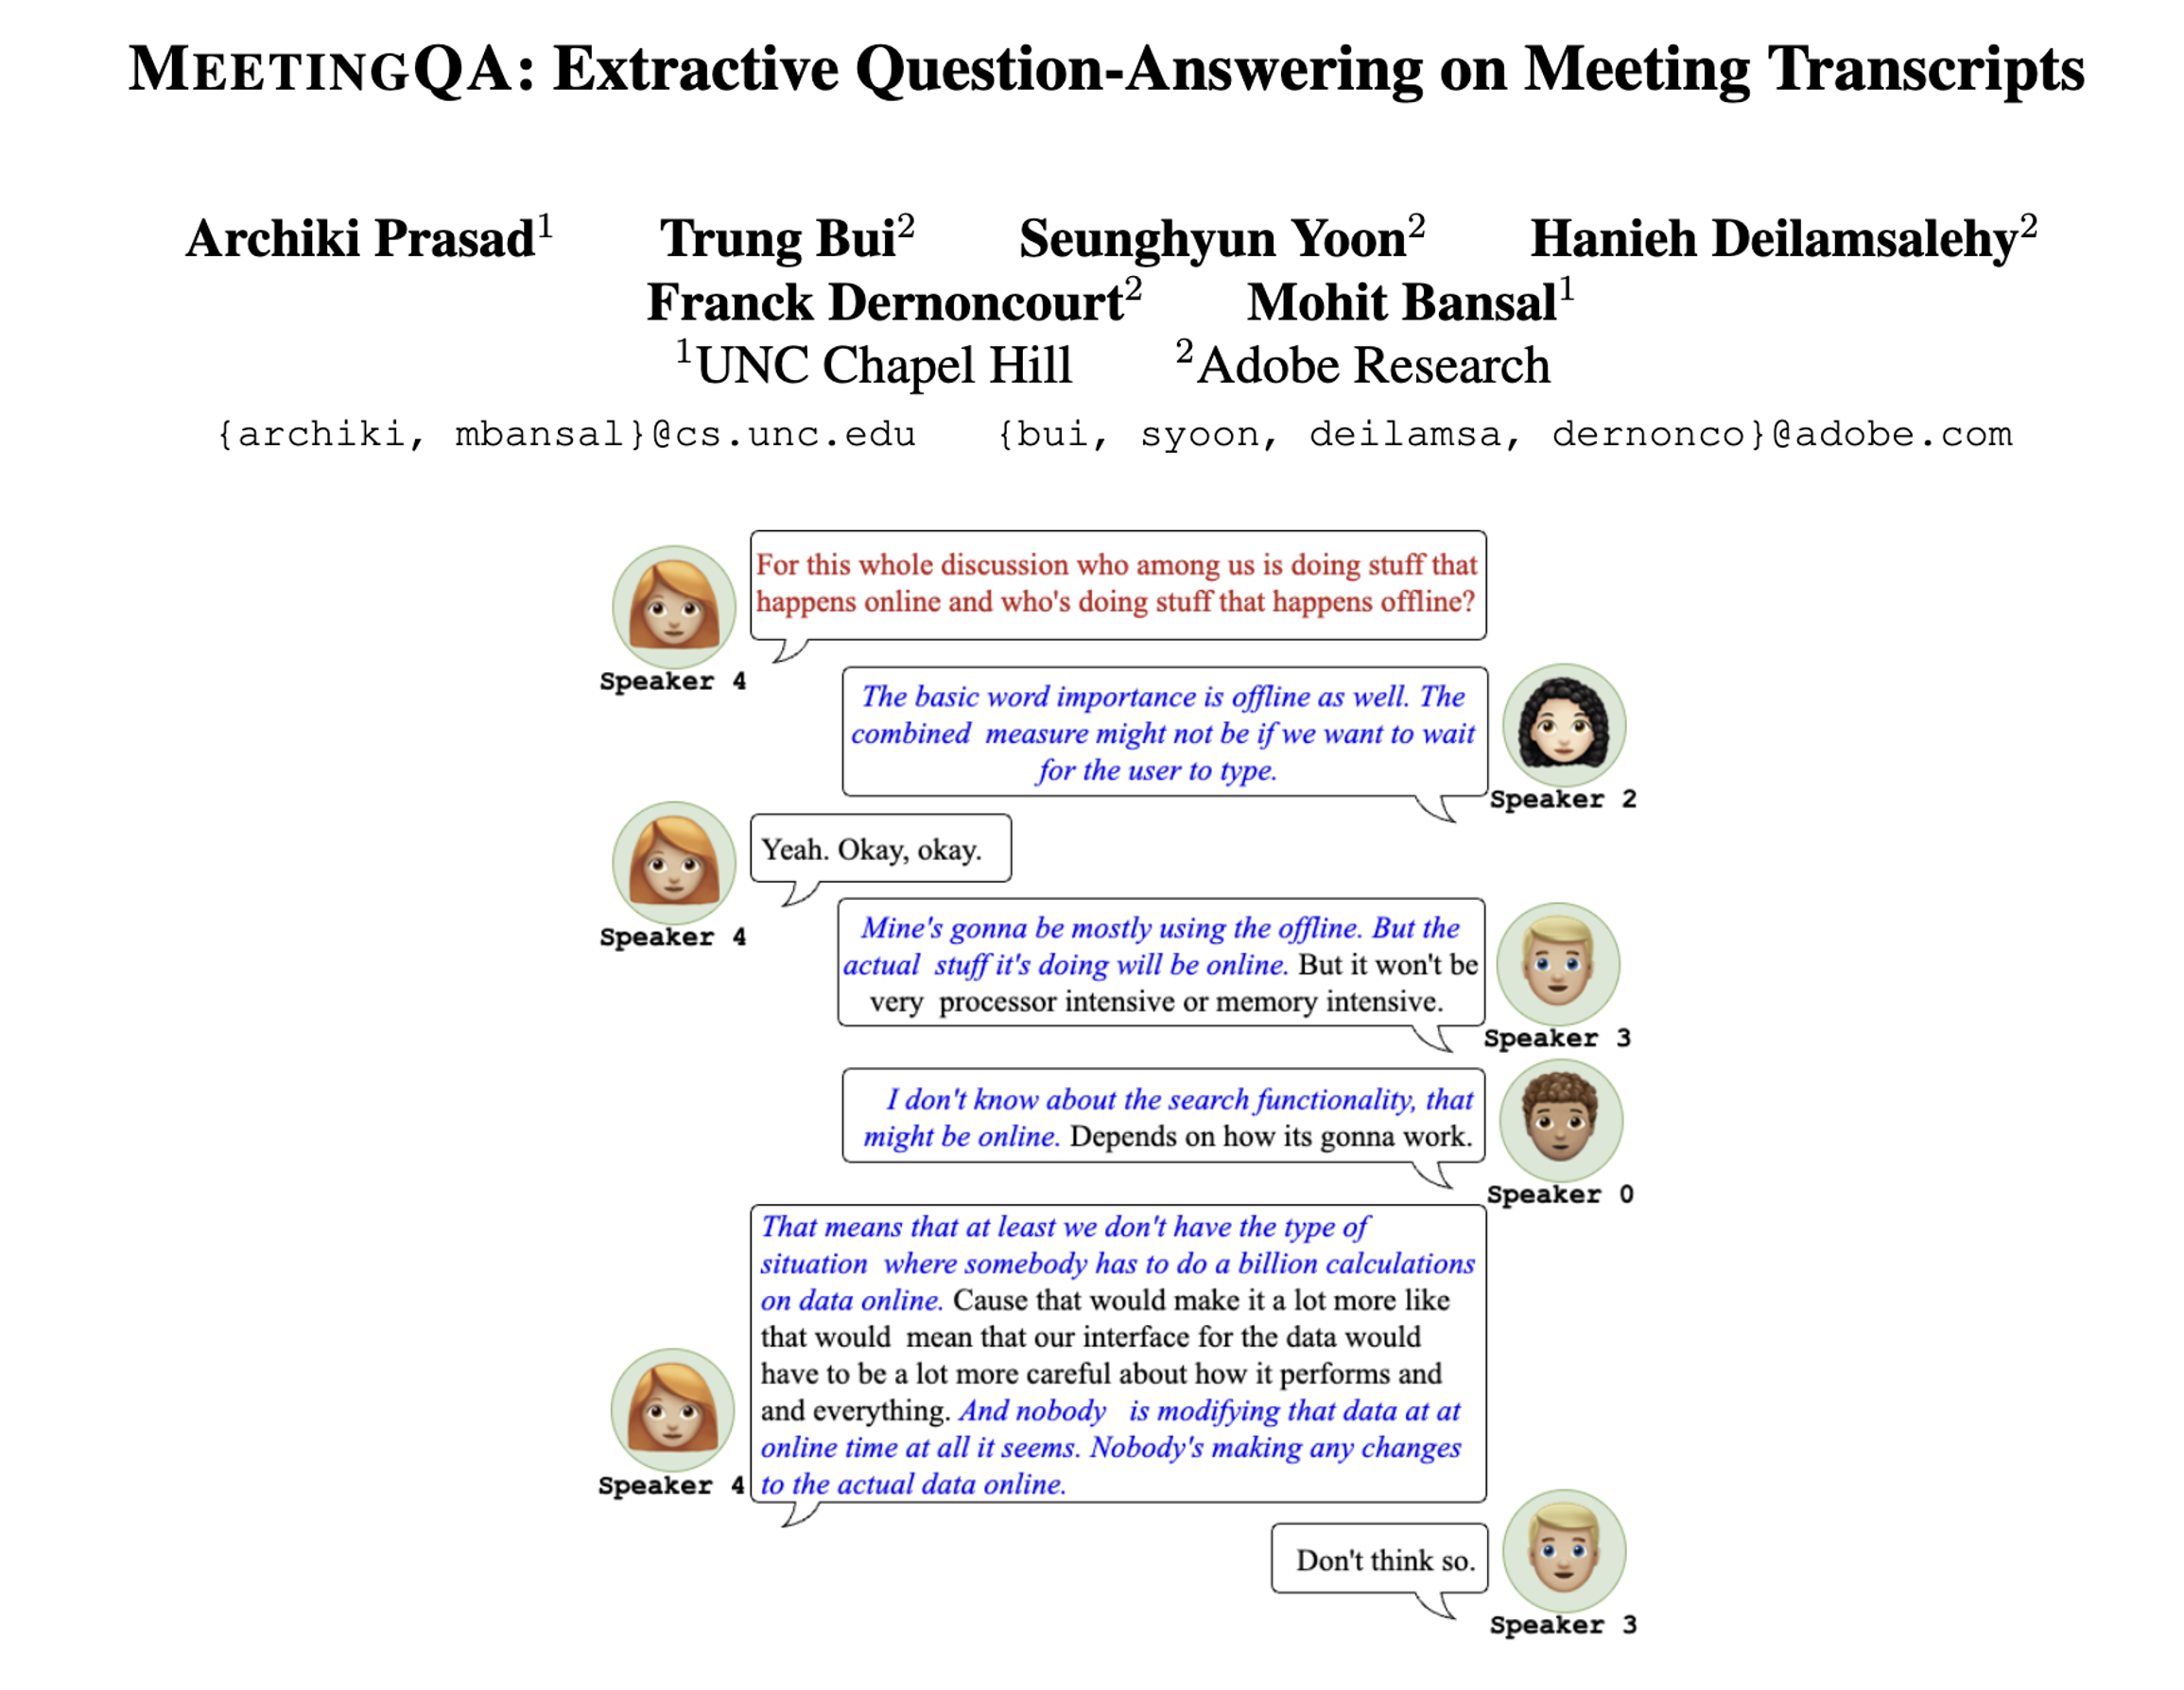
该论文题为《MEETINGQA: Extractive Question-Answering on Meeting Transcripts》,由来自北卡罗来纳大学教堂山分校和Adobe Research的研究人员共同撰写,发表于2023年ACL会议。论文聚焦于会议记录中的问答任务,旨在填补会议记录自然语言处理领域的空白。
论文指出,随着在线会议平台的普及和自动语音识别技术的进步,会议记录成为自然语言处理任务的新兴领域。尽管已有研究主要集中在会议记录的总结和行动项提取上,但会议讨论中的问答(QA)部分对于理解会议内容至关重要。为此,研究者们引入了MEETINGQA,这是一个包含会议参与者提出的问题及其对应回答的抽取式问答数据集。数据集中的问题可以是开放性的,旨在促进讨论,而答案可能是多跨度的,涉及多个发言人。
该研究通过全面的实证研究,测试了包括长上下文语言模型和最新指令调整模型在内的多个强大基线模型。结果显示,这些模型在该任务上的表现远低于人类水平(F1=57.3对比人类的F1=84.6),凸显了这一任务的挑战性。研究者们还分析了MEETINGQA数据集的多个方面,包括问题类型、长度分布以及答案类型等,发现会议记录问答任务具有独特性,如问题通常较长且不以"wh"开头,答案可能是多跨度和多发言人贡献的。
此外,论文还探讨了不同的上下文检索策略、模型架构以及数据增强方法,以期提升模型在会议记录问答任务上的性能。研究者们通过实验发现,基于位置的上下文检索策略优于基于评分的策略,且长上下文模型在处理此类任务时面临挑战。论文的结论强调了当前模型在会议记录问答任务上的局限性,并为未来的研究提供了方向,即如何进一步提升模型性能以缩小与人类表现的差距。