LLM大语言模型部署到本地(个人总结)

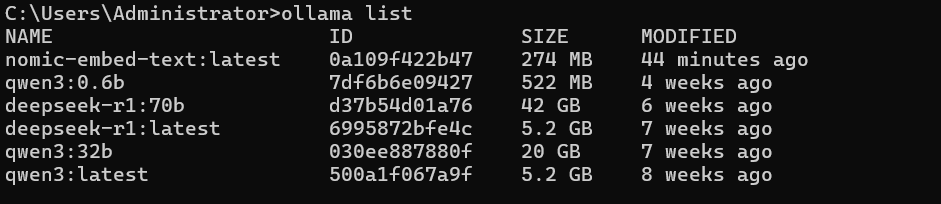
使用的是ollama

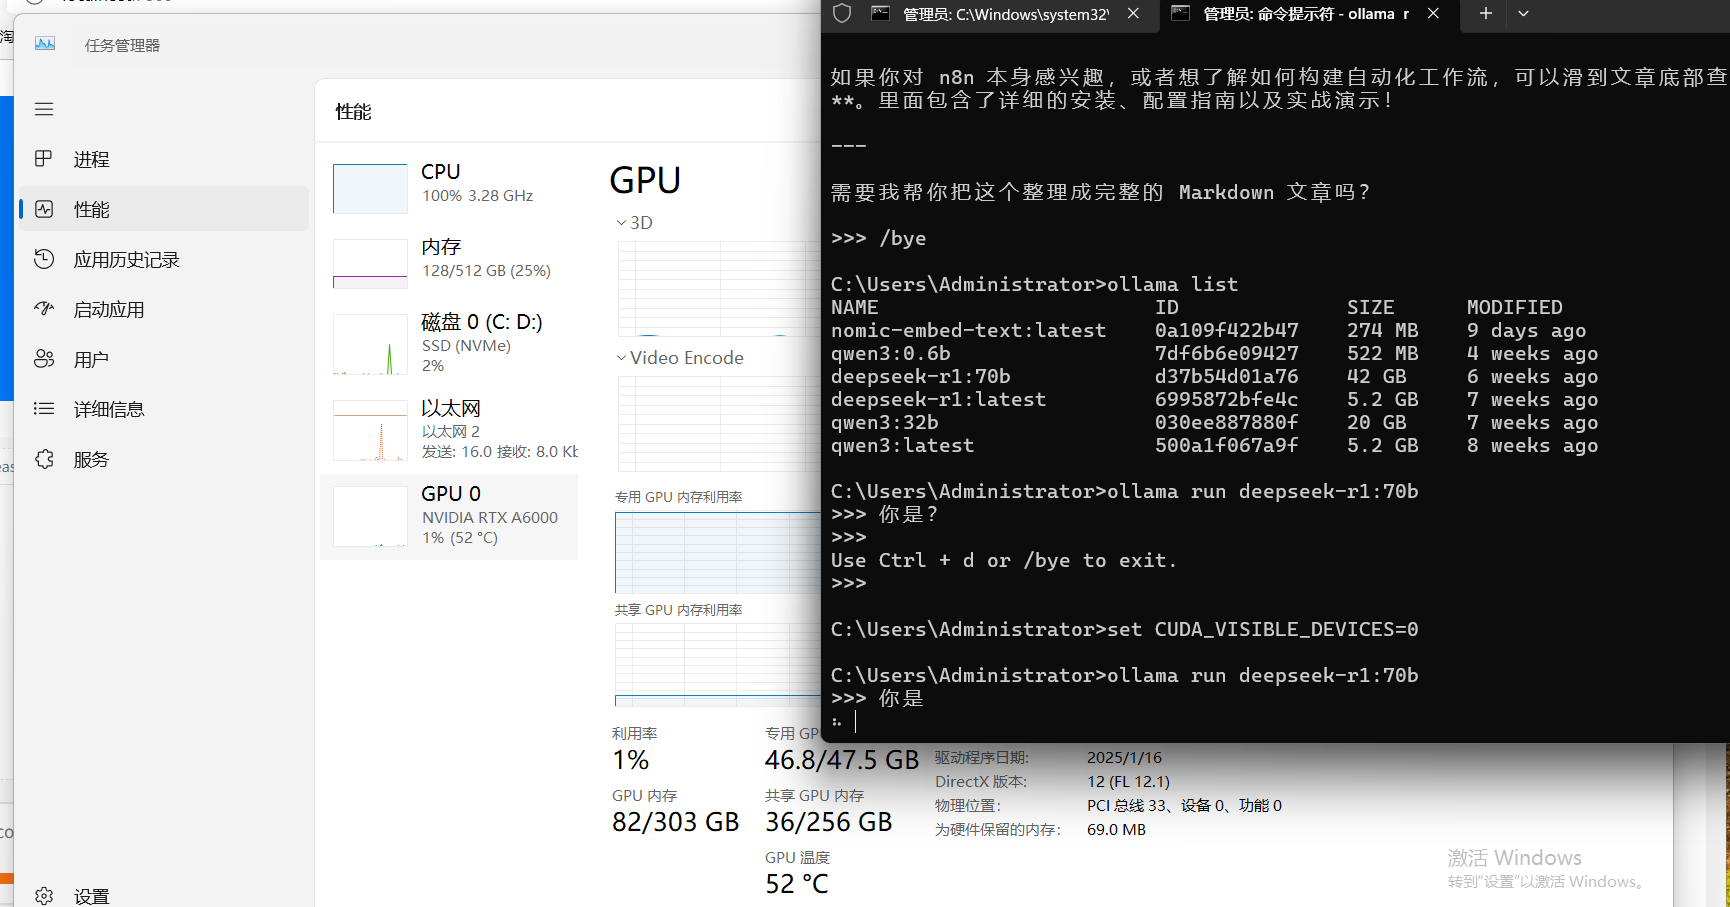
在跑ollama run deepseek-r1:latest时cpu100%,说明没有用到gpu

添加命令:

复制代码
set CUDA_VISIBLE_DEVICES=0

运行正常

但在跑70b的时候,cpu又百分比

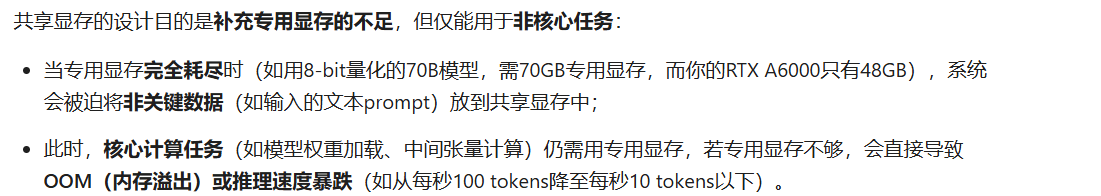
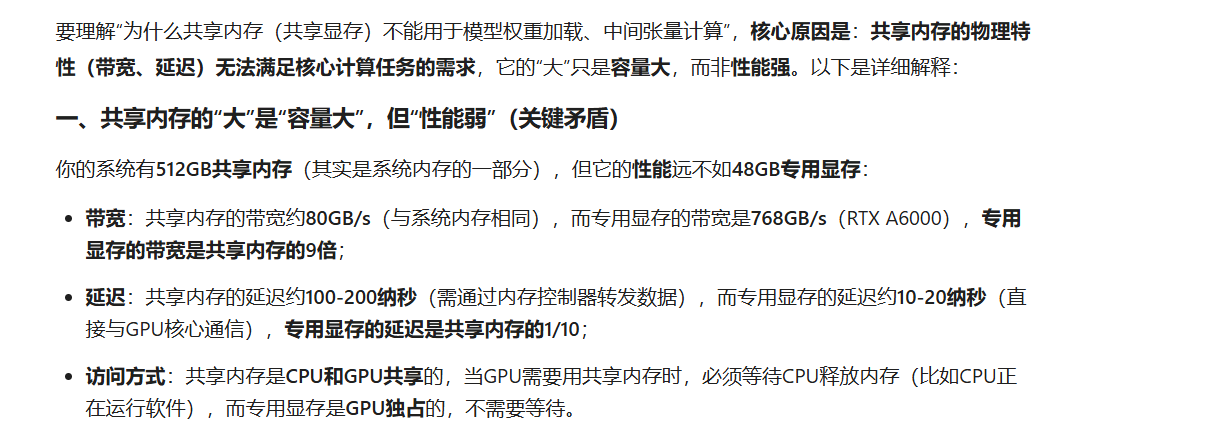
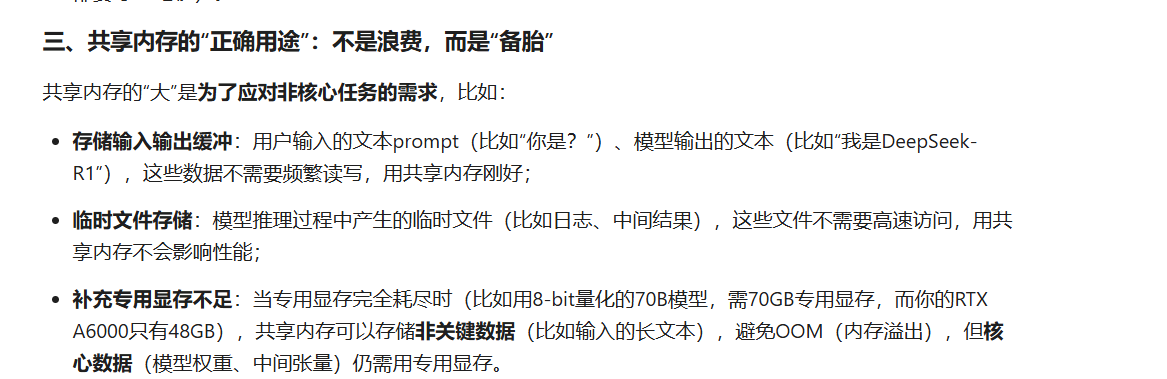
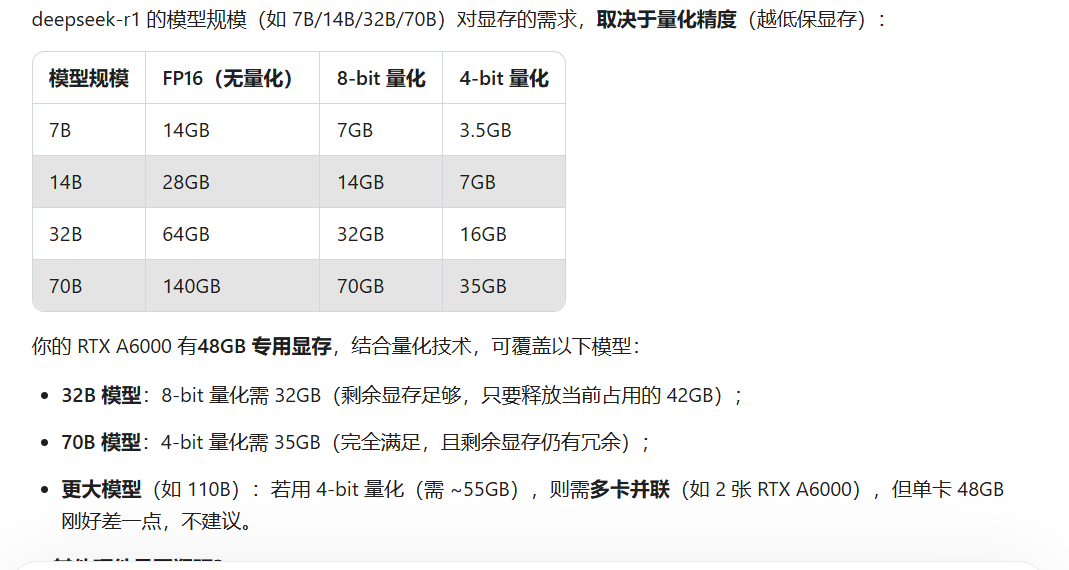
后续问ai解释到

说白了就是GPU硬件不支持,如果要运行70b的


我重启了电脑 gpu直接

哈哈,于是我又运行了ollama run deepseek-r1:70b
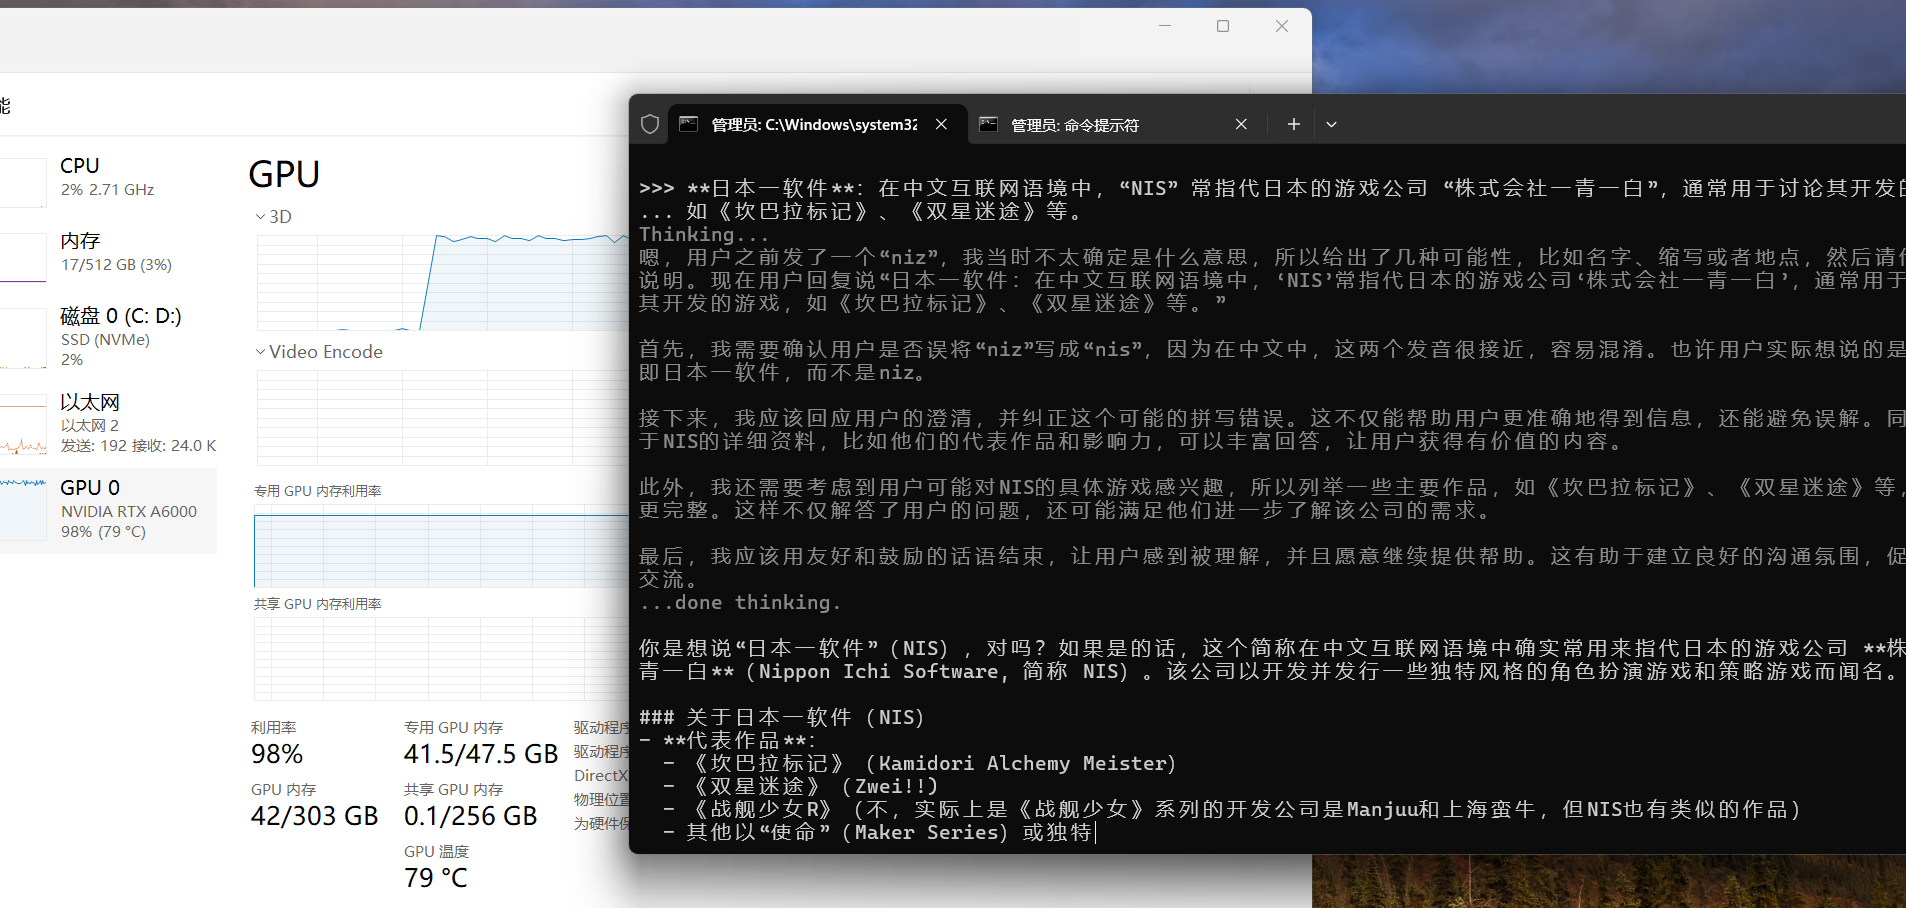
可以了,然后不用了的话
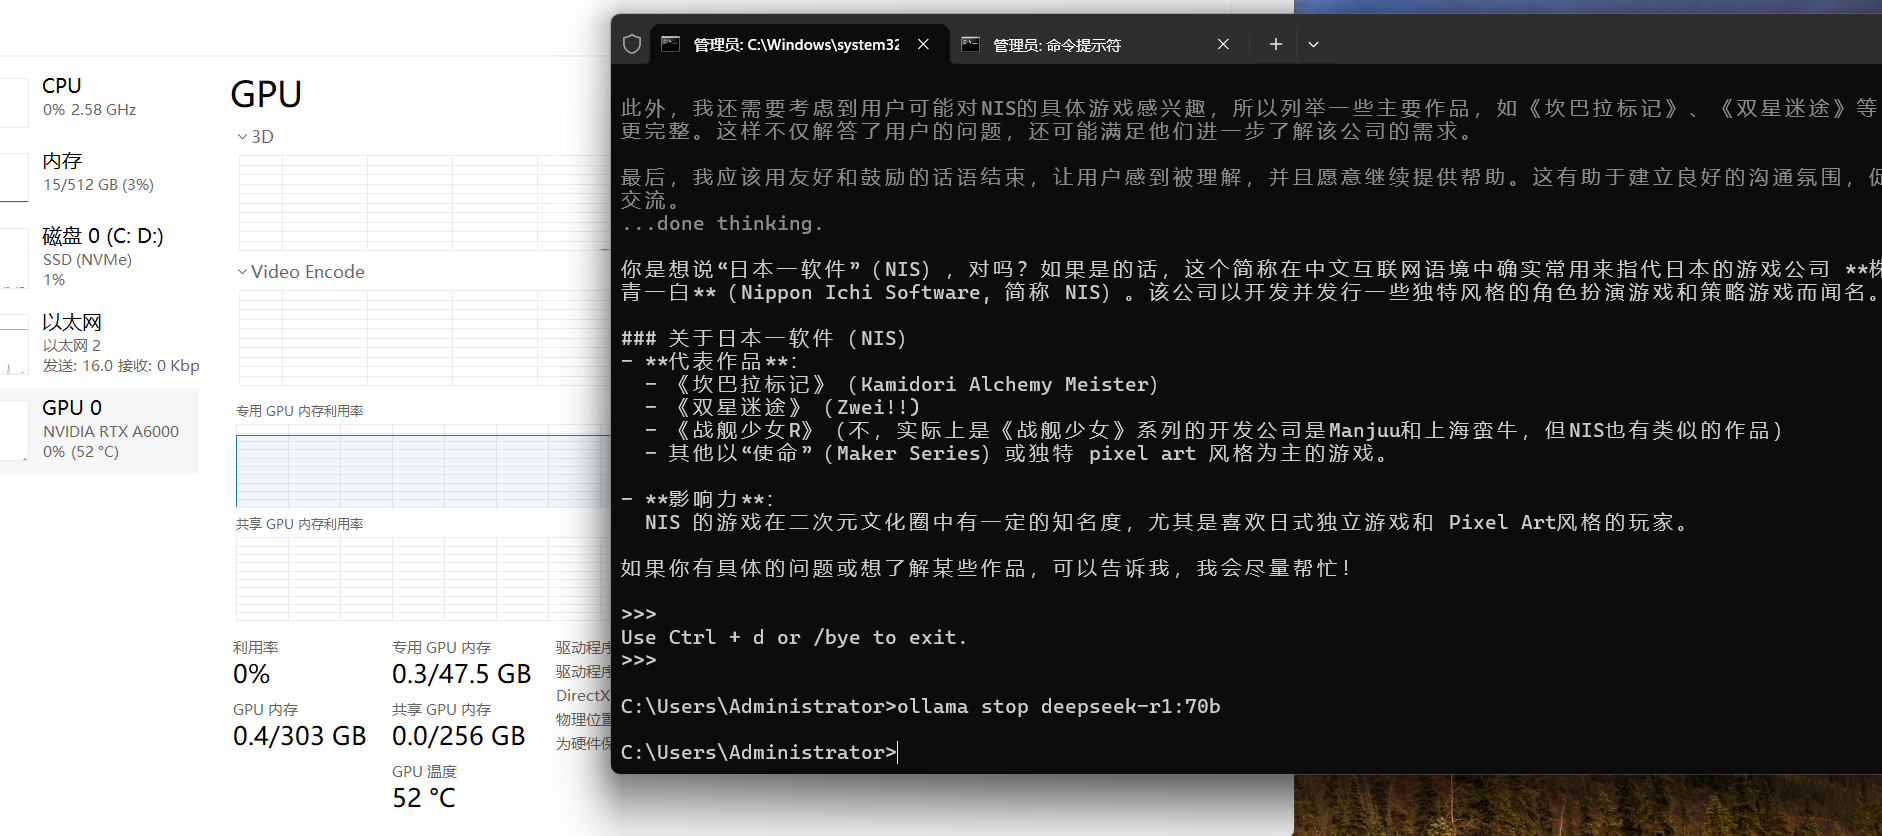
所以说专用内存占用太多,nvidia-smi也看不到(前序进程未释放显存(显存泄漏)),直接重启,然后运行完不用的话要stop

哈哈哈,好好好好好

相关推荐
云-缩影2 小时前
文生图技术落地:从广告到游戏,哪些场景真的能用
人工智能·游戏
冬奇Lab5 小时前
一天一个开源项目(第254篇):NVIDIA Auto Ontology —— 给数据 Agent 搭一层「可认证的语义层」,答不了就老实说答不了
人工智能
其实防守也摸鱼5 小时前
个人学习 Pwn 思路:从基础到漏洞利用的进阶路径
大数据·前端·人工智能·chrome·算法·安全·网络安全
甲维斯5 小时前
Workbuddy+HY4 略超预期!
人工智能
天远API6 小时前
零信任架构实战:基于天远运营商三要素详版V即时版构建自动化消费电子大促电商平台高价值权益秒杀与优惠券防羊毛高并发实名核验网关
运维·人工智能·架构·自动化
朱涛的自习室6 小时前
212 个需求、22 万行代码:Agent 接管开源项目的 19 天
android·前端·人工智能
美林数据Tempodata6 小时前
高职大数据技术专业升级的六个落地样本:从产业链需求库到实训室数据链路
大数据·人工智能·数字化转型·产教融合·ai教育
美好世界6 小时前
OpenAI Codex 源码深度剖析(三):执行引擎与内核沙箱深度剖析
人工智能
敖老师6 小时前
Dify 接入高德地图 MCP:Agent 策略、新旧节点与配置全流程避坑指南
人工智能