在机器学习模型训练中,超参数(Hyperparameter)设置对模型性能影响巨大,但很多开发者和数据科学家在这方面常常感到困惑:如何选择合适的超参数,避免盲目调参带来的低效和效果不佳?本文将分享一些实用思路和方法,特别推荐参考当前流行且成熟的AutoML(自动机器学习)框架中的超参数设计思路,帮助你更科学、更高效地进行超参数配置。
为什么超参数调优难?
- 参数空间庞大
超参数通常是多维的连续或离散空间,全量搜索成本极高。 - 调优耗时长
每次参数调整都需重新训练模型,计算资源和时间消耗巨大。 - 无万能配置
不同任务和数据集的最优超参数差异显著,需要针对性调优。 - 缺乏经验
初学者难以判断哪些参数关键,哪些影响较小,导致盲目尝试。
参考成熟AutoML框架的超参数设计思路
1. FLAML(Fast and Lightweight AutoML)
FLAML 是微软开源的轻量级AutoML库,专注于快速且高效的自动调参。其超参数设计具有以下特点:
- 采用基于资源分配的搜索策略,优先探索对性能影响显著的关键参数。
- 结合启发式规则与贝叶斯优化,动态调整搜索空间范围。
- 默认参数设计合理,适用多种任务,极大减少用户手动调参负担。
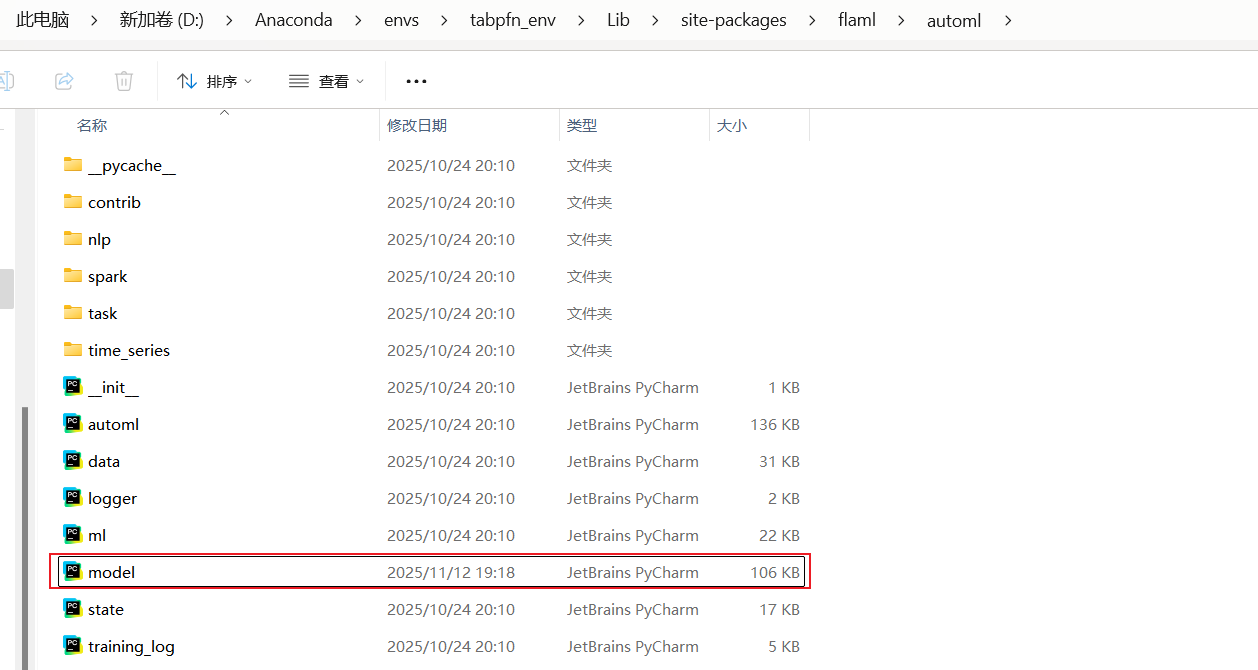
你可以参考FLAML源码中超参数定义和管理逻辑(通常位于安装路径下的 flaml/automl/model.py,见下图),学习其如何设计合理的默认值和搜索空间,提高调参效率。
python
class LGBMEstimator(BaseEstimator):
    """The class for tuning LGBM, using sklearn API."""

    ITER_HP = "n_estimators"
    HAS_CALLBACK = True
    DEFAULT_ITER = 100

    @classmethod
    def search_space(cls, data_size, **params):
        upper = max(5, min(32768, int(data_size[0])))  # upper must be larger than lower
        return {
            "": {
                "domain": tune.lograndint(lower=4, upper=upper),
                "init_value": 4,
                "low_cost_init_value": 4,
            },
            "num_leaves": {
                "domain": tune.lograndint(lower=4, upper=upper),
                "init_value": 4,
                "low_cost_init_value": 4,
            },
            "min_child_samples": {
                "domain": tune.lograndint(lower=2, upper=2**7 + 1),
                "init_value": 20,
            },
            "learning_rate": {
                "domain": tune.loguniform(lower=1 / 1024, upper=1.0),
                "init_value": 0.1,
            },
            "log_max_bin": {  # log transformed with base 2
                "domain": tune.lograndint(lower=3, upper=11),
                "init_value": 8,
            },
            "colsample_bytree": {
                "domain": tune.uniform(lower=0.01, upper=1.0),
                "init_value": 1.0,
            },
            "reg_alpha": {
                "domain": tune.loguniform(lower=1 / 1024, upper=1024),
                "init_value": 1 / 1024,
            },
            "reg_lambda": {
                "domain": tune.loguniform(lower=1 / 1024, upper=1024),
                "init_value": 1.0,
            },
        }

	    def config2params(self, config: dict) -> dict:
	        params = super().config2params(config)
	        if "log_max_bin" in params:
	            params["max_bin"] = (1 << params.pop("log_max_bin")) - 1
	        return params
2. AutoGluon
AutoGluon 是亚马逊开源的AutoML工具,支持多种数据类型和任务,调参灵活且功能强大。其超参数设计体现在:
- 采用层次化参数空间管理,分模块定义超参数。
- 支持多模型集成,自动选择并调优不同模型的关键参数。
- 参数空间包含合理的默认值和边界,方便快速上手与优化。
你可以在AutoGluon安装目录(如 autogluon/tabular/models/,见下图)查看各模型(LightGBM、CatBoost、NeuralNet等)的超参数设置及搜索空间设计,借鉴其高效且合理的参数管理方式。
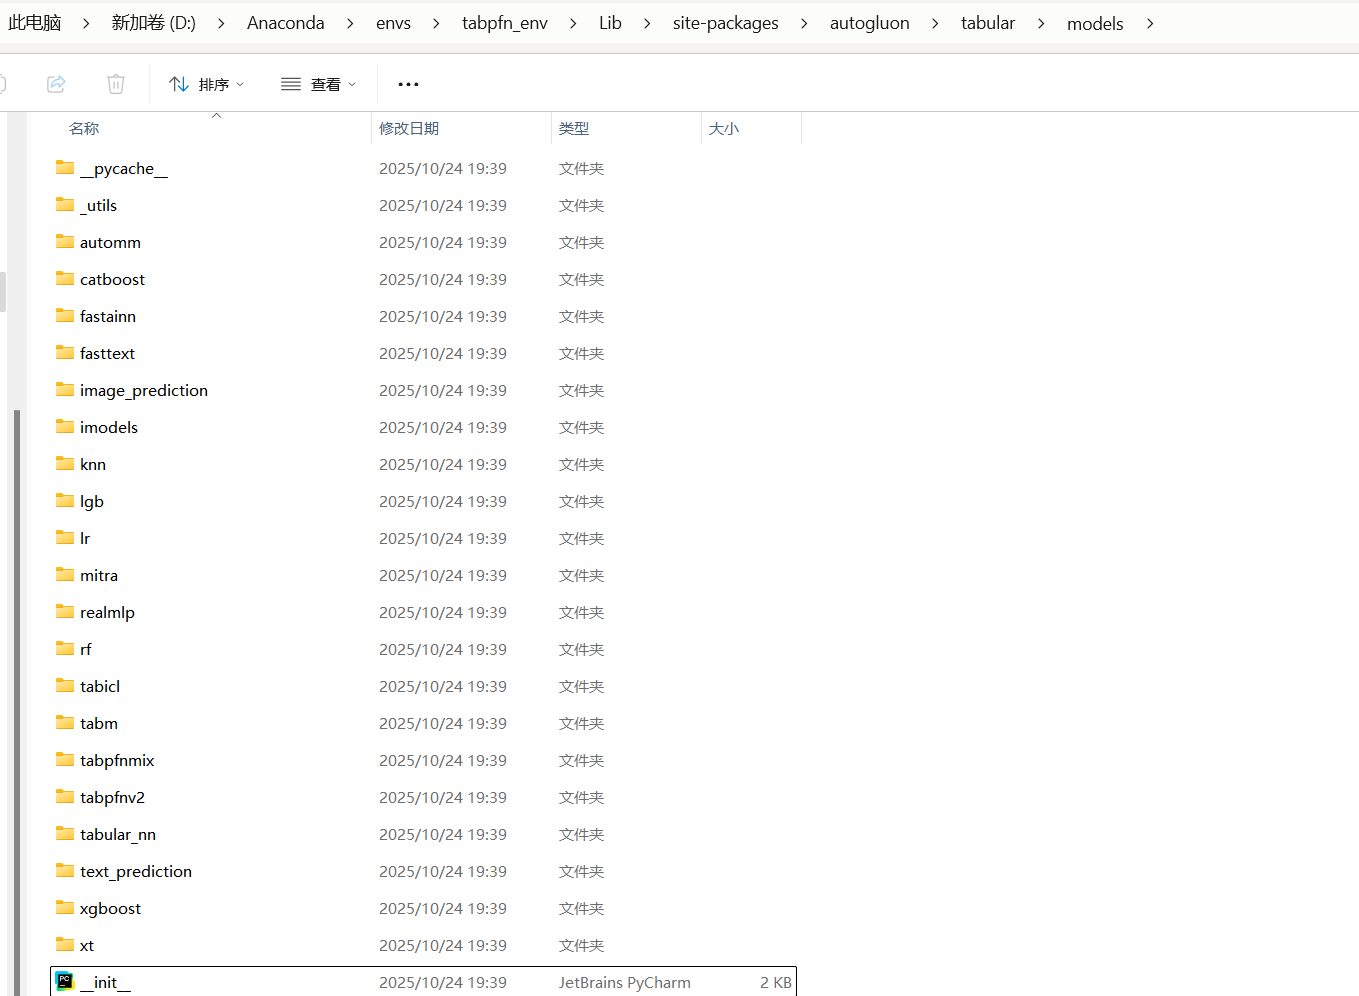
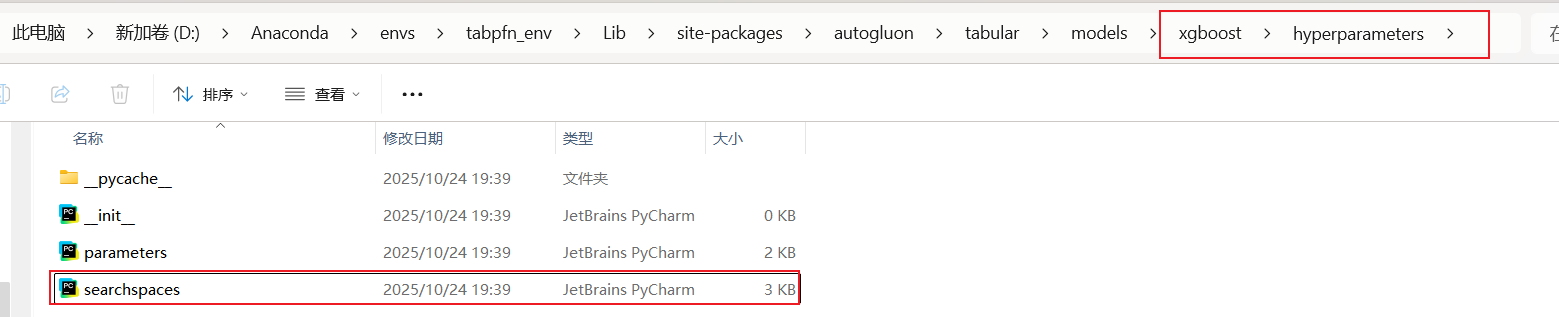
在定位到上图后,以Xgboost为例,找到对应目录下的hyperparameters文件夹,打开下面的searchspaces.py
python
def get_base_searchspace():
    base_params = {
        "n_estimators": DEFAULT_NUM_BOOST_ROUND,
        "booster": "gbtree",
        "n_jobs": -1,
        "learning_rate": space.Real(lower=5e-3, upper=0.2, default=0.1, log=True),
        "max_depth": space.Int(lower=3, upper=10, default=6),
        "min_child_weight": space.Int(lower=1, upper=5, default=1),
        "colsample_bytree": space.Real(lower=0.5, upper=1.0, default=1.0),
        # Below lines are commented out as they made search worse. Refine ranges before considering reintroducing these hyperparameters.
        # 'gamma': Real(lower=0, upper=5, default=0),
        # 'subsample': Real(lower=0.5, upper=1.0, default=1.0),
        # 'reg_alpha': Real(lower=0.0, upper=10.0, default=0.0),
        # 'reg_lambda': Real(lower=0.0, upper=10.0, default=1.0),
    }
    return base_params
总结与建议
- 借鉴成熟框架
参考FLAML、AutoGluon等开源AutoML项目的超参数设计理念,是提升调参效率与效果的快捷途径。 - 聚焦关键参数
不是所有参数都需调优,优先识别对模型性能影响最大的几个关键超参数。 - 合理设定范围与默认值
避免参数范围过大或默认值不合理,缩小搜索空间,提高优化效率。 - 利用自动化调参工具
结合贝叶斯优化、进化算法、早停策略等自动化技术,辅助快速找到较优参数组合。 - 持续学习与实践
不同任务和数据特征各异,需不断积累经验,结合业务需求灵活调整。