哈喽各位,我是前端小L。
欢迎来到我们的图论专题第二十三篇!在现实世界的大数据处理中,"实体对齐 (Entity Resolution)"是一个非常重要的话题。它的核心就是:如何判断两个看似不同的记录,实际上指向的是同一个实体?
对于这道"账户合并"题,我们的连接纽带是邮箱。
-
账户 A:
["John", "a@mail.com", "b@mail.com"] -
账户 B:
["John", "c@mail.com", "d@mail.com"] -
账户 C:
["John", "a@mail.com", "c@mail.com"]
虽然 A、B、C 看起来是三条记录,但 A 和 C 共享了 "a@mail.com",所以 A 和 C 是同一个人。一旦 A 和 C 合并,它们就共享了 "c@mail.com",而 B 也有 "c@mail.com",所以 B 也被拉进了这个圈子。最终,A、B、C 其实都是同一个人!
这就是并查集的拿手好戏:通过局部的交集,推导出全局的连通分量。
力扣 721. 账户合并
https://leetcode.cn/problems/accounts-merge/
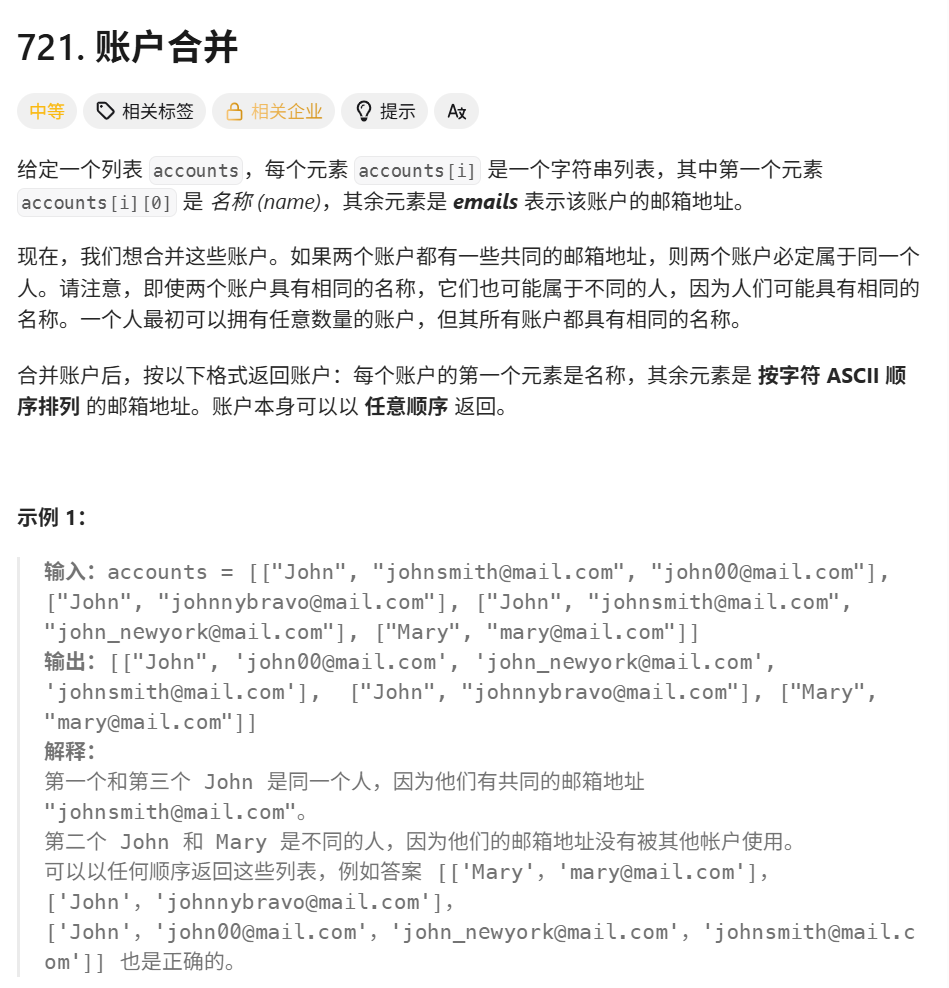
题目分析:
-
输入 :一个列表
accounts,每个元素是[name, email1, email2, ...]。 -
规则 :如果两个账户有任何一个共同的邮箱,它们就属于同一个人。
-
目标 :合并这些账户。返回格式:
[name, sorted_email1, sorted_email2, ...]。
核心难点: 我们并查集处理的通常是 0 到 n-1 的整数 ID。但这里我们面对的是一堆字符串(邮箱)。 我们有两种建模思路:
-
给账户编号 :把索引
0, 1, 2视为节点。如果发现邮箱重叠,就union(0, 2)。这比较麻烦,因为需要建立"邮箱 -> 账户ID列表"的倒排索引。 -
直接给邮箱分组 :把每一个邮箱看作图中的一个节点!
-
在同一个账户列表里的邮箱(比如
e1, e2, e3),它们肯定属于同一个人,所以我们执行union(e1, e2),union(e2, e3)。 -
遍历完所有账户后,所有属于同一个人的邮箱,自然就会在并查集中拥有同一个"老大(Root Email)"。
-
思路二更加直观!但标准的并查集用数组 parent。面对字符串,我们只需要把数组换成哈希表 unordered_map<string, string> parent 即可!
算法流程:字符串并查集
-
初始化:
-
parent哈希表:存储email -> parent_email。 -
owner哈希表:存储email -> user_name(用于最后输出名字)。 -
初始时,每个邮箱的 parent 指向自己。
-
-
遍历并合并 (Union):
-
遍历输入列表
accounts。 -
对于每个账户
[name, e1, e2, ...]:-
记录
owner[e1] = name,owner[e2] = namehttps://www.google.com/search?q=...(其实只要记任意一个就行,因为最后合并后大家都是一家人)。 -
关键操作:从第二个邮箱开始,将其与第一个邮箱合并。
-
union(e1, e2),union(e1, e3), https://www.google.com/search?q=... -
这样,该账户下的所有邮箱就挂在了一起。如果别的账户也包含
e2,那个账户的邮箱也会顺藤摸瓜挂到这一串上。
-
-
-
收集结果 (Group):
-
创建一个哈希表
groups:root_email -> list<email>。 -
遍历所有出现过的邮箱
e:-
找到它的老大
r = find(e)。 -
把
e加入到groups[r]的列表中。
-
-
-
格式化输出:
-
遍历
groups。 -
对于每一组,取出
root_email对应的列表,进行排序。 -
从
owner表中找到这个组对应的名字name。 -
组合成
[name, e1, e2...],加入最终结果。
-
代码实现 (字符串并查集)
C++
#include <vector>
#include <string>
#include <unordered_map>
#include <algorithm>

using namespace std;

class Solution {
private:
    // 字符串并查集
    unordered_map<string, string> parent;

    // 查找 + 路径压缩
    string find(const string& x) {
        // 如果 x 不在 parent 中(第一次遇到),初始化它指向自己
        if (parent.find(x) == parent.end()) {
            parent[x] = x;
        }

        if (parent[x] != x) {
            parent[x] = find(parent[x]);
        }
        return parent[x];
    }

    // 合并
    void unite(const string& x, const string& y) {
        string rootX = find(x);
        string rootY = find(y);
        if (rootX != rootY) {
            parent[rootX] = rootY;
        }
    }

public:
    vector<vector<string>> accountsMerge(vector<vector<string>>& accounts) {
        unordered_map<string, string> owner; // 记录每个邮箱归属的用户名

        // 1. 遍历账户,进行合并
        for (const auto& acc : accounts) {
            const string& name = acc[0];
            const string& firstEmail = acc[1];

            // 记录每个邮箱的 owner (即使重复记录也无所谓,名字是一样的)
            // 同时也确保了每个出现的邮箱都在 parent 逻辑中被初始化
            for (int i = 1; i < acc.size(); ++i) {
                const string& email = acc[i];
                owner[email] = name;

                // 将当前邮箱与第一个邮箱合并
                // (find 函数内部会处理初始化)
                if (i > 1) {
                    unite(firstEmail, email);
                } else {
                    find(firstEmail); // 确保单个邮箱的情况也被初始化
                }
            }
        }

        // 2. 收集结果:按 Root Email 分组
        unordered_map<string, vector<string>> groups;
        for (const auto& pair : owner) {
            const string& email = pair.first;
            string root = find(email);
            groups[root].push_back(email);
        }

        // 3. 格式化输出
        vector<vector<string>> result;
        for (auto& pair : groups) {
            const string& rootEmail = pair.first;
            vector<string>& emailList = pair.second;

            // 题目要求排序
            sort(emailList.begin(), emailList.end());

            // 构建 [Name, e1, e2...]
            vector<string> account;
            account.push_back(owner[rootEmail]); // 只需要找 Root 的 owner 即可
            account.insert(account.end(), emailList.begin(), emailList.end());

            result.push_back(account);
        }

        return result;
    }
};
深度复杂度分析
-
N:所有账户中邮箱的总数量。
-
时间复杂度 O(N * logN):
-
并查集操作 :虽然是字符串操作,但每个邮箱最多参与常数次
find/unite。如果字符串长度视为常数K,这部分近似O(N * K)。 -
排序 :这是最耗时的部分。我们需要对每个组的邮箱列表进行排序。在最坏情况下(所有邮箱属于同一个人),我们需要对
N个字符串排序,复杂度为O(N * logN * K)。 -
总时间主要由排序决定。
-
-
空间复杂度 O(N):
parent,owner,groups等哈希表都需要存储所有的邮箱。
总结:并查集------关系数据的"整理收纳师"
今天这道题,展示了并查集在实际数据处理中的强大能力。 通过将"邮箱"视为节点,将"同列表"视为连接,我们轻松地将杂乱无章的碎片信息,整理成了井井有条的"档案"。
核心技巧回顾:
-
字符串并查集 :用
unordered_map<string, string>代替数组,逻辑完全不变。 -
两步走 :先
Union建立关系,再Group收集结果。
在下一篇中,我们将迎来图论中一个极其重要、且算法优美的大类------最小生成树 (MST) 。我们将学习如何用并查集来实现大名鼎鼎的 Kruskal 算法,在一个庞大的网络中,以最小的成本连接所有节点。
下期见!