六、大模型文字生成音频和图片
随着生成式人工智能的飞速发展,大模型不仅在文本理解和生成方面展现出卓越能力,更将触角伸向了多模态内容创作。其中,文字转音频(Text-to-Speech, TTS)和文字转图片(Text-to-Image, TTI)技术,正以前所未有的速度改变着我们创造和消费数字内容的方式,开启了一个"所想即所得"的创意新时代。
6.1 文字转音频
文字转音频技术旨在将书面文本转化为自然、流畅且富有表现力的语音。传统TTS技术依赖于拼接预录音的音素或单元,声音往往机械生硬。而基于大模型的TTS技术,则实现了质的飞跃。
6.1.1 文字转音频原理
- 神经网络的深度学习: 现代TTS模型(如Tacotron, WaveNet, VITS等)采用深度神经网络,直接从文本中学习语音的韵律、音调、语速和停顿,生成高度自然的语音波形。
- 端到端学习: 许多先进的TTS系统是端到端的,这意味着它们可以直接将文本输入映射到原始音频波形,无需复杂的特征工程。
- 情感与风格控制: 大模型使得TTS能够捕捉并合成包含情感(高兴、悲伤、愤怒)和不同说话风格(新闻播报、客服、休闲对话)的语音,甚至能够模仿特定人的音色(语音克隆/Voice Cloning)。
- 多语言与多角色支持: 能够支持多种语言,并生成不同性别、年龄和口音的角色声音。
6.1.2 文字转音频应用场景
- 有声读物与播客: 极大降低制作成本和时间,让更多文字作品转化为听觉体验。
- 智能助手与导航系统: 提供更加自然、个性化的语音交互体验。
- 无障碍辅助: 为视障人士提供便捷的信息获取方式。
- 视频配音与旁白: 快速为视频内容添加专业配音,尤其是在多语言本地化方面。
- 虚拟数字人: 赋予虚拟形象更具表现力、更自然的"声音"。
想象一下: 你只需要输入一篇新闻稿,大模型就能立即生成一段由专业播音员风格朗读的音频,语气抑扬顿挫,完全媲美真人录制。
6.1.3 文字转音频代码示例
下图中 input 中可修改为自己想要生成语音的文字。

from pathlib import Path
import openai

speech_file_path = Path(__file__).parent / "speech.mp3"
with openai.audio.speech.with_streaming_response.create(
  model="gpt-4o-mini-tts",
  voice="alloy",
  input="今天天气真不错,我们一起出去玩吧"
) as response:
  response.stream_to_file(speech_file_path)
6.2 文字转图片
文字转图片技术是将自然语言描述转化为视觉图像的强大能力。在过去几年中,TTI领域取得了突破性进展,尤其是扩散模型(Diffusion Models)的出现,彻底改变了我们对机器生成图像的认知。
6.2.1 文字转图片原理
- 生成对抗网络 (GANs) 到扩散模型 (Diffusion Models): 早期TTI技术主要依赖GANs,但生成图像的质量和多样性有限。扩散模型通过模拟像素从随机噪声逐渐去噪的过程,能够生成令人惊叹的高质量、高分辨率和高度逼真的图像。
- 跨模态理解: 大模型(如CLIP等)在训练过程中学习了文本和图像之间的语义关联,使得TTI模型能够更准确地理解文本提示的含义,并将其映射到视觉特征。
- 精细控制与创作自由: 用户可以通过**详细的文本描述(Prompt Engineering)**来指导图像的风格、构图、颜色、物体位置甚至光照条件。例如,可以指定"赛博朋克风格的城市夜景,雨后霓虹灯倒影,高分辨率"。
- 多模态融合: 除了纯文本生成图像,TTI技术还可以结合其他输入(如草图、风格图片),实现更复杂的图像编辑和生成。
6.2.2 文字转图片应用场景
- 创意设计与艺术创作: 帮助设计师快速生成概念图、灵感草图,甚至完成最终的艺术作品。
- 内容营销与广告: 依据产品描述或营销文案快速生成高质量的广告图片或社交媒体内容。
- 游戏与影视: 快速生成游戏场景、角色概念图、特效元素,大大缩短制作周期。
- 教育与出版: 为教材、文章、报告等生成定制化的插图。
- 虚拟现实/增强现实 (VR/AR): 快速构建沉浸式环境和物体。
6.2.3 文字转图片代码示例
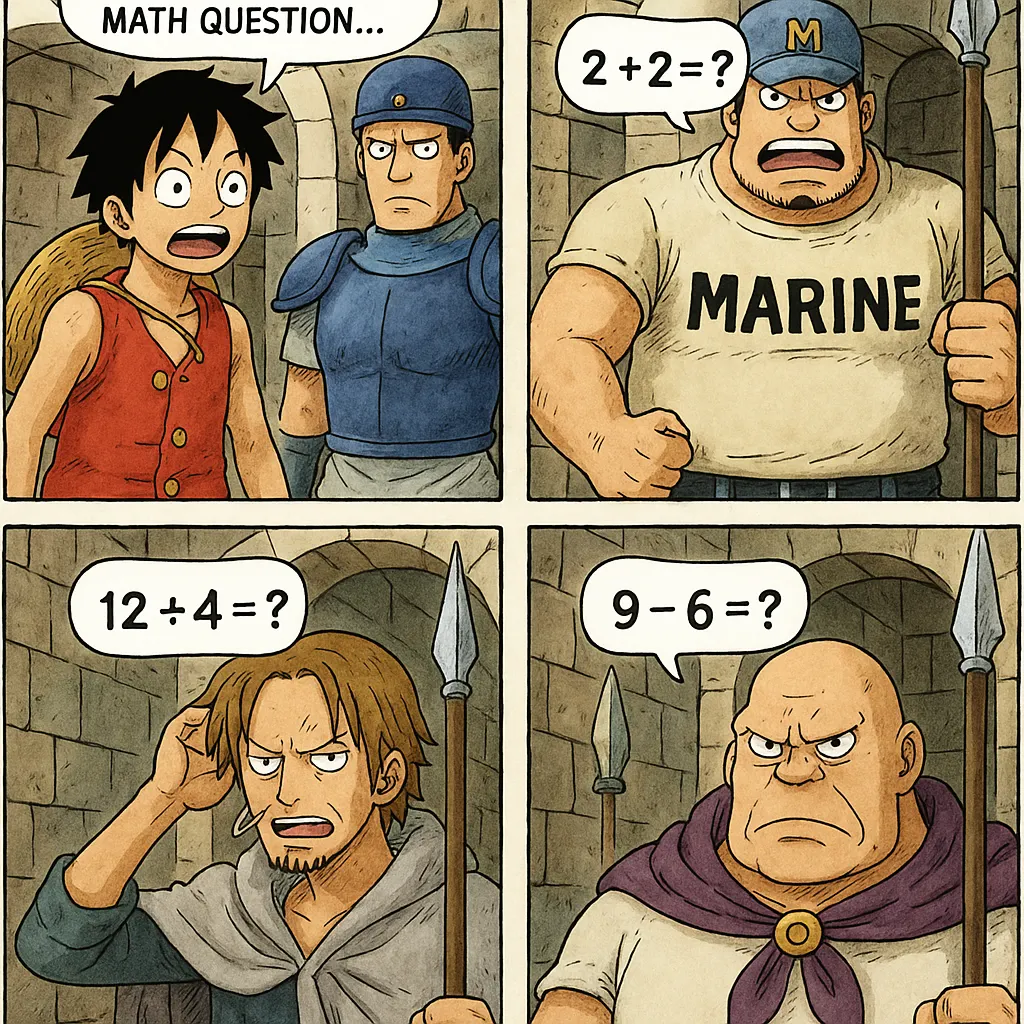
之前了解到一位爸爸为了让自己孩子学习增添趣味性,用模型生成一些图文计算激发孩子兴趣。
可以参考我的提示自己进行实践。

import base64
from openai import OpenAI
client = OpenAI()

prompt = """
帮我生成图片:四格漫画,用动漫《海贼王》的风格,主题是一道数学题:
我们进入了一个有四个房间的迷宫,每个房间里都有一个守卫。
每个守卫都会问我们一个数学问题,如果我们回答正确,就可以进入下一个房间;
如果回答错误,就会被赶出迷宫。

第一个守卫问我们:2+2等于几?
第二个守卫问我们:5乘以3等于几?
第三个守卫问我们:12除以4等于几?
第四个守卫问我们:9减去6等于几?

请帮我画出这个四格漫画,每一格都要有守卫和数学题的内容。
"""

img = client.images.generate(
    model="gpt-image-1",
    prompt=prompt,
    n=1,
    size="1024x1024"
)

image_bytes = base64.b64decode(img.data[0].b64_json)
with open("output.png", "wb") as f:
    f.write(image_bytes)