这篇博客是进程概念的最后一篇博客,了解完这篇博客,我们就已经对进程有了初步的概念,就可以接下来对进程更深层的探索啦
1.查看linux下不同数据的地址存放在哪里
我们在讲C语⾔的时候,⽼师给⼤家画过这样的空间布局图(32位)
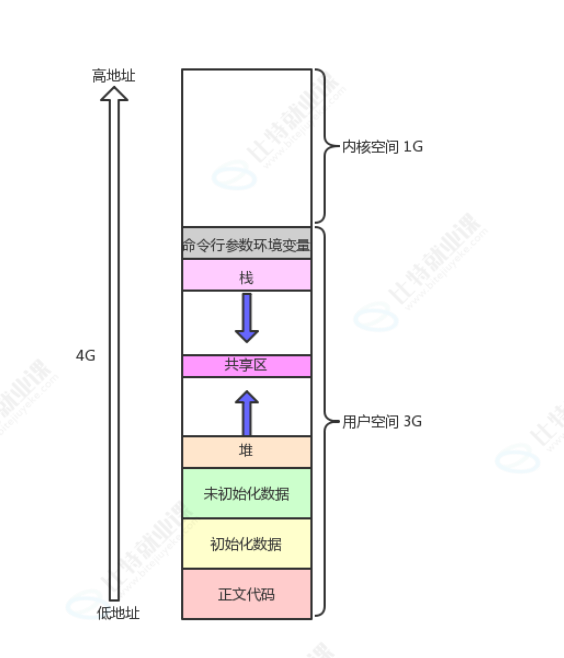
可是我们对他并不理解!可以先对其进⾏各区域分布验证:
code.c代码如下:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int g_unval;
int g_val = 100;

int main(int argc, char *argv[], char *env[])
{
    const char *str = "helloworld";
    printf("code addr: %p\n", main);
    printf("init global addr: %p\n", &g_val);
    printf("uninit global addr: %p\n", &g_unval);
    static int test = 10;
    char *heap_mem = (char*)malloc(10);
    char *heap_mem1 = (char*)malloc(10);
    char *heap_mem2 = (char*)malloc(10);
    char *heap_mem3 = (char*)malloc(10);
    printf("heap addr: %p\n", heap_mem); //heap_mem(0), &heap_mem(1)
    printf("heap addr: %p\n", heap_mem1); //heap_mem(0), &heap_mem(1)
    printf("heap addr: %p\n", heap_mem2); //heap_mem(0), &heap_mem(1)
    printf("heap addr: %p\n", heap_mem3); //heap_mem(0), &heap_mem(1)
    printf("test static addr: %p\n", &test); //heap_mem(0), &heap_mem(1)
    printf("stack addr: %p\n", &heap_mem); //heap_mem(0), &heap_mem(1)
    printf("stack addr: %p\n", &heap_mem1); //heap_mem(0), &heap_mem(1)
    printf("stack addr: %p\n", &heap_mem2); //heap_mem(0), &heap_mem(1)
    printf("stack addr: %p\n", &heap_mem3); //heap_mem(0), &heap_mem(1)
    printf("read only string addr: %p\n", str);
    for(int i = 0 ;i < argc; i++)
    {
        printf("argv[%d]: %p\n", i, argv[i]);
    }
    for(int i = 0; env[i]; i++)
    {
        printf("env[%d]: %p\n", i, env[i]);
    }
    return 0;
}
编译运行出结果:
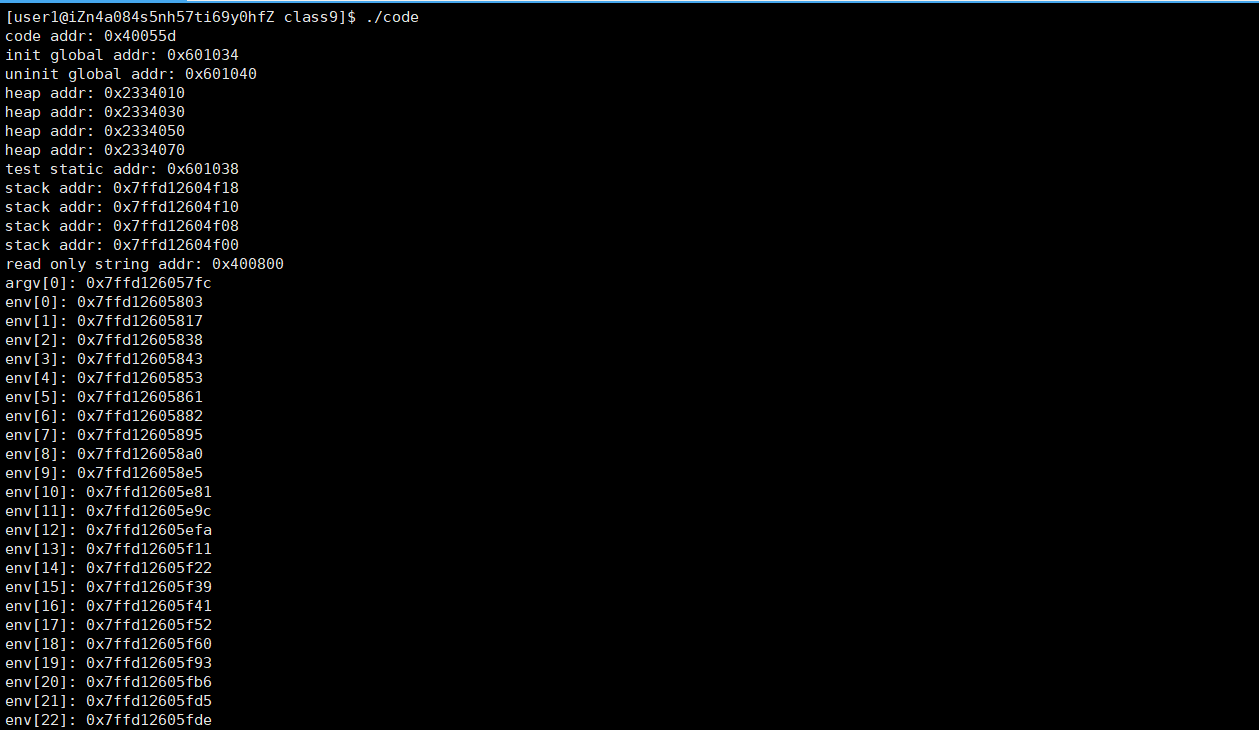
于是得到了下面的对于地址表格:
| 代码中的打印语句 | 输出结果示例 | 对应虚拟地址空间分区 | 说明 |
|---|---|---|---|
printf("code addr: %p\n", main); |
code addr: 0x40055d |
代码段(.text) | main是程序的可执行函数,存放在代码段 |
printf("init global addr: %p\n", &g_val); |
init global addr: 0x601034 |
已初始化数据段(.data) | g_val是初始化的全局变量,存放在.data 段 |
printf("uninit global addr: %p\n", &g_unval); |
uninit global addr: 0x601040 |
未初始化数据段(.bss) | g_unval是未初始化的全局变量,存放在.bss 段(程序加载时会被初始化为 0) |
printf("heap addr: %p\n", heap_mem);(4 次) |
heap addr: 0x2334030等 |
堆(heap) | malloc动态分配的内存位于堆,堆从低地址向高增长,所以多次malloc的地址依次增大 |
printf("test static addr: %p\n", &test); |
test static addr: 0x601038 |
已初始化数据段(.data) | test是初始化的局部 static 变量(static 变量不管是全局 / 局部,都存放在.data/.bss 段) |
printf("stack addr: %p\n", &heap_mem);(4 次) |
stack addr: 0x7ffd12604f18等 |
栈(stack) | heap_mem是 main 的局部变量,局部变量存放在栈;栈从高地址向低增长,所以后续局部变量的地址会更小 |
printf("read only string addr: %p\n", str); |
read only string addr: 0x400800 |
只读数据段(.rodata) | "helloworld"是字符串常量,属于只读数据,存放在.rodata 段(防止被修改) |
printf("argv[%d]: %p\n", i, argv[i]); |
argv[0]: 0x7ffd126057fc |
栈 / 参数区 | 命令行参数argv存放在栈的高地址区域,与栈地址范围接近 |
printf("env[%d]: %p\n", i, env[i]); |
env[0]: 0x7ffd12605803等 |
栈 / 环境变量区 |
2.虚拟地址
我们做两个实验
实验一:
我们将code.c代码变为
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
#include <sys/types.h>
int g_val = 0;
int main()
{
    pid_t id = fork();
    if(id < 0)
    {
        perror("fork");
        return 0;
    }
    else if(id == 0)
    { //child
        printf("child[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }
    else
    { //parent
        printf("parent[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }
    sleep(1);
    return 0;
}
运行结果:
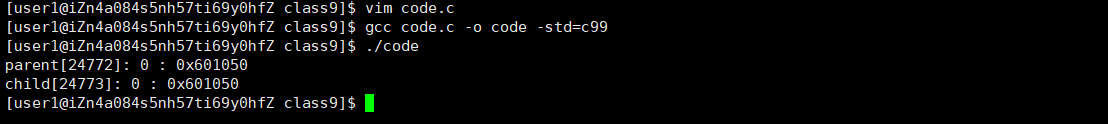
我们发现,输出出来的变量值和地址是⼀模⼀样的,很好理解呀,因为⼦进程按照⽗进程为模版,⽗⼦并没有对变量进⾏进⾏任何修改。可是将代码稍加改动:
实验二:
code.c代码:
cpp
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
#include <sys/types.h>
int g_val = 0;
int main()
{
    pid_t id = fork();
    if(id < 0)
    {
        perror("fork");
        return 0;
    }
    else if(id == 0)
    { //child,⼦进程肯定先跑完,也就是⼦进程先修改,完成之后,⽗进程再读取
        g_val=100;
        printf("child[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }
    else
    { //parent
        sleep(3);
        printf("parent[%d]: %d : %p\n", getpid(), g_val, &g_val);
    }
    sleep(1);
    return 0;
} 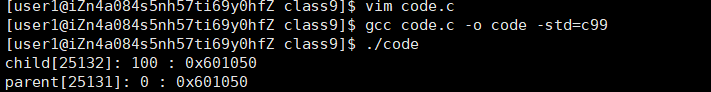
我们发现,⽗⼦进程,输出地址是⼀致的,但是变量内容不⼀样 !能得出如下结论:
• 变量内容不⼀样,所以⽗⼦进程输出的变量绝对不是同⼀个变量
• 但地址值是⼀样的,说明,该地址绝对不是物理地址!
• 在Linux地址下,这种地址叫做 虚拟地址
• 我们在⽤C/C++语⾔所看到的地址,全部都是虚拟地址!物理地址,⽤⼾⼀概看不到,由OS统⼀
管理
OS必须负责将 虚拟地址 转化成 物理地址
3.进程地址空间
在现代操作系统(如 Linux、Windows)的语境下,"进程地址空间" 和 "虚拟地址空间" 几乎是等价的 ------ 通常所说的 "进程地址空间",本质就是该进程的 "虚拟地址空间"
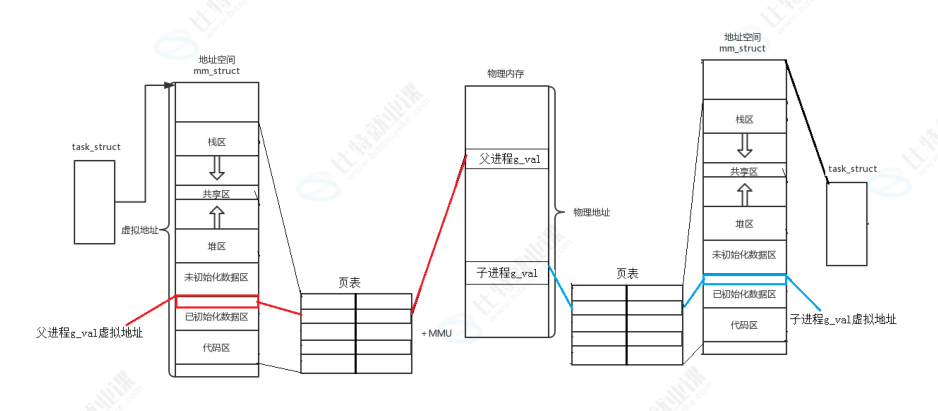
上⾯的图就⾜矣说明问题,同⼀个变量,地址相同,其实是虚拟地址相同,内容不同其实是被映
射到了不同的物理地址(这里会发生写实拷贝)
现在我们来详细讲解一下上图
我们有一个页表,其实我们每次常见一个进程,都会将页表的一侧写入虚拟地址空间,之后代码和数据加载到内存里面,将物理内存地址一一对应页表的另一侧(实现了一个虚拟地址对应一个物理地址),然后我们只需要调用虚拟地址空间就可以访问到物理内存
父进程创建了子进程,于是拷贝了一份task_struct与页表,所以两个进程的虚拟地址是一样的,解释了上面为什么打印出的地址一样的问题,由于子进程改变了数据段的数据,于是物理内存发生了写实拷贝,拷贝了一份g_val,将这个拷贝的地址替换子进程对应的虚拟地址的物理地址,于是就可以实现子进程虚拟地址访问到拷贝的g_val,父进程虚拟地址访问到原始的g_val,并且两个地址相同
简单记:父子进程 "虚拟地址相同" 是因为拷贝了页表和虚拟地址空间布局,"内容不同" 是因为写操作触发写实拷贝,替换了子进程的物理地址映射
4.虚拟内存管理
描述linux下进程的地址空间的所有的信息的结构体是 mm_struct (内存描述符)。每个进程只有⼀个mm_struct结构,在每个进程的 task_struct 结构中,有⼀个指向该进程的mm_struct结构体指
针
struct task_struct
{
/*...*/
struct mm_struct* mm; //对于普通的⽤⼾进程来说该字段指向他的虚拟地址空间的⽤⼾空间部分,对于内核线程来说这部分为NULL。
struct mm_struct* active_mm; // 该字段是内核线程使⽤的。当该进程是内核线程时,它的mm字段为NULL,表⽰没有内存地址空间,可也并不是真正的没有,这是因为所有进程关于内核的映射都是⼀样的,内核线程可以使⽤任意进程的地址空间。
/*...*/
}
可以说, mm_struct 结构是对整个⽤⼾空间的描述。每⼀个进程都会有⾃⼰独⽴的 mm_struct ,
这样每⼀个进程都会有⾃⼰独⽴的地址空间才能互不⼲扰。先来看看由 task_struct 到
mm_struct ,进程的地址空间的分布情况:
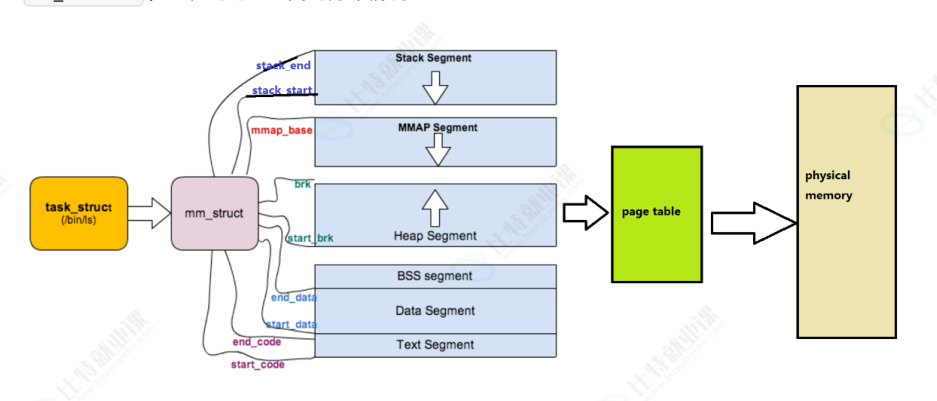
定位 mm_struct ⽂件所在位置和 task_struct 所在路径是⼀样的,不过他们所在⽂件是不⼀样
的, mm_struct 所在的⽂件是 mm_types.h
cpp
struct mm_struct
{
    /*...*/
    struct vm_area_struct *mmap;
    /* 指向虚拟区间(VMA)链表 */
    struct rb_root mm_rb;
    /* red_black树 */
    unsigned long task_size;
    /*具有该结构体的进程的虚拟地址空间的⼤⼩*/
    /*...*/
    // 代码段、数据段、堆栈段、参数段及环境段的起始和结束地址。
    unsigned long start_code, end_code, start_data, end_data;
    unsigned long start_brk, brk, start_stack;
    unsigned long arg_start, arg_end, env_start, env_end;
    /*...*/
}
那既然每⼀个进程都会有⾃⼰独⽴的 mm_struct ,操作系统肯定是要将这么多进程的 mm_struct
组织起来的!虚拟空间的组织⽅式有两种:
-
当虚拟区较少时采取单链表,由mmap指针指向这个链表;
-
当虚拟区间多时采取红⿊树进⾏管理,由mm_rb指向这棵树。
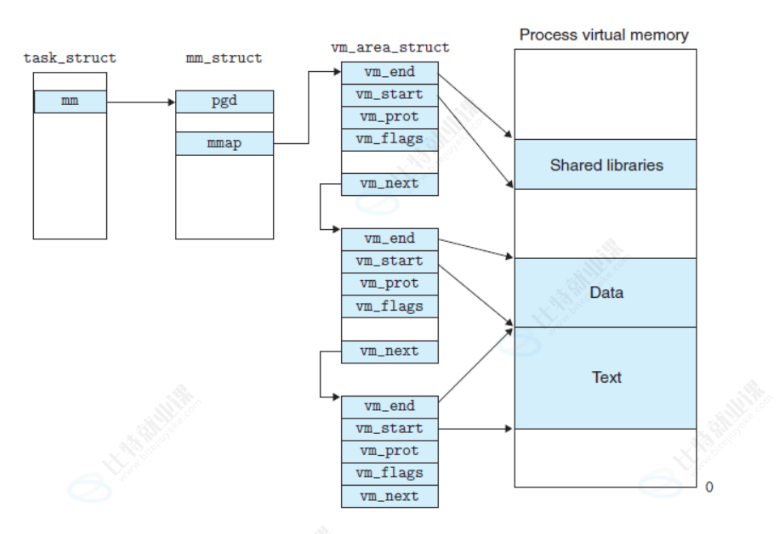
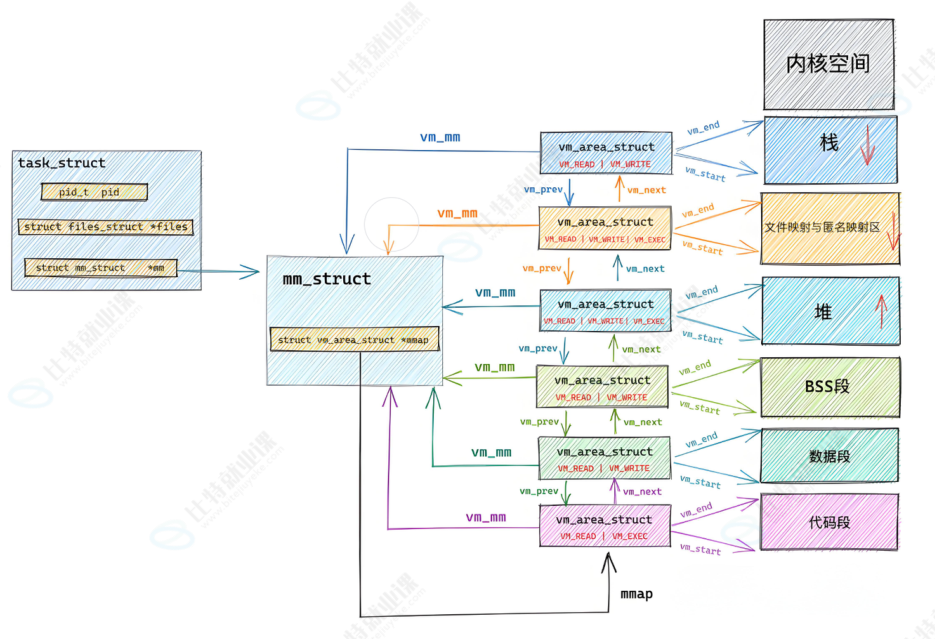
linux内核使⽤ vm_area_struct 结构来表⽰⼀个独⽴的虚拟内存区域(VMA),由于每个不同质的虚
拟内存区域功能和内部机制都不同,因此⼀个进程使⽤多个vm_area_struct结构来分别表⽰不同类型的虚拟内存区域。上⾯提到的两种组织⽅式使⽤的就是vm_area_struct结构来连接各个VMA,⽅便进程快速访问
linux内核源码:
cpp
struct vm_area_struct {
    unsigned long vm_start; //虚存区起始
    unsigned long vm_end;
    //虚存区结束
    struct vm_area_struct *vm_next, *vm_prev;
    //前后指针
    struct rb_node vm_rb;
    //红⿊树中的位置
    unsigned long rb_subtree_gap;
    struct mm_struct *vm_mm;
    //所属的 mm_struct
    pgprot_t vm_page_prot;
    unsigned long vm_flags;
    //标志位
    struct
    {
        struct rb_node rb;
        unsigned long rb_subtree_last;
    } shared;
    struct list_head anon_vma_chain;
    struct anon_vma *anon_vma;
    const struct vm_operations_struct *vm_ops; //vma对应的实际操作
    unsigned long vm_pgoff;
    //⽂件映射偏移量
    struct file * vm_file;
    //映射的⽂件
    void * vm_private_data;
    //私有数据
    atomic_long_t swap_readahead_info;
#ifndef CONFIG_MMU
    struct vm_region *vm_region;
    /* NOMMU mapping region */
#endif
#ifdef CONFIG_NUMA
    struct mempolicy *vm_policy;
    /* NUMA policy for the VMA */
#endif
    struct vm_userfaultfd_ctx vm_userfaultfd_ctx;
} __randomize_layout;
所以我们可以对上图在进⾏更细致的描述,如下图所⽰:
5.为什么要有虚拟地址空间
这个问题其实可以转化为:如果程序直接可以操作物理内存会造成什么问题?
在早期的计算机中,要运⾏⼀个程序,会把这些程序全都装⼊内存,程序都是直接运⾏在内存上的,也就是说程序中访问的内存地址都是实际的物理内存地址。当计算机同时运⾏多个程序时,必须保证这些程序⽤到的内存总量要⼩于计算机实际物理内存的⼤⼩
那当程序同时运⾏多个程序时,操作系统是如何为这些程序分配内存的呢?例如某台计算机总的内存⼤⼩是128M,现在同时运⾏两个程序A和B,A需占⽤内存10M,B需占⽤内存110M。计算机在给程序分配内存时会采取这样的⽅法:先将内存中的前10M分配给程序A,接着再从内存中剩余的118M中划分出110M分配给程序B
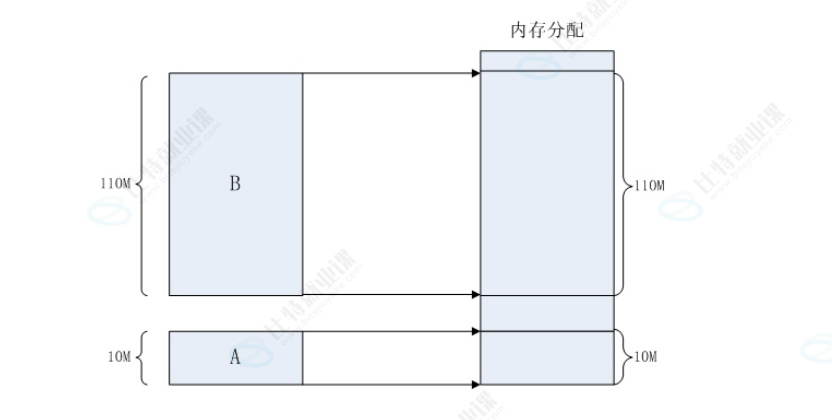
这种分配⽅法可以保证程序A和程序B都能运⾏,但是这种简单的内存分配策略问题很多。
安全⻛险
每个进程都可以访问任意的内存空间,这也就意味着任意⼀个进程都能够去读写系统相关内
存区域,如果是⼀个⽊⻢病毒,那么他就能随意的修改内存空间,让设备直接瘫痪。
地址不确定
众所周知,编译完成后的程序是存放在硬盘上的,当运⾏的时候,需要将程序搬到内存当中
去运⾏,如果直接使⽤物理地址的话,我们⽆法确定内存现在使⽤到哪⾥了,也就是说拷⻉
的实际内存地址每⼀次运⾏都是不确定的,⽐如:第⼀次执⾏a.out时候,内存当中⼀个进程
都没有运⾏,所以搬移到内存地址是0x00000000,但是第⼆次的时候,内存已经有10个进程
在运⾏了,那执⾏a.out的时候,内存地址就不⼀定了
效率低下
如果直接使⽤物理内存的话,⼀个进程就是作为⼀个整体(内存块)操作的,如果出现物理
内存不够⽤的时候,我们⼀般的办法是将不常⽤的进程拷⻉到磁盘的交换分区中,好腾出内
存,但是如果是物理地址的话,就需要将整个进程⼀起拷⾛,这样,在内存和磁盘之间拷⻉
时间太⻓,效率较低
存在这么多问题,有了虚拟地址空间和分⻚机制就能解决了吗?当然!
地址空间和⻚表是OS创建并维护的!是不是也就意味着,凡是想使⽤地址空间和⻚表进⾏映射,
也⼀定要在OS的监管之下来进⾏访问!!也顺便保护了物理内存中的所有的合法数据,包括各个
进程以及内核的相关有效数据!
因为有地址空间的存在和⻚表的映射的存在,我们的物理内存中可以对未来的数据进⾏任意位置
的加载!物理内存的分配 和 进程的管理 就可以做到没有关系 ,进程管理模块和内存管理模块就完
成了解耦合
因为有地址空间的存在,所以我们在C、C++语⾔上new, malloc空间的时候,其实是在地址
空间上申请的,物理内存可以甚⾄⼀个字节都不给你。⽽当你真正进⾏对物理地址空间访问
的时候,才执⾏内存的相关管理算法,帮你申请内存,构建⻚表映射关系(延迟分配),这
是由操作系统⾃动完成,⽤⼾包括进程完全0感知!!
因为⻚表的映射的存在,程序在物理内存中理论上就可以任意位置加载。它可以将地址空间上的
虚拟地址和物理地址进⾏映射,在进程视⻆所有的内存分布都可以是有序的