标题
Time-series monitoring and prediction of cyanobacteria blooms based on FY3D/MERSI data.
基于 FY3D/MERSI 数据的蓝藻水华时序监测与预测
背景
作者
张若琳,王萌,孟庆岩,孙云晓,原喜屯,张琳琳,吴晗天,孙震辉,王佳龙
期刊来源
China Environmental Science
摘要
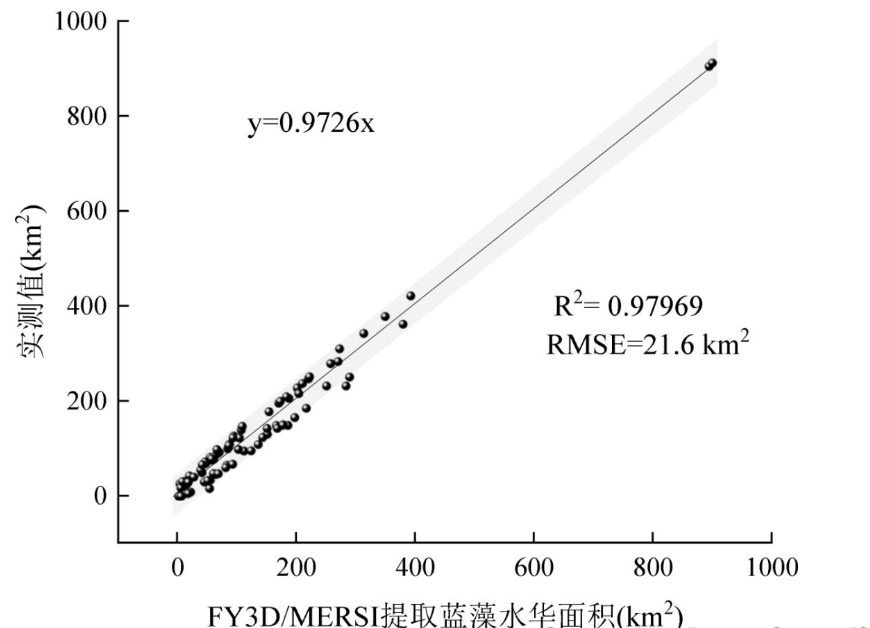
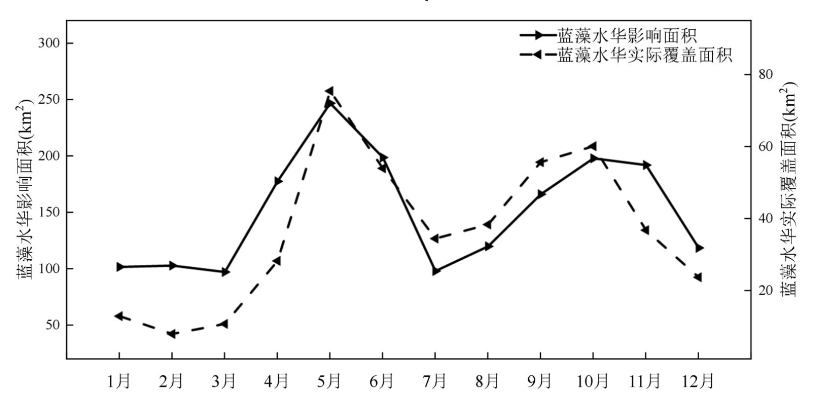
蓝藻水华频发对湖泊生态与水环境安全构成严重威胁.Landsat、Sentinel 等遥感平台因时间分辨率较低,难以实现蓝藻水华的连续动态监测;而基于FY 卫星数据的蓝藻监测与预测普遍存在监测维度单一、预测模型依赖单一类型变量等问题,难以全面刻画水华时空演变特征及捕捉多因子复杂耦 合效应.鉴于此,本研究基于 FY3D/MERSI 高时间分辨率遥感数据,构建太湖蓝藻水华多维度时序监测与预测体系.研究结合遥感指数与大津算法提取蓝 藻水华信息,通过像元级与亚像元级双尺度计算量化面积,并从强度、频率、暴发程度等维度系统分析 2019---2023 年太湖蓝藻水华时空特征.同时整合 气象与水质因子,构建 BP 神经网络模型预测水华面积.研究结果表明,利用 FY3D/MERSI 数据提取水华具有较高精度,与实测数据的决定系数 R²达 0.98, 均方根误差为 21.6 km².太湖蓝藻水华面积呈季节性双峰特征,峰值出现在 5 月和 10 月;水华等级以轻度和中度为主,重度水华全年维持低水平;西部、 南部沿岸及湖心区暴发频率显著高于东部,夏秋季节暴发频率较高;年际暴发程度呈逐步减弱趋势,2023 年"无蓝藻水华"占比升至 89%.相关性分析显 示,温度、相对湿度等因子促进水华暴发,浊度、荧光可溶性有机物等起抑制作用.BP 神经网络模型验证集均方根误差为 27.07 km²,皮尔逊相关系数 0.94,83%的样本预测误差控制在±25 km²内,多项指标表明该模型能够有效捕捉蓝藻水华面积动态变化趋势.
研究区域以及数据来源
太湖作为我国第三大淡水湖泊,是长江三角洲地区社会经济发展的重要水资源.受气候变暖和人为活动 的影响,太湖长期面临富营养化问题的挑战。
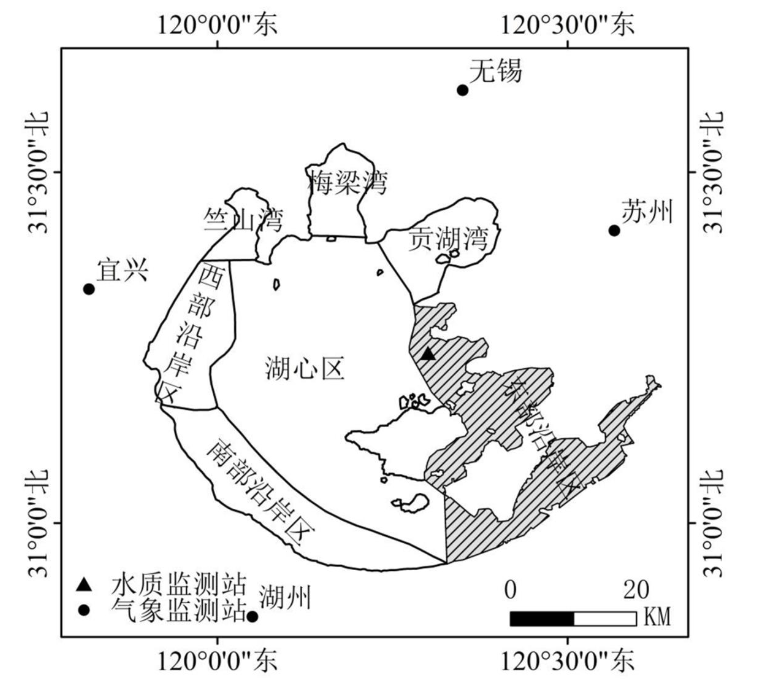
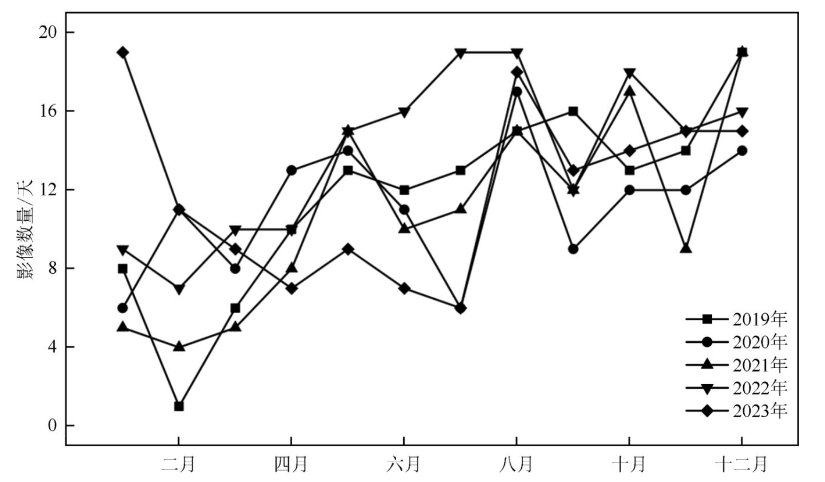
研究采用 FY3D/MERSI L1 级遥 感影像数据,通过国家气象卫星中心官网完成批量下载.为确保数据质量,筛选了 2019-2023 年间云量较小、质量较高的影像数据,共计 712 景,对这些影像进行了辐射定标、大气校正、几何 精纠正等预处理操作,以保证数据的质量和可靠性.
本研究所用气象数据来源于中国气象数据网,选取无锡、湖州、苏州和宜兴四个站点 的监测数据,并计算其平均值作为代表太湖区域气象特征的基础数据。水质数据来源于陆地卫星观测共性应用支撑平台。
算法
决策树构建
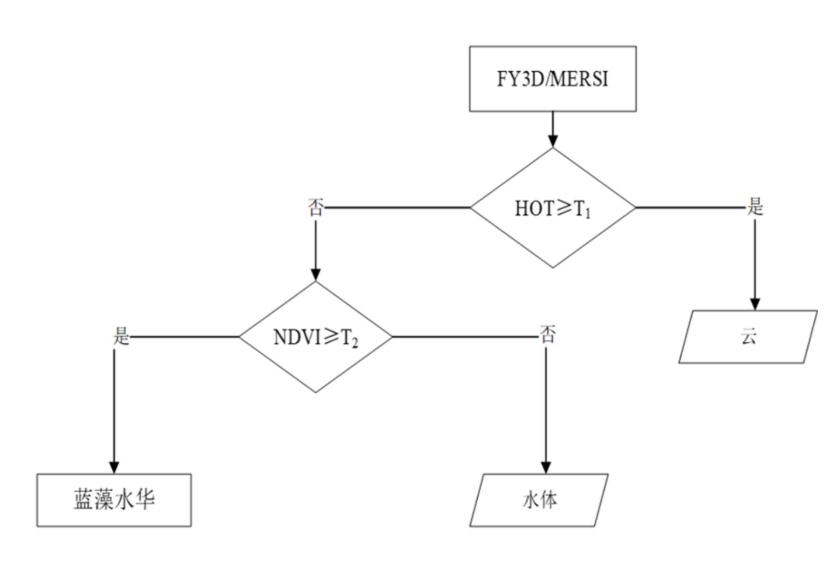
采用知识决策树分类方法提取蓝藻水华信息.决策树建立过程中首先基于已知的目标类别,如蓝藻水华和非蓝藻水华,对每个类别的特征进行分析,并将其信息整合为决策树的节点.每个节点代表一个特定的特征条件,基于这些条件对影像样本进行分类。
针对FY3D/MERSI数据,通过使用HOT和 NDVI遥感指数作为节点构建决策树。
蓝藻水华强度监测
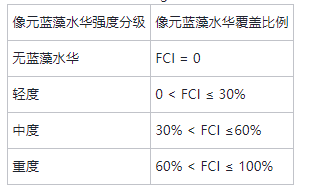
蓝藻水华的强度通过蓝藻水华覆盖度指数进行评估,用于表征单个像元 内蓝藻水华的覆盖比例,反映蓝藻在水体表面的分布程度.根据《卫星遥感监测技术导则蓝藻水华》,基于 FCI值将蓝藻水华强度划分为四个等级:无蓝藻水华、轻度、中度和重度。
蓝藻水华与环境因子相关性分析
蓝藻水华面积的季节性变化受气象与水质因子的综合影响,各因子通过不同机制作用于蓝藻的生长与分布.为量化这种相关性,本研究采用皮尔逊相关系数分析蓝藻水华面 积与气象因子(温度、风速、气压等)及水质因子(水温、电导率、浊度等)之间的关联程度.皮尔逊相关系数由 统计学家卡尔·皮尔逊提出,是用来度量两个定量变量间线性相关性的经典统计指标.该方法通过 r 或 ρ 定量 描述变量间直线相关的方向和密切程度,其计算公式如下:
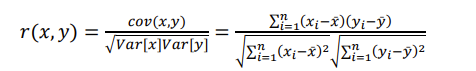
r(x, y)为 x 和 y 的相关系数的值,cov(x, y)为 x 和 y 的协方差,n 为样本数量的大小,x为 x 的均值;y为 y 的均值.相关系数的值域为-1,1,其中 r 接近 1 表明两变量呈强正相关,接近-1 表明两变量呈强负相关,越趋 近于 0 表明相关性越弱.
BP神经网络预测模型
BP神经网络, 属于多层前馈神经网络,具有高度的非线性映射能力 .该网络由输入层、隐含层和输出层组成,三层之间的 神经元相互连接,即全连接.输入层和输出层均属于单层结构,隐含层则是既能单层又能多层.在不限制隐含 节点数的情况下,单层的BP神经网络可实现任意非线性映射。
首先,构建蓝藻面积和影响因子的样本数据集并进行归一化处理;接着,将数 据输入神经网络并随机设置初始参数;然后,进行神经网络训练,输出预测结果并判断是否达到最大迭代次数. 如果未达到,则返回数据输入步骤;若已达到,则按步长为 1 逐步增加隐含层神经元的数量,并评估该数量是否 超出预设范围.若超出,则终止训练;若未超出,则返回数据输入步骤.训练完成后比较各神经网络的预测值与 蓝藻面积真实值之间的均方根误差,最终选择均方根误差最小的网络作为预测模型,输出预测结果。
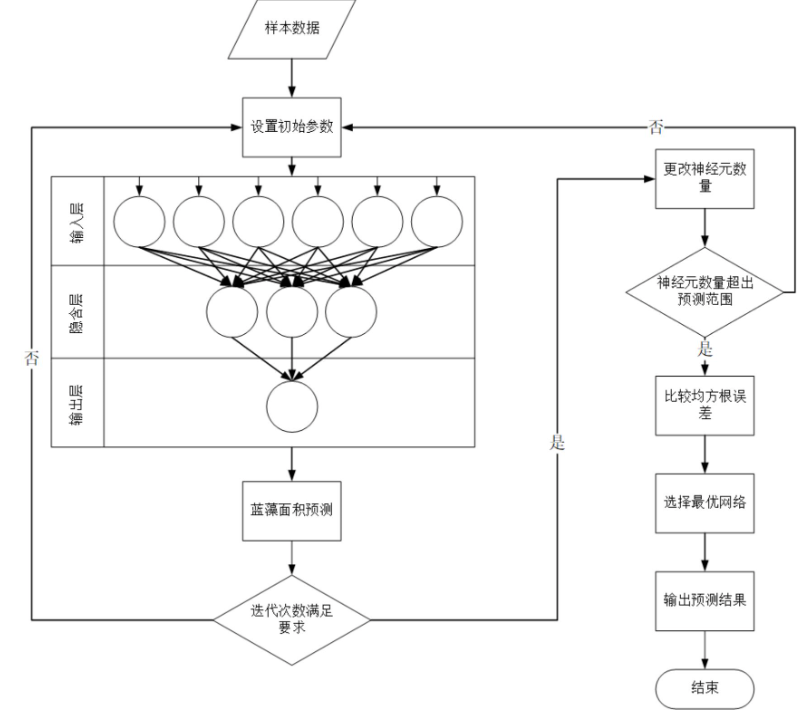
使用的训练算法为莱文伯格-马夸特算法 ,学习率设置为 0.01.输入层和隐含层间的激励函数采用 sigmoid 函数,隐含层与输出层间选取线性函数 Purelin 作为传递函数.神经元数量为:输入层为气象水质因子个数、隐含层神经元 5~30 个、输出层 1 个(即太湖蓝藻水华面积).每一神经元数量 下设置迭代次数为 1000 次。
使用均方根误差和决定系数作为蓝藻水华预测模型的精度评价指标,计算公式如下:
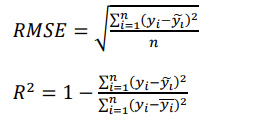
式中,yi表示真实值,ỹi表示预测值,y̅i表示真实值的平均值,n 表示样本数量。
结果分析
结果显示,遥感提取面积与江苏省环境监测中心监 测的蓝藻水华面积高度一致。
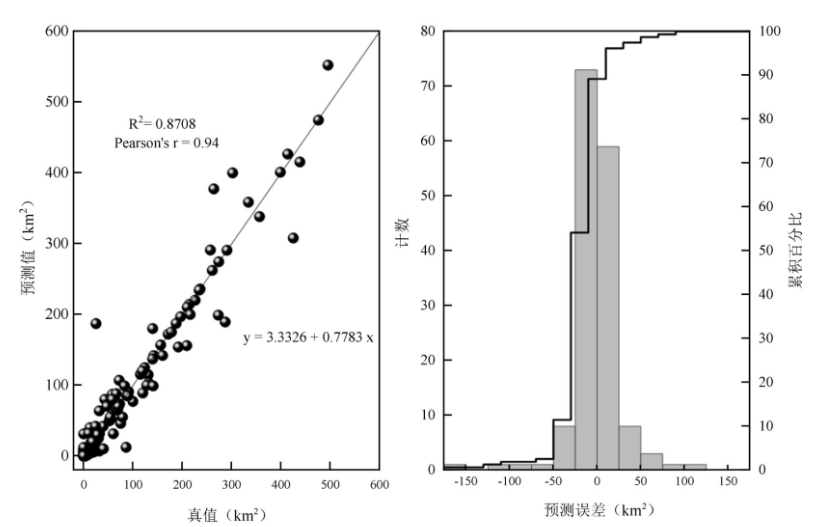
本研究采用 2022---2023 年的样本验证模型对蓝藻水华面积的预测能力. 结果,预测值与真值的决定系数为 0.87,表明模型能够解释该时段蓝藻水华面积变化中 87%的方差,在大部分样本中预测值与真实值拟合度良好,具备较强的预测能力.皮尔逊相关系数为 0.94,均方根误差为 27.07 km², 模型性能稳定且预测结果准确.部分散点在高值区域出现一定偏差,可能与极端数据的不均衡分布或复杂的 非线性关系相关.所选神经网络预测误差范围为-161,95 km2 ,约 83%的样本预测误差处于-25,25 km2 区间 内,预测结果与真实蓝藻面积一致性良好;仅有 2%的样本预测误差高于 100 km2 ,预测误差较小且异常值较少. 综上所述,所训练的模型能够较为准确地反映蓝藻面积的变化趋势。