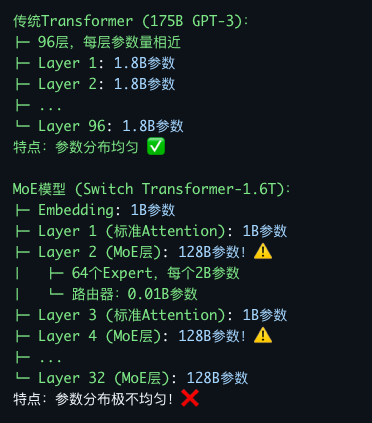
MoE 区别于传统的 Transformer 是其参数分布极为不均
传统Transformer (175B GPT-3):
├─ 96层,每层参数量相近
├─ Layer 1: 1.8B参数
├─ Layer 2: 1.8B参数
├─ ...
└─ Layer 96: 1.8B参数
特点:参数分布均匀 ✅

MoE模型 (Switch Transformer-1.6T):
├─ Embedding: 1B参数
├─ Layer 1 (标准Attention): 1B参数
├─ Layer 2 (MoE层): 128B参数!⚠️
│   ├─ 64个Expert,每个2B参数
│   └─ 路由器:0.01B参数
├─ Layer 3 (标准Attention): 1B参数
├─ Layer 4 (MoE层): 128B参数!⚠️
├─ ...
└─ Layer 32 (MoE层): 128B参数
特点:参数分布极不均匀!❌
如果使用 ZeRO-3,当计算的时候all-gather 所有模型参数,如果 expert 数量很多,例如 64 个,那么总显存可能带 256G, 远超一个 GPU所能承载的
Expert Parallelism
核心思想
Expert并行 (EP):
不同GPU负责不同的Expert
只加载被本GPU负责的Expert参数
Token根据路由结果发送到对应GPU
配置:EP=64(64个GPU,每个负责1个Expert)
参数分配:
├─ GPU 0: Expert 0 (2GB)
├─ GPU 1: Expert 1 (2GB)
├─ GPU 2: Expert 2 (2GB)
├─ ...
└─ GPU 63: Expert 63 (2GB)每个GPU显存占用:
- Expert参数:2GB(只有1个Expert)✅
- 共享层参数:1GB(Attention等)
- 激活值:根据收到的token数量
Pytorch分布式训练/多卡训练(六) —— Expert Parallelism (MoE的特殊策略)
hxxjxw2025-12-18 17:58
相关推荐
秦先生在广东2 分钟前
去中心化与全能化:深入剖析 Open WebUI 的自托管架构与工程实践IvorySQL3 分钟前
PostgreSQL 日报|堆表选择性索引更新(10 月 13 日)蜗牛互联网6 分钟前
Java 17 调用视觉 Responses API:JSON 约束与人工复核路由秦先生在广东6 分钟前
Agent 驱动的逆向工程工作流:REA 全栈二进制与多格式分析工具深度解析2603_9688173410 分钟前
AI视频怎么超清增强frankzch15 分钟前
微软 137B 编码模型搬到 PC:端侧推理与 Agent 权限防线外收内放20 分钟前
Python基础语法练习题(69)TomEval25 分钟前
【测AI】第11篇:深度学习基础 —— 神经网络是怎么工作的zhang-ge27 分钟前
python包和项目管理器uv在ubuntu下的安装与使用老金带你玩AI31 分钟前
Gemini 4上线!又回到御三家了?