本文解决,数据量太大,数据种类多,表格之间逻辑混乱的问题
从事数据分析的数据专员已经数马上两年了说一些数据开发的做表心得
在大数据开发中有表都是有明确的属性划分的,事实表,维度表,
事实表里面放的大部分都是度量,这个表记录了企业做的动作,如销售的订单明细,如销售时间,成交金额,成交件数,等,记录的都是企业发生的事实,可以进行计算,因为记录的是事实,所以这个表的主键不能有重复,比如一个不可能在同一个时间做多个事情,维度表就是对描述业务实体属性包含描述性字段,用于分组和筛选,如主档表,商品信息表等,还有一个就是链接表,记录的是表与表之间的关系
总结如下所示
一、基本表类型对比
| 表类型 | 作用 | 特点 | 示例 |
|---|---|---|---|
| 事实表 | 存储业务度量值(可累加的数字) | 包含外键和度量字段,记录业务事实 | 销售事实表:订单ID、产品ID、客户ID、销售金额、销售数量 |
| 维度表 | 描述业务实体属性 | 包含描述性字段,用于分组和筛选 | 产品维度表:产品ID、产品名称、类别、品牌、价格 |
| 桥接表 | 解决多对多关系 | 连接事实表和维度表 | 订单产品桥接表:订单ID、产品ID、数量 |
所以当表多的时候我们在PQ中就要对表进行分组了,把每种类型的表放在同一个文件夹下,最好不要在PQ对表进行合并,你那样表的清洗运行会变慢。我们想要吧不同类型的表放哪一起进行透视,我们要在PP中进行连接,进行表关系的创建,逻辑链接这样避免了PQ进行表连接速度会块一些,用PP进行建模在逻辑上吧表连接在一起。
最佳实践总结
| 操作 | 建议位置 | 原因 |
|---|---|---|
| 数据清洗 | Power Query | 一次性处理,避免重复工作 |
| 表连接 | Power Pivot | 逻辑关系,查询性能好 |
| 复杂计算 | DAX(Power Pivot) | 计算效率高,可复用 |
| 简单计算 | Power Query | 减少模型复杂度 |
说到了表之间的连接,就牵扯到了数据的模型,我们说一下模型
二、数据模型架构
| 模型类型 | 结构特点 | 适用场景 | 优缺点 |
|---|---|---|---|
| 星型模型 | 1个事实表 + 多个维度表直接连接 | 简单查询、快速响应 | 优点:简单易理解,查询性能好 缺点:数据冗余,维度更新复杂 |
| 雪花模型 | 维度表进一步规范化,形成层次结构 | 复杂分析、数据一致性要求高 | 优点:数据冗余少,维护方便 缺点:查询性能较差,连接复杂 |
| 星座模型 | 多个事实表共享维度表 | 多主题分析、企业级数据仓库 | 优点:支持复杂分析,数据共享 缺点:设计复杂,维护成本高 |
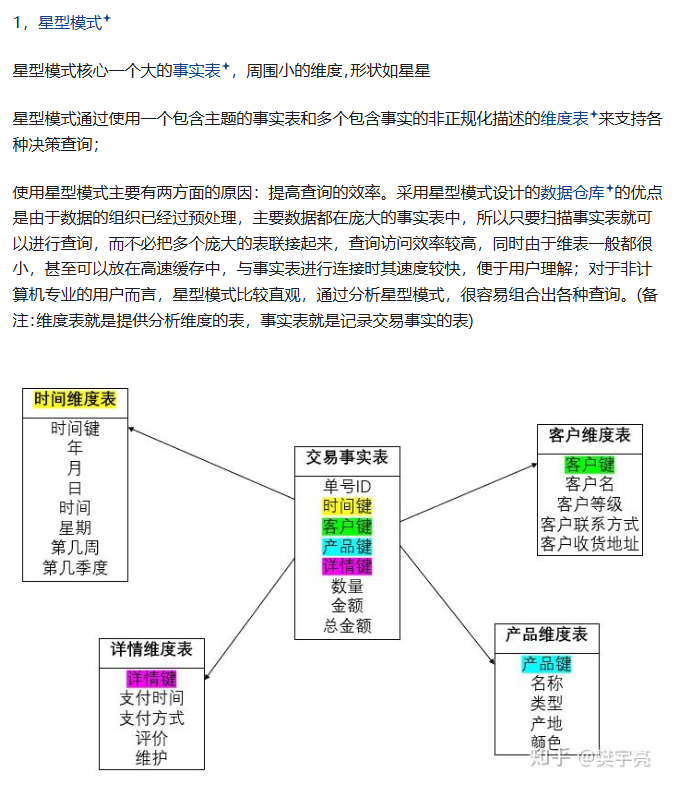
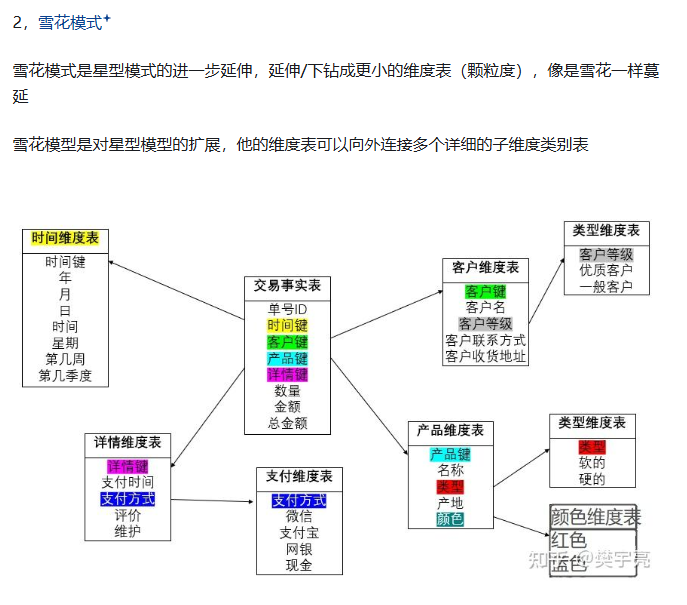
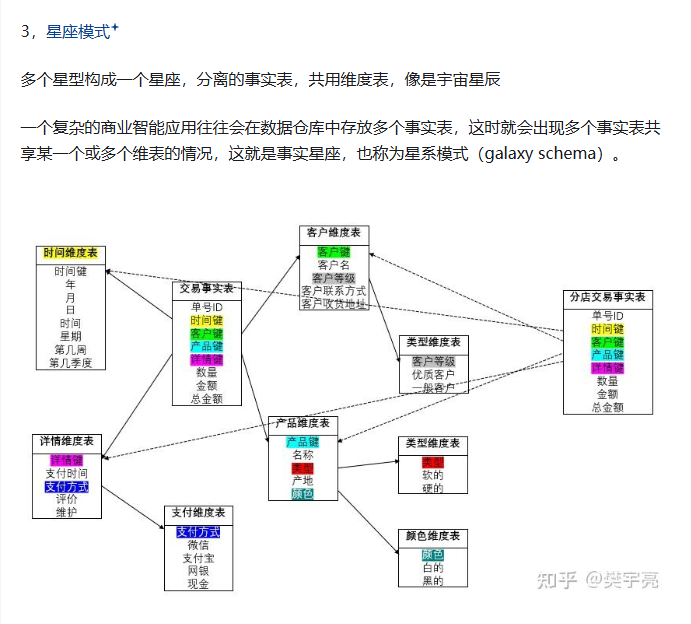
可以这样说,模型的建模搭建是要考虑最多的事情,这个直接影响了整体的数据工作,
对一模型的构建与链接,最重要的就是主键,所以我们要拉齐所有表之间的维度,除了维度,还要考虑分析的主题和计算的指标,以及数据源的最小颗粒度,定义事实表记录的最小单位
最终根据事实表和维度表的数量,以及分析主题,表格维度等,进行模型的选择和连接
1. 主键设计的黄金法则
-
唯一性:主键必须唯一标识每条记录
-
稳定性:主键值不应随时间变化(避免使用业务含义字段)
-
简洁性:尽量使用整数类型,减少存储和连接开销
-
代理键:建议使用自增ID作为主键,而非业务主键
2. 维度一致性(Conformed Dimensions)
-
共享维度:多个事实表应使用相同的维度表(如时间维度、产品维度)
-
属性统一:相同维度在不同事实表中的定义和粒度必须一致
-
跨主题分析:维度一致性是实现跨业务主题分析的基础
3. 粒度定义的关键考虑
-
业务需求驱动:粒度越细,分析越灵活,但数据量越大
-
存储成本:评估存储空间和查询性能的平衡
-
可扩展性:预留足够的粒度,避免后期重构
三. 模型选择的决策矩阵
| 因素 | 星型模型 | 雪花模型 | 星座模型 |
|---|---|---|---|
| 查询性能要求 | 高 | 低 | 中 |
| 数据一致性要求 | 中 | 高 | 高 |
| 维度变化频率 | 低 | 高 | 中 |
| 存储空间限制 | 无 | 有 | 中 |
| 分析主题数量 | 单一 | 单一 | 多个 |
四、三种模型对比总结
| 对比维度 | 星型模型 | 雪花模型 | 星座模型 |
|---|---|---|---|
| 结构复杂度 | 简单 | 复杂 | 最复杂 |
| 查询性能 | 最优 | 最差 | 中等 |
| 数据冗余 | 高 | 低 | 中等 |
| 维护难度 | 中等 | 简单 | 复杂 |
| 存储空间 | 大 | 小 | 中等 |
| 适用场景 | 单一主题快速分析 | 数据一致性要求高 | 企业级多主题分析 |
| 扩展性 | 差 | 中等 | 好 |
| 查询性能要求 | 高 | 低 | 中 |
| 数据一致性要求 | 中 | 高 | 高 |
| 维度变化频率 | 低 | 高 | 中 |
| 存储空间限制 | 无 | 有 | 中 |
| 分析主题数量 | 单一 | 单一 | 多个 |
| 事实表 | 1张或多张 | 1张或多张 | |
| 维度表 | 一级维表 | 多层级维表 | |
| 数据总量 | 多 | 少 | |
| 数据冗余度 | 高 | 低 | |
| 可读性 | 高 | 低 | |
| 表个数 | 少 | 多 | |
| 表宽度 | 宽 | 窄 | |
| 查询逻辑 | 简单 | 复杂 |
五、建模步骤
| 步骤 | 内容 | 关键产出 |
|---|---|---|
| 1. 业务需求分析 | 确定分析主题和指标 | 业务指标清单 |
| 2. 确定粒度 | 定义事实表记录的最小单位 | 事实表粒度说明 |
| 3. 识别维度 | 确定分析角度 | 维度表结构 |
| 4. 识别事实 | 确定度量指标 | 事实表度量字段 |
| 5. 模型设计 | 选择星型/雪花/星座模型 | 数据模型图 |
| 6. 物理实现 | 建表、ETL开发 | 物理表结构 |
所以我们数据量大计算时间长的时候,就可以考虑吧数据分组,不在PQ中进行物理连接,而在PP的模型中进行逻辑链接,建模,梳理好表之间的关系,这样就避免了指标计算的混乱,提升了数据计算的性能,件单明确的指标可以用PQ进行处理,复杂的指标用PP的度量值进行处理,做超级透视表