2024年EMNLP上,滑铁卢大学团队提出的文档截图嵌入(Document Screenshot Embedding, DSE) 范式,为这一痛点提供了颠覆性解决方案。该方法将任意文档转化为截图作为统一输入,无需任何内容提取预处理,直接通过视觉语言模型编码为密集向量,完美保留文档的文本、图像、布局等全部信息。
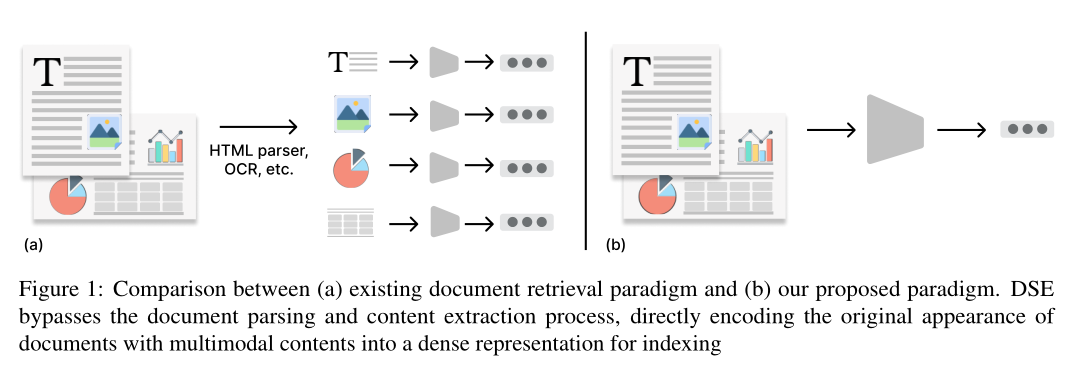
在信息爆炸的时代,我们面临的文档形态日益多元------网页、PDF、幻灯片等载体中,文本、图像、图表、表格等模态交织共存。传统检索系统却始终受制于"分而治之"的逻辑:HTML需要解析器、PDF依赖OCR、图像单独处理,不仅预处理流程繁琐易错,还会不可逆地丢失文档原始布局和视觉上下文信息。
2024年EMNLP上,滑铁卢大学团队提出的文档截图嵌入(Document Screenshot Embedding, DSE) 范式,为这一痛点提供了颠覆性解决方案。该方法将任意文档转化为截图作为统一输入,无需任何内容提取预处理,直接通过视觉语言模型编码为密集向量,完美保留文档的文本、图像、布局等全部信息。
论文地址:https://aclanthology.org/2024.emnlp-main.373.pdf01、研究背景:传统检索的两大核心痛点
现有文档检索系统无论采用传统 lexical 方法还是神经模型,都存在难以逾越的局限:
1. 预处理繁琐且易出错
不同格式文档(HTML、PDF、幻灯片)需要定制化解析工具,如HTML的结构解析、PDF的OCR文本提取、表格的单独处理。现实中,野生HTML结构复杂、幻灯片布局多样,单一工具难以精准提取全部信息,且长期维护多模态处理流程成本极高。
2. 视觉上下文与布局信息丢失
文档的视觉呈现本身承载着关键语义:标题的字号、图表的位置、文本的排版,都在暗示信息的重要性层级。而传统方法通过提取文本或拆分图像单元进行处理,彻底破坏了这种视觉完整性,导致检索时丢失核心上下文线索。
3. 多模态缺乏统一编码范式
现有多模态检索仍依赖"文本+图像"的分离编码,无法将文档作为一个有机整体建模,面对混合模态文档时检索效果受限。
为此,DSE的核心思路应运而生:既然文档的原始形态包含所有信息,何不直接将其作为检索的最小单元? 截图作为一种通用载体,能轻松覆盖各类文档格式,且完整保留视觉与布局信息。
02、核心贡献:范式创新+数据集支撑
1. 提出DSE统一检索范式
首次将文档截图作为多模态检索的统一输入格式,无需任何内容提取预处理,直接通过视觉语言模型(VLM)编码为密集向量,实现"截图输入→向量编码→相似度匹配"的端到端检索流程。
2. 构建两大大规模评估数据集
- Wiki-SS:130万张维基百科网页截图,覆盖文本密集型文档场景,用于验证DSE对纯文本信息的编码能力。
- SlideVQA-Open:5万张幻灯片截图,包含丰富的文本-图像混合内容(图表、复杂布局),用于评估混合模态检索性能。
03、核心贡献:范式创新+数据集支撑
现有数据集多为"文本+图像"分离存储,缺乏对文档整体视觉结构的保留,且规模较小。为此,研究团队构建了两个针对性数据集:
Wiki-SS:文本密集型截图数据集
- 构建方式:使用Selenium工具自动访问英文维基百科页面,以980×980像素窗口截图,确保覆盖核心内容。截图时间跨度为2024年5月20-23日,保证数据时效性。
- 存储优化:完整维基百科截图需2TB以上存储空间,因此通过BM25筛选"有效样本":将每个NQ数据集的问题+答案作为查询,检索前50个相关文档,最终保留1,267,874张截图,确保包含正样本和困难负样本。
- 文本对照集:基于2024年5月20日维基百科dump,使用mwparserfromhell工具提取前500词(匹配截图内容覆盖范围),构建文本检索基线的对照语料。
SlideVQA-Open:混合模态幻灯片数据集
- 来源改造:将原始SlideVQA(14.5k问答对、52k幻灯片)转换为开放域检索任务,需从5万张幻灯片中检索相关样本。
- 数据清洗:删除无法下载的幻灯片和无证据幻灯片的问题,最终保留50,714张幻灯片和2,136个测试问题。
- 文本对照集:使用pytesseract OCR提取幻灯片文本,构建OCR-based检索基线。
04、DSE核心方法:截图→编码→检索的全流程解析
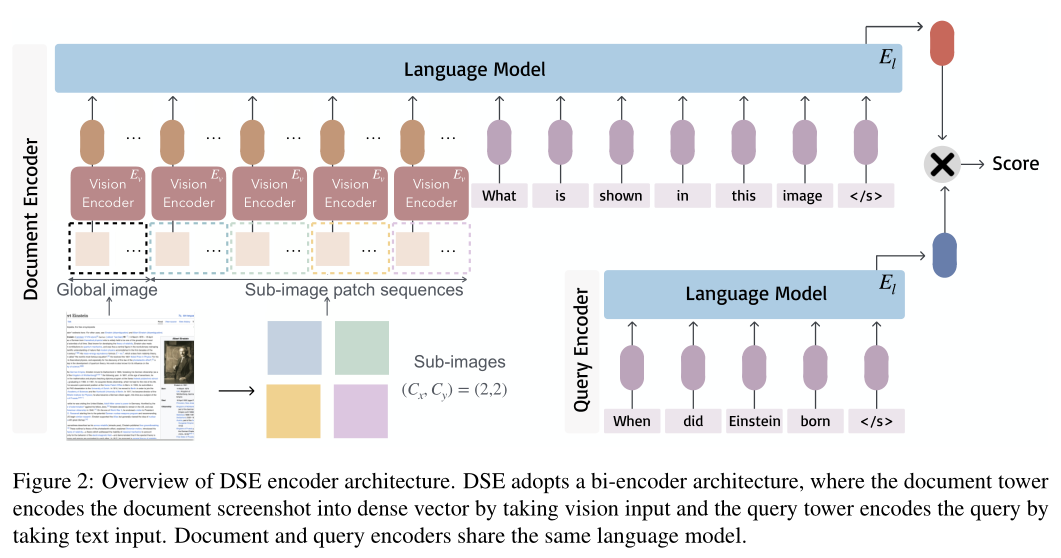
DSE的核心是双编码器架构,分别处理文档截图和文本查询,通过对比学习优化相似度匹配。
任务定义
给定查询Q和文档截图集合,检索与Q最相关的k个文档,相似度由余弦相似度衡量:
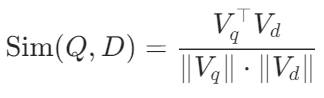
模型架构详解
(1)视觉编码器:捕捉细粒度视觉信息
-
基础模型:采用clip-vit-large-patch14-336,将截图缩放至336×336像素,划分为24×24个patch(共576个),每个patch通过线性投影生成嵌入。
-
优化方案:针对长文本截图的细粒度捕捉问题,引入Phi-3-vision模型,将截图裁剪为
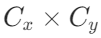
个子图像(如4×4),每个子图像独立编码为576个patch嵌入,同时保留全局截图的576个patch嵌入,最终生成
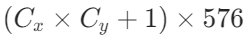
个patch嵌入,兼顾局部细节与全局信息。
(2)语言模型:融合视觉与文本语义
-
输入构造:将patch嵌入序列与提示词拼接:
<s><img> What is shown in this image?</s>,其中<img>占位符替换为patch嵌入序列。 -
嵌入生成:使用语言模型最后一个隐藏层的
</s>标记嵌入作为文档截图的最终向量表示: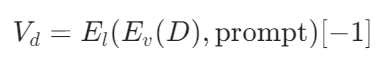
其中

是视觉编码器,
是语言编码器。
(3)查询编码:文本到向量的映射
文本查询通过模板<s>{query}</s>输入语言模型,同样取</s>标记的嵌入作为查询向量:
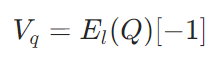
(4)对比学习训练
损失函数:采用InfoNCE损失,优化正样本文档与查询的相似度,抑制负样本文档(含困难负样本和批次内负样本):
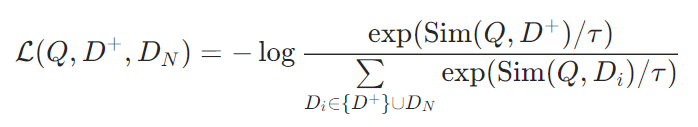
05、实验结果:全方位验证DSE的优越性
实验设置了两大核心任务:文本密集型网页检索(Wiki-SS+NQ)和混合模态幻灯片检索(SlideVQA-Open),对比基线包括BM25、DPR、E5、Phi-3(文本检索)和CLIP(视觉检索)。
监督检索效果:碾压传统方法
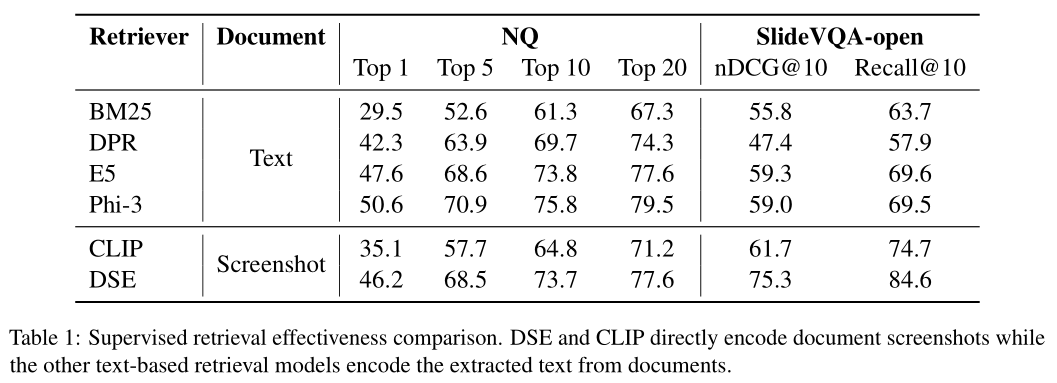
- 文本密集型任务(NQ):DSE 比 BM25 高 17 个 Top-1 准确率,与 E5 性能相当,仅略低于 Phi-3(4 个百分点),证明其能有效编码截图中的文本信息。
- 混合模态任务(SlideVQA):DSE 大幅领先所有文本基线(超 15 个 nDCG@10),比 CLIP 高 12.6 个 nDCG@10,凸显视觉上下文保留的核心价值 ------OCR 方法丢失图表、布局信息,而 DSE 完整捕捉混合模态语义。
零样本泛化能力:跨数据集/跨任务的通用性
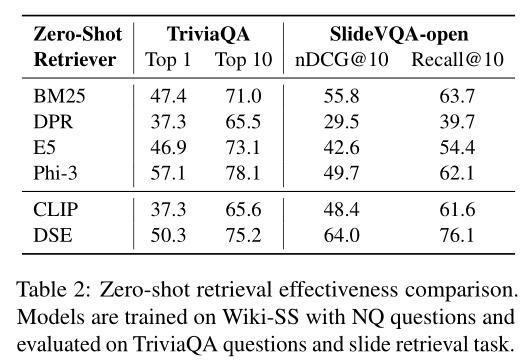
- 跨数据集泛化(TriviaQA):DSE比BM25高3个Top-1准确率,远优于DPR和CLIP,显示对不同查询分布的适应性。
- 跨任务泛化(SlideVQA):DSE是唯一优于BM25的模型,比文本基线高14个nDCG@10,证明其无需任务特定训练即可处理混合模态文档。
块序列长度的权衡:细粒度与效率的平衡
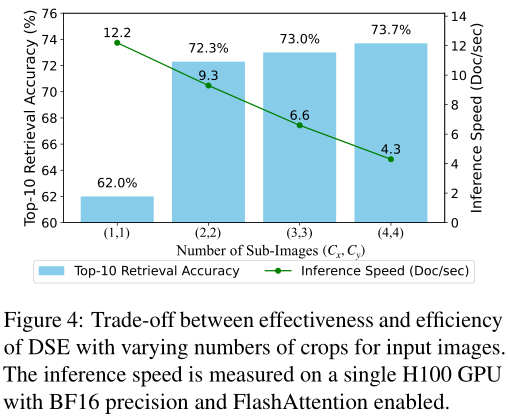
- 效果提升:随着裁剪数量从1×1增加到4×4,Top-10准确率从62.0%提升至73.7%,细粒度patch能捕捉更多文本细节(如单个字母、关键词)。
- 效率下降:编码速度从12.2 doc/sec降至4.3 doc/sec,计算成本随序列长度增长。
- 最优选择:2×2或3×3裁剪可平衡效果与效率,适用于大多数场景。
消融分析:为何DSE如此有效?
(1)注意力可视化:全局+局部信息双捕捉
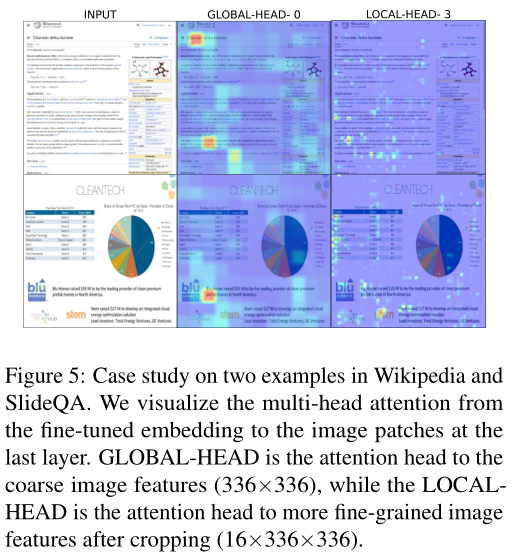
- 全局注意力:聚焦标题、图像、章节等宏观结构。
- 局部注意力:关注关键词、单个字母等细粒度文本信息。
- 证明DSE能同时捕捉文档的结构特征和语义细节。
(2)视觉整合的必要性
对Phi-3(文本检索)的50个失败案例分析:
- 22个案例因OCR文本提取错误导致失败。
- 28个案例因缺少视觉上下文(如图表、布局)导致失败。
证明传统文本方法既受限于OCR准确性,又丢失视觉信息,而DSE通过截图编码完美解决这两个问题。
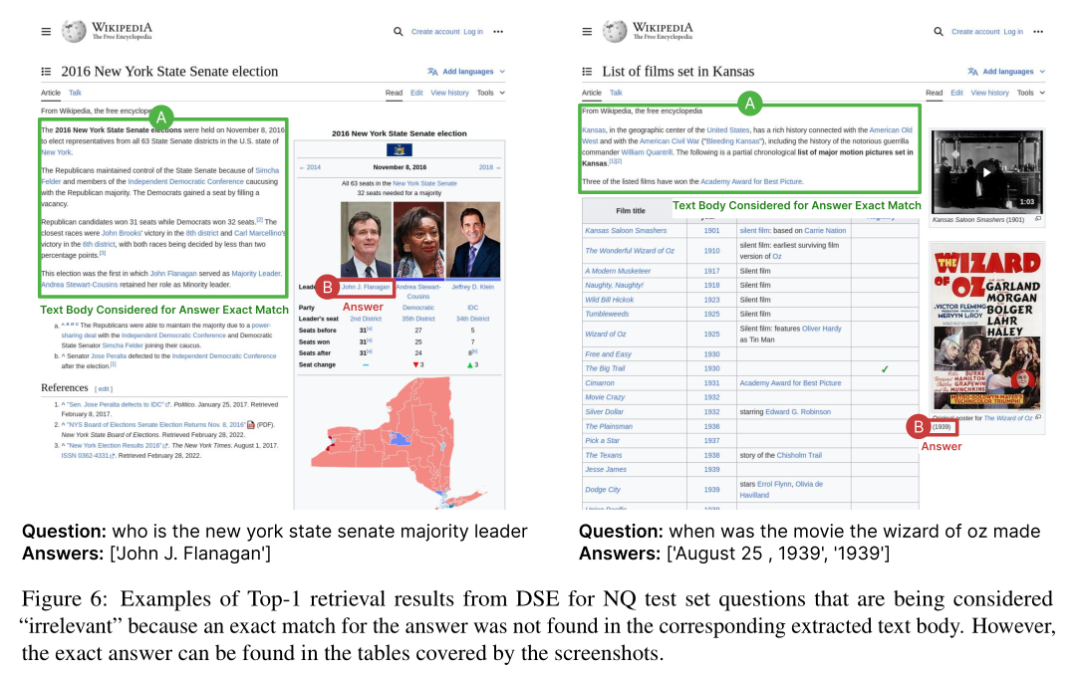
(3)假阴性分析:捕捉主文本外的关键信息
传统评估仅检查主文本中的答案匹配,导致DSE的7/50个样本被误判为"无关"------实际答案存在于截图的表格、图像标题中。这表明DSE能利用文档的完整视觉结构,挖掘传统方法忽略的信息。
06、总结
DSE 通过 "截图作为统一输入" 的创新范式,彻底简化了多模态检索的预处理流程,同时完整保留文档的视觉与布局信息,在文本密集型和混合模态任务中均展现出卓越性能。其单向量嵌入与双编码器架构,平衡了检索效率与精度,为通用场景提供了简洁高效的解决方案,尤其在网页、幻灯片等常见文档类型的检索中表现突出。
2025 年 ICLR 上的 ColPali 工作,进一步提出多向量嵌入与延迟交互机制,通过捕捉文档 patch 与查询 token 的细粒度匹配,实现了检索精度的再提升。这两款模型虽技术路径不同,但共同验证了 "直接基于原始像素的多模态检索"** 范式的可行性与优越性**,也反映出该方向仍有巨大挖掘空间 ------ 从单向量到多向量、从通用场景到工业级适配,技术迭代正持续推动性能边界。
但模态对齐仍是需要解决的关键问题。当前 DSE 虽能通过视觉语言模型融合文本与视觉信息,但在文本密集场景中,其性能仍略逊于专门的文本检索模型(如 Phi-3),说明视觉模态向文本语义的精准映射仍有优化空间;而 ColPali 的多向量机制虽提升了匹配精度,却也带来了更高的存储与计算成本,如何在模态对齐质量与系统效率之间找到更优平衡,仍是未来研究的核心方向。
此外,跨文档类型的泛化能力、低质量截图(模糊、低分辨率)的鲁棒性、无监督 / 弱监督训练策略的探索等,也是该领域亟待突破的课题。随着视觉语言模型的持续演进,未来的多模态检索系统有望实现 "精度与效率并重、通用与专用兼顾" 的目标,进一步拓展在 RAG、学术文献检索、企业文档管理等实际场景的应用深度与广度。
如果你想更深入地学习大模型,以下是一些非常有价值的学习资源,这些资源将帮助你从不同角度学习大模型,提升你的实践能力。
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
因篇幅有限,仅展示部分资料,需要点击文章最下方名片即可前往获取
四、AI大模型商业化落地方案
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量