这是一个非常深刻的区别,触及了人工智能的两个不同维度:感知(Perception)与决策(Decision Making)。
虽然它们现在经常结合在一起(称为深度强化学习 DRL),但在逻辑起点、数学目标和训练流程上截然不同。
1. 逻辑上的理解:不同的老师,不同的考卷
我们可以通过**"学习者如何获得反馈"**来区分两者:
| 特性 | 深度学习 (Supervised DL) | 强化学习 (RL) |
|---|---|---|
| 角色类比 | 背题的学生 | 学走路的孩子 |
| 反馈机制 | 标准答案 (Label)。做完一道题,老师立刻告诉你"错了,选C",并打手心。 | 奖惩 (Reward)。走一步摔倒了(痛),走稳了(开心)。没人告诉你具体哪块肌肉用力不对,你自己悟。 |
| 数据来源 | 静态历史数据。数据是现成的、死的(如 ImageNet 图片库)。 | 动态交互数据。数据是你自己创造的(你走一步,环境变了,才有了新的画面)。 |
| 核心逻辑 | 模式识别。输入 X,映射到 Y。 | 序列决策。现在做 A,为了将来能拿到最大的 R。 |
-
深度学习是看着后视镜开车(基于已知数据拟合)。
-
强化学习是摸着石头过河(基于探索和试错)。
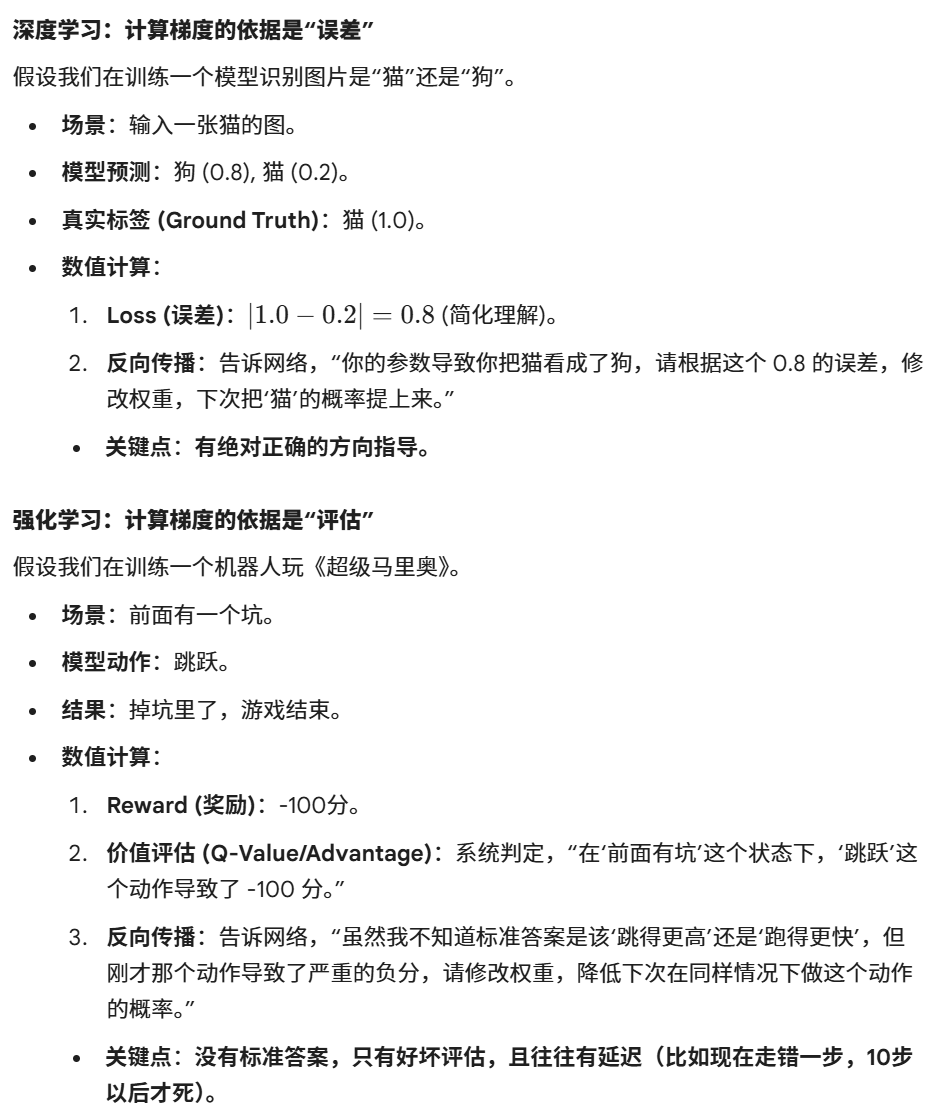
2. 数值计算与原理举例
这是理解两者数学本质差异的关键。
3. 在整个流程中的位置与作用
在现代 AI 系统(尤其是大模型和自动驾驶)中,这两者通常是串联 或嵌套关系。
位置 1:深度学习 (DL) ------ 打造"大脑的基础能力"
-
处于流程的前端/基础层。
-
作用:让 AI **"看懂"**环境。
-
在自动驾驶中,CNN(深度学习)负责看懂摄像头画面:"这是红灯,那是行人"。它不决定刹车还是加速,只负责识别。
-
在 ChatGPT 中,预训练(Pre-training)和监督微调(SFT)是深度学习,让模型学会造句、学会知识。
-
位置 2:强化学习 (RL) ------ 打造"大脑的决策专家"
-
处于流程的后端/优化层。
-
作用 :让 AI "学会怎么做"。
-
在自动驾驶中,RL 接收 DL 识别出的信息(红灯、行人),决定:"我现在应该踩刹车,以保证安全(奖励最大化)"。
-
在 ChatGPT 中,RLHF(基于人类反馈的强化学习)阶段,RL 用来调整模型的回答偏好:"虽然这句话语法没错(DL 做的),但它带有歧视色彩(RL 给予惩罚),所以我以后不这么说。"
-
4. 总结:为什么需要强化学习?
既然深度学习那么强,为什么还要强化学习?
-
有些问题没有标准答案:比如"如何控制核聚变反应堆的磁场"或者"在王者荣耀里怎么走位"。没人能给每一帧画面都标上完美的操作标签,AI 必须自己在环境里试。
-
长远规划:深度学习通常看重当前的准确率(贪心),而强化学习看重未来的总收益(远见)。比如下围棋,深度学习可能想吃掉眼前的子,而强化学习为了赢棋愿意现在弃子(延迟满足)。
一句话总结:深度学习教 AI 认清这个世界,强化学习教 AI 在这个世界里活得更好。