目录
[1. 核心目标](#1. 核心目标)
[2. 技术栈](#2. 技术栈)
[1. 核心工具函数(项目基石)](#1. 核心工具函数(项目基石))
(2)four_point_transform:四点透视变换
[2. 主流程解析(从图像到评分)](#2. 主流程解析(从图像到评分))
[1. SIFT的核心优势](#1. SIFT的核心优势)
[2. SIFT定位核心代码](#2. SIFT定位核心代码)
[1. 核心技术沉淀](#1. 核心技术沉淀)
[2. 拓展优化方向](#2. 拓展优化方向)
在教育场景中,答题卡自动阅卷能大幅提升效率、减少人工误差,是计算机视觉技术落地的经典案例。本文将基于Python+OpenCV,拆解一套完整的答题卡识别评分系统,从图像预处理到最终得分计算,逐环节解析原理与代码,同时补充SIFT特征提取的进阶优化方案,帮助大家吃透视觉识别在实际项目中的应用逻辑。
一、项目核心目标与技术栈
1. 核心目标
通过计算机视觉技术,实现对倾斜、有透视畸变的答题卡的自动校正、作答区域识别、答案比对,最终输出正确率得分,并标注正确/错误答案,全程无需人工干预。效果展示: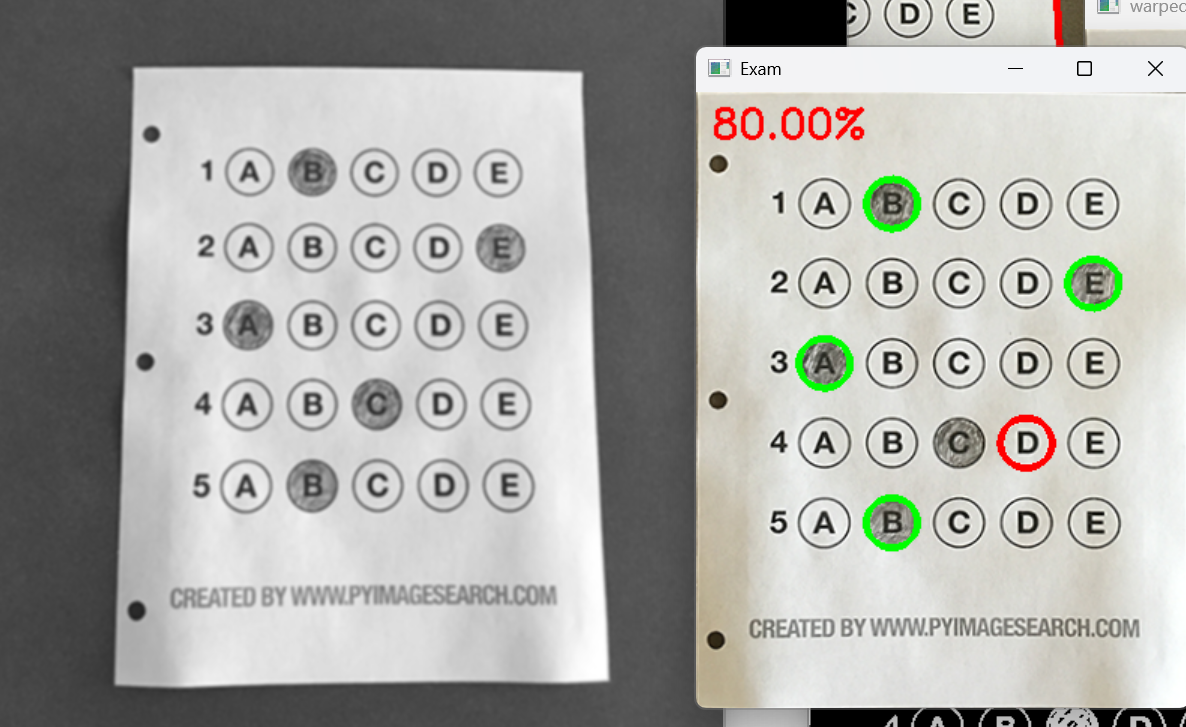
2. 技术栈
-
编程语言:Python(简洁高效,生态丰富)
-
核心库:OpenCV(图像预处理、轮廓检测、透视变换等核心操作)
-
辅助库:NumPy(矩阵运算、数值处理)
-
关键技术:轮廓检测、透视变换、二值化阈值处理、掩码像素统计
二、整体实现流程
答题卡识别本质是"图像预处理→目标定位→畸变校正→区域识别→结果判定"的全链路流程,每一步都为后续操作铺垫,确保识别精度。整体流程如下:
-
图像读取与预处理:降噪、提边缘,为轮廓检测做准备;
-
轮廓检测与筛选:定位答题卡外框(四边形),排除无关干扰;
-
透视变换校正:将倾斜/畸变的答题卡转为正矩形,消除视角影响;
-
答题区域增强:二值化+反相处理,突出涂写的选项;
-
选项轮廓筛选:提取符合尺寸、比例的答题圆圈,排除杂点;
-
作答识别与评分:通过掩码统计像素数判断选中答案,与标准答案比对打分;
-
结果可视化:标注正确/错误答案,显示最终得分。
三、核心代码逐段解析
下面结合代码,从工具函数到主流程,拆解每个环节的实现逻辑与关键技术点。
1. 核心工具函数(项目基石)
自定义函数封装了重复操作,是项目可复用性的核心,重点解析3个关键函数。
(1)order_points:四边形顶点排序
**作用**:将检测到的答题卡外框4个顶点,按"左上→右上→右下→左下"的顺序排序,确保透视变换时坐标对应关系正确(透视变换对顶点顺序敏感,顺序错误会导致校正失败)。
**原理**:利用四边形顶点的几何特征快速定位------x+y之和最小的是左上顶点,之和最大的是右下顶点;y-x之差最小的是右上顶点,之差最大的是左下顶点。
python
def order_points(pts):
    # 初始化存储排序后顶点的矩阵(4行2列,float32类型适配OpenCV运算)
    rect = np.zeros((4, 2), dtype="float32")
    # 按x+y之和排序,定位左上、右下顶点
    s = pts.sum(axis=1)  # 对每个顶点的x、y坐标求和
    rect[0] = pts[np.argmin(s)]  # 左上:x+y最小
    rect[2] = pts[np.argmax(s)]  # 右下:x+y最大
    # 按y-x之差排序,定位右上、左下顶点
    diff = np.diff(pts, axis=1)  # 对每个顶点计算y-x差值
    rect[1] = pts[np.argmin(diff)]  # 右上:y-x最小
    rect[3] = pts[np.argmax(diff)]  # 左下:y-x最大
    return rect
(2)four_point_transform:四点透视变换
**作用**:解决拍摄角度导致的答题卡畸变(如倾斜、透视变形),将不规则四边形转为正矩形(鸟瞰视角),为后续答题区域识别提供标准图像。
**核心API**:`cv2.getPerspectiveTransform` 计算透视变换矩阵,`cv2.warpPerspective` 应用变换矩阵得到校正图像。
python
def four_point_transform(image, pts):
    rect = order_points(pts)  # 先排序顶点
    (tl, tr, br, bl) = rect  # 解包顶点坐标(左上、右上、右下、左下)

    # 计算目标图像的宽高(取两侧长度最大值,避免畸变)
    widthA = np.sqrt(((br[0] - bl[0])**2) + ((br[1] - bl[1])**2))  # 底部宽度
    widthB = np.sqrt(((tr[0] - tl[0])**2) + ((tr[1] - tl[1])**2))  # 顶部宽度
    maxWidth = max(int(widthA), int(widthB))

    heightA = np.sqrt(((tr[0] - br[0])**2) + ((tr[1] - br[1])**2))  # 右侧高度
    heightB = np.sqrt(((tl[0] - bl[0])**2) + ((tl[1] - bl[1])**2))  # 左侧高度
    maxHeight = max(int(heightA), int(heightB))

    # 定义目标图像的4个顶点(正矩形,左上角为原点)
    dst = np.array([[0, 0],
                    [maxWidth - 1, 0],
                    [maxWidth - 1, maxHeight - 1],
                    [0, maxHeight - 1]], dtype="float32")

    # 计算透视变换矩阵M,应用变换得到校正图像
    M = cv2.getPerspectiveTransform(rect, dst)  # 生成3x3变换矩阵
    warped = cv2.warpPerspective(image, M, (maxWidth, maxHeight))  # 执行变换
    return warped
(3)sort_contours:轮廓排序
**作用**:按指定方向(左到右/上到下)对轮廓排序,确保答题区域的顺序与答题卡题目、选项顺序一致(否则会导致答案比对错误)。
python
def sort_contours(cnts, method='left-to-right'):
    reverse = False
    i = 0  # 排序依据:0为x坐标,1为y坐标
    # 反向排序判断(右到左/下到上)
    if method == 'right-to-left' or method == 'bottom-to-top':
        reverse = True
    # 排序维度判断(上下排序按y坐标,左右排序按x坐标)
    if method == 'top-to-bottom' or method == 'bottom-to-top':
        i = 1
    # 计算每个轮廓的最小外接矩形(用于排序依据)
    boundingBoxes = [cv2.boundingRect(c) for c in cnts]
    # 按外接矩形的x/y坐标排序,重组轮廓和边界框列表
    (cnts, boundingBoxes) = zip(*sorted(zip(cnts, boundingBoxes),
                                       key=lambda b: b[1][i], reverse=reverse))
    return cnts, boundingBoxes
2. 主流程解析(从图像到评分)
(1)图像预处理:降噪与边缘提取
原始图像含噪声、颜色干扰,预处理的目的是"净化"图像,突出答题卡边缘,为轮廓检测铺路。
python
# 读取图像,创建副本用于绘制轮廓
image = cv2.imread('./images/test_01.png')
contours_img = image.copy()
# 灰度化:去除颜色通道干扰,降低计算量
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
# 高斯模糊:5x5卷积核降噪,sigmaX=0表示自动计算标准差
blurred = cv2.GaussianBlur(gray, ksize=(5, 5), sigmaX=0)
# Canny边缘检测:双阈值筛选强边缘(75为低阈值,200为高阈值)
edged = cv2.Canny(blurred, threshold1=75, threshold2=200)
**关键说明**:高斯模糊的5x5核是经验值,可根据图像噪声情况调整;Canny双阈值需平衡------低阈值过低会保留杂边,过高会丢失有效边缘。
(2)轮廓检测:定位答题卡外框
通过轮廓检测找到答题卡外框(四边形),核心思路是"按面积排序,筛选四边形轮廓"(答题卡外框是图像中面积最大的轮廓)。
python
# 检测最外层轮廓(RETR_EXTERNAL排除内部干扰)
cnts = cv2.findContours(edged.copy(), cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)[-2]
cv2.drawContours(contours_img, cnts, -1, (0, 0, 255), 3)  # 绘制所有轮廓(可视化)
docCnt = None  # 存储答题卡外框轮廓

# 按轮廓面积降序排序,优先处理最大轮廓
cnts = sorted(cnts, key=cv2.contourArea, reverse=True)
for c in cnts:
    peri = cv2.arcLength(c, closed=True)  # 计算轮廓周长(closed=True表示闭合轮廓)
    # 轮廓近似:用Douglas-Peucker算法简化轮廓,精度为周长的2%
    approx = cv2.approxPolyDP(c, 0.02 * peri, closed=True)
    if len(approx) == 4:  # 筛选出四边形(答题卡外框)
        docCnt = approx
        break
**关键技术**:`cv2.approxPolyDP` 是轮廓简化的核心,0.02*peri的精度需适配实际场景------精度过高会保留过多细节(无法简化为四边形),过低会丢失顶点(轮廓变形)。
(3)透视校正与答题区域增强
将畸变的答题卡校正为正矩形后,通过二值化反相处理(前面的博客也多次提到了:背景为黑色,内容为白色有利于轮廓检测的函数执行),让涂写的选项与背景形成强烈对比,便于后续识别。
python
# 执行透视变换,校正答题卡
warped_t = four_point_transform(image, docCnt.reshape((4, 2)))  # 转换顶点格式为(4,2)
warped_new = warped_t.copy()  # 副本用于最终结果绘制
warped = cv2.cvtColor(warped_t, cv2.COLOR_BGR2GRAY)  # 转灰度图

# 二值化反相处理:自动计算阈值(OTSU),涂写区域转为白色,背景为黑色
thresh = cv2.threshold(warped, 0, 255, cv2.THRESH_BINARY_INV | cv2.THRESH_OTSU)[1]
运行效果: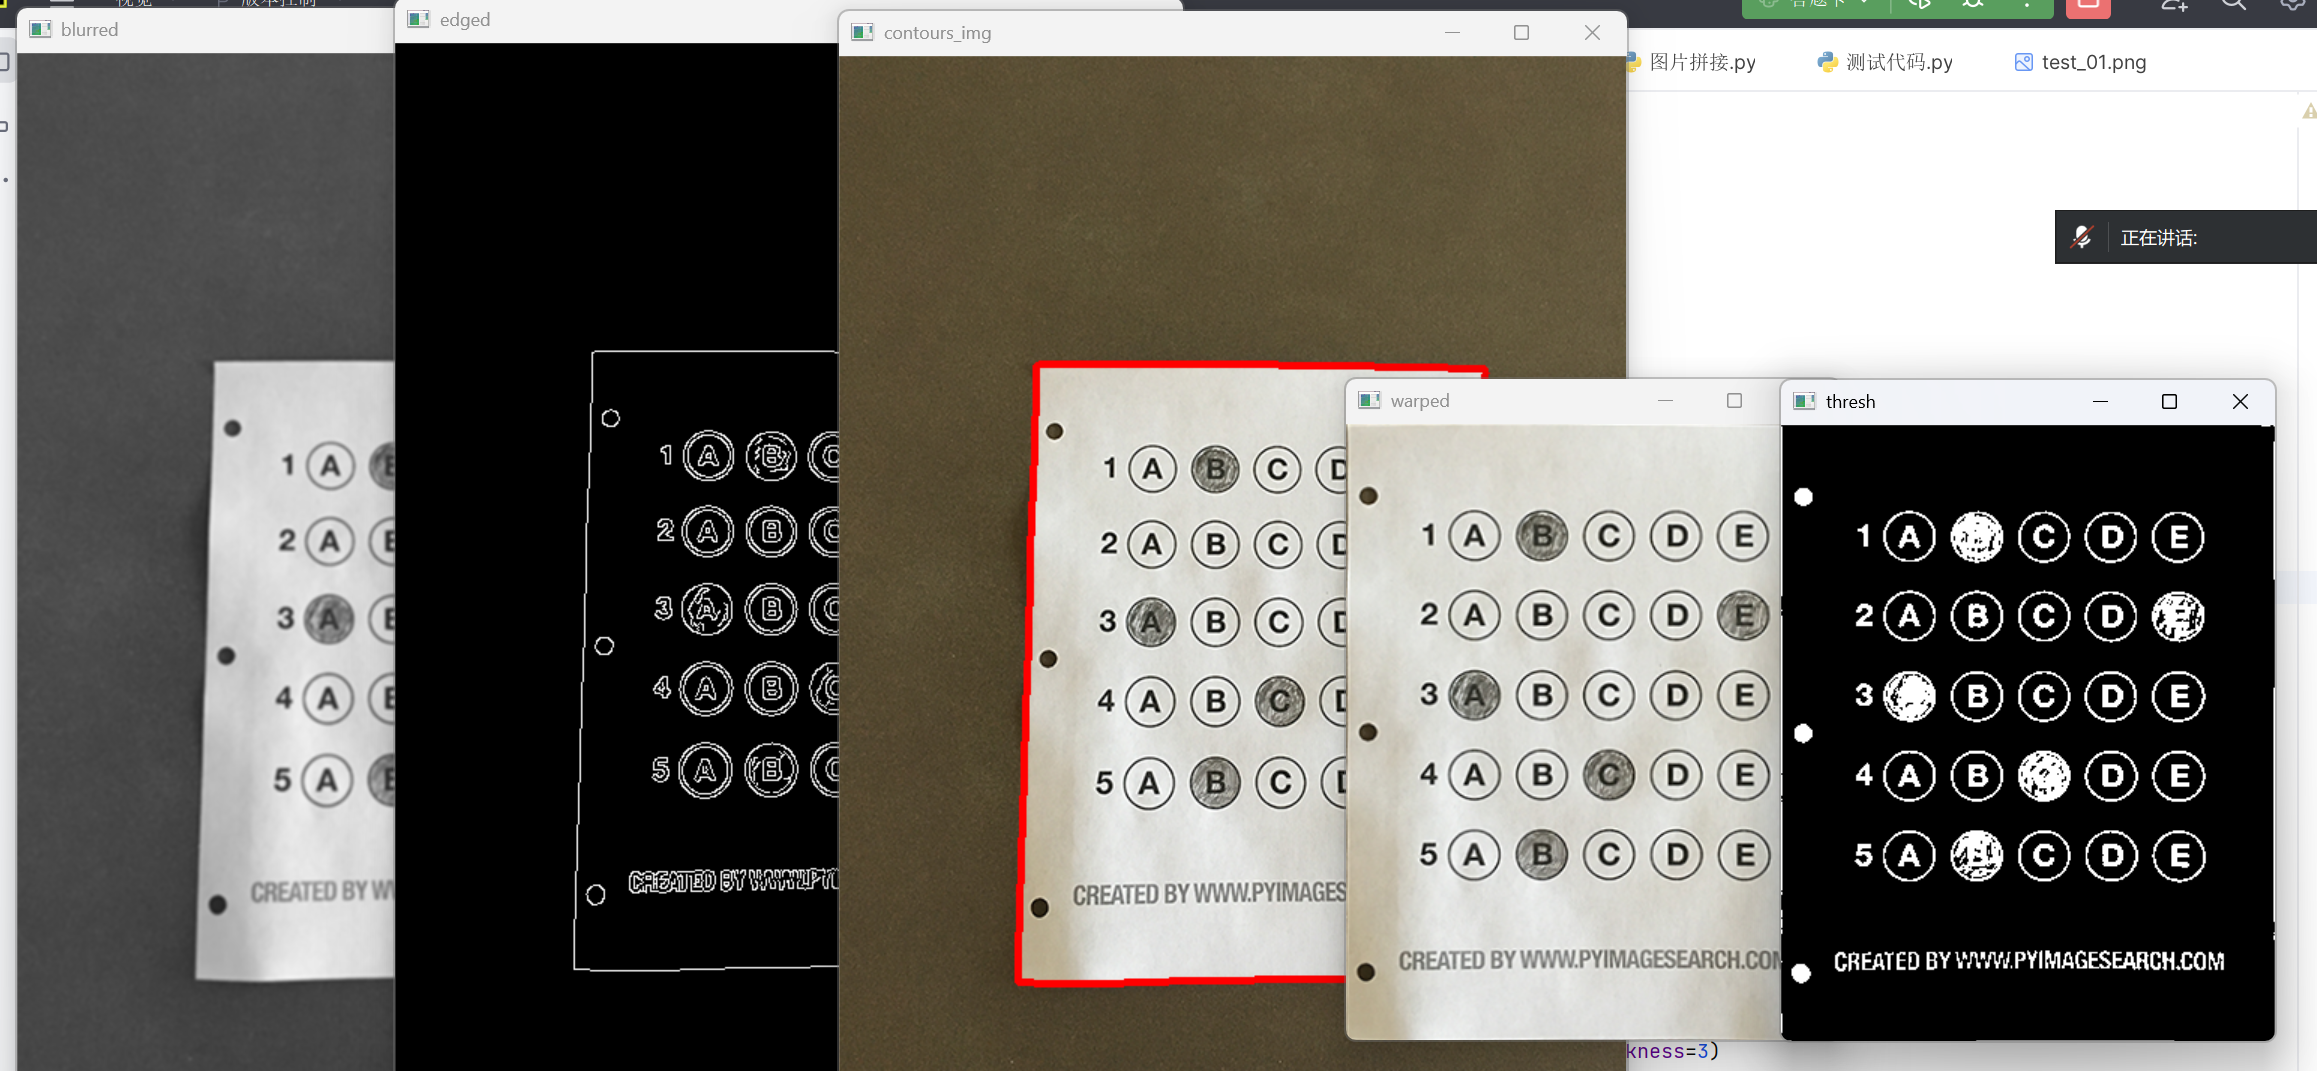
**优势**:`cv2.THRESH_OTSU` 自动适配光照变化,无需手动调整阈值,让项目更具通用性。
(4)选项识别与评分:核心业务逻辑
通过筛选答题圆圈轮廓、排序、掩码像素统计,识别用户作答选项,再与标准答案比对,统计正确数并计算得分。
python
# 检测答题区域轮廓(二值化图中的白色轮廓)
cnts = cv2.findContours(thresh, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)[-2]
questionCnts = []  # 存储筛选后的答题圆圈轮廓

# 筛选符合条件的轮廓(排除杂点,保留正圆形选项)
for c in cnts:
    (x, y, w, h) = cv2.boundingRect(c)  # 计算轮廓外接矩形
    ar = w / float(h)  # 宽高比(正圆的宽高比接近1)
    # 筛选条件:宽高≥20像素(排除小杂点),宽高比0.9~1.1(接近正圆)
    if w >= 20 and h >= 20 and 0.9 <= ar <= 1.1:
        questionCnts.append(c)

# 按从上到下排序(对应答题卡题目顺序)
questionCnts = sort_contours(questionCnts, method="top-to-bottom")[0]
correct = 0  # 正确题数
ANSWER_KEY = {0: 1, 1: 4, 2: 0, 3: 3, 4: 1}  # 标准答案(题目索引→正确选项索引)

# 每5个轮廓为1道题(5个选项),遍历所有题目
for (q, i) in enumerate(np.arange(0, len(questionCnts), 5)):
    # 对当前题的5个选项按左到右排序
    cnts = sort_contours(questionCnts[i:i + 5])[0]
    bubbled = None  # 存储用户选中的选项

    # 遍历每个选项,通过掩码统计像素数判断是否选中
    for (j, c) in enumerate(cnts):
        # 创建掩码(全黑背景,仅当前选项区域为白色)
        mask = np.zeros(thresh.shape, dtype="uint8")
        cv2.drawContours(mask, [c], -1, 255, -1)  # -1表示填充轮廓内部
        # 掩码与二值化图做与运算,仅保留当前选项区域
        thresh_mask_and = cv2.bitwise_and(thresh, thresh, mask=mask)
        total = cv2.countNonZero(thresh_mask_and)  # 统计非零像素数(涂写区域像素)

        # 非零像素数最大的选项即为用户选中的选项
        if bubbled is None or total > bubbled[0]:
            bubbled = (total, j)

    # 对比标准答案,标注正确/错误并统计得分
    color = (0, 0, 255)  # 初始为红色(错误)
    k = ANSWER_KEY[q]
    if k == bubbled[1]:  # 答案正确,标为绿色
        color = (0, 255, 0)
        correct += 1
    # 绘制标注(在校正后的图像上框选正确选项)
    cv2.drawContours(warped_new, [cnts[k]], -1, color, thickness=3)

# 计算得分并绘制在图像上
score = (correct / 5.0) * 100  # 5道题,正确率转为百分比得分
cv2.putText(warped_new, "{:.2f}%".format(score), (10, 30),
            cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 0, 255), 2)

# 显示结果
cv2.imshow("Original", image)
cv2.imshow("Result", warped_new)
cv2.waitKey(0)
cv2.destroyAllWindows()
**核心原理**:涂写的选项内部填充了大量白色像素(非零像素数多),未涂写的选项仅有轮廓线(非零像素数少),通过掩码隔离单个选项,统计像素数即可精准识别作答结果。
运行结果:
循环一行选项: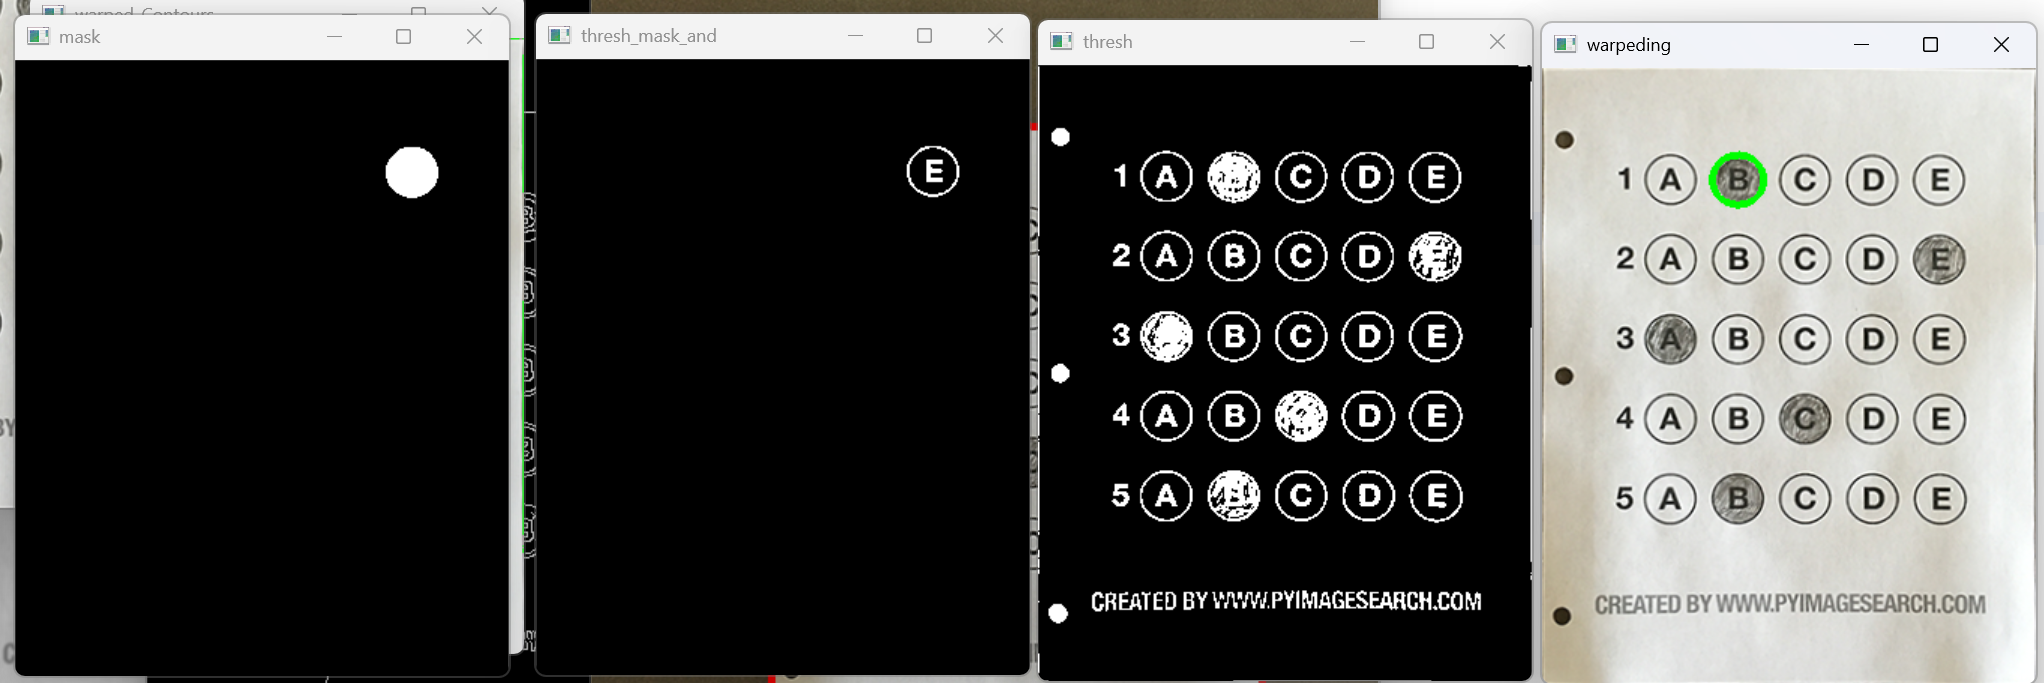
最终结果: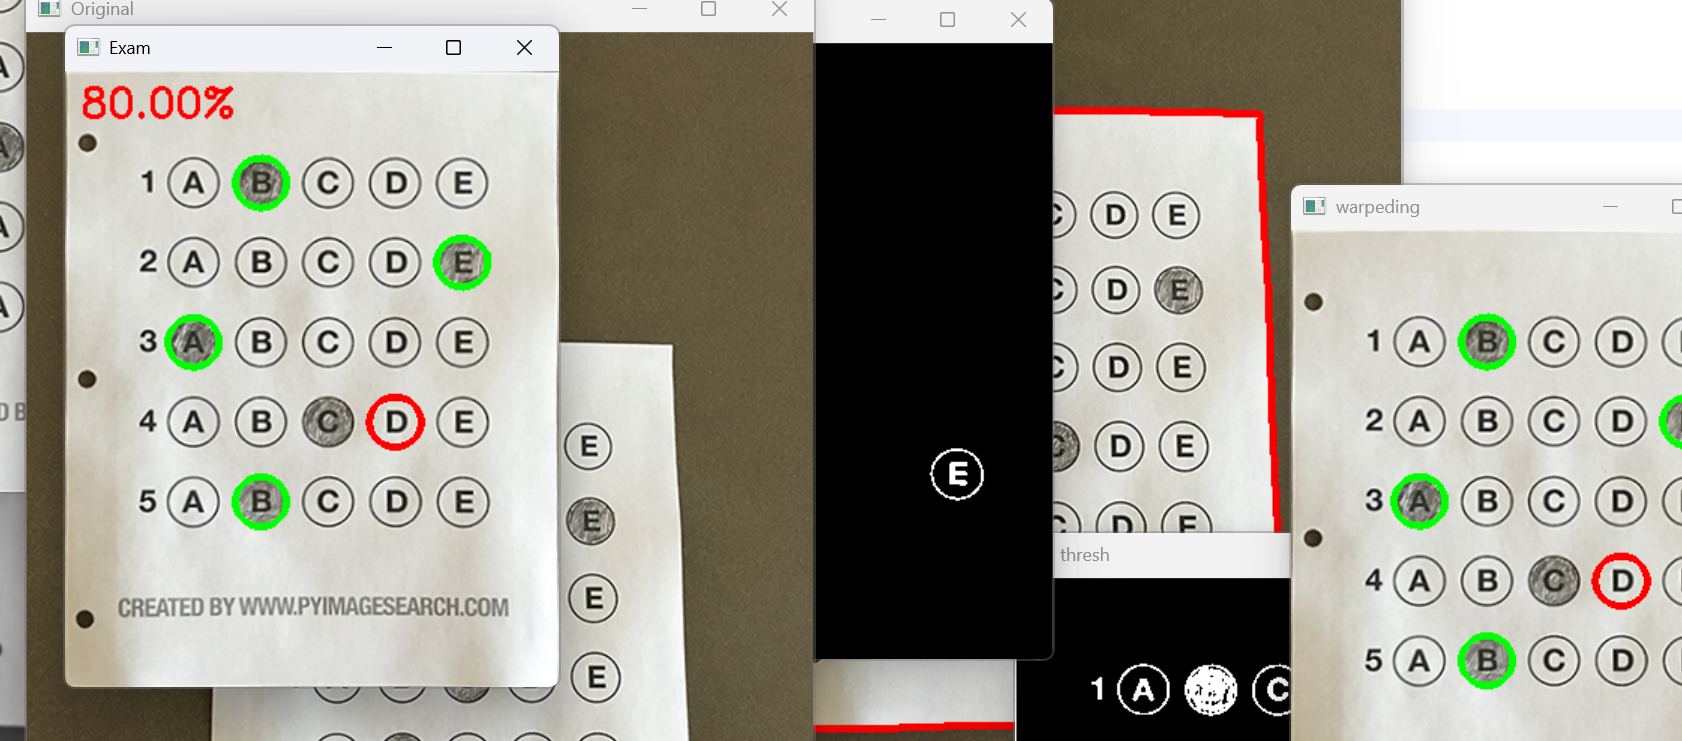
五、项目总结与拓展方向
1. 核心技术沉淀
本项目的核心价值的是"将计算机视觉基础技术串联落地":透视变换解决畸变问题,轮廓排序匹配实际场景逻辑,掩码像素统计实现精准识别,这些技术可迁移到票据识别、试卷批改等同类场景。
2. 拓展优化方向
-
批量处理:遍历文件夹内所有答题卡图像,自动生成评分报告;
-
抗干扰增强:加入形态学操作(膨胀/腐蚀),处理模糊、污渍答题卡;
-
多题型适配:支持单选、多选,通过轮廓数量和分布自动判断题型;
-
深度学习融合:用CNN替代传统像素统计,提升复杂场景下的选项识别精度。
通过本项目,大家不仅能掌握OpenCV的核心API用法,更能理解"技术如何适配实际需求"------从图像预处理到结果输出,每一步的设计都要围绕"精度"和"鲁棒性"展开。希望本文能为大家的计算机视觉实践提供参考,也欢迎大家留言交流优化方案!