文章目录
1.行转列
1.1 concat函数
concat函数用于实现字符串拼接,不可指定分隔符。如果任意一个元素为null,结果就为null。
sql
# 语法:
concat(element1,element2,element3......)
sql
select concat("it","cast","And","heima");
+-----------------+
| itcastAndheima  |
+-----------------+
sql
select concat("it","cast","And",null);
+-----------------+
|       null      |
+-----------------+
1.2 concat_ws函数
concat_ws函数用于实现字符串拼接,可以指定分隔符。任意一个元素不为null,结果就不为null。
sql
# 语法:
concat_ws(SplitChar,element1,element2......)
sql
select concat_ws("-","itcast","And","heima");
+-------------------+
| itcast-And-heima  |
+-------------------+
sql
select concat_ws("-","itcast","And",null);
+-------------+
| itcast-And  |
+-------------+
1.3 collect_list函数
collect_list函数是聚合函数的一种,用于将一列中的多行合并为一行,不进行去重
sql
# 语法:
collect_list(colName)
sql
select collect_list(col1) from row2col1;
+----------------------------+
| ["a","a","a","b","b","b"]  |
+----------------------------+
1.4 collect_set函数
collect_set函数也是聚合函数的一种,用于将一列中的多行合并为一行,并进行去重
sql
# 语法:
collect_set(colName)
sql
select collect_set(col1) from row2col1;
+------------+
| ["b","a"]  |
+------------+
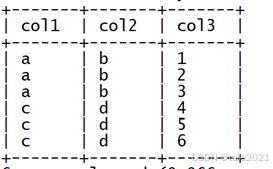
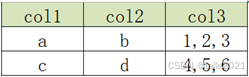
1.5 SQL实现多行转单列
原始数据表
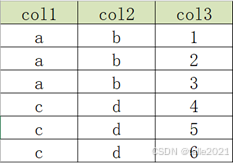
目标数据表
创建原始数据表,加载数据
sql
--建表
create table row2col2(
   col1 string,
   col2 string,
   col3 int
)row format delimited fields terminated by '\t';

--加载数据到表中
load data local inpath '/export/data/r2c2.txt' into table row2col2;
SQL实现转换
sql
select
  col1,
  col2,
  concat_ws(',', collect_list(cast(col3 as string))) as col3 # 把col3一列转换为字符串是因为concat_ws只能合并字符串类型的数据
from
  row2col2
group by
  col1, col2;
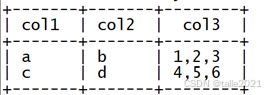
运行结果:
2.列转行
2.1 explode函数
explode函数用于将一个集合或数组中的每个元素展开,将每个元素变成一行。explode(array)将array列表里的每个元素生成一行;explode(map)将map里的每一对元素作为一行,其中key为一列,value为一列。一般情况下,explode函数需要结合lateral view侧视图使用。
powershell
select explode(`array`(11,22,33)) as item;
select explode(`map`("id",10086,"name","zhangsan","age",18));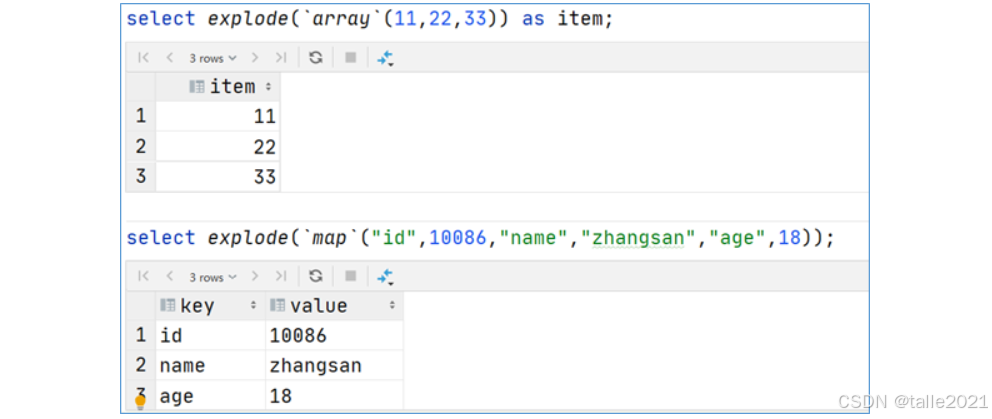
sql
# 对于非集合或数组的字符串可以用split转换为集合
select explode(split("a,b,c,d",","));
运行结果:
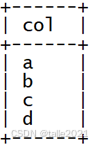
explode函数属于UDTF函数,即表生成函数,在select中只查询源表数据没有问题,只查询explode生成的虚拟表数据也没问题,但是不能在只查询源表的时候,既想返回源表字段又想返回explode生成的虚拟表字段,通俗点讲,有两张表,不能只查询一张表但是返回分别属于两张表的字段; 从SQL层面上来说应该对两张表进行关联查询。
2.2 Lateral View
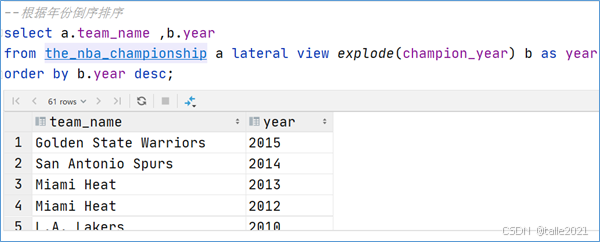
Lateral View是一种特殊的语法,主要用于搭配UDTF类型功能的函数一起使用,用于解决UDTF函数的一些查询限制的问题。侧视图的原理是将UDTF的结果构建成一个类似于视图的表(虚拟表),然后将原表中的每一行和UDTF函数输出的每一行进行连接(inner join),生成一张新的虚拟表。这样就避免了UDTF的使用限制问题。使用lateral view时也可以对UDTF产生的记录设置字段名称,产生的字段可以用于group by、order by 、limit等语句中,不需要再单独嵌套一层子查询。
一般只要使用UDTF,就会固定搭配lateral view使用。官方链接:https://cwiki.apache.org/confluence/display/Hive/LanguageManual+LateralView
sql
--lateral view侧视图基本语法如下
select ...... from tabelA lateral view UDTF(xxx) 别名 as col1,col2,col3......;

select * from the_nba_championship;
select a.team_name ,b.year
from the_nba_championship a lateral view explode(champion_year) b as year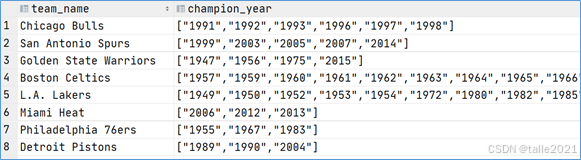
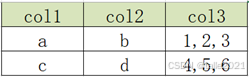
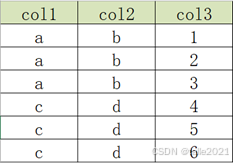
2.3 SQL实现单列转多行
原始数据表:
目标数据表:
创建原始数据表,加载数据
sql
--切换数据库
use db_function;

--创建表
create table col2row2(
   col1 string,
   col2 string,
   col3 string
)row format delimited fields terminated by '\t';


--加载数据
load data local inpath '/export/data/c2r2.txt' into table col2row2;
SQL实现转换
sql
select
  col1,
  col2,
  lv.col3 as col3
from
  col2row2
    lateral view
  explode(split(col3, ',')) lv as col3;
运行结果: