人工智能应用- 语言理解:04.大语言模型

近年来,随着深度学习的发展,基于神经网络的语言模型取得了显著进展。以GPT 为代表的大规模神经网络语言模型,或简称大语言模型(LLM),展现出了强大的语言理解与生成能力。这些模型的核心任务是通过上下文信息预测下一个词,从而生成自然流畅的句子。

大语言模型之所以强大,主要得益于它们具备超强的上下文建模能力。传统的 N 元文法模型通常只能考虑前几个词(一般不超过 5 个)的上下文信息,而基于神经网络的模型可以处理极长的上下文信息。例如,第一代 GPT-1 模型可以处理 512 个标记(Token)的上下文,而最新的 GPT-4 模型可以处理长达 12.8 万个标记的上下文。标记是文本表示的最小单位,一个英文单词平均包含 1.2-1.5 个 Token。

这种强大的上下文处理能力归功于一种名为 Transformer 的网络结构。Transformer 的核心是自注意力机制,它允许模型在生成下一个词时回顾并整合所有前面已经生成的单词,从而使生成内容连贯、一致。如图 31.4所示,当模型预测第 9 个单词"it"时,它可以通过回顾所有前面的单词来生成下一个词。
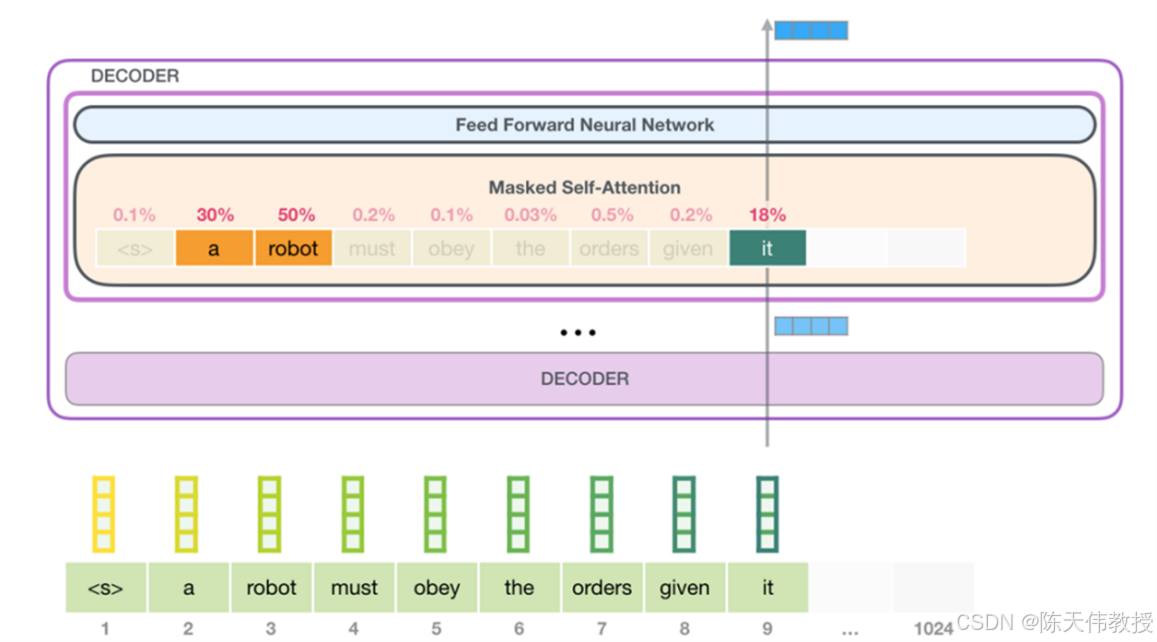
大语言模型的单词预测示意图。图片来源:Jay Alammar's blog

相关推荐
用户8314550980314 分钟前
如一 Agent 架构解读(二):上下文工程——为模型构造它唯一的现实
人工智能·架构
揽秀亭长5 分钟前
音频如何转换为乐谱?扒谱流程与关键技术分析
人工智能·音视频
丙亮8 分钟前
ECC:一个Agent操作系统的深度拆解
人工智能
财迅通Ai9 分钟前
开拓全球合作新机遇 科兴制药亮相CPHI Milan 2026
大数据·人工智能·科兴制药
kaixin_啊啊12 分钟前
【零基础学AI】第 7 章课后练习与答案
人工智能
AI日报派送佬19 分钟前
Ultralytics YOLO 模型训练技巧与最佳实践
人工智能·python·深度学习·yolo·机器学习·计算机视觉
2501_9139817821 分钟前
Semtech与国产LoRa芯片对比:SX1276/SX1262/LR2021与ASR6601解析
人工智能·lora芯片
刻、苦铭心`21 分钟前
Tare使用:如何在虚拟环境中调试,(小白教程)
人工智能
zhaowangji27 分钟前
mujoco仿真(机械臂推动正方体到指定位置)
人工智能·python
AI分享猿28 分钟前
百智云联网智能生图电商商品图场景
人工智能