技术栈
大模型架构演进:从Transformer到MoE
人工智能培训
2026-02-14 16:47
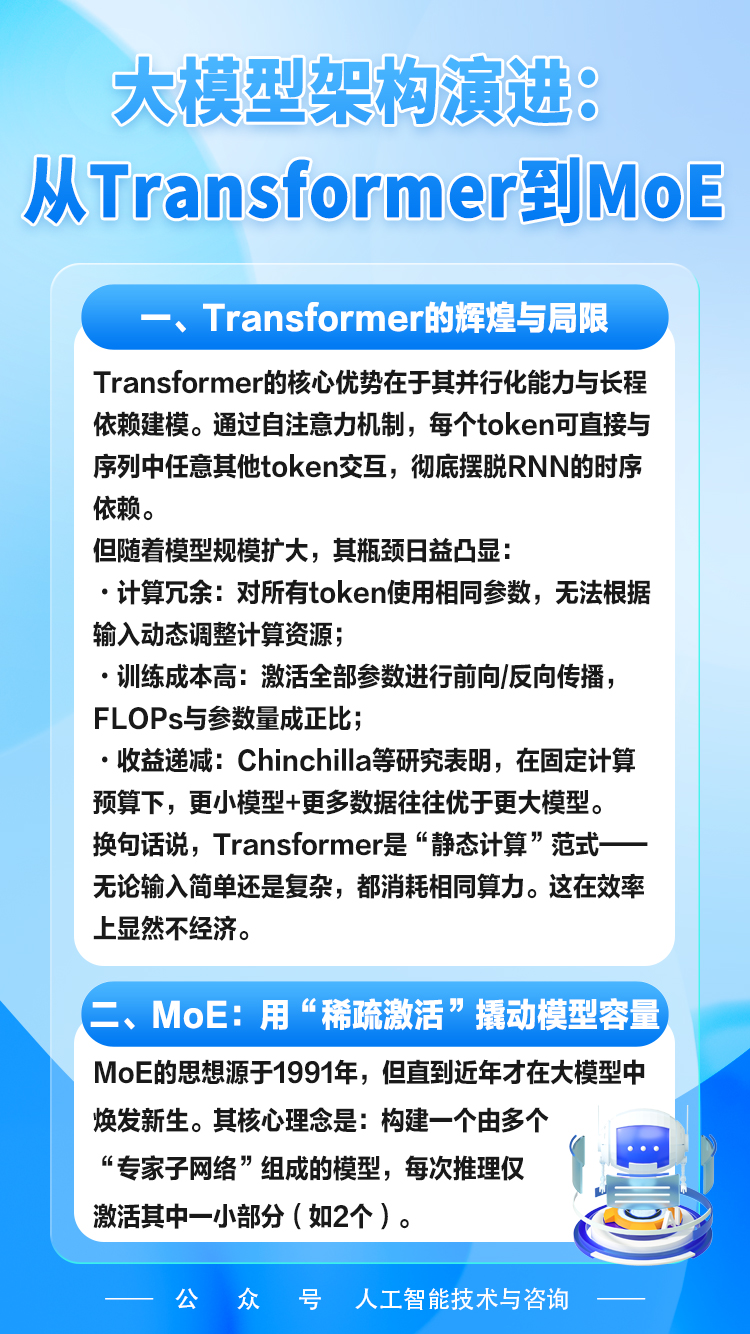
Transformer的辉煌与局限
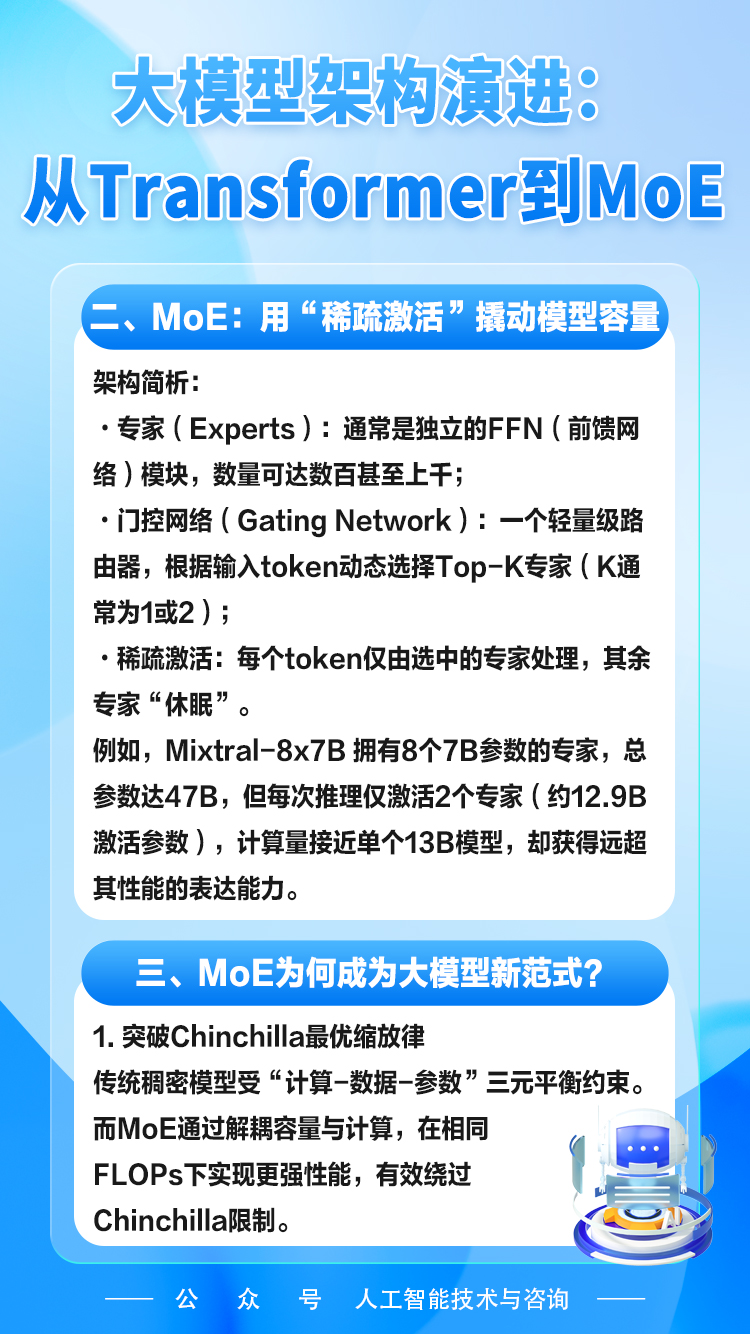
MoE:用"稀疏激活"撬动模型容量
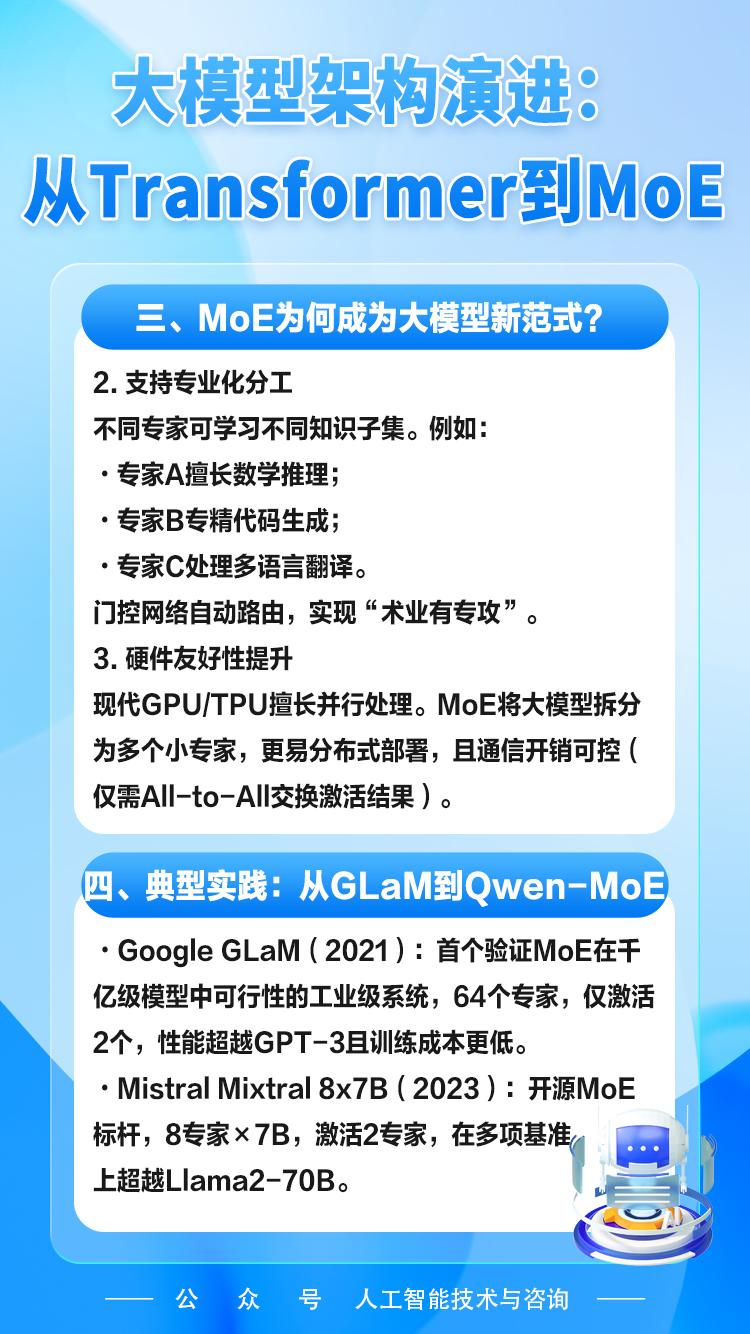
MoE为何成为大模型新范式?
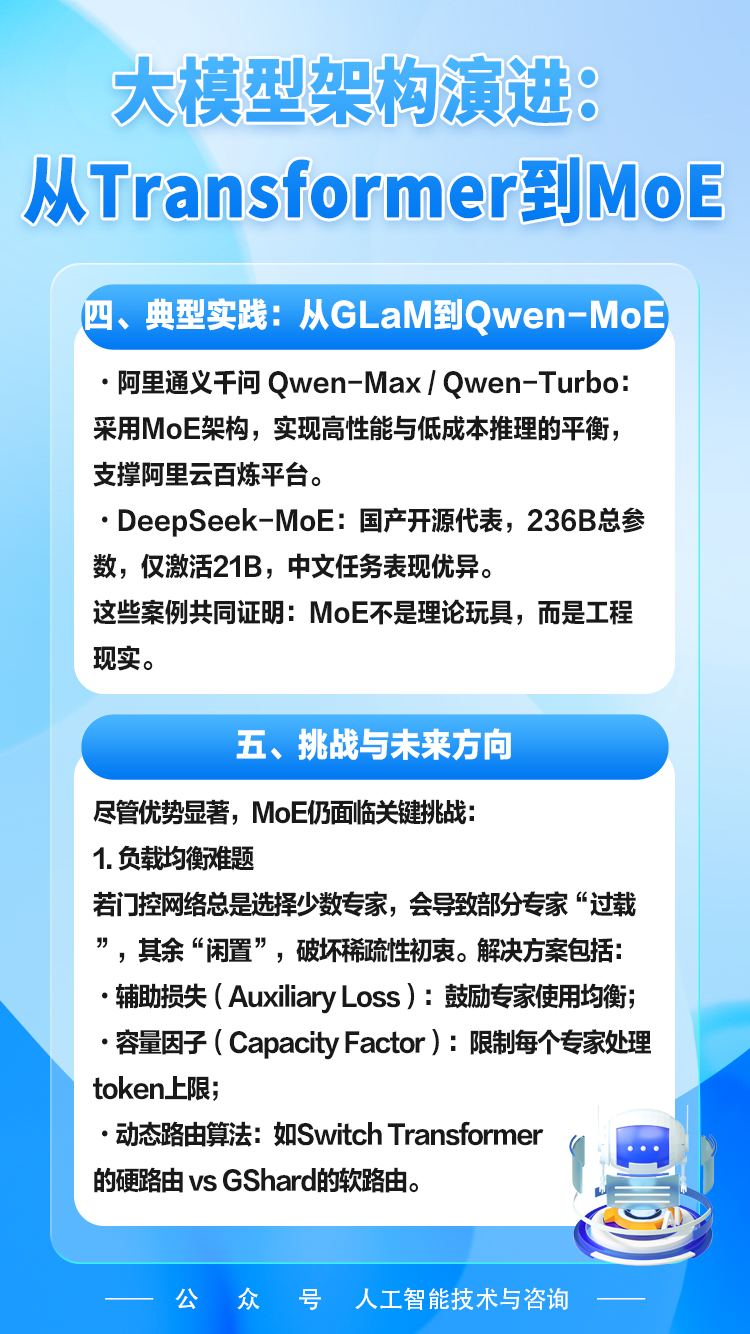
典型实践:从GLaM到Qwen-MoE
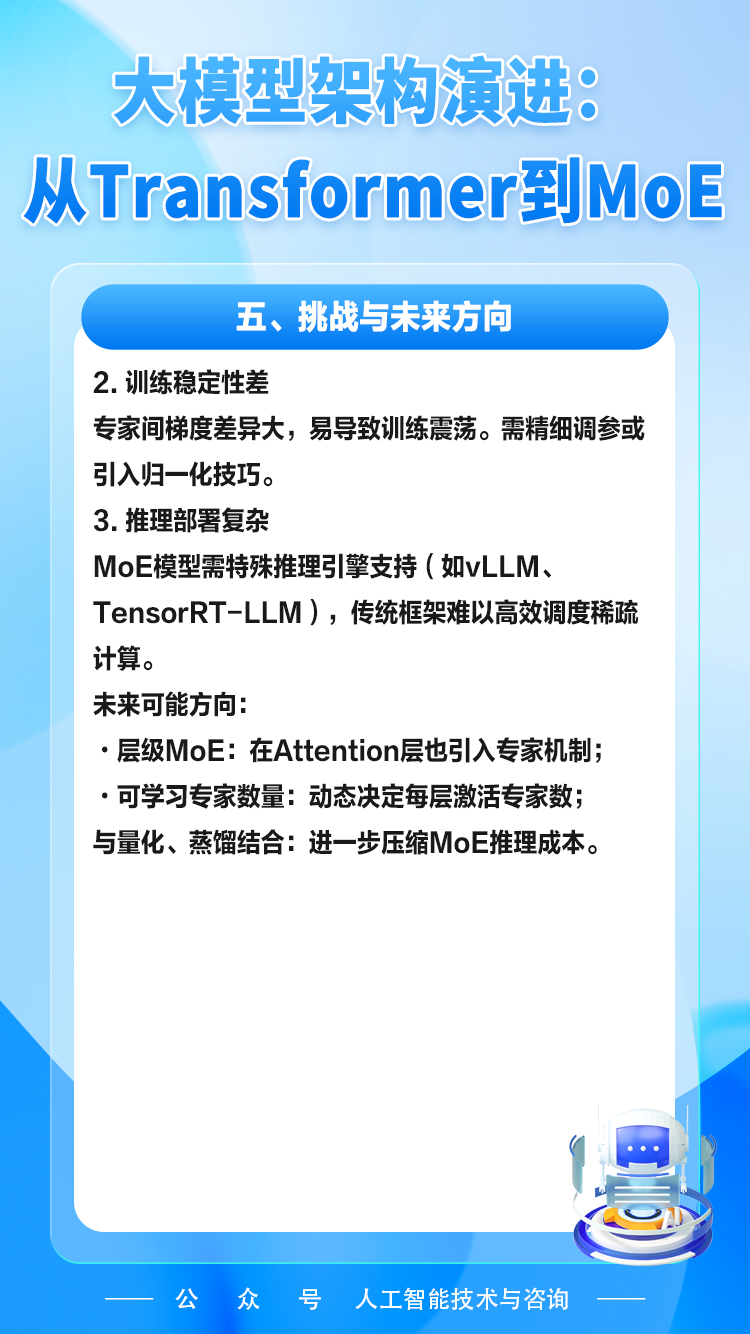
挑战与未来方向
#Transformer#MoE(混合专家)#稀疏激活#专家#模型容量
人工智能
深度学习
大模型
transformer
知识图谱
具身智能
人工智能 培训
上一篇:
MYSQL---事务
下一篇:
2026主权AI趋势:DeepSeek搭建企业自有可控AI环境,保障数据安全实战
相关推荐
吴佳浩
29 分钟前
我把 HAMi 摆回一台双卡机器上跑了一遍:GPU 编排的性能账,到底记在谁头上
人工智能
·
gpu
forest_09
4 小时前
《AI 编程 Harness 实战手册》04|审批这道门:点了一百次“允许”,还剩多少作用?
人工智能
·
算法
·
prompt
·
agi
火山引擎开发者社区
5 小时前
当 RPA 遇上 Agent:MUA 混合执行 Workflow 深度拆解
人工智能
严肃小白兔
6 小时前
第 10/24 期:深度神经网络的自动求导机制与梯度验证
人工智能
·
神经网络
·
dnn
火山引擎开发者社区
6 小时前
定档12.16-12.18!FORCE原动力大会上海见!
人工智能
努力的MM123
6 小时前
CAIE 二级和阿里云大模型 ACP 怎么选?企业 AI 工程与云平台开发能力对比
人工智能
老金带你玩AI
6 小时前
Kling Image 4.0来了!8K和组图直出,电商人的提效神器?
人工智能
孟健
7 小时前
用 unslop 拯救 AI 生成网页的塑料感,7 分钟重构落地实测
前端
·
人工智能
·
ai编程
stormzhangV
7 小时前
Google 重返第一梯队
人工智能
·
google
·
aigc
热门推荐
01
国内可直接用、免费额度/永久免费的大模型API清单(含 SiliconFlow、火山、阿里、智谱、百度、Kimi、DeepSeek、DMXAPI 等)
02
历年考研数学一、数学二、数学三真题试卷及答案PDF
03
几个好用的ip纯净度检测网站
04
微信历史版本含下载地址( Windows PC | 安卓 | MAC )及设置微信不更新
05
昇腾910B系列芯片完全指南:四款型号对比、服务器选型与大模型部署实战
06
GitHub 镜像站点
07
蜘蛛磁力 搜索引擎大全,如何使用蜘蛛磁力查找磁力链接
08
苹果iPA游戏软件资源下载网站
09
Dify:一站式AI应用开发平台全解析与Windows部署指南
10
如何新建文件夹? 电脑新建文件夹的4种方法