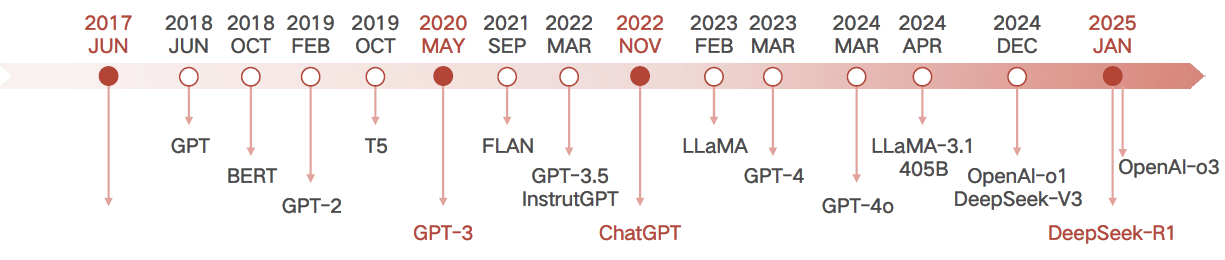
大型语言模型简史

Transformer:理论架构创新

自注意力机制:支持并行计算/全局上下文的理解能力

• 多头注意力:从多个角度捕捉复杂的语义关系

• 前馈网络/位置编码/层归一化:解决了传统模型的诸多局限性

在理解语言任务时,Attention 机制本质上是捕捉单词间的关系

相关推荐
#六脉神剑2 小时前
myBuilder 11 月新版本:AI辅助设计
ide·人工智能·低代码·ai·mybuilder
SJZR2 小时前
图解循环神经网络(RNN)
人工智能·rnn·神经网络
QXWZ_IA2 小时前
测绘单位采购RTK:设备价格、账号年费、售后,用时间轴分权重
网络·人工智能·安全
kaixin_啊啊3 小时前
【零基础学AI】第 29 章——第一次调用大模型 API
人工智能
甲维斯3 小时前
Qwen4 被嘲笑了!国模被啥锁死了?
人工智能
夕阳_醉了3 小时前
Codex 客户端从装好到跑通:第三方 API 接入与配置避坑指南
人工智能·gpt·openai·codex·ai 编程
熟的生菜3 小时前
从零造一个腱绳驱动灵巧手——仿真器篇5:姿势串与手势工程——从文本协议到握拳、OK 与多姿势插值
人工智能
武子康4 小时前
攻击动作做对了,游戏规则就对了吗?H3-World 与三条控制路线的分工
大数据·人工智能·agent
ZzT4 小时前
AI-SDLC 实践 05|开发阶段的工程结构:在一个主仓里跨多个仓库写代码
ai编程·claude