ONNX Runtime (ORT) 利用 NVIDIA GPU 加速,核心在于将模型的计算任务交给GPU处理。把它理可解为 "配置硬件驱动" 的过程:通过指定
CUDAExecutionProvider 或 TensorrtExecutionProvider,让 ORT 知道应该调用 NVIDIA 的 CUDA/cuDNN 库来执行计算,从而实现并行加速。
1.核心依赖:必须安装 CUDA Toolkit 和 cuDNN
|--------------|-------------------------|------------|
| 组件 | 版本要求 (示例) | 作用 |
| CUDA Toolkit | 11.x 或 12.x (需与 ORT 匹配) | GPU 计算的核心库 |
| cuDNN | 8.x (需与 CUDA 匹配) | 深度神经网络加速库 |
| C++ 编译器 | 支持 C++17 标准 | 编译你的项目代码 |
首先查看自己的计算机安装的cuda版本和cudnn版本
1)通过指令nvcc -V查看cuda版本如下图所示
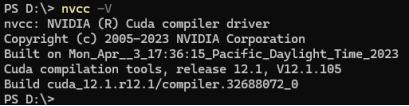
注意:用命令 nvidia-smi 看到 的版本是驱动支持的 最高上限。
****2)****查看 GPU 型号列表的指令如下图所示

3)在cuda安装目录下cudnn相关文件上点击右键查看详细信息,可看到对应的cudnn版本为8.9,如下图所示。
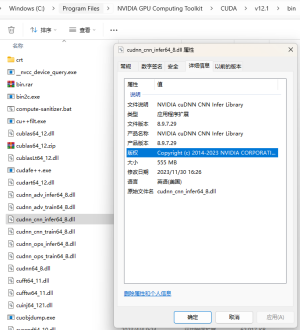
2. 获取onnx的运行库获取ONNX Runtime GPU库
方式一:下载预编译的二进制包(推荐)
这是最简单快捷的方式。访问 ONNX Runtime 的 页面地址:
https://github.com/microsoft/onnxruntime/releases?page=2,
找到与你环境匹配的版本。对于 GPU 加速,你需要下载名称中包含 gpu 或 cuda 字样的包,例如 onnxruntime-win-x64-gpu-1.17.3.zip 。下载后解压到你的项目目录即可。
官网上有两个关于gpu的onnxruntime运行库,如下图所示

两者的差别如下图所示:
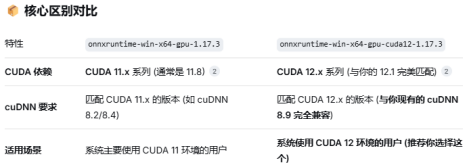
我目前采用的CUDA12.1支持的版本,要求最好用最新的cudnn9.x版本,如下图所示。
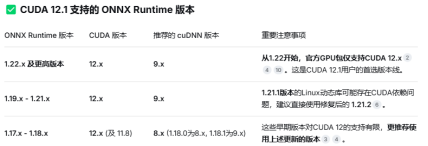
问题:cuda12.1 cudnn8.9.可以运行Onnxruntime1.22吗?
答:ORT 1.22 需要 CUDA 12.x 和 cuDNN 9.x。官方特别强调:cuDNN 8.x 与 9.x 互不兼容 。所以既然 cuDNN 8.9 不符合 ORT 1.22 的要求,建议采用 ONNX Runtime 1.17.x。它对 CUDA 12.x 支持良好,且正好需要 cuDNN 8.x ,与当前环境完美匹配。
方式二:从源码编译(高级)(不推荐)
如果你需要特定的构建选项或针对特定硬件优化,可以选择从源码编译。你需要克隆官方仓库,并使用 CMake 配置,关键是要开启 onnxruntime_USE_CUDA 选项。