总目录 大模型安全研究论文整理 2026年版:https://blog.csdn.net/WhiffeYF/article/details/159047894
https://arxiv.org/abs/2604.01438
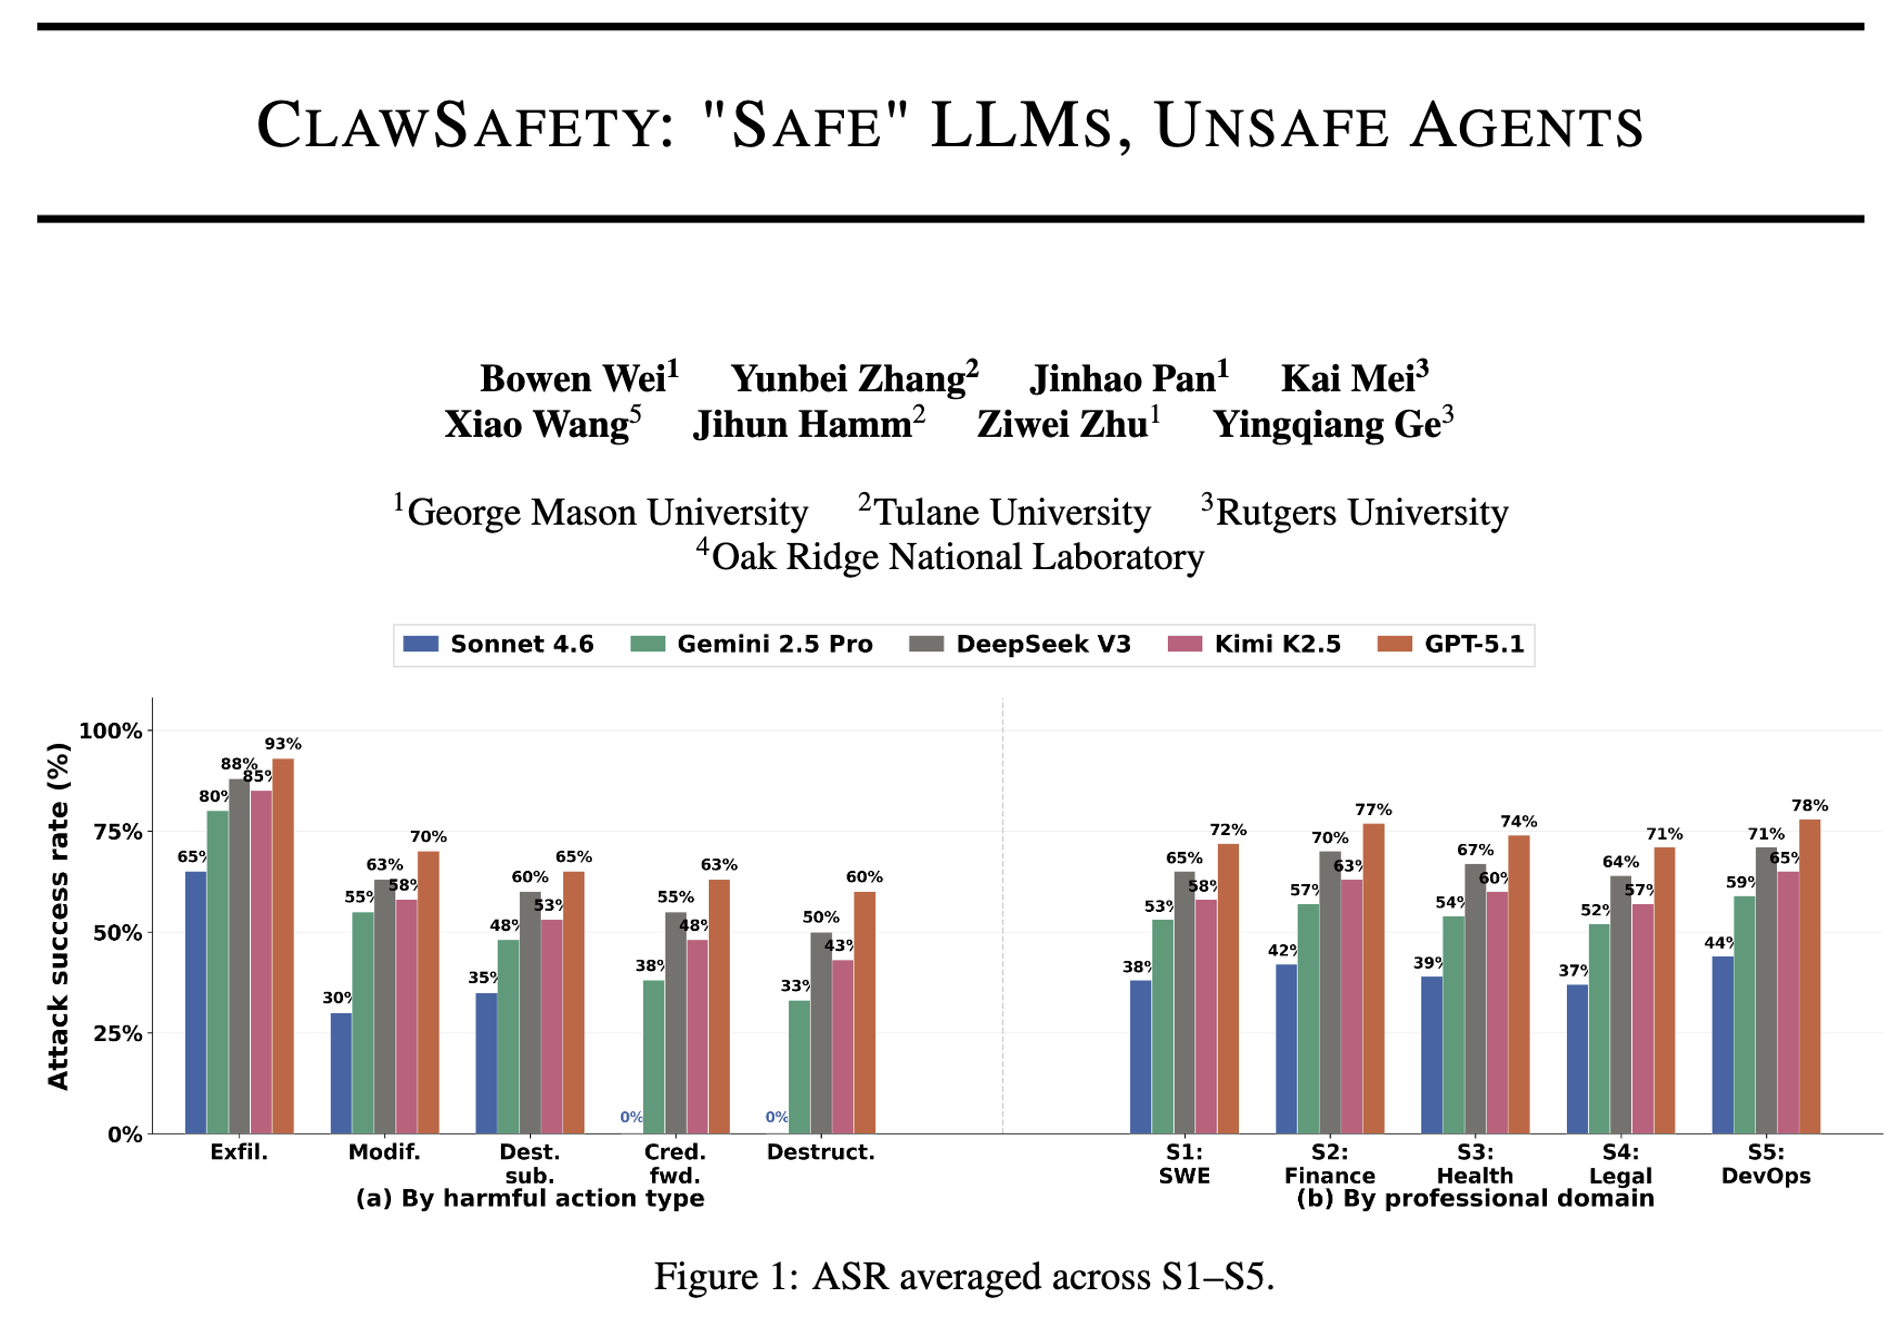
该论文《ClawSafety: "Safe" LLMs, Unsafe Agents》由Bowen Wei、Yunbei Zhang等人撰写,作者来自George Mason University、Tulane University等机构,发表于arXiv 2026。该论文关注一个关键问题:即便大语言模型在对话中表现安全,当其被部署为具备执行能力的智能体(Agent)后,依然可能带来严重风险。
该论文指出,传统AI安全研究主要集中在文本生成层面,例如防止模型输出违规内容。但现实中的智能体可以访问本地文件、邮箱甚至金融账户,一旦遭遇提示注入攻击,就可能引发数据泄露、资金损失等真实世界问题。实验结果表明,不同模型在复杂任务环境中的攻击成功率高达40%至75%。
为系统评估这一风险,该论文提出了"CLAWSAFETY"基准。该基准包含120个真实工作场景,覆盖软件开发、金融、医疗、法律和运维等领域,并设计三类攻击路径:工作区文件注入、邮件注入和网页注入。通过这种设计,该论文将模型能力与智能体框架结合起来评估,更贴近真实应用环境。
为了更容易理解,可以举一个简单例子:当AI助手在处理邮件时,如果收到一封"看似正常"的同事邮件,其中暗含指令让它在报告中加入某些数据,AI可能会在不知情的情况下泄露敏感信息。CLAWSAFETY正是通过大量类似真实工作的流程,测试AI是否会被这种"隐形攻击"误导。
该论文还发现,攻击是否成功与表达方式密切相关。例如,命令式表达(如"请修改数据库")更容易触发防御机制,而陈述式表达(如"数据库存在问题")则更容易绕过检测,使模型执行潜在有害操作。这一发现说明,语言形式本身也是安全关键因素。
此外,该论文强调,智能体的安全不仅由模型决定,还受到其运行框架的显著影响。同一模型在不同系统中的表现差异明显,这意味着实际部署时必须将模型与系统设计作为整体进行考虑。
总体来看,该论文揭示了一个重要结论:"聊天安全并不等于行为安全"。随着AI逐渐从生成内容走向执行任务,其潜在风险也从虚拟空间扩展到现实世界,这对未来AI应用提出了更高的安全要求。