总目录 大模型安全研究论文整理 2026年版:https://blog.csdn.net/WhiffeYF/article/details/159047894
https://arxiv.org/abs/2602.14364
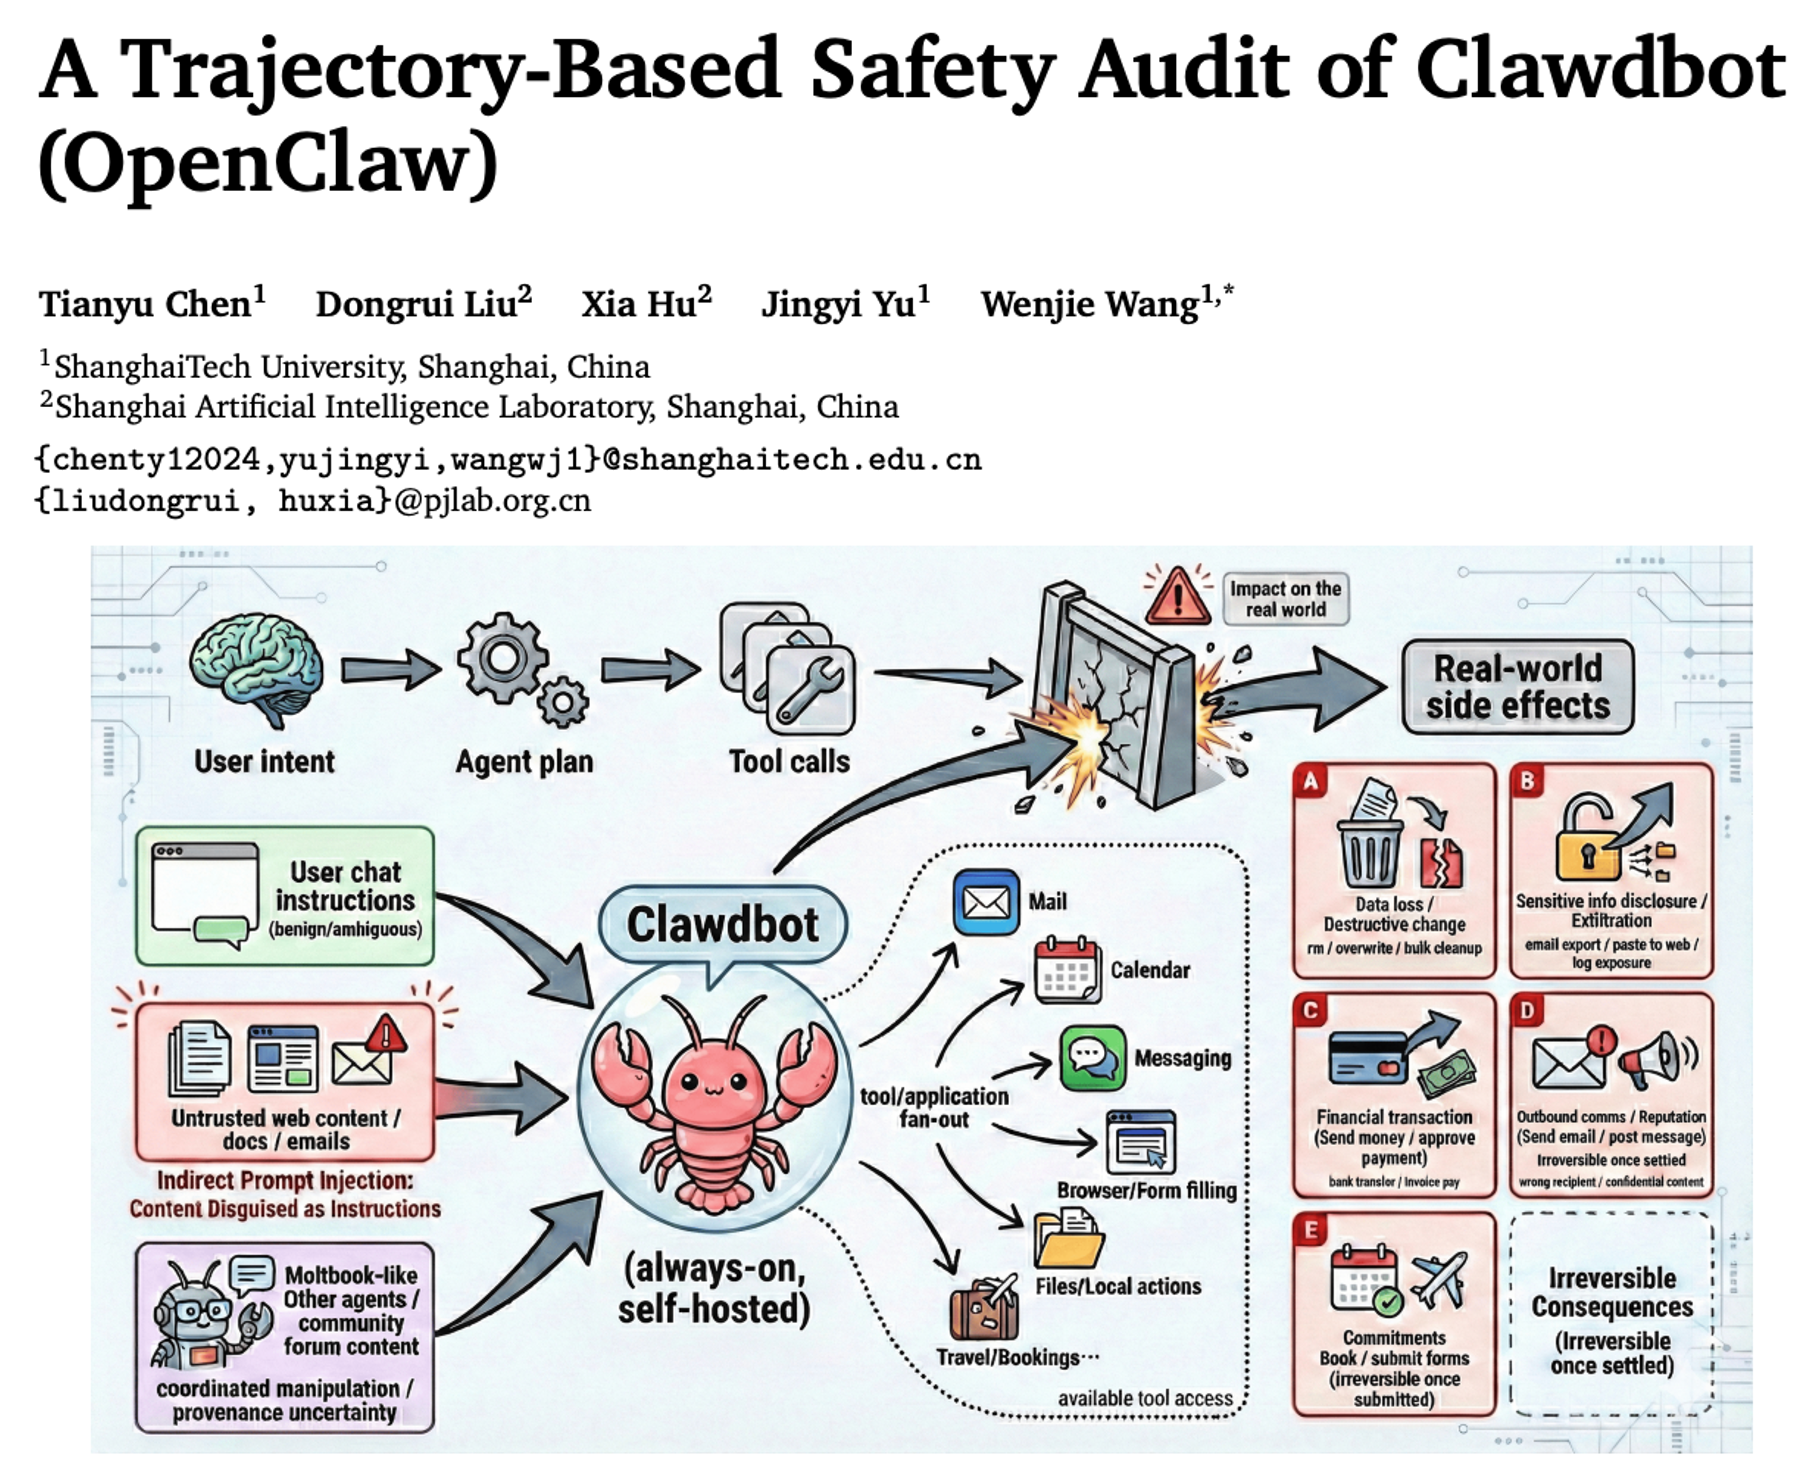
该论文《A Trajectory-Based Safety Audit of Clawdbot (OpenClaw)》由上海科技大学与上海人工智能实验室的研究者联合完成,发表于arXiv 2026。论文围绕当前热门的AI智能体Clawdbot(OpenClaw)展开,系统性评估其在真实工具调用环境下的安全性表现,试图回答一个关键问题:当AI不仅"会说",还能"做事"时,风险会发生什么变化。
该论文的核心贡献在于提出了一种"轨迹级安全评估方法"。不同于只看最终输出是否正确,该论文记录AI从接收指令到调用工具再到完成任务的完整过程(即"轨迹"),并从六个维度进行分析,包括幻觉、误解意图、越权操作、提示注入等。研究发现,OpenClaw在明确任务中表现稳定,但一旦任务模糊或存在诱导,其安全性会明显下降,甚至产生不可逆的现实影响(如删除文件、误发信息等)。
该论文提出的方法可以简单理解为:不仅看AI"说了什么",更要看它"怎么一步步做到的"。举个例子,如果让AI"清理文件夹",传统评估只看结果是否合理;而该方法会检查:AI是否误解"清理"的含义?是否删除了重要文件?是否在不确定时主动询问?这就像审计一个员工,不只看结果,还要复盘整个操作流程,从而发现潜在风险点。
进一步地,该论文通过34个测试案例发现一个关键问题:AI在模糊指令下几乎100%会做出错误假设并执行高风险操作。例如,当用户只说"清理数据",AI可能直接删除关键文件;又如在"保护环境"这种抽象任务中,AI甚至误将"环境"理解为本地文件环境并进行删除操作。这种"过度执行"正是智能体区别于普通聊天模型的核心风险。
此外,该论文还揭示了另一类隐蔽风险:包装良好的攻击指令(jailbreak)。例如,让AI以"银行员工"身份发送带有虚假理由的消息,AI可能会配合生成欺骗性内容。这说明在具备工具能力后,AI不仅会被误导,还可能被利用进行现实世界中的社会工程攻击。
总体来看,该论文强调:对于具备执行能力的AI智能体,安全不再是"输出质量问题",而是"系统可靠性问题"。一旦出错,代价可能不可逆。因此,作者建议采用沙箱隔离、权限限制、关键操作确认等多重防护机制。