在信息爆炸的 2026 年,舆情风险已成为企业品牌管理的"头号杀手"。传统的关键词匹配早已无法应对多模态、碎片化的传播环境。作为一名技术负责人,如何快速构建一套具备情感分析 、热点聚类 和实时预警能力的 AI 舆情系统?本文将带你通过 Python 与主流 NLP 模型,落地一套工程化方案。
1. 核心架构设计
一个成熟的 AI 舆情系统通常包含以下四个核心模块:
- 数据采集层 (Data Ingestion):对接社交媒体 API、新闻源或论坛爬虫。
- 数据处理层 (Processing):文本清洗、去重、分词及实体识别(NER)。
- AI 分析引擎 (AI Engine):利用大模型或专用 NLP 模型进行情感打分、主题分类。
- 可视化与预警 (Visualization & Alert):通过看板展示趋势,并在异常时触发告警。
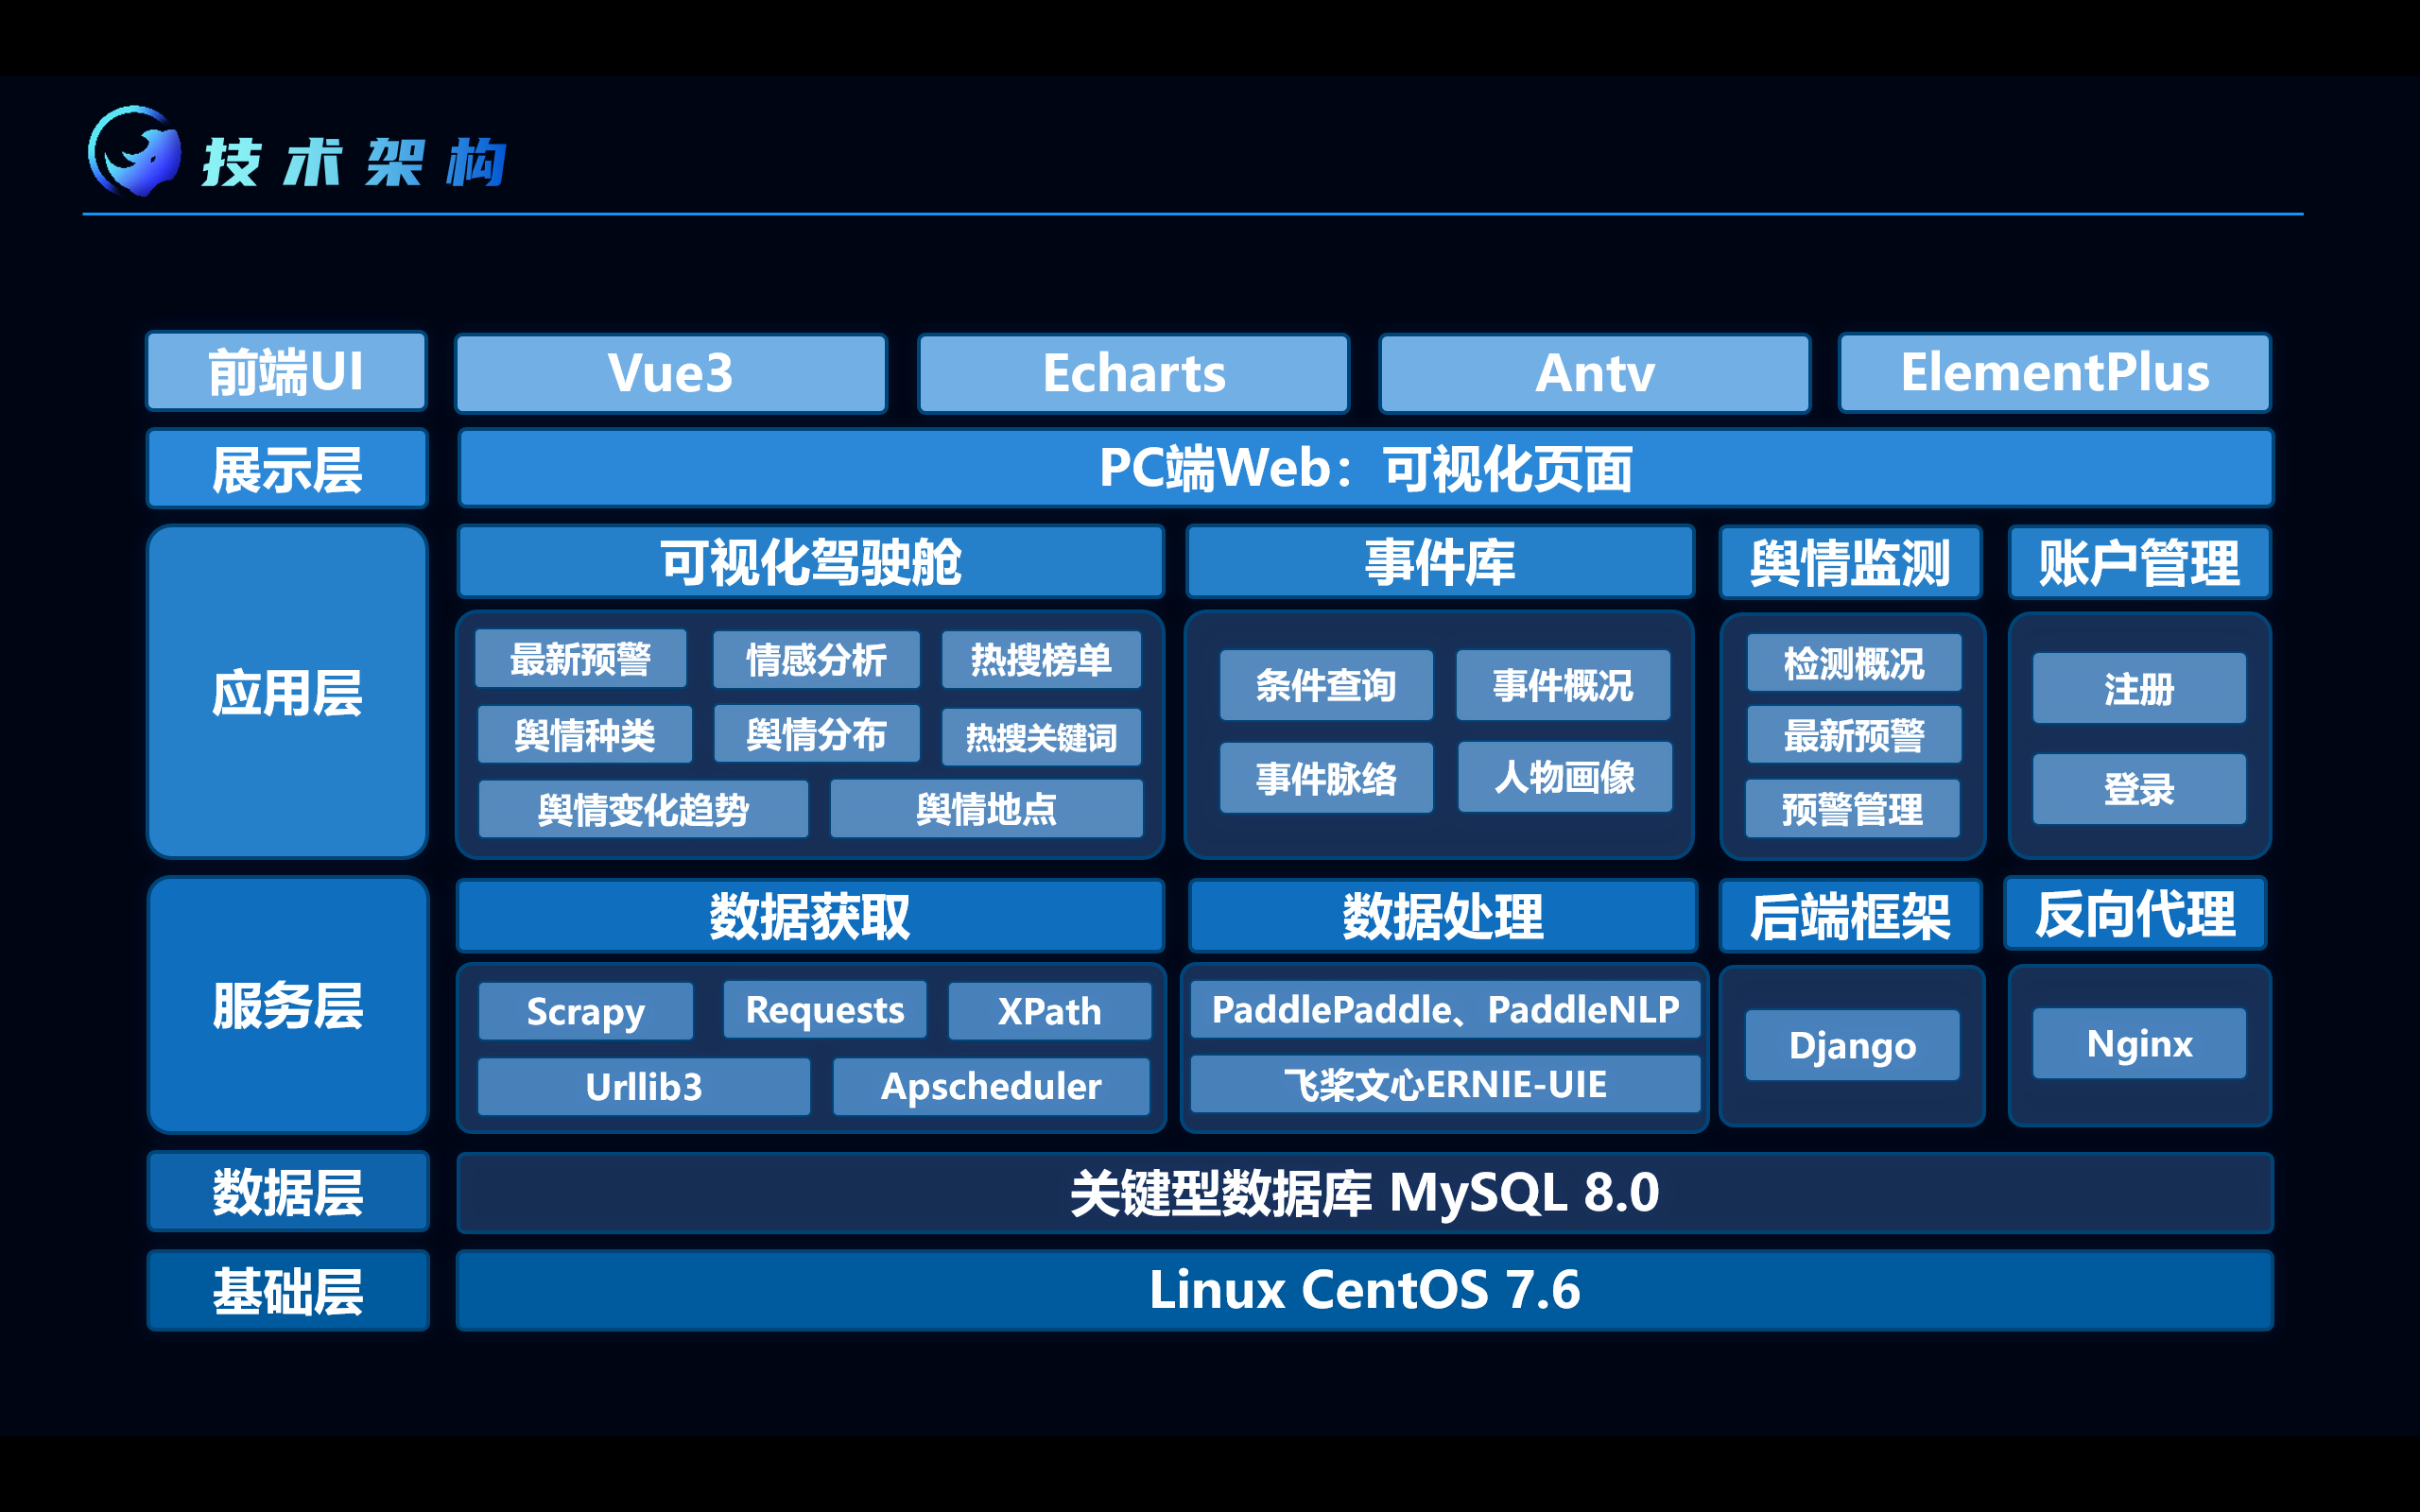
2. 关键技术栈选型
为了实现"短平快"的落地,我们推荐以下工具链:
| 模块 | 推荐工具 | 理由 |
| :--- | :--- | :--- |
| 开发语言 | Python 3.10+ | 拥有最丰富的 AI 生态库 |
| NLP 框架 | Hugging Face Transformers / PaddleNLP | 提供预训练的中文情感分析模型 |
| 向量数据库 | Chroma / Milvus | 用于海量舆情的语义检索与去重 |
| 任务调度 | Celery + Redis | 处理高并发的实时数据流 |
| 前端看板 | Streamlit / Grafana | 快速搭建数据可视化界面 |
3. 核心代码实现:情感分析流水线
我们以 transformers 库为例,实现一个简单的情感分析器。
python
from transformers import pipeline

# 加载预训练的中文情感分析模型
sentiment_pipeline = pipeline("sentiment-analysis", model="uer/roberta-base-finetuned-jd-binary-chinese")

def analyze_sentiment(texts):
    """
    批量分析文本情感
    :param texts: 文本列表
    :return: 包含标签和置信度的结果列表
    """
    results = sentiment_pipeline(texts, truncation=True, max_length=512)
    return [
        {"text": t, "label": r["label"], "score": round(r["score"], 4)}
        for t, r in zip(texts, results)
    ]

# 模拟测试数据
comments = [
    "这款产品的用户体验简直太棒了!",
    "客服态度极差,再也不会买了。",
    "物流速度一般,但包装很精美。"
]

for item in analyze_sentiment(comments):
    print(f"内容: {item['text']} -> 情感: {item['label']}, 置信度: {item['score']}")
4. 进阶:如何利用 AI 提升监控精度?
传统的监控容易陷入"关键词误伤"的陷阱。引入 AI 后,我们可以实现:
- 语义去重:利用 Embedding 模型将文本向量化,通过余弦相似度过滤重复转发的噪音。
- 观点抽取:使用 LLM(如 Qwen 或 ChatGLM)自动总结舆情焦点,例如:"用户主要抱怨的是'电池续航'而非'屏幕亮度'"。
- 多模态识别:结合 OCR 和图像分类模型,监控短视频和图片中的品牌 Logo 或敏感文字。
5. 总结与建议
对于中大型团队,建议采用**"自研引擎 + 商业平台"**的混合模式。你可以利用《集蜂云数据采集平台》解决复杂的数据采集难题,再结合自研的 AI 分析模块进行深度加工。
技术选型的核心原则: 不要为了 AI 而 AI。先从解决"漏报"和"误报"这两个痛点出发,逐步迭代你的监控闭环。
本文首发于 CSDN,作者:AI 架构师·墨言。欢迎关注我的专栏,获取更多 AI 工程化实战干货。