6. 网络优化方法之 学习率 优化/衰减策略

1. 学习率优化

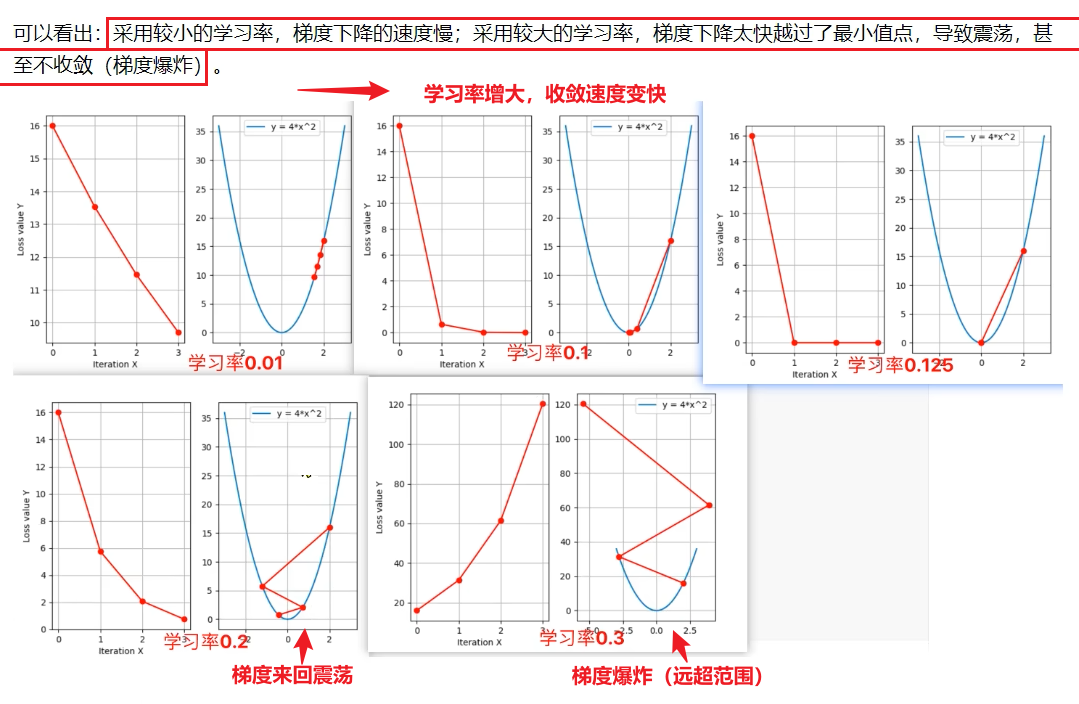
如图:学习率=0.01时收敛速度很慢,学习率=0.1时收敛速度变快,学习率越大 收敛速度越快;

学习率=0.2 即学习率较大是会 来回震荡 ,学习率=0.3 即学习率过大时会发生 梯度爆炸(即远远超出所在范围);

结论:
学习率越小,梯度下降越慢;学习率越大,梯度下降越快,可能会越过最小值,造成震荡,甚至不收敛(梯度爆炸);

2. 学习率衰减方法 (衰减策略)

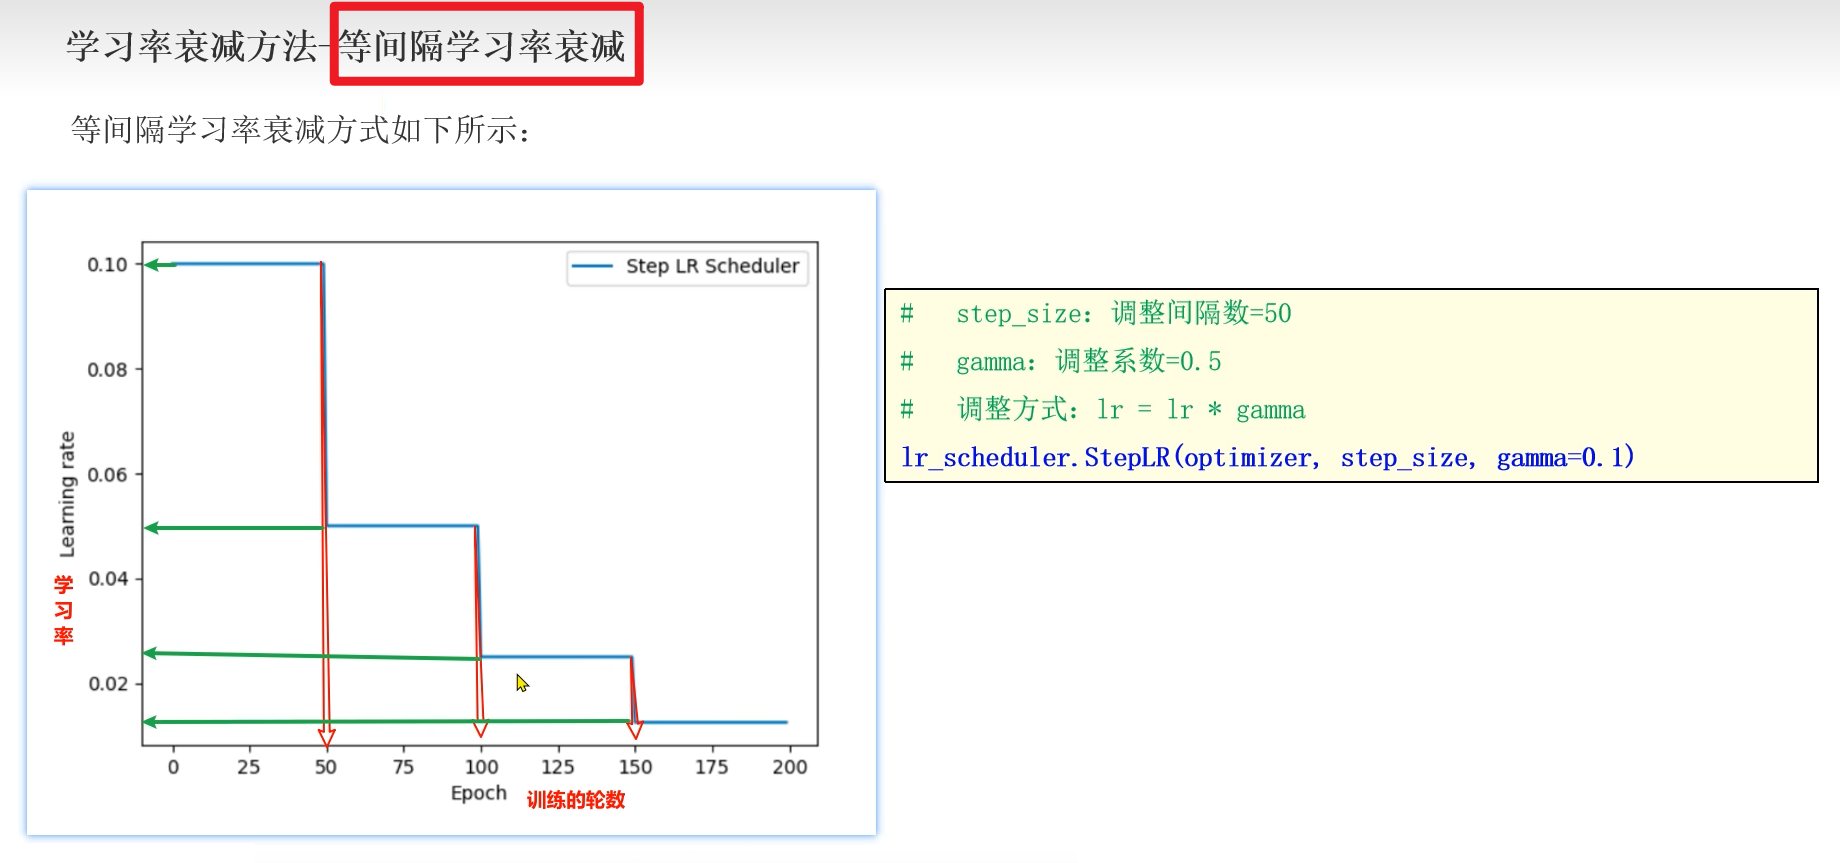
2.1 等间隔学习率衰减方法
2.2 指定间隔学习率衰减方法
2.3 指数间隔学习率衰减方法
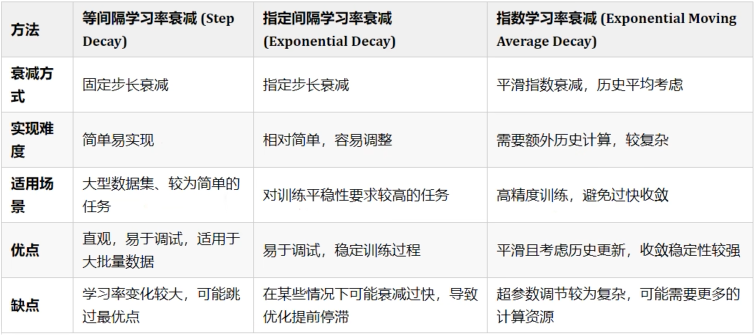
2.4 总结:

学习率衰减策略介绍:
1️⃣ 目的: 较之于AdaGrad,RMSProp,Adam方式,我们可以通过 等间隔,指定间隔,指数等方式,来手动控制学习率的调整.

2️⃣ 分类:

    等间隔学习率衰减

    指定间隔学习率衰减

    指数学习率衰减

3️⃣ 等间隔学习率衰减:

    step_size:间隔的轮数,即:多少轮调整一次学习率。

   gamma:学习率衰减系数,即:Lr新=Lr旧*gamma

    优点: 直观,易于调试,适用于大批量数据.

    缺点: 学习率变化较大,可能跳过最优解.

    应用场景: 大型数据集,较为简单的任务。

4️⃣ 指定问隔学习率衰减:

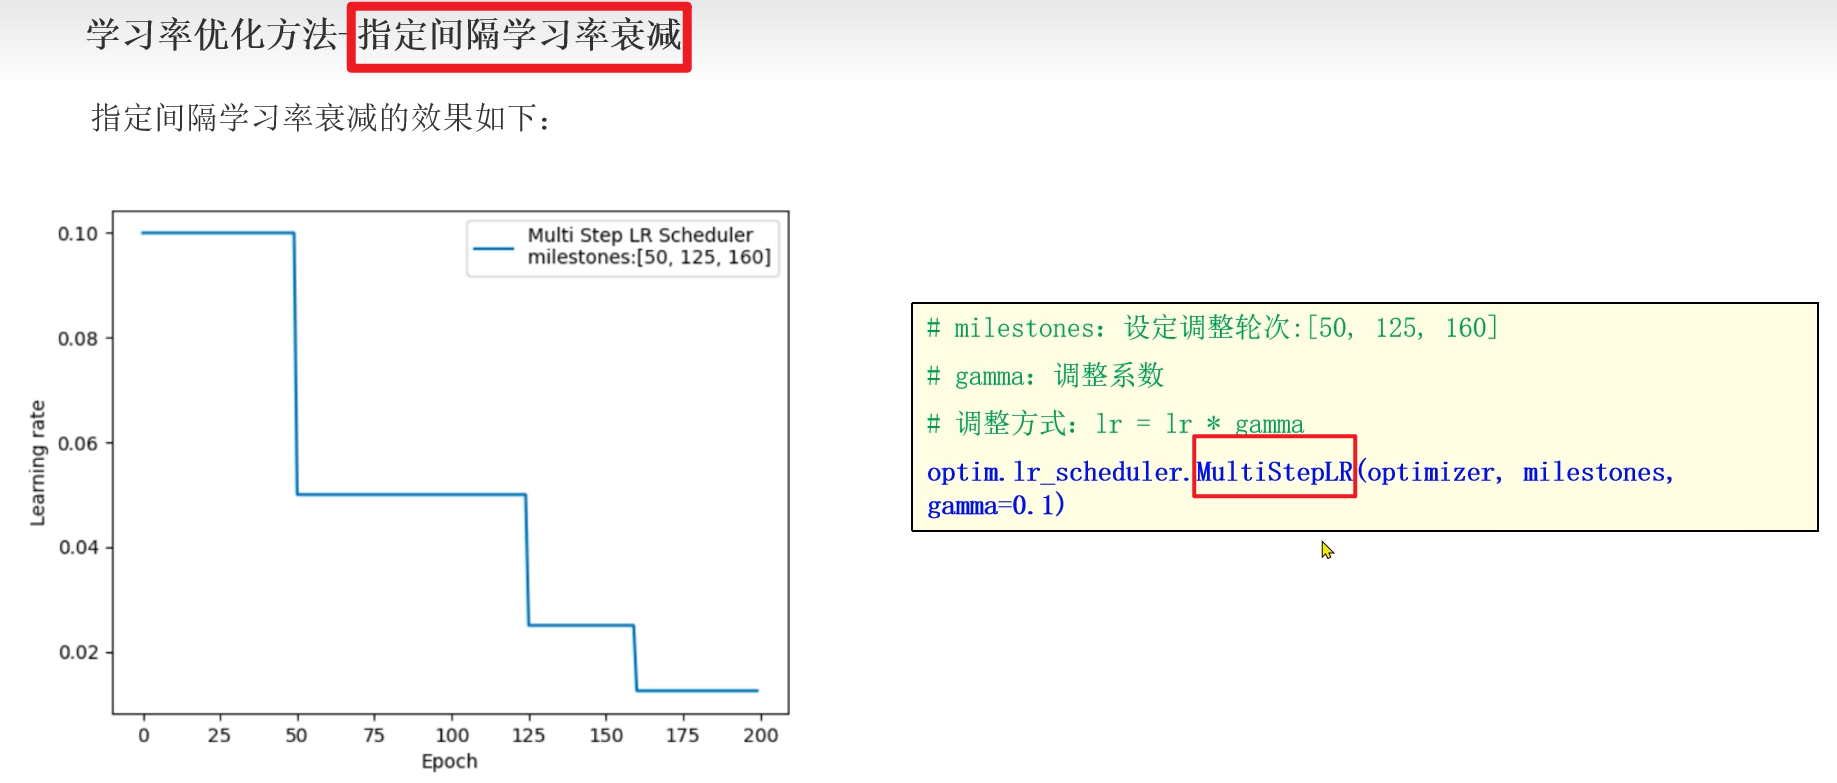
    milestones = 50, 125, 160 里边定义的是要调整学习率的 轮数。

    gamma: 学习率衰减系数,即: lr新 = lr旧 * gamma

    优点:易于调试,稳定训练过程.

    缺点: 在某些情况下可能衰减过快,导致优化提前停滞.

    应用场景: 对训练平稳性要求较高的任务。

5️⃣ 指数间隔学习率衰减:

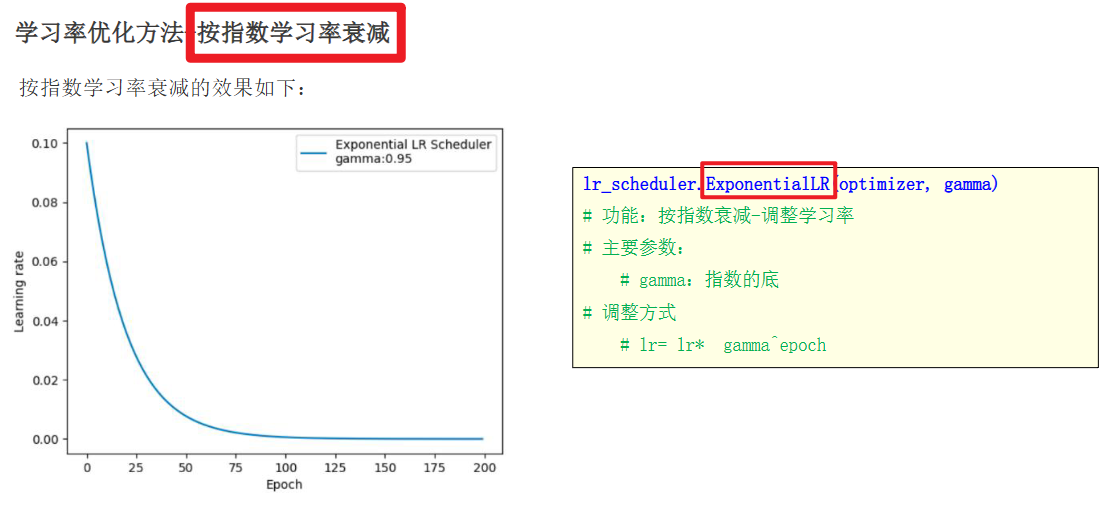
    前期学习率衰减快,中期慢,后期更慢.更符合梯度下降规律

    公式: Lr新 = Lr旧 * gamma ** epoch

    优点: 平滑,且考虑历史更新,收敛稳定性较强.

    缺点: 超参调节较为复杂,可能需要更多的资源.

    应用场景: 高精度训练,避免过快收敛.
相关推荐
kaixin_啊啊11 小时前
【用于更准确 G×E 基因组预测的大规模作物数据集与基于深度学习的多模态融合框架】论文学习
人工智能·深度学习·学习
deepseek2311 小时前
AI 模型隐藏任意能力拆解:把加密神经网络塞进宿主权重,能力评估为什么在密码学上抓不到
人工智能·深度学习·神经网络·密码学·模型安全
Smoothcloud润云12 小时前
PyTorch推理服务模型热切换与失败回滚实战:降低版本更新中断
服务器·人工智能·pytorch·python·深度学习·gpu
lll235269177913 小时前
法律咨询过程中的重要信息如何保存?
深度学习·智能手机
小王20413 小时前
Day 41:模型注意力机制 — SE / CBAM / ECA
python·深度学习·机器学习
朝朝辞暮i13 小时前
第 22 课:Conditional 1D U-Net——Diffusion Policy 怎样理解一整段未来动作?
人工智能·pytorch·深度学习·transformer·vla
探客木木夕13 小时前
结构超图重构神经网络模型:脉冲权重节点与四阶段闭环框架
人工智能·深度学习·神经网络
地理探险家13 小时前
从零实现图片自动分类:数据准备、模型训练与单图预测
人工智能·深度学习·机器学习·分类·数据挖掘·数据集
ZZHow102414 小时前
Ascend C算子开发(高级)笔记
c++·人工智能·笔记·深度学习·华为云
frankzch15 小时前
微软 137B 编码模型搬到 PC:端侧推理与 Agent 权限防线
人工智能·深度学习·microsoft·机器学习·语言模型