倾斜数据集的错误指标-混淆矩阵

有一些特殊的例子,他的样本比较小

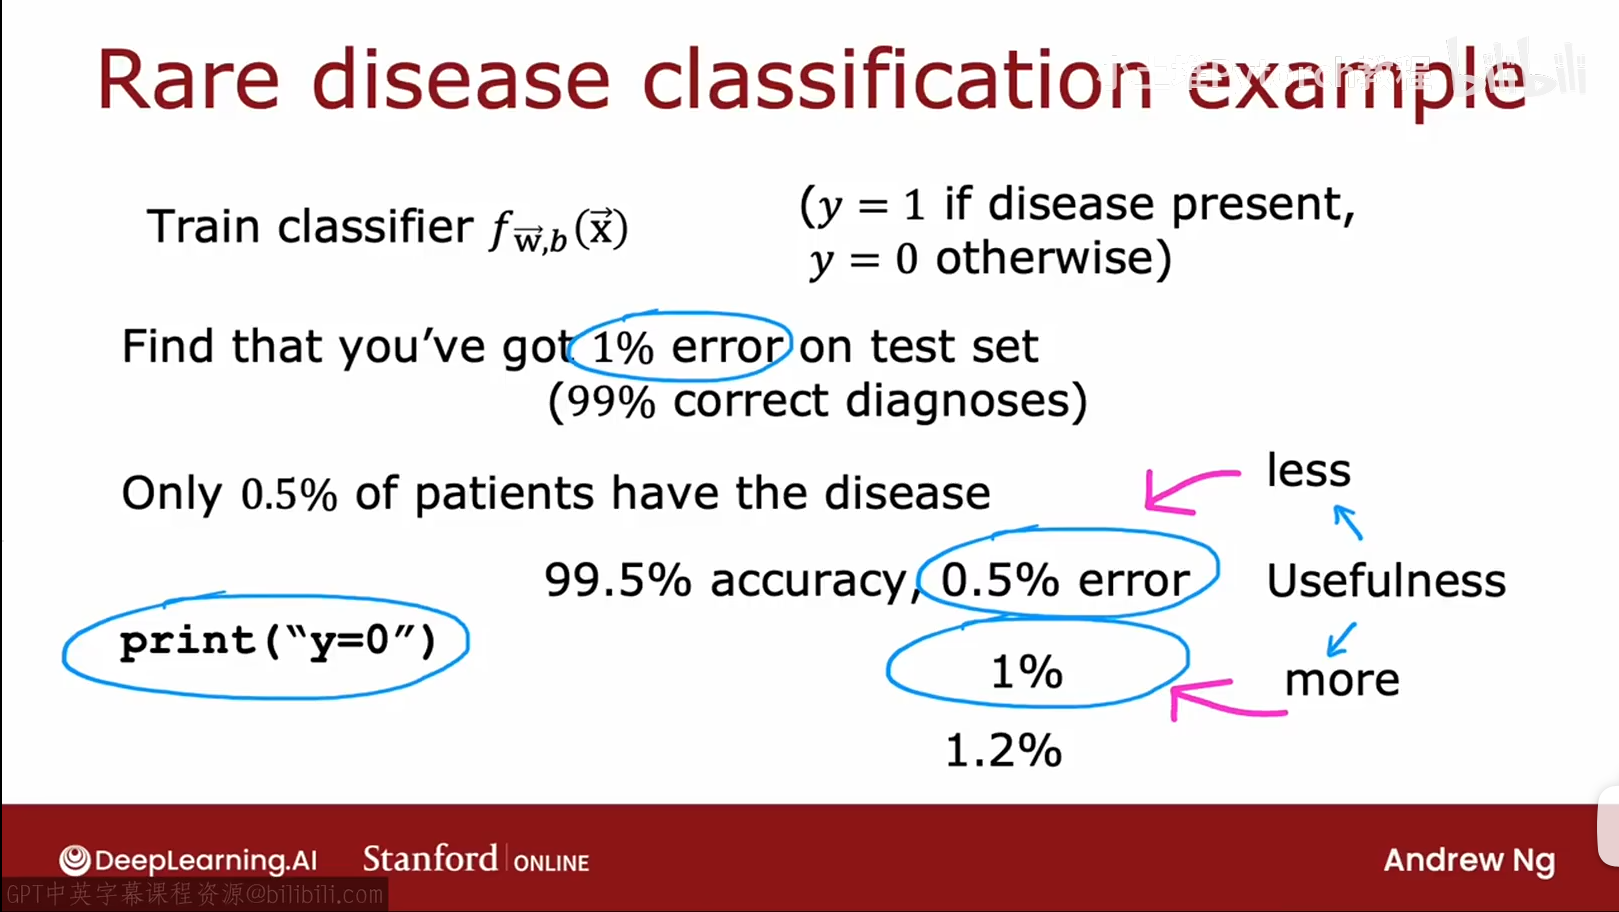
例如 有一种罕见病并且只有0.5%的患者环游该疾病

我们进行训练一个模型达到95%的准确率,

另一额模型我们我们瞬步输出患者健康,不是这个病,那么这个模型就有99.5%的准确率

如果我们仅仅只看这两个数字我们的就会选择错误的算法,所以引入一个判断算法性能的方式

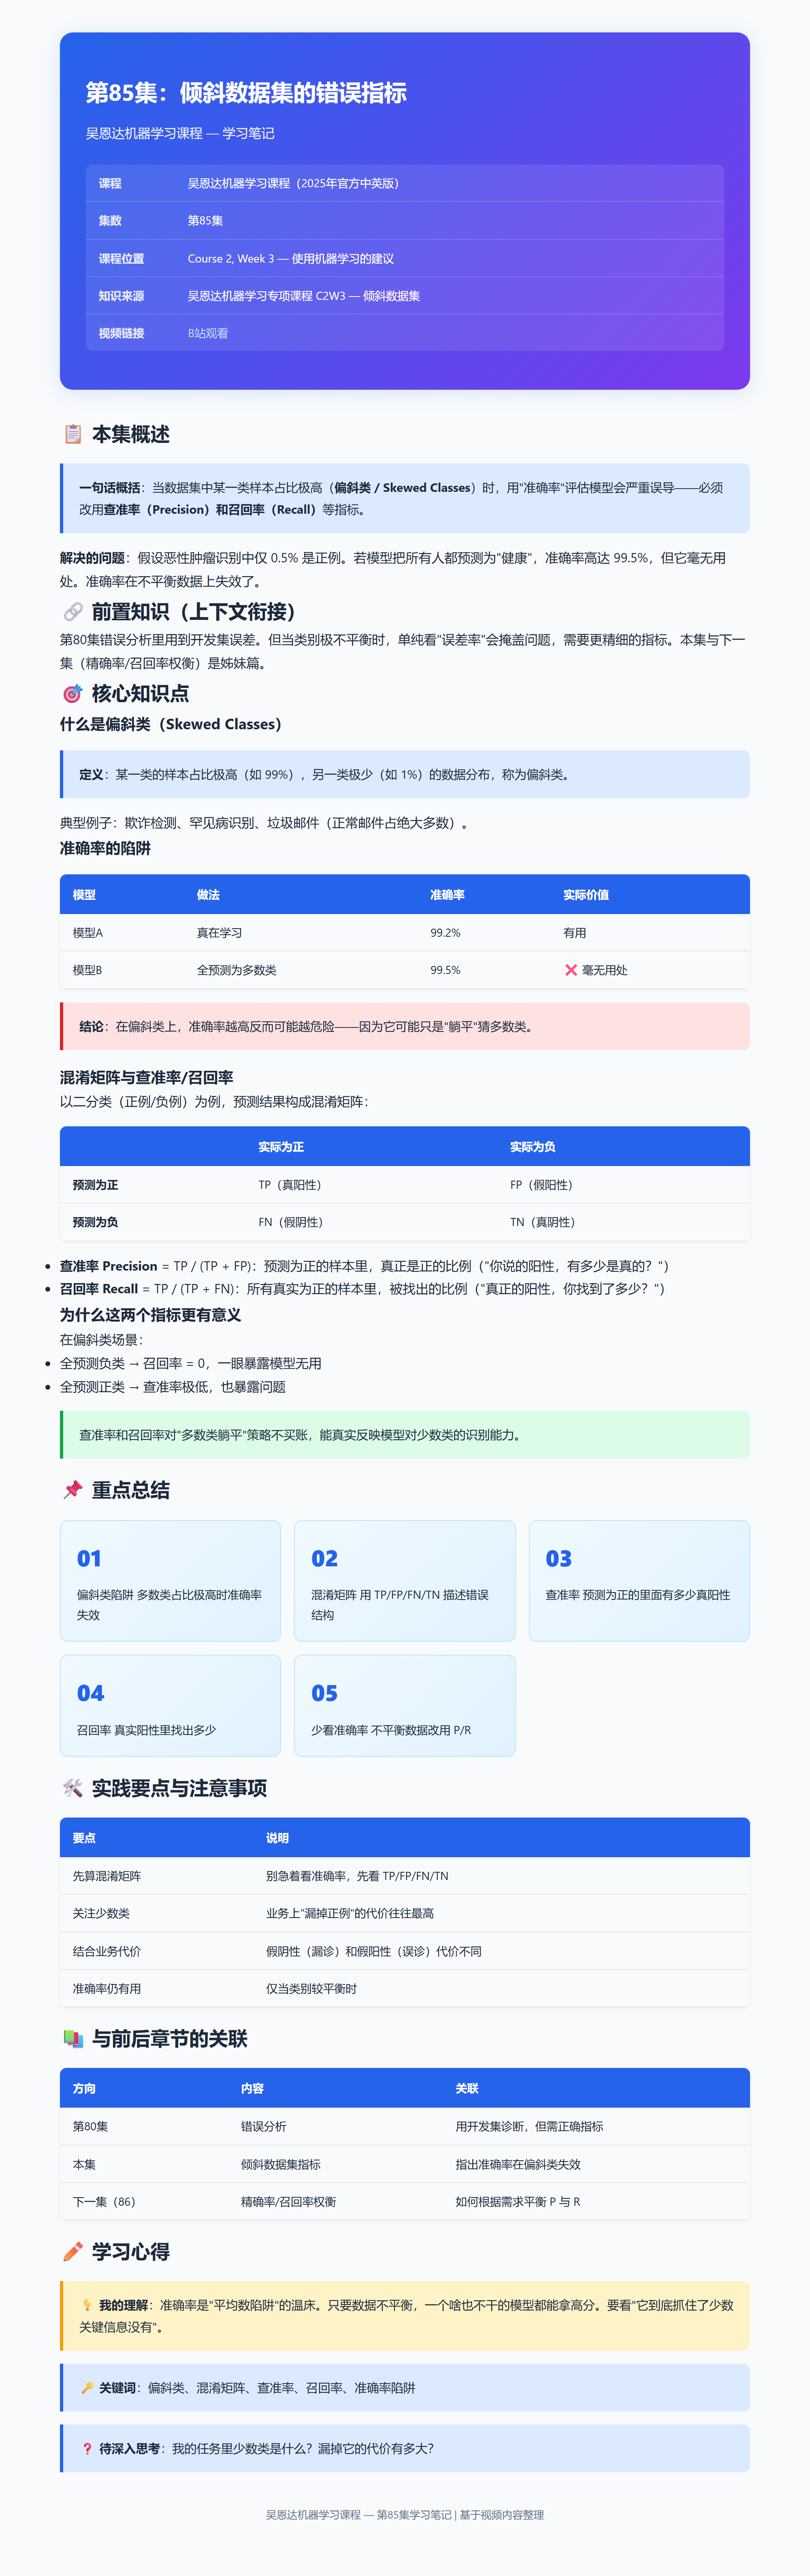
就是混淆矩阵
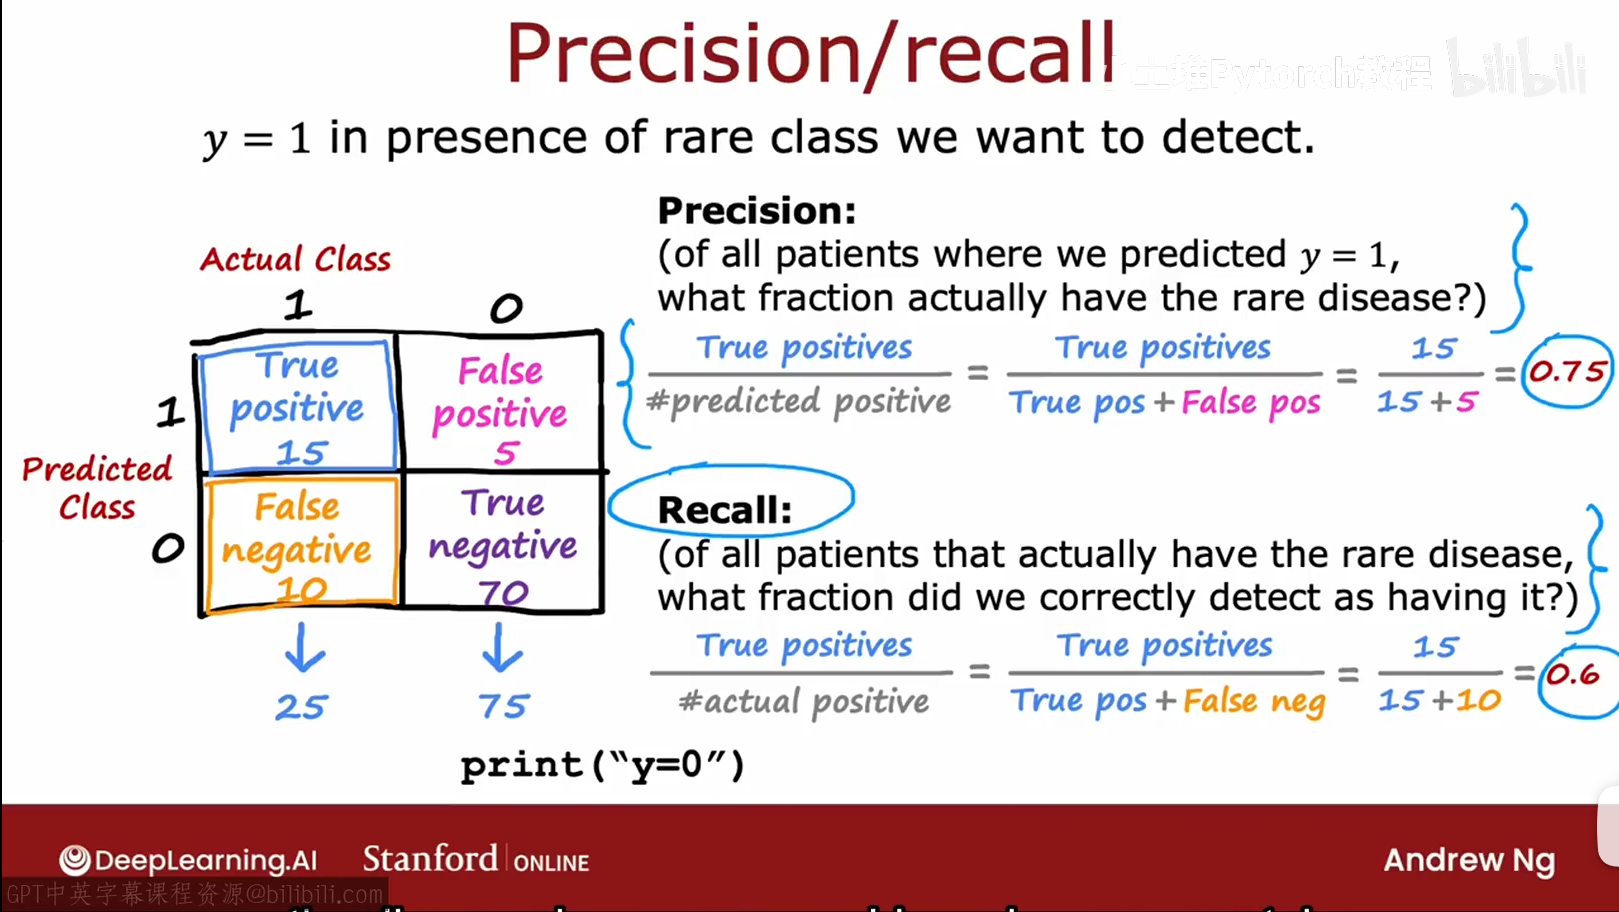
其中横轴代表真是类别

纵轴表示预测类别

这样我们就得到了四个象限

左上角 ,真是患病,预测也是患病 所以我们交真阳性

右上角 没有患病,我们预测患病 叫 假阳性

左下角 真实患病,预测没有患病 叫 假阴性

右下角 没有患病 预测没有患病,叫真阴性
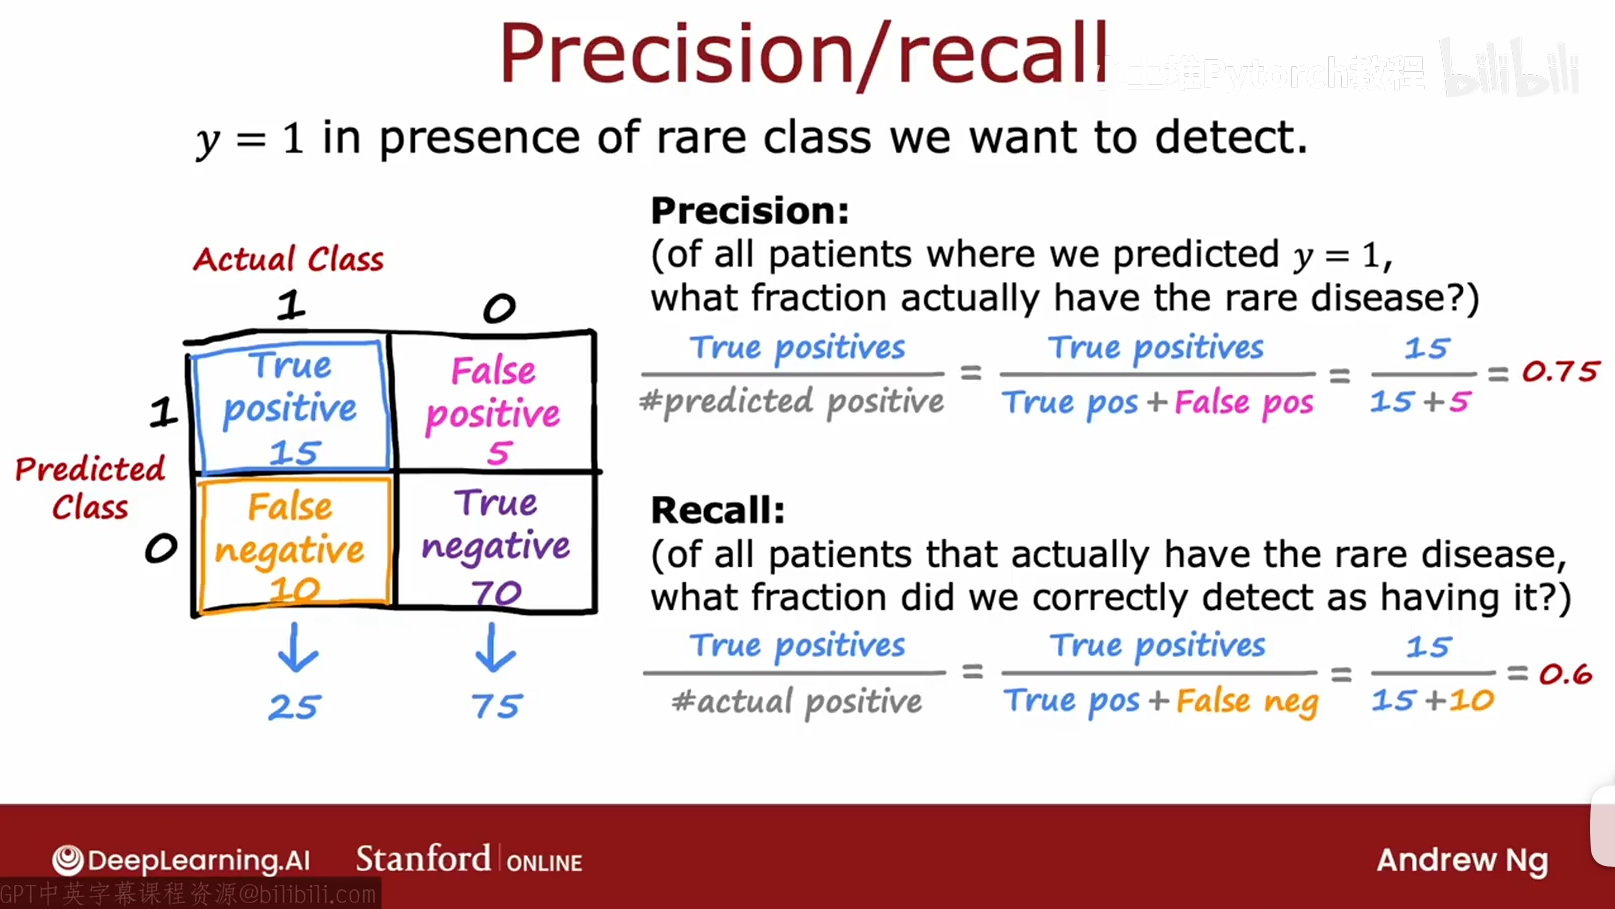
分成了四个单元格之后,我们会对齐进行两个常见的指标

分别是

精确度: 再预测为阳性中模型预测阳性是否可信,预测为阳性且实际为阳性的 / 预测为阳性的

召回率:我在所有阳性中有多少阳性抓到了,预测为阳性且实际为阳性的 / 实际为阳性的

准确率:模型预测对了多少,榆次额对的(真阴性+真阳性)/ 所有样本

精确度:返回的结果中(只返回想要的)正确的有多少

召回率:有多少个该返回的没返回

精确度:模型做对了多少

精确率和召回率在某种程度上呈现此消彼长的情况
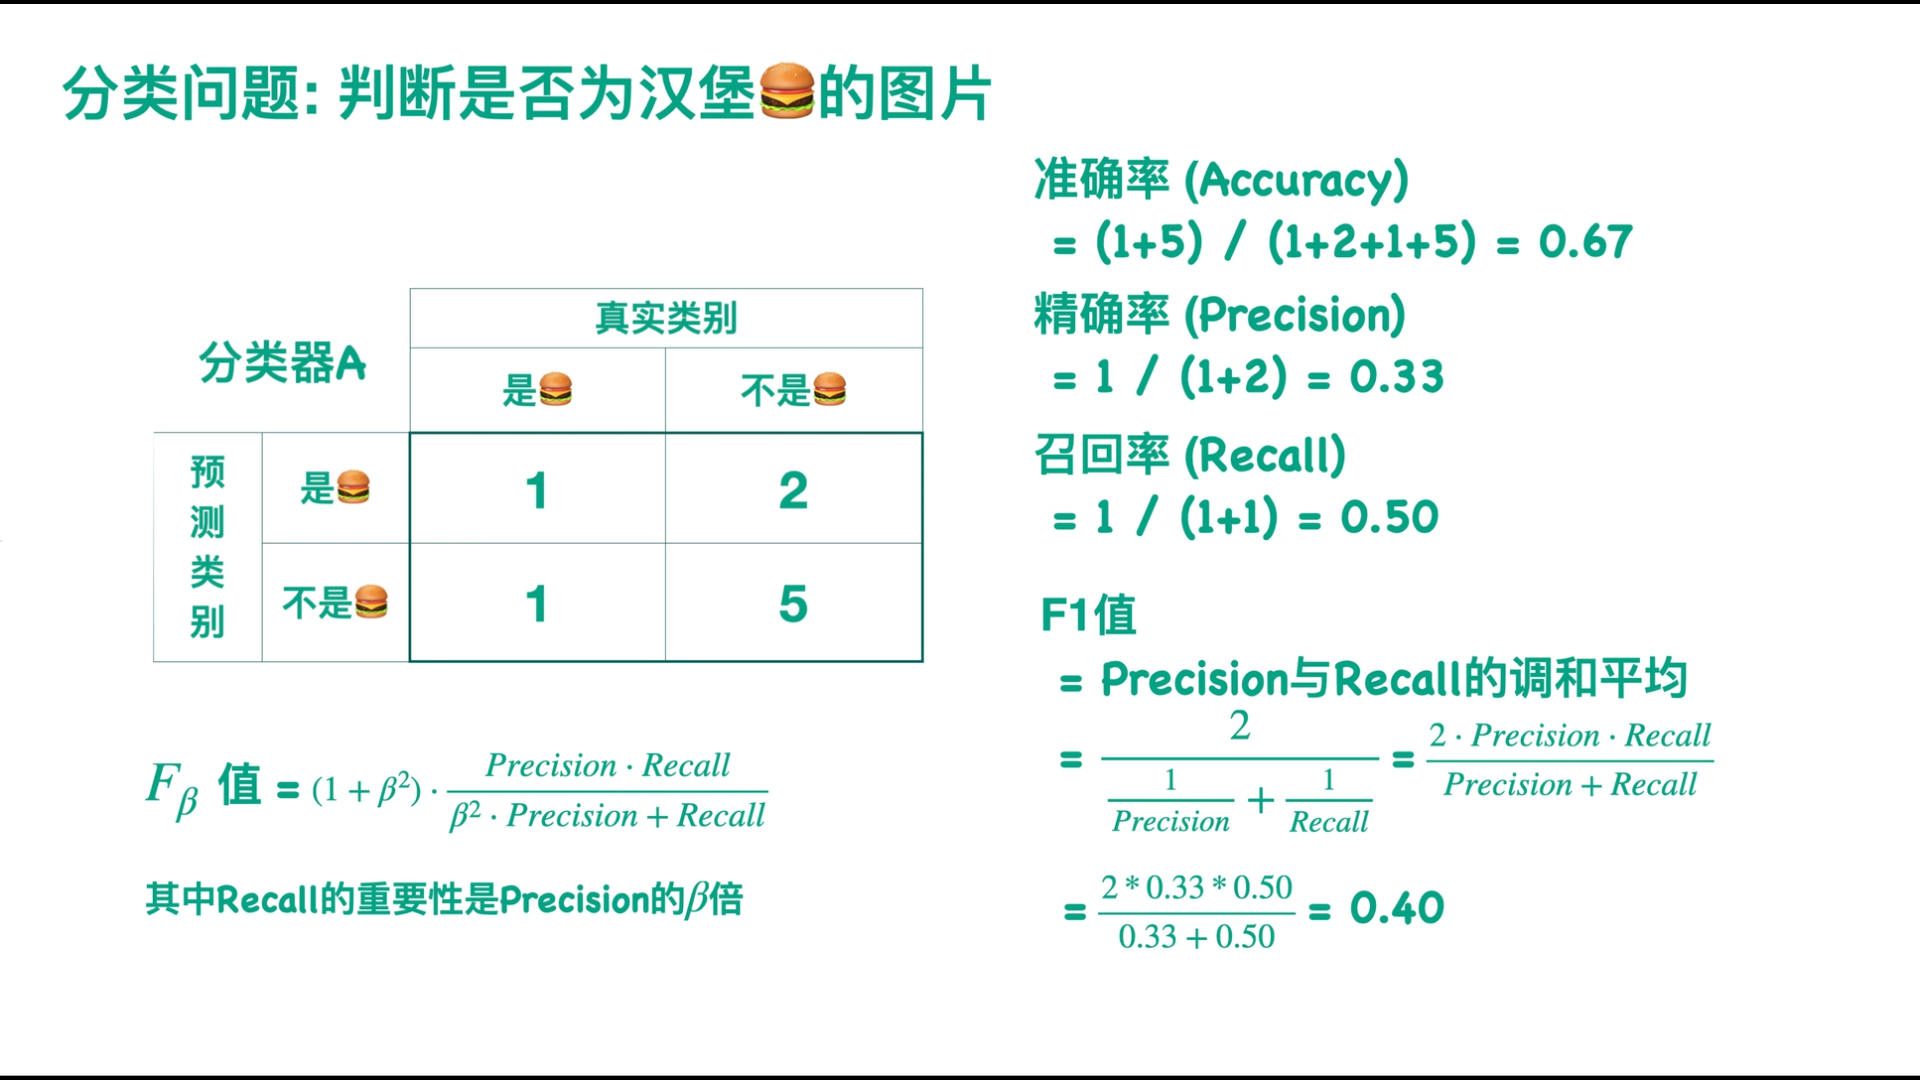
还有一个F1值

F1是精确率和召回率的调和平均 反应了整体的情况

但是什么指标最重要,要看具体情况

F1是综合的评判

例如在医疗领域我们希望不要漏掉任何一个患者

所以这个时候召回率就相当的重要。
相关推荐
锋行天下9 分钟前
Langgraph HITL 中断运行,用户输入后输出打字效果
人工智能·python
ZhengEnCi14 分钟前
agent 为什么需要自进化:从静态模型到经验驱动的持续成长
人工智能
QXWZ_IA21 分钟前
RTK平面很准、高程总飘,问题出在哪
人工智能
Ferries30 分钟前
用 WorkBuddy+DeepSeek 跑了30天自动矩阵,事情没那么简单
人工智能·aigc·vibecoding
时早玖沐33 分钟前
给 AstrBot 写一个天气推送插件:12 次提交、6 个坑
python·开源·ai编程
触底反弹39 分钟前
🚀 FastAPI 五大重难点深度剖析:从 500 报错到彻底搞懂 Depends、Pydantic 与 SQLAlchemy
python·fastapi
用户8371332007640 分钟前
AI总是会忘记细节咋办?我用GitHub实现外部记忆管理
人工智能·github
谁在黄金彼岸40 分钟前
OCR 方案对比:本地多模态可行吗?
人工智能
cpolar技术支持42 分钟前
网关加 gzip,同时开启 chunked,下载回来的包解不开:把两层编码的解压顺序与长度核对做成只读页
python·http·网络编程·socket·内网穿透
小嘉丶学长42 分钟前
Day14 · 字典与集合
java·开发语言·网络·python·学习·1024程序员节