系列第四篇。前三篇分别讲了 TS 工程初始化、LLM 的 invoke/stream 调用、Embedding 向量化与余弦相似度。本篇进入 RAG 真正的第一环------把散落各处的文件变成模型能消费的「文档」。
一、为什么"加载文档"值得单独写一篇
很多人以为做知识库第一步是调向量模型,其实不是。第一件难事是把你硬盘里那堆 CSV、PDF、Word、网页变成统一的、可切分、可向量化的数据。
现实里的数据长这样:
- 销售数据在
Sheet_20260622.csv - 产品手册是
manual.pdf - 会议纪要散在网页和 Markdown
- 合同躺在
.docx里
模型只认「文本」,而且最好是结构化、带元信息 的文本。LangChain 用 Document 这个统一抽象解决了"多格式接入"问题------不管来源是什么,加载完都变成同一种东西。
二、Document 长什么样
加载器产出的每个结果都是一个 Document 对象:
ts
interface Document {
pageContent: string; // 真正的文本内容
metadata: { // 来源、页码、行号等附加信息
source: string;
[key: string]: unknown;
};
}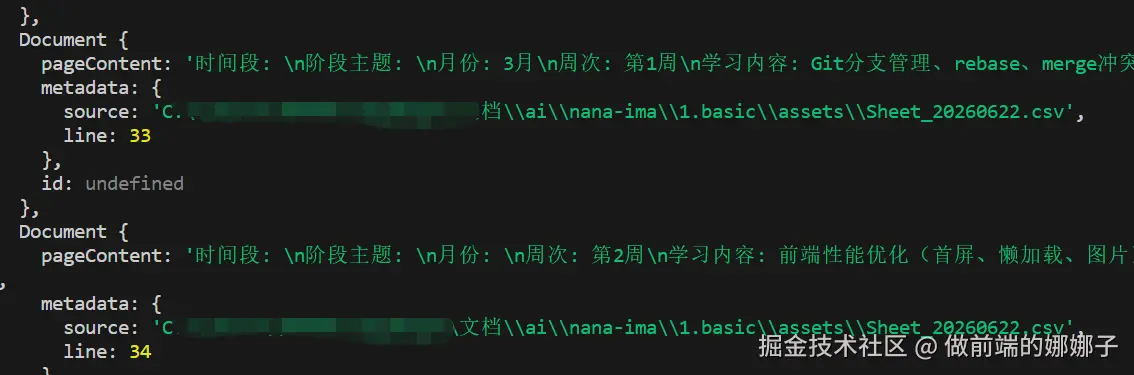 关键点:
pageContent是后续切分、向量化、检索的唯一输入metadata不参与向量化,但能在检索结果里告诉你"这段话来自哪个文件第几页",是 RAG 可溯源的基础
一句话:Document 是知识库里所有数据的"统一货币"。
三、CSV 加载实战
1. 装依赖
bash
pnpm add @langchain/communityCSV 加载底层用 d3-dsv 解析,已作为 @langchain/community 的传递依赖装好,不用单独管。
2. 代码
ts
import { CSVLoader } from "@langchain/community/document_loaders/fs/csv";
import path from "node:path";

const input = {
  filePath: path.resolve(__dirname, "../assets/Sheet_20260622.csv"),
};

export const invoke = async () => {
  const loader = new CSVLoader(input.filePath);
  const document = await loader.load();
  console.log("document", document);
  console.log("长度", document.length);
};
CSVLoader 会把 CSV 的每一行 变成一条 Document,pageContent 形如:
text
列A: 值1
列B: 值2
列C: 值3
metadata 里带 source(文件路径)和 line(行号)。
3. 入口切换
ts
import { invoke } from "./3.loader";

invoke();
想跑 embedding 就改成 import { invoke } from "./2.embedding",想跑 LLM 就改成 ./1.basic------每个模块都导出同名 invoke,入口只换一行,互不干扰。
四、踩坑:路径与编译输出
这是今天花时间最多的地方,单独列出来。
坑 1:tsc 不会复制 assets/
tsc 只编译 .ts,不会 把 assets/Sheet_20260622.csv 复制到 dist/。
编译后代码在 dist/ 执行,__dirname 指向 dist/。如果 loader 里写:
ts
path.resolve(__dirname, "./assets/Sheet_20260622.csv") // ❌ 找的是 dist/assets/...就会报 ENOENT: no such file or directory。
修复:路径退回根目录:
ts
path.resolve(__dirname, "../assets/Sheet_20260622.csv") // ✅ dist 的上一级就是项目根补充:本项目
package.json未声明"type": "module",module: nodenext实际编译成 CommonJS ,__dirname是可用的。如果你开了 ESM,要改用import.meta.url定位路径。
坑 2:peer dependency 不自动装
CSVLoader 在 @langchain/community 里,但如果你还要用 HumanMessage,它来自 @langchain/core------这是 @langchain/openai 的 peer dependency,pnpm 默认不自动装:
bash
pnpm add @langchain/core # 否则 import { HumanMessage } 报 Cannot find name坑 3:导入路径与类名必须精确
| 需求 | 正确导入 | 常见错误 |
|---|---|---|
| 加载 CSV | @langchain/community/document_loaders/fs/csv + CSVLoader |
写成 /csv 却想加载 PDF |
| 加载 PDF | @langchain/community/document_loaders/fs/pdf + PDFLoader |
以为是 loadPDF 函数 |
报错信息通常是 Cannot find module 或 Cannot find name,本质是路径/类名拼错。
五、多格式接入一览
LangChain 的 loader 体系是按来源分目录 的,都在 @langchain/community/document_loaders/fs/ 下:
| 来源 | 导入路径 | 类名 | 额外依赖 |
|---|---|---|---|
| CSV 文件 | .../fs/csv |
CSVLoader |
无 |
| PDF 文件 | .../fs/pdf |
PDFLoader |
pdf-parse |
| JSON 文件 | .../fs/json |
JSONLoader |
无 |
| 纯文本 | .../fs/text |
TextLoader |
无 |
| 网页 URL | .../web/cheerio |
CheerioWebLoader |
cheerio |
加载 PDF 的写法:
bash
pnpm add pdf-parse
ts
import { PDFLoader } from "@langchain/community/document_loaders/fs/pdf";
import path from "node:path";

const loader = new PDFLoader(
  path.resolve(__dirname, "../assets/manual.pdf")
);
const docs = await loader.load();
console.log(docs.length); // 通常一页一条 Document
经验:打通一个 CSV loader 后,其它格式只是换导入路径 + 补一个底层依赖,模式完全一致。
六、Document 标准化之后做什么
加载完拿到 Document[],下一步就是进 RAG 流水线:
css
原始文件 → Loader → Document[] → 文本切分 → 向量化 → 存入向量库
                                                  ↑
                                          本篇到此为止
切分(把长 pageContent 按长度/语义切开)和向量化(用前两篇讲的 OpenAIEmbeddings 把每段转成向量)是下一篇的内容。
衔接代码示例(把 CSV 的每行内容向量化):
ts
import { CSVLoader } from "@langchain/community/document_loaders/fs/csv";
import { OpenAIEmbeddings } from "@langchain/openai";
import { getEnv } from "./utils";

export const invoke = async () => {
  const docs = await new CSVLoader(
    path.resolve(__dirname, "../assets/Sheet_20260622.csv")
  ).load();

  const embedding = new OpenAIEmbeddings({
    model: getEnv("NANA_EMBEDDING_MODEL"),   // BAAI/bge-m3
    apiKey: getEnv("NANA_EMBEDDING_API_KEY"),
    configuration: { baseURL: getEnv("EMBEDDING_BASE_URL") },
  });

  // 把每行的 pageContent 转成向量
  const vectors = await embedding.embedDocuments(
    docs.map((d) => d.pageContent)
  );
  console.log("向量数:", vectors.length, "维度:", vectors[0].length);
};
.env 配置(已脱敏):
env
# 向量模型(硅基流动 SiliconFlow)
NANA_EMBEDDING_API_KEY=sk-你的硅基流动key
NANA_EMBEDDING_MODEL=BAAI/bge-m3
EMBEDDING_BASE_URL=https://api.siliconflow.cn/v1
DeepSeek 没有向量模型,所以 embedding 走硅基流动;生成模型继续走 DeepSeek。两者用不同 key 和 baseURL,互不干扰。
七、小结
Document(pageContent + metadata)是知识库数据的统一抽象CSVLoader/PDFLoader等 loader 把多格式文件变成Document[]- 加载时两大雷区:
tsc不复制 assets(路径要退回根目录) 和 peer dependency 不自动装 - 加载完的
Document[]是切分和向量化的直接输入
下一篇写「文本切分 + 向量存储 + 检索增强问答」,把这条流水线彻底跑通。
本篇代码来自个人学习工程 nana-ima(TypeScript + LangChain.js),所有 key 已脱敏。代码已开源上传至github