Agent响应变快了,评测法官终于定型了,知识库检索更准了。这24小时,65条提交,主线是速度和确定性。
一、Agent变快了:首条消息不再冷启动
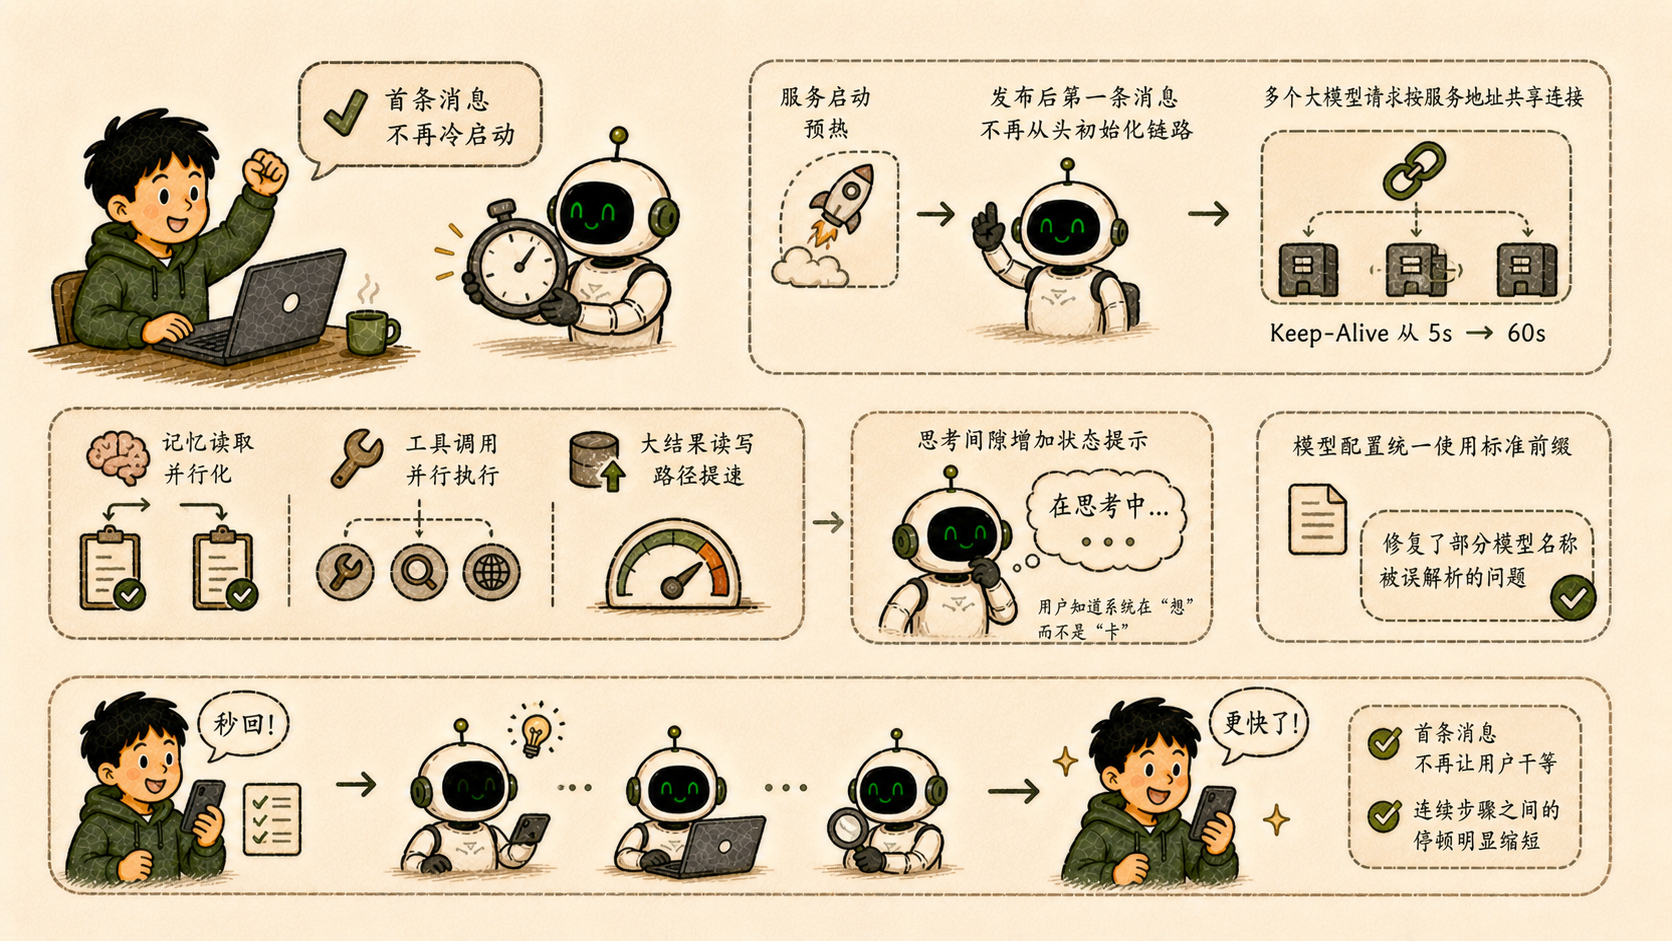
首条消息的冷启动延迟一直被诟病------发布后第一个用户总会等很久。这轮做了后端处理服务启动预热,发布后第一条消息不再从头初始化链路。多个大模型请求按服务地址共享连接,Keep-Alive从5秒提高到60秒,减少反复建连的开销。
记忆读取并行化,工具调用支持并行执行,大结果读写路径提速。新一代模型(输出思考过程的那种)在思考间隙增加了状态提示,用户知道系统在"想"而不是"卡"。模型配置统一使用标准前缀,修复了部分模型名称被误解析的问题。
首条消息不再让用户干等,连续步骤之间的停顿也明显缩短了。
二、评测法官定下来了
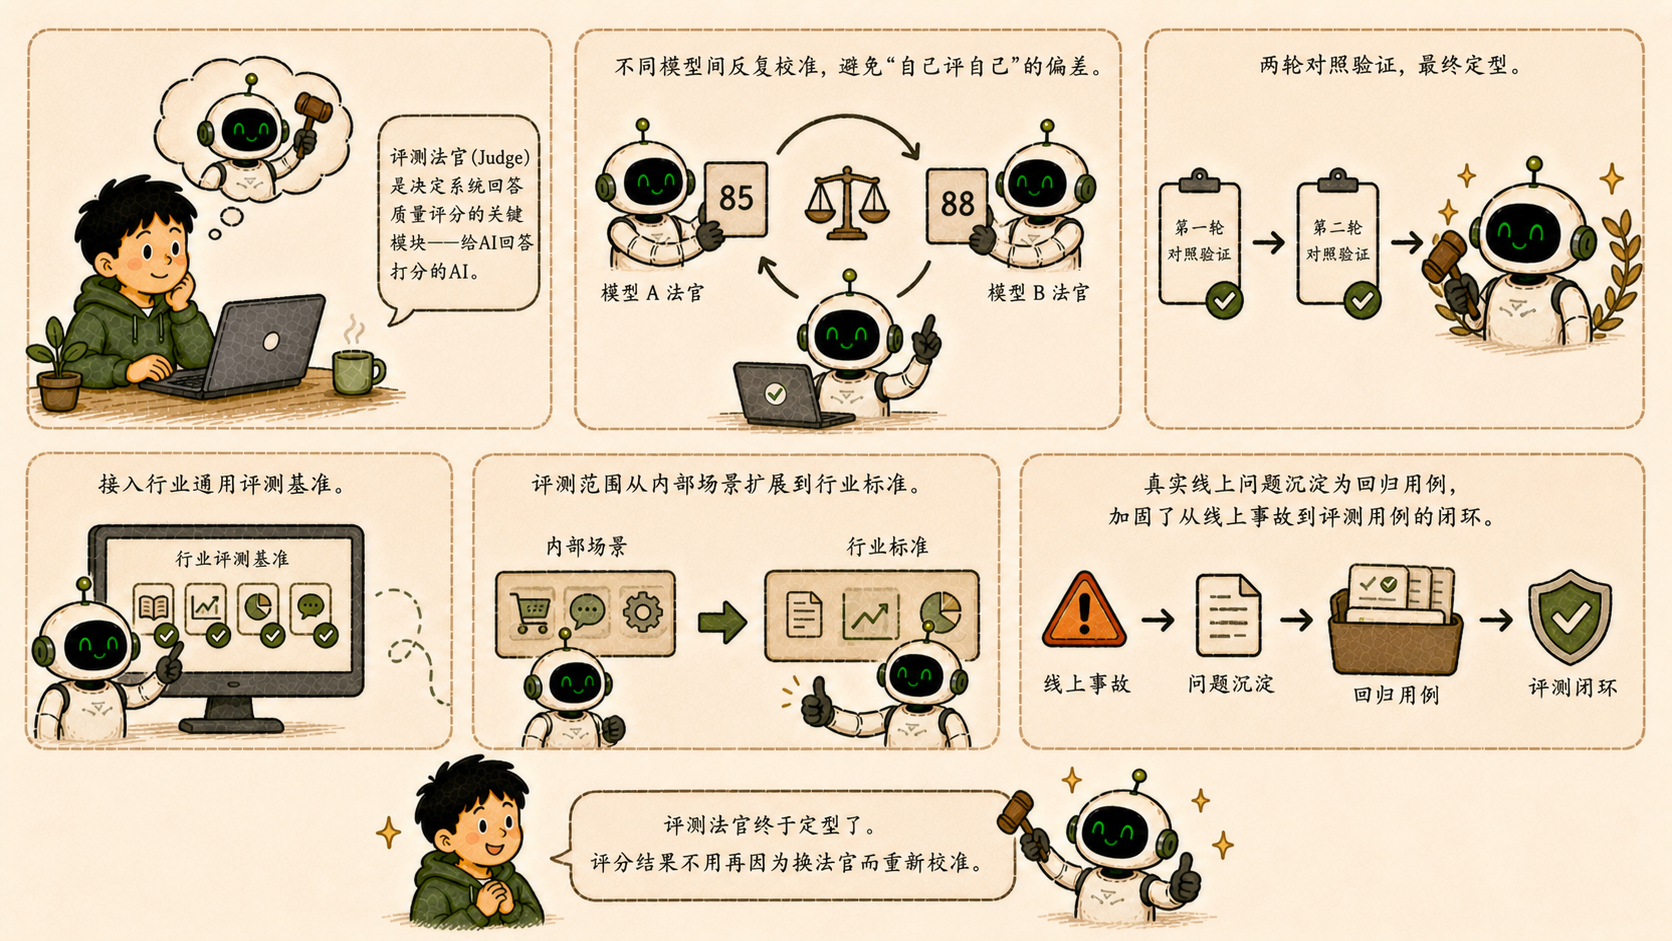
评测法官(Judge)是决定系统回答质量评分的关键模块------你可以理解为一个专门给AI回答打分的AI,这段时间在不同模型间反复校准。最终定型的模型经过两轮对照验证,不用与被测模型同型号,避免"自己评自己"的偏差。
同时接入了行业通用评测基准,评测范围从内部场景扩展到行业标准。真实线上问题沉淀为回归用例,加固了从线上事故到评测用例的闭环。
评测法官终于定型了。评分结果不用再因为换法官而重新校准。
三、知识库检索:更快、更准、更稳
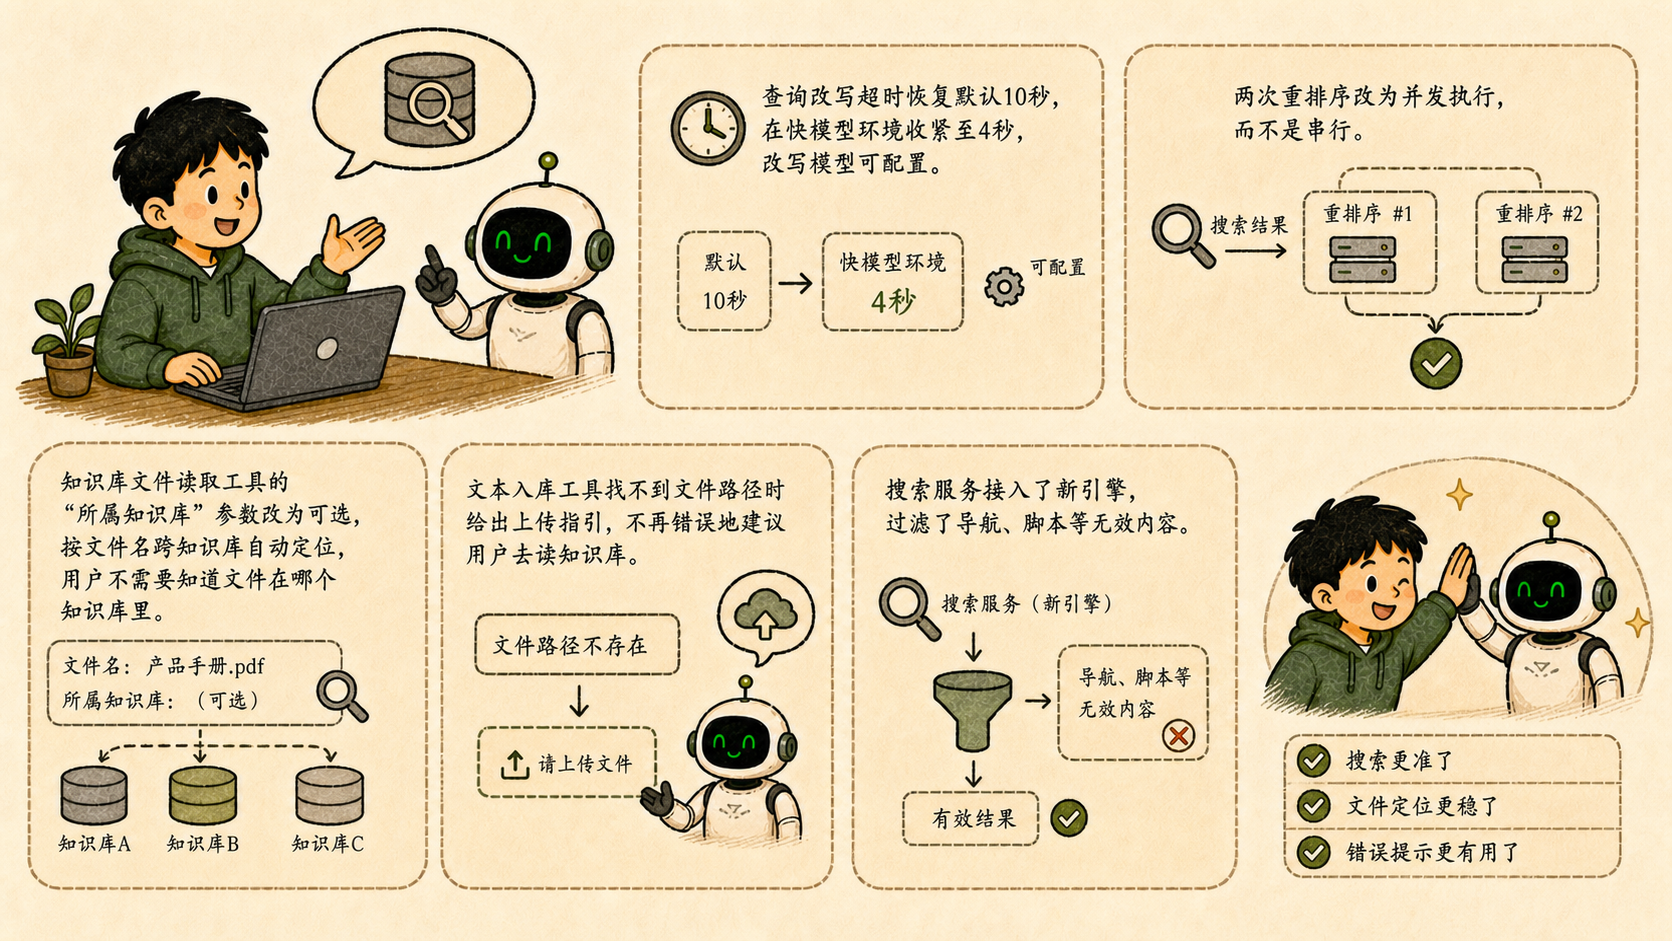
查询改写超时恢复默认10秒,在快模型环境收紧至4秒,改写模型可配置。两次重排序改为并发执行,而不是串行。
知识库文件读取工具的"所属知识库"参数改为可选,按文件名跨知识库自动定位,用户不需要知道文件在哪个知识库里。文本入库工具找不到文件路径时给出上传指引,不再错误地建议用户去读知识库。搜索服务接入了新引擎,过滤了导航、脚本等无效内容。
搜索更准了,文件定位更稳了,错误提示更有用了。
四、资源清理更干净了
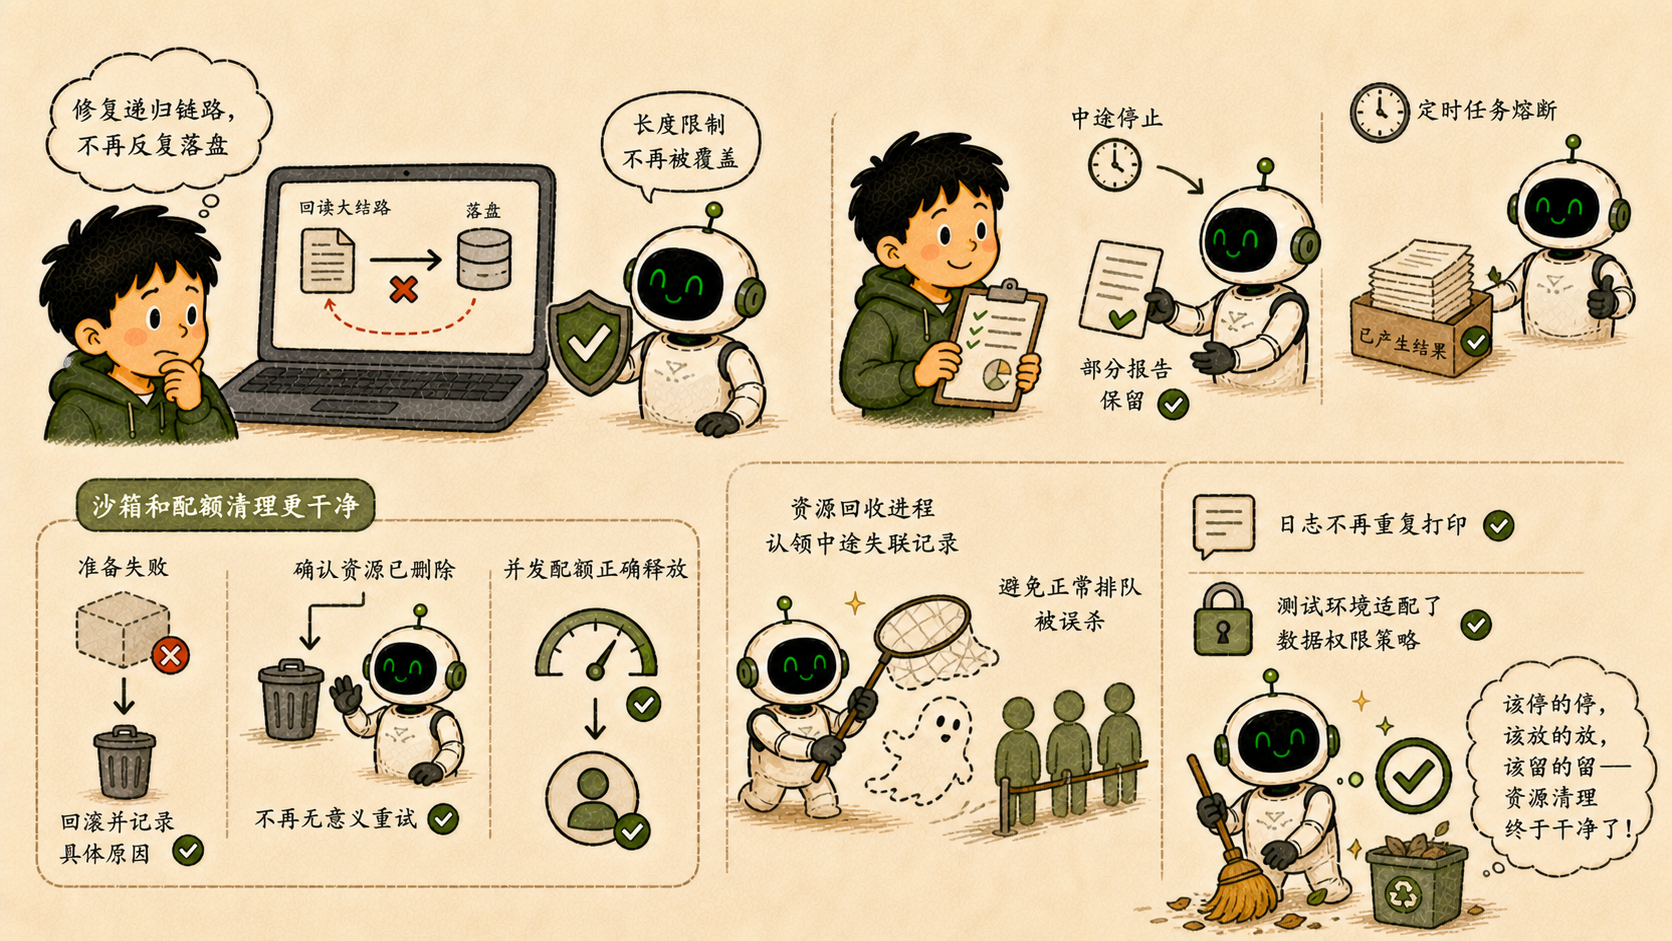
大结果落盘之前有一个问题------回读大结果时可能再次触发落盘,导致反复搬运。这轮修复了这个递归链路,调用方明确要求的长度限制不再被系统覆盖。
评测场景中途停止时,已完成的尝试保留在部分报告中,不会全部丢失。定时任务熔断前保留已产生结果。
沙箱和配额清理也更干净了:准备失败时回滚并记录具体原因,确认资源已删除后不再无意义重试,并发配额正确释放。资源回收进程能认领中途失联的记录,避免正常排队被误杀。日志不再重复打印,测试环境适配了数据权限策略。
该停的停,该放的放,该留的留------资源清理终于干净了。
Agent变快了,评测法官定下来了,搜索更准了,清理更干净了。这四条线同时推进,系统在变得更快、更准、更稳。
速度和确定性,是系统被信任的前提。
这,是第九十天。
**《从0到1:企业级AI项目迭代日记》**记录一个企业级 AI 项目从创意、架构到落地的真实过程。不讲神话,只记录进化。
如果你也在做企业 AI 落地,欢迎留言来聊。或者,把这篇转发给一个正在踩同样坑的朋友。