小 T 导读
水泥行业是典型的"连续生产、高能耗、强合规"产业。在双碳目标和精细化管控的驱动下,集团级能源管理系统需要同时应对多工厂异构数据治理、海量时序数据高效计算、复杂业务逻辑灵活扩展三大挑战。
- 多工厂计算引擎统一部署:单服务实例以 db_{factory} 库级隔离方式同时支撑多个工厂,无需为每个工厂单独部署。
- 实时触发 + 周期调度双轮驱动:TDengine TSDB Topic 订阅毫秒级触发引用点计算;XXL-Job 按不同档周期级联聚合。
- 5 分钟级联能耗聚合:5min → hour → day → month → year 自动级联,叠加峰/平/谷/尖/深五时段电价统计。
本案例面向工业时序数据高吞吐计算场景,为建材行业能源数据治理提供可落地的实践路径。
背景和痛点
金隅集团是大型建材/水泥产业集团,旗下金隅冀东水泥产能全国第三。'盾石'为其知名水泥品牌,唐山盾石水泥是集团水泥板块核心成员企业。本能源管理平台由集团信息化研发团队统一建设,覆盖多个工厂。生产流程覆盖"生料制备 → 熟料煅烧 → 水泥制成 → 环保处理"全链路。能源管理平台需要对各工厂的电、水、气、煤等能源数据进行采集、计算、统计、告警、考核。
我们能源管理系统使用传统的MySQL关系型数据库,面临以下核心痛点:
计算逻辑硬编码,扩展成本高
能源点位(如"某窑主机日用电量"、"某磨机峰时段电费")的计算公式随工艺、设备、考核口径频繁调整。传统做法将公式写死在 Java 代码中,每次新增/调整点位都要修改代码 → 测试 → 发版,响应周期长,业务方与研发反复拉扯。
实时触发与周期批量计算割裂
- 实时触发计算 (如设备状态变化、引用点更新)要求毫秒级响应
- 周期聚合统计 (如 5min/1h/1d 用电量)要求批量、可靠
两者对调度模型、并发模型、数据一致性的要求截然不同。早期基于轮询的方案要么延迟大,要么数据库压力高。
多工厂数据治理与隔离困难
集团旗下多家工厂,每家工厂的:
- 设备编码规则、点位命名习惯不一致
- 数据需独立存储、独立权限、独立 TTL
- 跨工厂统计(集团级报表)需要统一视图
简单地把所有工厂数据写入同一张表会导致子表爆炸、查询变慢、权限混乱。
累计型点位期差计算复杂
电表、水表、气表等表计类数据是累计值。业务上需要的是"一段时间内的增量"(如 5 分钟用电量 = 末读数 -- 首读数)。
- 应用层做差分:实现复杂、易出错、性能差
- 数据库层不支持:每次查询都要扫描窗口内首末两条
设备开停机状态判定逻辑复杂
设备的"开机/停机"不是简单的 status=0/1,而是多信号、有时序、带超时的状态机:
- 起始信号 + 终止信号都要满足
- 状态转换有时限(超过时限不算成功)
- 窑系统的投料状态还要结合头煤称反馈、生料流量、近 7 天均值等多维判定
传统 SQL 难以表达,应用层硬编码又难以维护。
TDengine TSDB 整体解决方案
针对上述痛点,结合 TDengine TSDB 的特性,我们从"多工厂数据库隔离、超级表与标签体系、Topic 订阅与流计算、状态机与脚本引擎融合"四大维度构建全链路解决方案,并与金隅集团能源管理业务流程深度适配。
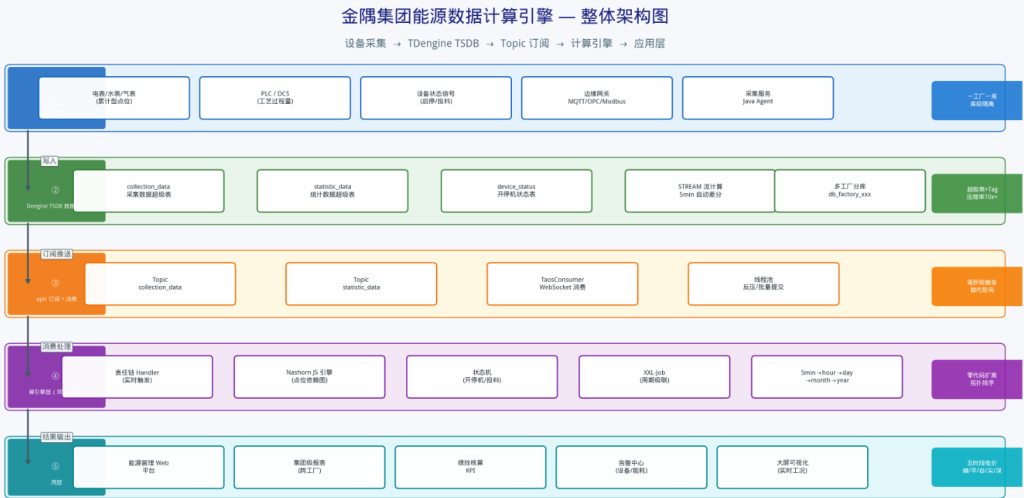
分库设计:多工厂的精细化管控
基于"一工厂一数据库"的设计原则,在 TDengine TSDB 中为每个工厂创建独立数据库:
TDengine TSDB 实例
├── db_cxx1
│ ├── collection_data (采集数据超级表)
│ ├── statistic_data (统计数据超级表)
│ ├── static_data (静态点)
│ ├── device_status (开停机状态)
│ ├── idling_status (闲置状态)
│ ├── workshift_statistic_data (班次统计)
│ ├── task_execution (任务执行记录)
│ └── alert_device_* (告警相关)
├── db_cxx2
├── db_cxx3
├── ......
业务收益:
- 工厂间数据完全隔离,权限清晰、安全合规
- 单库数据量受控,查询性能稳定
- 单库故障不影响其他工厂
超级表与标签体系:解决编码混乱与统计效率
通过 TDengine TSDB 的超级表(STable)+ 子表 + Tag模型,构建标准化点位体系。
-
主超级表设计
CREATE STABLE device_data (
_ts TIMESTAMP ENCODE 'delta-i' COMPRESS 'lz4' LEVEL 'medium',
amount DOUBLE ENCODE 'delta-d' COMPRESS 'lz4' LEVEL 'medium',
his_mark TINYINT UNSIGNED ENCODE 'simple8b' COMPRESS 'lz4' LEVEL 'medium'
) TAGS (
device_code NCHAR(16), -- 设备编码
point_code NCHAR(16), -- 点位编码
quality NCHAR(2) -- 数据质量(0=好)
);CREATE STABLE collection_data (
_ts TIMESTAMP ENCODE 'delta-i' COMPRESS 'lz4' LEVEL 'medium',
amount DOUBLE ENCODE 'delta-d' COMPRESS 'lz4' LEVEL 'medium',
his_mark TINYINT UNSIGNED ENCODE 'simple8b' COMPRESS 'lz4' LEVEL 'medium'
) TAGS (
device_code NCHAR(16),
point_code NCHAR(16),
quality NCHAR(2)
);CREATE STABLE statistic_data (
_ts TIMESTAMP ENCODE 'delta-i' COMPRESS 'lz4' LEVEL 'medium',
amount DOUBLE ENCODE 'delta-d' COMPRESS 'lz4' LEVEL 'medium',
his_mark TINYINT UNSIGNED ENCODE 'simple8b' COMPRESS 'lz4' LEVEL 'medium',
curr_value DOUBLE ENCODE 'delta-d' COMPRESS 'lz4' LEVEL 'medium'
) TAGS (
device_code NCHAR(16),
point_code NCHAR(16),
quality NCHAR(2)
);CREATE STABLE device_status (
_ts TIMESTAMP ENCODE 'delta-i' COMPRESS 'lz4' LEVEL 'medium',
status TINYINT UNSIGNED ENCODE 'simple8b' COMPRESS 'lz4' LEVEL 'medium'
) TAGS (
device_code NCHAR(16)
);
设计要点:
-
单一值列模型:amount 统一存放数值,简化 schema
-
三标签识:device_code + point_code + quality 唯一确定一条时间序列
-
类型特定编码:时间戳用 delta-i,Double 用 delta-d,整数用 simple8b,压缩率可达 10 倍以上
-
通用 lz4 压缩:速度与压缩比平衡
-
子表自动创建(写入时)
项目核心写入模式:USING ... TAGS 自动建子表
INSERT INTO db_cxx1.t_D1P10
USING db_cxx1.statistic_data
TAGS ('D1', 'P1','0')
VALUES (?, ?, ?, ?);
业务收益:
- 新设备接入零 DDL,写入时自动建子表
- 按设备/点位/质量聚合时,PARTITION BY 自动分组,极快
- 历史数据回溯、报表生成效率显著提升
- 存储空间降低 80% 以上,大幅降低了长期数据留存的经济压力。
Topic 订阅 + 流计算:实时与批量的双轮驱动
这是本项目区别于传统方案的核心创新点。
Topic 订阅:毫秒级实时触发
TDengine TSDB 支持把写入的数据通过 Topic 主动推送出去(类似 Kafka 语义)。本项目为每个工厂创建两个 Topic:
# 采集数据 Topic
create topic if not exists cxx1_collection_data as
  (select _ts, amount, his_mark, device_code, point_code, quality
   from db_cxx1.collection_data);

# 统计数据 Topic
create topic if not exists cxx1_statistic_data as
  (select _ts, amount, his_mark, device_code, point_code, quality
   from db_cxx1.statistic_data);
服务端用 TaosConsumer 订阅(WebSocket 连接,无需 native 客户端):
// 简化示意,实际在 TDConsumerRunner.java
TaosConsumer<Map<String, Object>> consumer = new TaosConsumer<>(
    "cxx1_collection_data",
    props,
    new MapDeserializer()
);消费模型设计要点:
- 异步线程池处理(核心 CPU*2 ~ CPU*4,队列 CPU*100),避免阻塞消费
- 批量提交 offset:每 100 条或每 5 秒
- 拒绝策略 CallerRunsPolicy:反压,不丢消息
- 优雅关闭:60 秒等待处理完
收到消息后,通过 IMessageHandler 责任链处理:
- DiagramTriggerHandler → 大屏推送
- DataTriggerHandler → JS 引擎实时计算引用点
- StartStopHandler → 开停机状态机
- MaterialFeedingHandler → 窑系统投料状态机
业务收益 :实时数据从落库到触发计算,端到端毫秒级,替代轮询方案的秒级延迟。
流计算:5min 期差自动差分
针对累计型点位(电/水/气表),用 TDengine TSDB 原生流计算(STREAM)做时间窗口差分:
CREATE STREAM device_data_5min_diff
INTERVAL(5m) SLIDING(5m)
FROM device_data
PARTITION BY device_code,point_code,quality STREAM_OPTIONS(WATERMARK(5m) | fill_history)
INTO device_data_5min_diff
OUTPUT_SUBTABLE(CONCAT('device_data_5min_diff_', cast(device_code as varchar), cast(point_code as varchar), cast(quality as varchar)))
TAGS (device_code nchar(16) as device_code, point_code nchar(16) as point_code, quality nchar(2) as quality)
AS
SELECT _twstart as _ts,
      (LAST(amount) - FIRST(amount)) as amount
    FROM device_data
    WHERE _c0 >= _twstart
      and _c0 < _twend
      and device_code=%%1
      and point_code=%%2
and device_code=%%3;业务收益:
- 计算下沉到数据库,服务端零代码
- 自动增量计算,不会重复
- 业务侧直接读 device_data_5min_diff 即可拿到 5min 用量
状态机 + 脚本引擎:复杂业务逻辑零代码扩展
这是本项目的业务核心创新,TDengine TSDB 提供数据底座,Nashorn + 状态机提供业务灵活度。
点位依赖图 + Nashorn JS 引擎
业务方在 emp 主服务配置点位的 JS 计算脚本,本服务启动时:
- 拉取配置 → 合并所有点位
- 构建依赖图(PointGraphHandler):识别引用、聚合、期差、分摊关系
- 拓扑排序(priorityNodes):生成每个周期的计算优先级(确保父节点先于子节点)
- 脚本压缩缓存:用 YUI Compressor 压缩后存 Redis
- Nashorn 预编译:每个工厂独立 ScriptEngine 实例
周期任务执行时:
// PeriodTaskRunner 核心流程
List<PointName> priorityPoints = redis.getPriorityPoints(factory, period);
for (PointName point : priorityPoints) {
    Object result = nashorn.invokeFunction(
        FunctionUtils.getFunctionName(point.getDeviceCode(), point.getPointCode()),
        dataContext   // 持有所有取值点 + 时间窗口 + TDengine  TSDB 访问能力
    );
    // 范围校验 → 写入 statistic_data
}业务收益 :新增/调整计算点位完全由业务方在配置端完成,服务零发版。
开停机状态机
StartStopHandler 用状态机管理设备启停流程:
状态:0=停止, 1=启动中, 2=运行中, 3=停止中
开机流程:
配置的"开始点位"全部=1 → 状态 0→1(启动中),缓存开始时间
→ 配置的"结束点位"全部=1 → 状态 1→2(运行中)
→ 若在时限内,记录开停机数据
停机流程:
配置的"开始点位"全部=0 → 状态 2→3(停止中)
→ 配置的"结束点位"全部=0 → 状态 3→0(停止)
状态变更实时写入 device_status 超级表,统计写入 device_status_statistics。
窑系统投料判定
MaterialFeedingHandler 针对水泥窑专门设计:
| 状态 | 判定条件 |
|---|---|
| 开机条件 | 窑主电机应答具备(status=1) 且 头煤称反馈 ≥ 限值 且 生料流量达标(日产 ≥ 4500t 时 >120 t/h,否则 >100 t/h) |
| 开机→运行 | 投料量 ≥ 近 7 天均值 × 90% 持续 30 分钟 |
| 停机条件 | status=0 或 头煤称 < 限值 或 投料量 ≤ 阈值 |
近 7 天均值通过 getSumAmount 回溯查询 90 天内最近 7 天的有效投料量计算。
核心 SQL 应用示例:支撑能源管理关键场景
本项目通过 TDengine TSDB 时序函数(last、first、last_row、聚合 + PARTITION BY、INTERVAL)编写核心 SQL,覆盖"实时触发计算、周期聚合、状态查询、任务追踪"四大场景。
场景 1:周期任务聚合查询(按方法)
每个周期任务执行时,查询某点位在某时间窗口的聚合值。
SELECT last(_ts),
       last(amount),
       avg(amount),
       sum(amount),
       max(amount),
       min(amount),
       device_code,
       point_code,
       quality
FROM db_cxx1.statistic_data
WHERE device_code = 'XXX'
  AND point_code  = 'YYY'
  AND quality     = '0'
  AND _ts >= '2024-07-12 23:55:00'
  AND _ts <  '2024-07-13 00:00:00'
GROUP BY device_code,point_code,quality;业务意义:5 分钟周期任务执行时,读取"上一周期该点位多个聚合值",作为后续计算的输入。
场景 2:批量查询多点位最新值
一次查询多个点位的最新值,减少 RTT。
SELECT last(_ts),
       last(amount),
       device_code,
       point_code,
       quality
FROM db_cxx1.collection_data
WHERE ((device_code='D1' AND point_code='P1' AND quality='0')
    OR (device_code='D1' AND point_code='P2' AND quality='0')
    OR (device_code='D2' AND point_code='P1' AND quality='0'))
    AND _ts >= '2024-07-12 23:55:00'
    AND _ts <  '2024-07-13 00:00:00'
GROUP BY device_code,point_code,quality;业务意义:周期任务批量取值阶段,一次性读取当前周期所有需要点的值,大幅减少数据库往返。
场景 3:设备开停机状态查询(first/last)
#-- 查询设备最后一次状态
SELECT last(_ts), last(status), device_code
FROM db_cxx1.device_status
WHERE device_code='D1'
GROUP BY device_code;

#-- 查询设备首次进入某状态(用于状态机回溯)
SELECT first(_ts), first(status), device_code
FROM db_cxx1.device_status
WHERE device_code='D1' AND status=1
GROUP BY device_code;业务意义:开停机状态机判定时,查询上次状态变更时间,决定是否触发状态转换。
场景 4:时间窗口期差(流计算结果)
--- 直接读取流计算结果,无需应用层做差分
SELECT _ts, amount
FROM device_data_5min_diff
WHERE device_code='D1' AND point_code='P1'
  AND _ts >= '2026-07-12 00:00:00'
  AND _ts <  '2026-07-13 00:00:00'
ORDER BY _ts;业务意义:能耗 5min 级联聚合时,直接拿到每个 5 分钟的用量增量,无需扫窗口首末值。
能耗级联聚合:5min → year 五档自动链式触发
能耗计算,支持峰/平/谷/尖/深五时段电价统计,并通过级联机制自动完成多周期聚合。
五时段点位前缀(Consumptions.java)
| 级别 | 代码 | 用量前缀 | 费用前缀 | 运行时长 |
|---|---|---|---|---|
| 尖 TIP | "1" | useele_jsdl_ | use_jsdf_ | dur_yjsc_ |
| 峰 PEAK | "2" | useele_fsdl_ | use_fsdf_ | dur_yfsc_ |
| 平 NORMAL | "3" | useele_psdl_ | use_psdf_ | dur_ypsc_ |
| 谷 VALLEY | "4" | useele_gsdl_ | use_gsdf_ | dur_ygsc_ |
| 深 DEEP | "5" | useele_dsdl_ | use_dsdf_ | dur_ydsc_ |
级联触发流程
5min 能耗任务完成
↓ 延迟 10s(ScheduledExecutorService)
小时聚合 → day 聚合 → month 聚合 → year 聚合
↓
ConsumptionService.aggreateConsumptions
(按 峰/平/谷/尖/深 分时段聚合用量、费用、运行时长)
业务收益
- 实时性:5min 数据完成后 10s 内自动触发上级聚合
- 准确性:每级聚合基于下一级已计算好的结果,避免重复扫描原始数据
- 灵活性:峰平谷尖深五时段通过点位前缀天然支持,无需额外表结构
未来规划
为进一步提升数据利用价值,我们规划在以下方向演进:
数据生命周期管理
- 探索 TDengine TSDB 多级存储(0 级 SSD / 1 级 HDD) + 对象存储归档,进一步降低成本
计算引擎升级
- 评估 GraalJS 替代 Nashorn
- 探索补偿计算自动化
智能分析扩展
作者:金隅集团 赵宇飞