一、任务定义
项目将评论分析拆成三个独立分类任务:投诉分流四分类、虚假评论二分类、广告骚扰二分类。每个任务使用自己的训练数据和分类头。
二、为什么选择 BERT
bert-base-chinese 已经在大量中文语料上进行预训练,具备基础中文语义能力。相比从零训练 Transformer,微调预训练模型需要的数据和算力更少,也更适合项目快速验证。
传统 TF-IDF 只能表达词频,FastText 擅长关键词和子词模式,但对复杂上下文的处理有限。BERT 通过双向 Transformer 建模上下文,适合处理否定、语序和语义重叠。
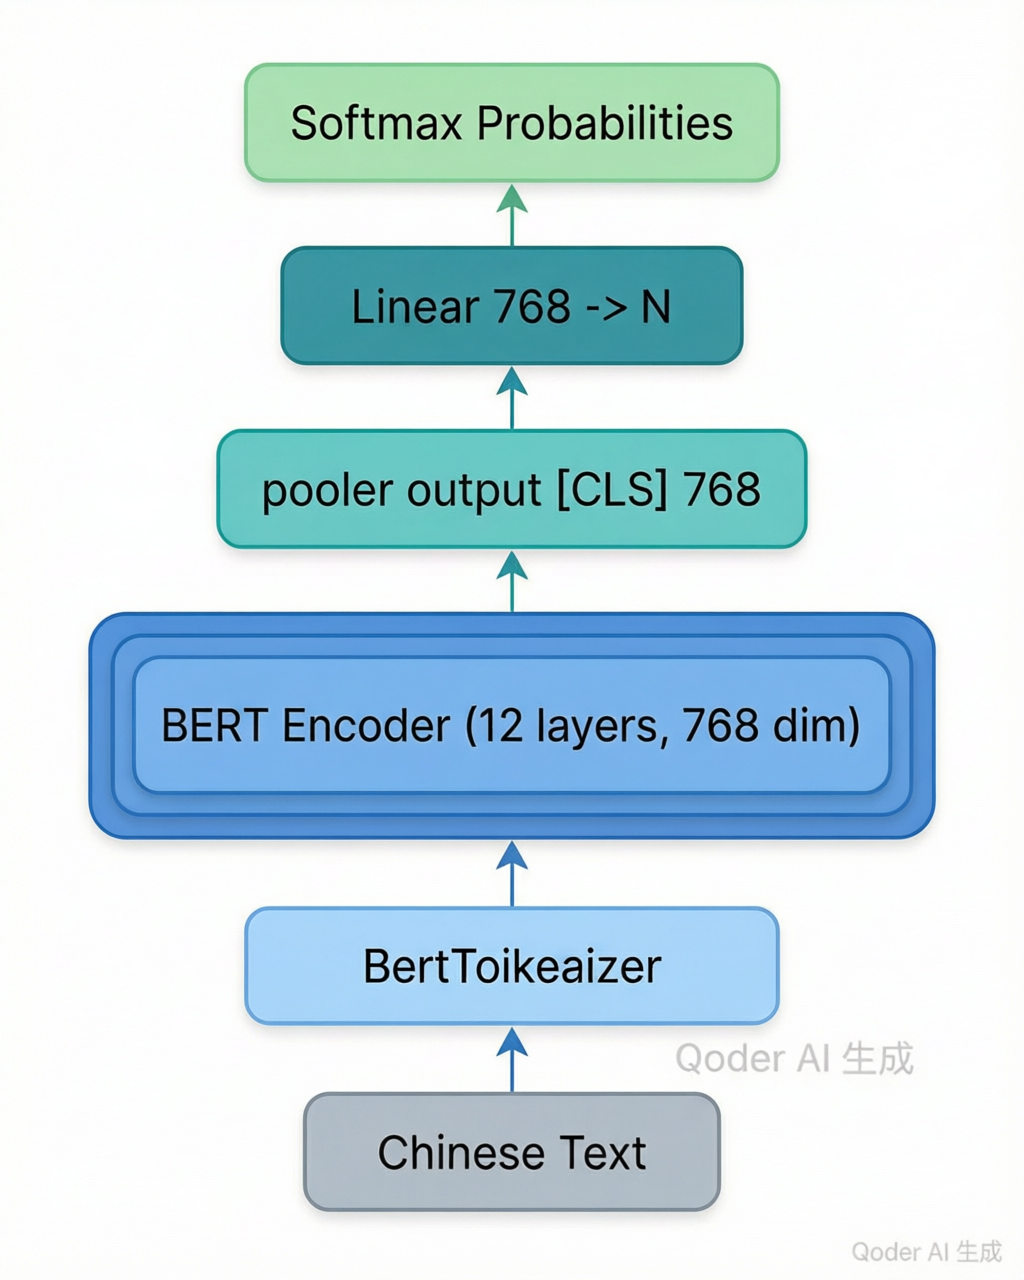
三、模型结构
text
文本
  -> BertTokenizer
  -> input_ids + attention_mask
  -> BERT Encoder
  -> pooler_output (768维)
  -> Linear 分类层
  -> logits
  -> softmax 概率
核心代码可以概括为:
python
class BertClassifier(nn.Module):
    def __init__(self, num_classes):
        super().__init__()
        self.bert = BertModel.from_pretrained(BERT_PATH)
        self.fc = nn.Linear(768, num_classes)

    def forward(self, input_ids, attention_mask):
        output = self.bert(
            input_ids=input_ids,
            attention_mask=attention_mask,
        )
        return self.fc(output.pooler_output)
四、训练过程
训练时,Tokenizer 将中文文本转成 token ID,并通过 attention_mask 区分真实内容和 padding。分类模型输出 logits,使用交叉熵计算损失,再通过 AdamW 更新参数。
投诉分流和虚假评论任务中使用类别权重,缓解类别不均衡。训练过程中按验证集 Macro-F1 保存最佳模型,并在测试集上做最终评估。
五、评估指标
Accuracy 适合看整体正确率,但类别不均衡时可能掩盖少数类表现。因此项目重点观察 Macro-F1:先分别计算每个类别 F1,再进行平均。
现有实验结果显示:投诉分流 BERT Accuracy 约 88.80%、Macro-F1 约 78.51%;虚假评论 BERT Accuracy 约 89.35%、Macro-F1 约 78.59%;广告检测 BERT Accuracy 约 98.35%、F1 约 98.20%。
这些数字依赖具体数据版本和训练参数,复现实验时应以日志为准。
六、为什么每个任务使用独立分类器
三个任务的标签含义不同。投诉分流关注责任部门,虚假评论关注内容真实性,广告检测关注违规风险。如果强行共用一个分类头,标签空间和业务目标会互相干扰。独立模型更容易训练、解释和部署。
后续如果数据规模继续增加,可以研究共享 BERT 编码器、多任务学习和任务专属分类头。
七、工程注意事项
- 训练和推理必须使用同一个 tokenizer;
- 最大序列长度要和任务配置一致;
- 类别顺序必须固定并与
class.txt绑定; - checkpoint 的输出层维度必须匹配任务类别数;
- 推理时使用
model.eval()和torch.no_grad(); - 线上接口需要限制文本长度和批量大小。
八、总结
BERT 微调解决了"让通用中文模型适应电商评论任务"的问题。它提供了较好的语义理解能力,但模型体积和延迟较高,因此后续还需要基线对比、知识蒸馏和量化优化。