告警显示 Lag 上升,值班同学把 Consumer 从 12 个扩到 40 个,吞吐没变,数据库连接却被打满。问题不是 Kafka 不支持水平扩展,而是实例数已经超过可用分区,并把瓶颈推向了下游。
普通 Consumer Group 的有效并行度上限首先受分区数约束;是否更快还取决于单分区处理能力、Key 倾斜、下游容量和再均衡成本。
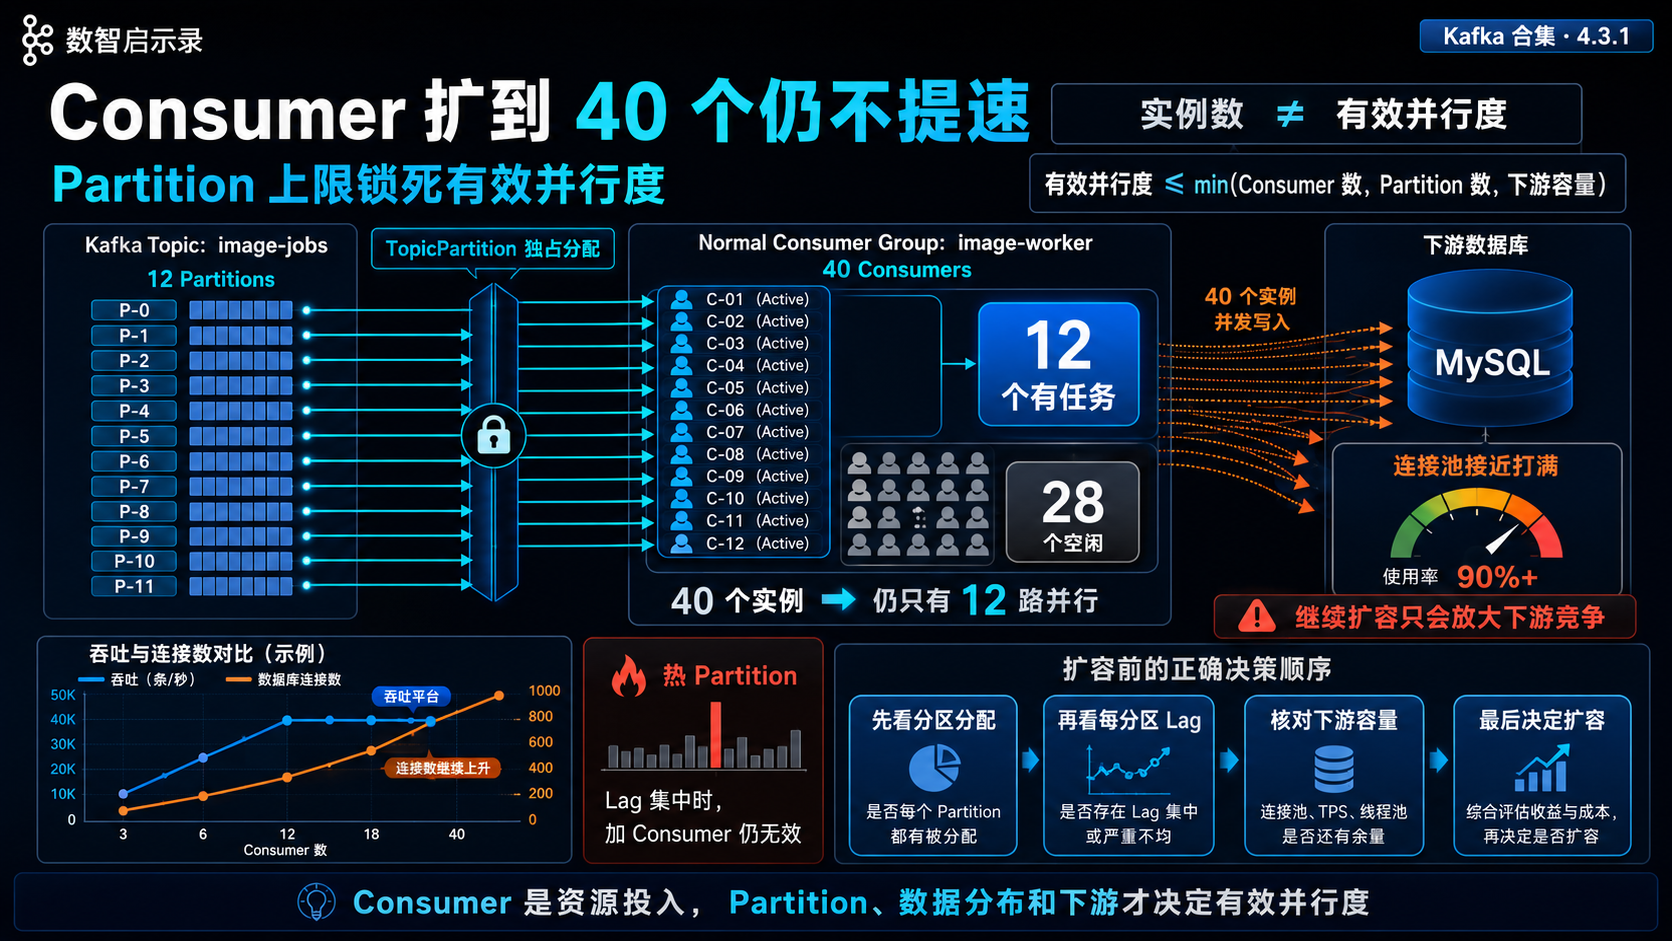
普通 Consumer Group 的硬边界
同一 Consumer Group 内,一个 TopicPartition 在稳定分配时只交给一个成员;成员可以拿多个分区,但一个分区不能同时由多个普通 Consumer 处理。12 个分区配 40 个成员,至少 28 个成员没有该 Topic 的分区任务。
text
effective_parallelism
  <= min(active_consumers, assigned_partitions, downstream_capacity)
只看 Pod 数会高估实际并行度。官方 kafka-consumer-groups.sh --describe --members --verbose 输出会直接显示每个成员的 #PARTITIONS 与分配列表。Basic Operations
四种扩容结果必须公平比较
| 条件 | 加 Consumer 后 | 根因 |
|---|---|---|
| 分区有空余、处理 CPU 饱和 | 吞吐可能提升 | 更多分区并行处理 |
| Consumer 已多于分区 | 基本不变 | 新成员空闲 |
| 单个热分区占大部分流量 | 提升有限 | 热 Key 仍落同一分区 |
| 下游数据库已饱和 | 变慢或失败 | 连接、锁、限流被放大 |
因此必须在相同消息、相同分区、相同下游容量下比较实例数,否则"扩容有效"可能只是输入速率变了。
新 Consumer 协议不会突破分区上限
Kafka 4.3.1 支持 group.protocol=classic 和 consumer,默认仍是 classic。Consumer 协议把心跳与分配控制更多移到 Broker,支持增量协调,能降低再均衡扰动;它没有改变普通 Consumer Group 的 TopicPartition 独占语义。Consumer Configs Group Configs
不要为解决吞吐问题直接切协议。协议迁移还涉及客户端版本、服务端配置、分配策略和回滚验证,应该先证明再均衡就是主瓶颈。
Share Group 能让多个成员共享分区,但语义不同
Kafka 4.3.1 的 Share Consumer API 允许一个 Share Group 的多个成员共享同一分区中的记录,官方命令输出也能看到同一分区分配给多个成员。APIs Basic Operations
这不是普通 Consumer 的透明加速开关:Share Group 有记录获取锁、确认和重投递语义,适合独立任务式处理;如果业务依赖分区顺序、传统 offset 管理或现有客户端生态,迁移前必须重新验证。
Lag 上升时先分辨是哪类瓶颈
1. 只读看分区与成员
bash
bin/kafka-topics.sh --bootstrap-server broker:9092 \
  --describe --topic image-jobs

bin/kafka-consumer-groups.sh --bootstrap-server broker:9092 \
  --describe --group image-worker --members --verbose
正常:多数有流量分区都有活跃成员,实例数没有大量空闲。异常:存在 #PARTITIONS=0,或 Lag 几乎集中在一个分区。
2. 看每分区 Lag,而非只看总 Lag
bash
bin/kafka-consumer-groups.sh --bootstrap-server broker:9092 \
  --describe --group image-worker --offsets
该命令只读。均匀上升通常指向整体处理不足;单分区陡增通常指向热 Key、大消息或该分区对应实例故障。
3. 同时看消费与下游
Consumer 侧看 records-lag-max、fetch rate、处理时延、poll 间隔、失败重试;下游看连接池等待、事务耗时、锁等待、限流和错误率。官方监控建议同时关注最大消息 Lag 与最小 fetch rate。Monitoring
若 Consumer CPU 空闲而数据库等待升高,继续加实例只会放大竞争;若分区都有积压、下游有余量且单实例 CPU 饱和,扩实例才可能有效。
扩容决策顺序
- 先消除同步慢调用、过大批次、无限重试等单实例问题。
- 治理 Key 倾斜,确认是否能拆分热 Key,同时守住顺序要求。
- 在现有分区有空余时扩 Consumer,并观测单分区处理率。
- 只有长期吞吐预测证明分区不足时,才评估扩分区或新 Topic 重分区。
- 任务式、无分区顺序依赖的场景,再评估 Share Group。
扩分区不可回退且会改变 Key 映射。切换 Consumer 协议或 Share Group 也属于语义变更。都需要小流量 canary、明确成功指标(处理率提升且下游无恶化)、停止条件(错误率/重平衡/状态不一致上升)和回滚路径。
容量实验怎么做才可信
固定 Topic 分区数、消息大小与下游限额,依次运行 3、6、12、18 个 Consumer;每档等待分配稳定后记录分区吞吐、p95 处理时延、总 Lag 斜率、空闲成员数和下游饱和度。
若 12 个分区在 12 个 Consumer 后平台化,结论是分区或下游限制,而不是"还没加够机器"。若 6 个实例已打满数据库,容量上限在下游,Kafka 扩容不是修复。
源码与 Java:用 AdminClient 看清空闲成员和分区上限
客户端的 KafkaConsumer.subscribe 进入 classic 或 async delegate;服务端分配由 GroupMetadataManager 管理。普通 Group 的 assignment 仍以 TopicPartition 为独占单位。
以下示例按 Kafka 4.3.1 Admin API 静态审阅,未在本环境连接真实 Consumer Group 运行。
java
import java.util.*;
import org.apache.kafka.clients.admin.*;

public class ConsumerCapacityProbe {
  public static void main(String[] args) throws Exception {
    Properties p = new Properties(); p.put(AdminClientConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
    try (Admin admin = Admin.create(p)) {
      int partitions = admin.describeTopics(List.of("image-jobs")).allTopicNames().get()
          .get("image-jobs").partitions().size();
      ConsumerGroupDescription g = admin.describeConsumerGroups(List.of("image-worker"))
          .all().get().get("image-worker");
      long assignedMembers = g.members().stream().filter(m -> m.assignment().topicPartitions().stream()
          .anyMatch(tp -> tp.topic().equals("image-jobs"))).count();
      long assignedPartitions = g.members().stream().flatMap(m -> m.assignment().topicPartitions().stream())
          .filter(tp -> tp.topic().equals("image-jobs")).distinct().count();
      System.out.printf("partitions=%d members=%d assignedMembers=%d assignedPartitions=%d%n",
          partitions, g.members().size(), assignedMembers, assignedPartitions);
    }
  }
}
输出若为 partitions=12 members=24 assignedMembers=12 assignedPartitions=12,继续加普通 Consumer 不会增加该 Topic 的分区并行度。这里特意按 image-jobs 过滤分配,避免 Group 同时订阅多个 Topic 时把其他分区误算进来。映射为 group.id → GroupMetadataManager assignment → member assignment。它不测下游容量,吞吐决策仍要结合数据库和每分区处理率。
结论
Consumer 数量只是资源投入,分区、数据分布和下游容量才决定有效并行度。先用分区级证据定位瓶颈,再选择优化处理、治理热 Key、扩实例、扩分区或 Share Group,才能把扩容变成可验证的工程决策。