PyTorch强化学习实战------融合人类示范数据的高效强化学习
-
- [0. 前言](#0. 前言)
- [1. 人类示范数据](#1. 人类示范数据)
- [2. 录制示范数据](#2. 录制示范数据)
- [3. 使用示范数据进行训练](#3. 使用示范数据进行训练)
- [4. 结果](#4. 结果)
- 相关链接
0. 前言
我们已经学习了强化学习在网页导航与浏览器自动化中的应用,介绍了 MiniWoB++ 基准测试,该环境提供像素观测、文本描述和 DOM 元素等多模态输入,动作空间涵盖鼠标键盘操作。并且实现了基于异步优势演员-评论家 (Asynchronous Advantage Actor-Critic, A3C) 算法的按钮点击智能体,将动作空间简化为网格化点击,通过卷积网络处理图像观测。实验结果表明该智能体能解决简单任务(如点击对话框),但在处理多步骤、依赖文本描述或违反马尔可夫性质的任务时效果不佳。
为改进训练过程,我们尝试引入人类示范数据。其核心思想很简单:通过展示我们认为解决问题所需的操作示例,帮助智能体发现最佳任务解决方式。这些示例未必是最优解或完全准确,但应足够为智能体指明有前景的探索方向。
1. 人类示范数据
人类示范数据其实是非常自然的学习方式------所有人类学习都基于教师、父母或他人提供的先验示例。这些示例可能以书面形式存在(如食谱),或需要通过多次重复示范才能掌握(如舞蹈课程)。此类训练形式比随机搜索高效得多:试想仅通过试错学习刷牙需要多么复杂漫长的过程。当然,模仿学习可能存在风险------示范可能错误或非最优解,但总体而言仍比随机搜索有效得多。
我们之前的所有强化学习都遵循了以下工作流程:
- 零先验知识起步,随机初始化权重导致训练初期执行随机动作
- 经过多次迭代,智能体发现某些状态下的特定动作能带来更佳结果(通过Q值或更高优势值的策略),开始优先选择这些动作
- 最终该过程形成近似最优策略,使智能体获得高额奖励
当动作空间维度较低且环境行为不太复杂时,这种方法效果良好。但仅仅将动作数量翻倍就至少需要两倍的观测数据。以我们的点击智能体为例,其 256 个不同动作对应活动区域中的 10×10 网格,比 CartPole 环境的动作数量多出 128 倍,因此训练过程漫长且可能无法收敛也就不足为奇了。
维度问题可通过多种方式解决:更智能的探索方法、更高采样效率的训练(一次性学习)、融入先验知识(迁移学习)等。目前大量研究致力于提升RL的效能与速度,本节我们将尝试更传统的方法------将人类记录的示范数据融入训练过程。
我们已经学习了同策略与异策略方法。这与人类示范数据高度相关:严格来说,我们不能将异策略数据(人类观测-动作对)用于同策略方法(本节中的异步优势演员-评论家 (Asynchronous Advantage Actor-Critic, A3C))。这是因为同策略方法的本质------它们使用当前策略收集的样本估计策略梯度。若直接将人类记录样本注入训练过程,估计的梯度将适用于人类策略而非神经网络给出的当前策略。
为了解决这个问题,我们需要稍微"作弊"一下,从监督学习的角度看待我们的任务。具体来说,我们将使用对数似然目标来推动我们的神经网络根据示范采取行动。
为解决此问题,我们需要转换视角:从监督学习角度审视问题。具体而言,将使用对数似然目标函数推动神经网络根据示范数据采取动作。但这并非用监督学习取代强化学习 (Reinforcement Learning, RL),而是复用监督学习技术辅助 RL 方法。本质上,类似做法我们早已实践过:Q学习中价值函数的训练就是纯粹的监督学习。
再开始训练之前,需先解决一个重要问题:如何以最便捷的形式获取示范数据。
2. 录制示范数据
在 MiniWoB++ 过渡到 Selenium 之前,录制示范在技术上颇具挑战。特别是需要捕获并解码虚拟网络计算 (Virtual Network Computing, VNC)协议,才能提取浏览器屏幕截图和用户执行的操作。
但现在,VNC 协议已被弃用,浏览器改为在本地进程启动,因此我们几乎可以直接与之通信。
Farama MiniWoB++ 附带了一个可将示范录制为 JSON 文件的 Python 脚本,可通过 python -m miniwob.scripts.record 命令启动。
但该脚本存在局限:其观测仅捕获网页 DOM 结构,不包含像素级信息。由于本节示例依赖像素数据,此脚本录制的示范无法使用。为此实现自定义录制工具 record_demo.py,可捕获浏览器像素信息,启动方式如下:
shell
$ python record_demo.py -o demos/test -g tic-tac-toe-v1 -d 1此命令以 render_mode='human' 模式启动环境,显示浏览器窗口并允许与页面交互。后台程序会持续记录观测数据(含屏幕截图),当回合结束时将截图与操作动作关联存储,所有数据均保存到 -o 命令行参数指定的 JSON 文件中。通过 -g 参数可切换环境,-d 参数设置回合间隔秒数(若未指定 -d 参数,则需在控制台按 Enter 键开始新回合)。下图展示了示范录制过程:
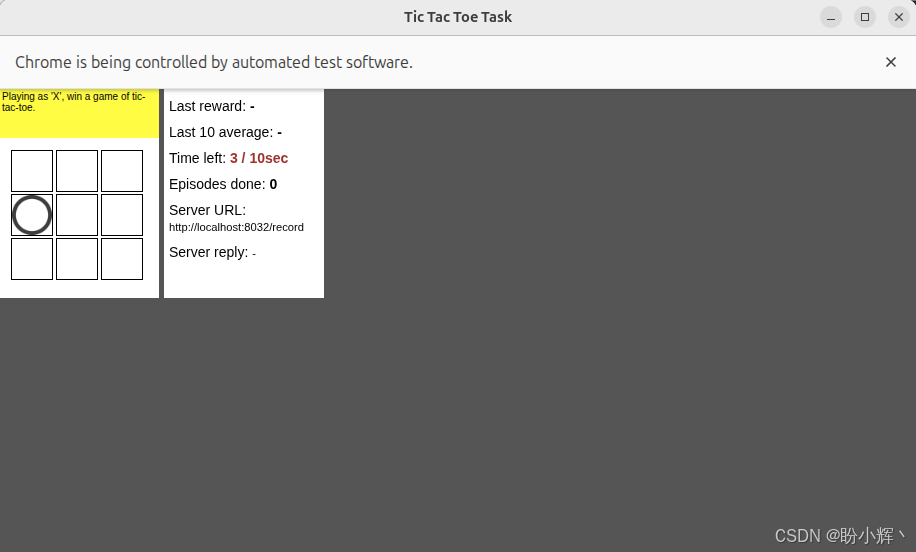
在 demos 目录中,提供了用于实验的示范数据,但我们当然也可以使用提供的脚本记录自己的示范数据。
3. 使用示范数据进行训练
掌握示范数据录制方法后,只剩最后一个问题:如何修改训练过程以融入人类示范数据。最简单的解决方案是复用训练交叉熵方法时使用的对数似然目标函数。
具体而言,我们需要将 A3C 模型视为分类问题:其策略头对输入观测进行分类。最简单形式是保持价值头不变(但实际上训练它并不困难):由于已知示范过程中获得的奖励,只需计算从每个观测到回合结束的折扣奖励即可。
(1) 查看wob_click_train.py中的相关代码实现:首先通过命令行 demo <DIR> 选项传递示范数据目录,这将启用以下代码块中的分支------从指定目录加载示范样本。demos.load_demo_dir() 函数自动从给定目录的 JSON 文件加载示范数据,并将其转换为 ExperienceFirstLast 实例:
python
    demo_samples = None
    if args.demo:
        demo_samples = demos.load_demo_dir(
            args.demo, gamma=GAMMA, steps=REWARD_STEPS,
            keep_text=True)
        print(f"Loaded {len(demo_samples)} demo samples")
(2) 与示范训练相关的第二段代码位于训练循环中,并在任何正常批次之前执行。示范训练以一定的概率进行(默认为 0.5),由 DEMO_PROB 超参数指定:
python
                if demo_samples and step_idx < DEMO_FRAMES :
                    if random.random() < DEMO_PROB:
                        random.shuffle(demo_samples)
                        demo_batch = demo_samples[:BATCH_SIZE]
                        model.train_demo(
                            net, optimizer, demo_batch, writer, step_idx, device=device,
                            preprocessor=preprocessor
                        )
其逻辑简单明了:以 DEMO_PROB 概率从示范数据中采样 BATCH_SIZE 个样本,并在该批次数据上执行一轮网络训练。
(3) 实际训练由 model.train_demo() 函数实现,流程非常简洁直接:
python
def train_demo(net: Model, optimizer: torch.optim.Optimizer,
               batch: tt.List[lib.experience.ExperienceFirstLast], writer, step_idx: int,
               preprocessor=lib.agent.default_states_preprocessor,
               device: torch.device = torch.device("cpu")):
    """
    Train net on demonstration batch
    """
    batch_obs, batch_act = [], []
    for e in batch:
        batch_obs.append(e.state)
        batch_act.append(e.action)
    batch_v = preprocessor(batch_obs)
    if torch.is_tensor(batch_v):
        batch_v = batch_v.to(device)
    optimizer.zero_grad()
    ref_actions_v = torch.LongTensor(batch_act).to(device)
    policy_v = net(batch_v)[0]
    loss_v = F.cross_entropy(policy_v, ref_actions_v)
    loss_v.backward()
    optimizer.step()
    writer.add_scalar("demo_loss", loss_v.item(), step_idx)
我们将批次数据拆分为观测值和动作列表,对观测值进行预处理以转换为 PyTorch 张量并送入 GPU。随后要求 A3C 网络返回策略值,并计算结果与目标动作之间的交叉熵损失。从优化视角看,这是在推动网络趋向示范数据中的动作选择。
4. 结果
为验证示范数据的效果,在 count-sides 问题上使用相同超参数进行了两组训练:一组未使用示范数据,另一组使用 demos/count-sides 目录中的 25 个示范回合。
结果差异显著:从零开始的训练在 12 小时 400 万帧后达到最佳平均奖励 -0.4,且训练动态未见明显改善;而使用示范数据的训练仅用 3 万训练帧就达到 0.5 的平均奖励。下图展示了奖励与步数变化。
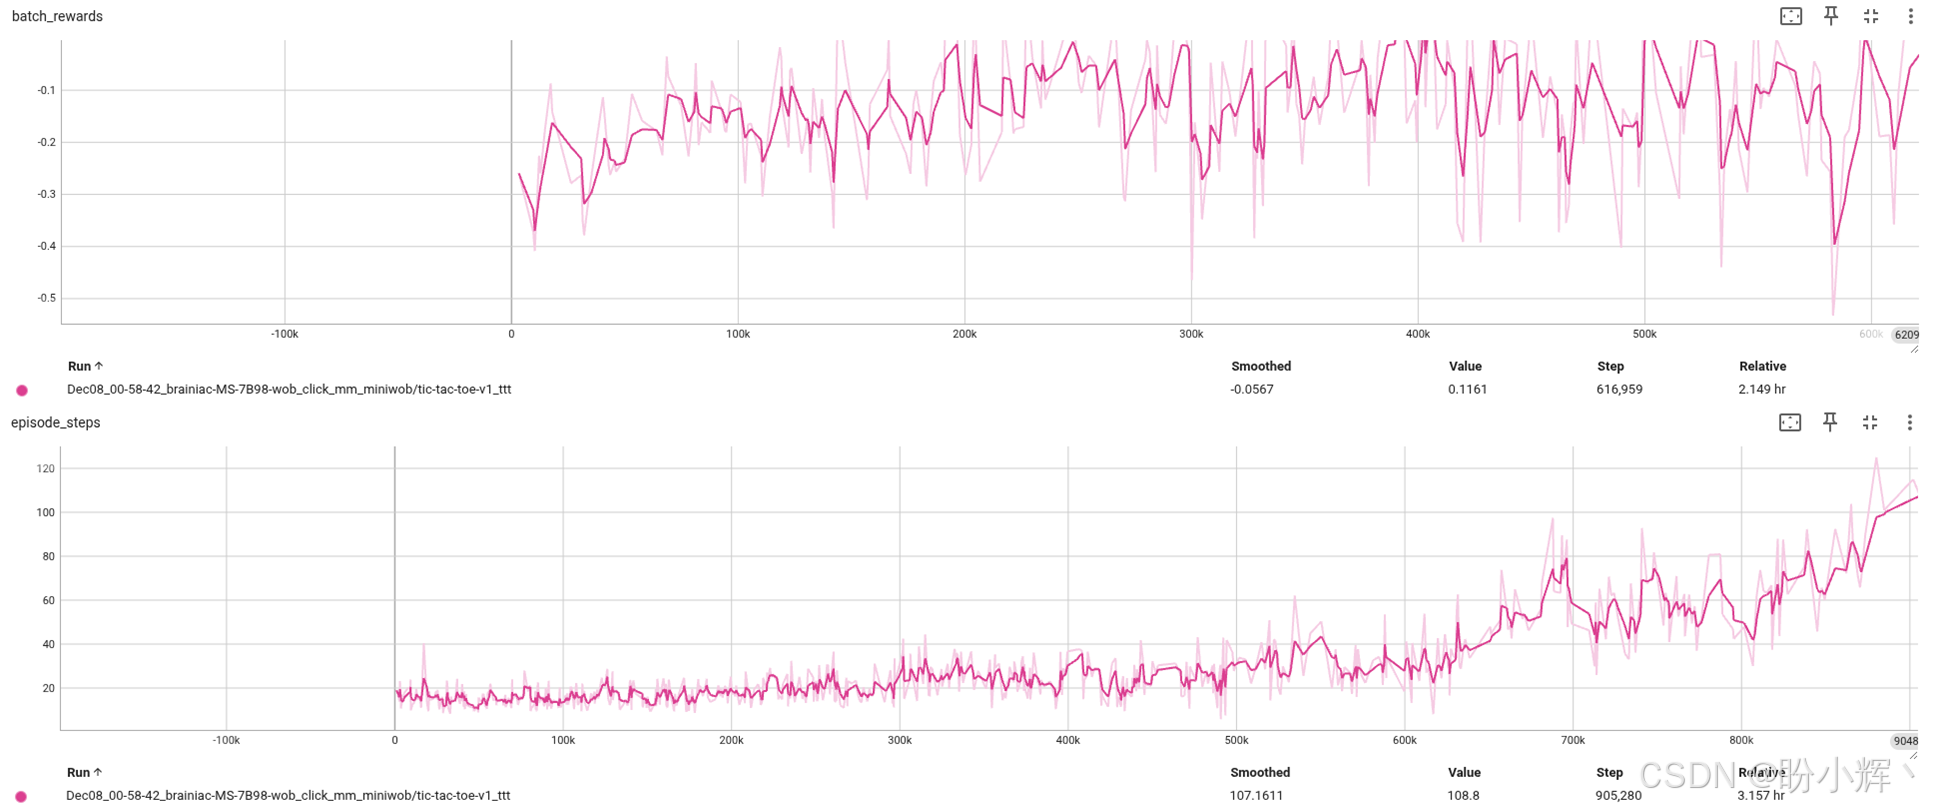
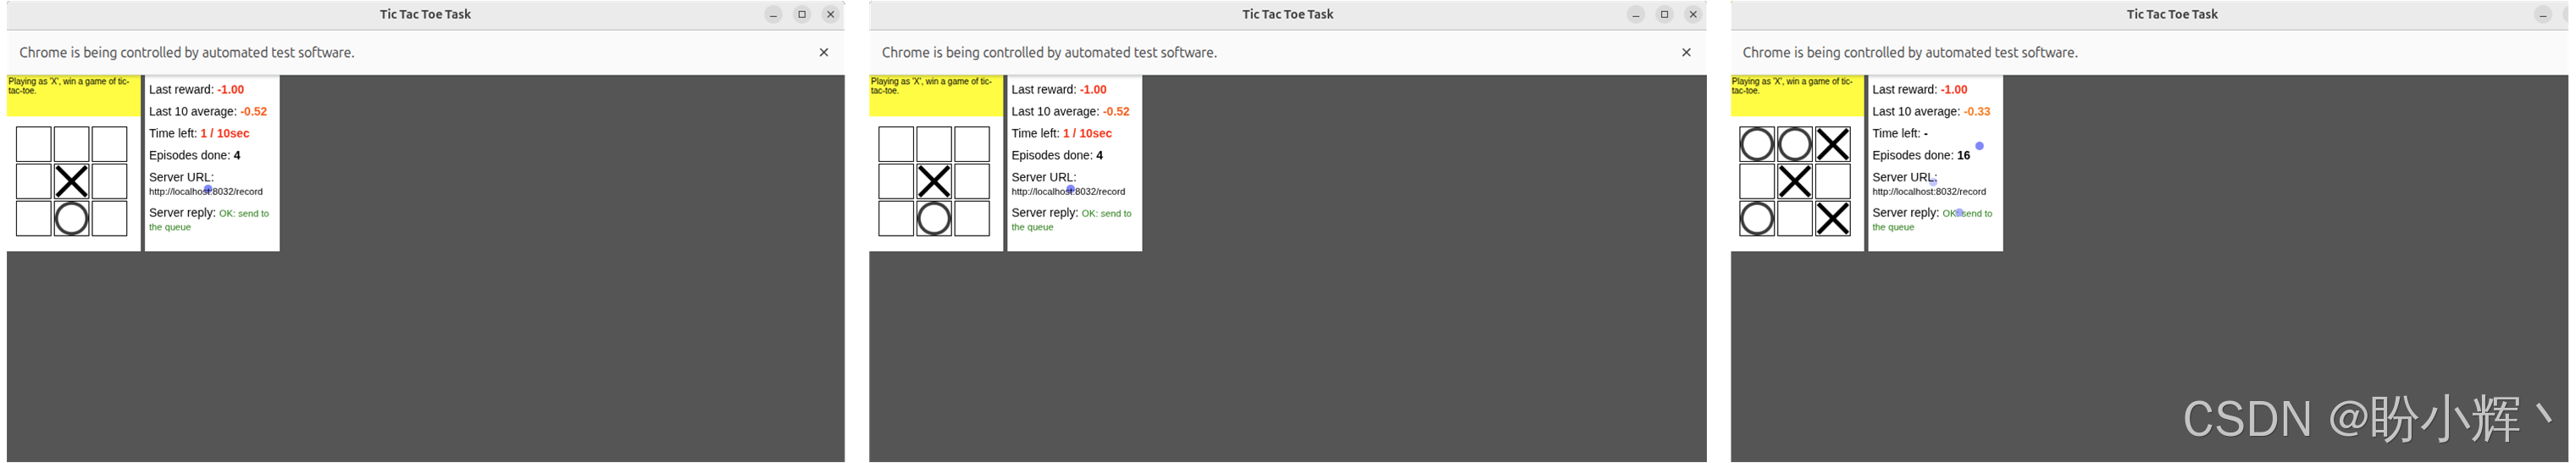
更具挑战性的问题是井字棋游戏( tic-tac-toe 环境)下图展示了录制的示范游戏过程(存于 demos/tic-tac-toe 目录),圆点表示点击位置:
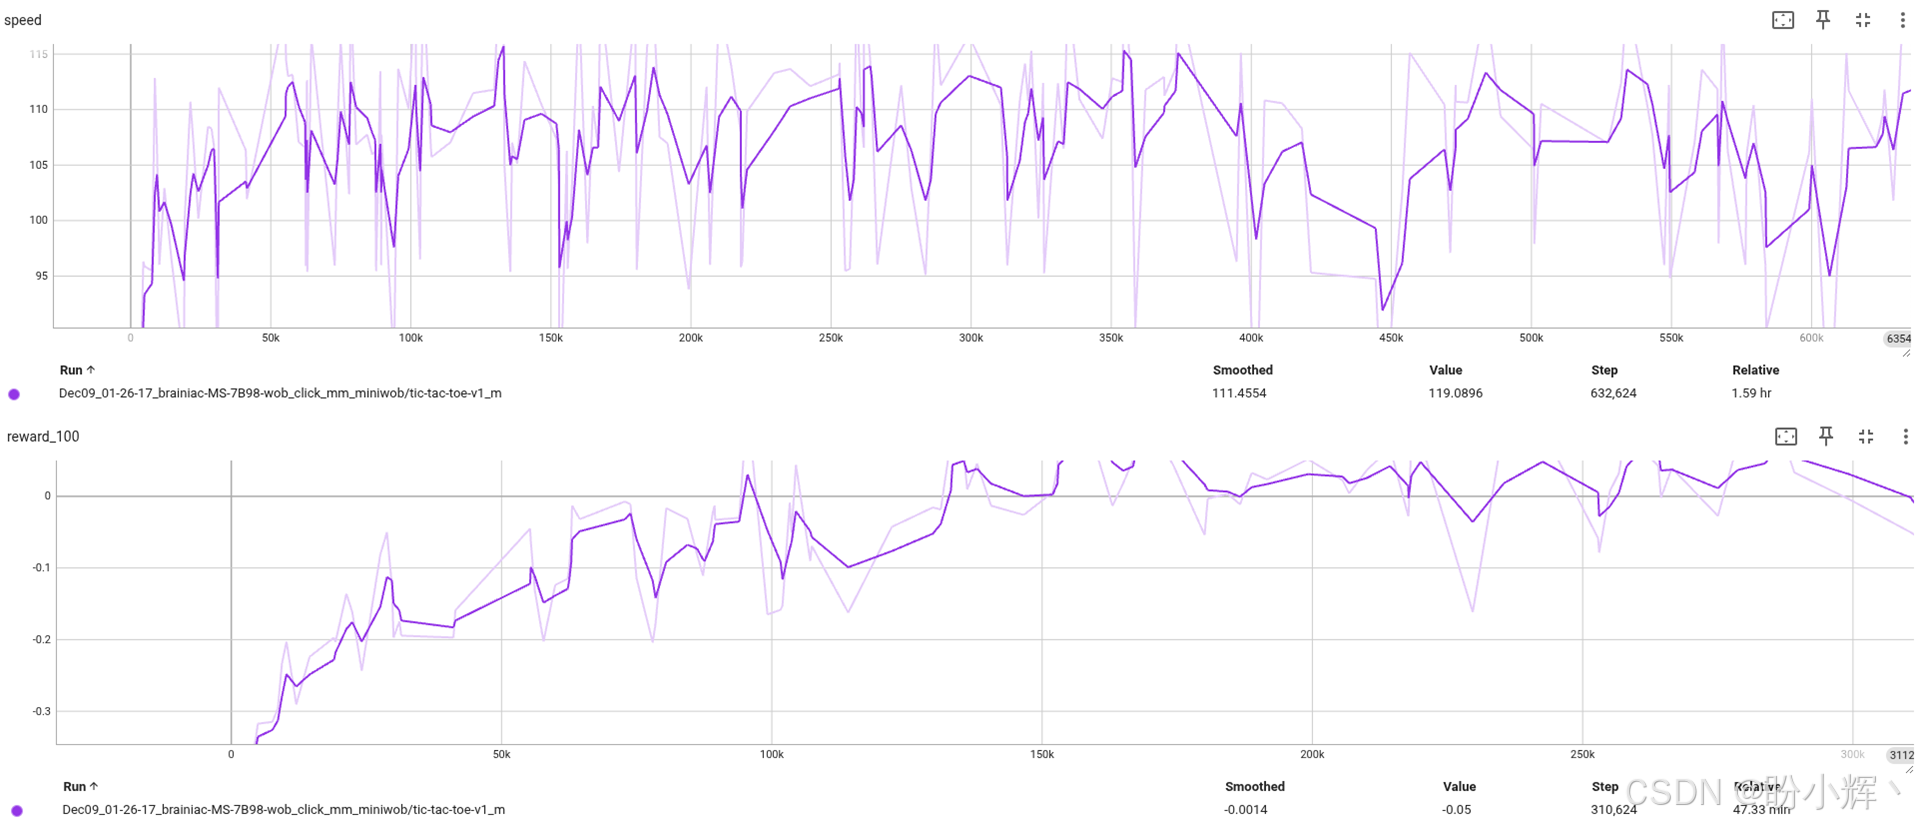
经过两小时训练,达到的最佳平均奖励为 0.05,这意味着智能体能赢得部分对局,但也会输掉或平局。下图展示了奖励动态和回合步数的变化曲线。
相关链接
PyTorch强化学习实战(1)------强化学习(Reinforcement Learning,RL)详解
PyTorch强化学习实战(2)------强化学习环境库Gymnasium
PyTorch强化学习实战(3)------Gymnasium API扩展功能
PyTorch强化学习实战(4)------PyTorch基础
PyTorch强化学习实战(5)------PyTorch Ignite 事件驱动机制与实践
PyTorch强化学习实战(6)------交叉熵方法详解与实现
PyTorch强化学习实战(7)------表格学习与贝尔曼方程
PyTorch强化学习实战(8)------Q学习详解与实现
PyTorch强化学习实战(10)------强化学习高级组件
PyTorch强化学习实战(11)------N步DQN(N-step DQN)
PyTorch强化学习实战(12)------Double DQN(DDQN)
PyTorch强化学习实战(13)------噪声网络(NoisyNet-DQN)
PyTorch强化学习实战(14)------优先经验回放机制
PyTorch强化学习实战(15)------Dueling DQN
PyTorch强化学习实战(16)------Categorical DQN
PyTorch强化学习实战(17)------强化学习训练加速
PyTorch强化学习实战(18)------基于DQN处理股票交易问题
PyTorch强化学习实战(20)------优势演员-评论家(Advantage Actor-Critic, A2C)
PyTorch强化学习实战(21)------异步优势演员-评论家(Asynchronous Advantage Actor-Critic, A3C)