目录
- 一、前言:为什么我们必须自己推导算力?
- 二、算力计算核心前提:分清GPU两套独立计算硬件
-
- [2.1 CUDA Core(通用标量单元)](#2.1 CUDA Core(通用标量单元))
- [2.2 Tensor Core(专用AI矩阵单元)](#2.2 Tensor Core(专用AI矩阵单元))
- 三、核心基石:FMA融合乘加指令与双统计口径
-
- [3.1 FMA硬件物理定义](#3.1 FMA硬件物理定义)
- [3.2 两套对立的TOPS统计口径(重点)](#3.2 两套对立的TOPS统计口径(重点))
- [四、Ampere架构Tensor Core硬件固有参数](#四、Ampere架构Tensor Core硬件固有参数)
-
- [4.1 硬件计算粒度:脉动阵列](#4.1 硬件计算粒度:脉动阵列)
- 五、AI芯片TOPS通用计算公式
-
- [5.1 2:4结构化稀疏翻倍原理(纯硬件逻辑)](#5.1 2:4结构化稀疏翻倍原理(纯硬件逻辑))
- [六、实战理论推导:Jetson Orin Nano Super算力验证](#六、实战理论推导:Jetson Orin Nano Super算力验证)
-
- [6.1 稠密算力推导(官方33 TOPS)](#6.1 稠密算力推导(官方33 TOPS))
- [6.2 稀疏算力推导(官方67 TOPS)](#6.2 稀疏算力推导(官方67 TOPS))
- 七、工程与理论总结
- 八、结语
💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫
一、前言:为什么我们必须自己推导算力?
在嵌入式AI开发、边缘部署、硬件学习中,我们总能看到厂商给出固定的AI算力参数。以Jetson Orin Nano Super为例,商家统一标注:稠密33 TOPS、稀疏67 TOPS 。
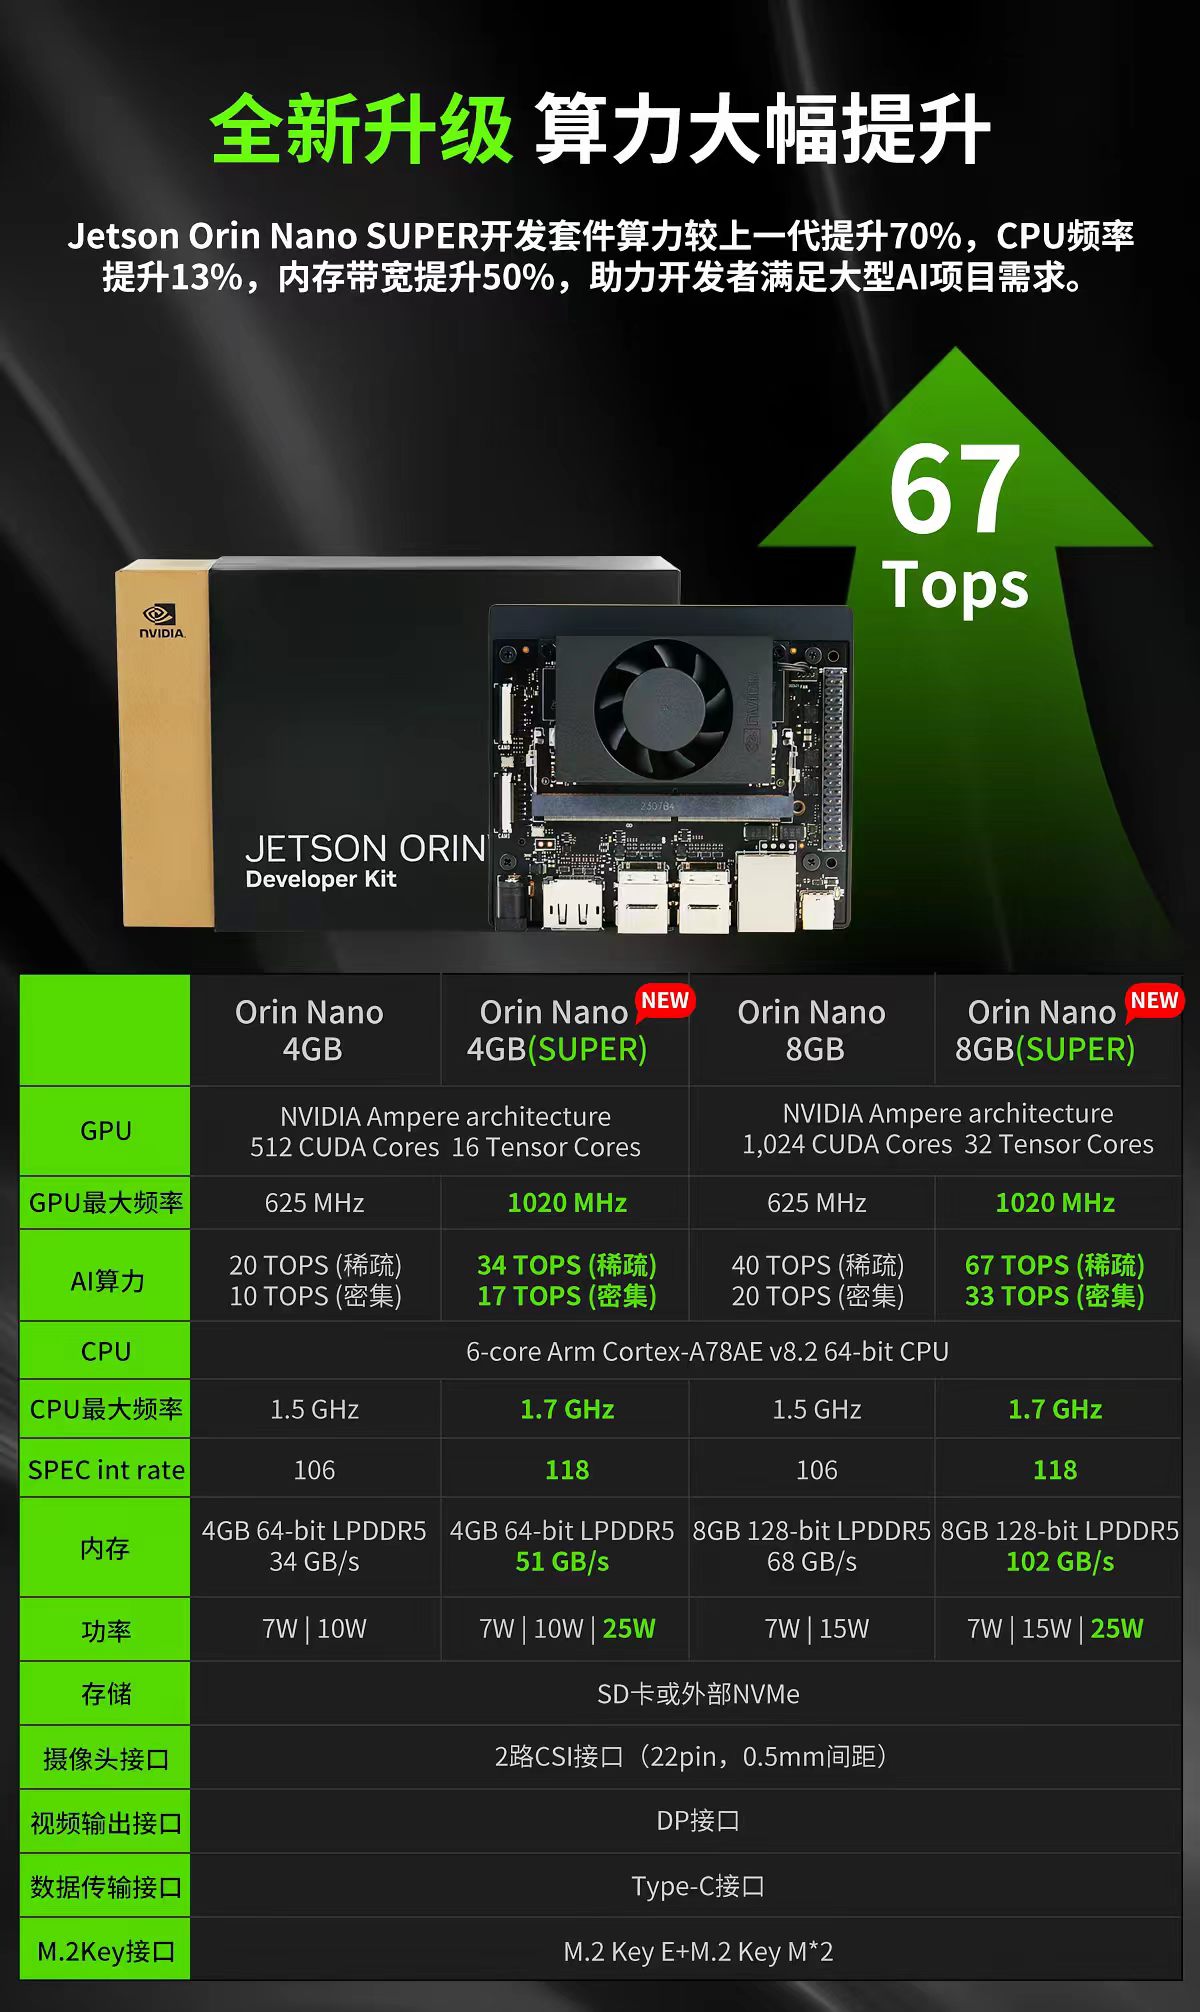
绝大多数开发者、学生都会默认照搬参数,认为硬件算力是厂商定义的固定值。但做技术研究,最核心的素养就是质疑参数、理论自证。
这个数值到底是虚标还是真实硬件上限?稠密算力、稀疏算力的翻倍逻辑从何而来?
本文彻底剥离浮点算力、只聚焦INT8整型推理算力(TOPS) ,基于Ampere架构官方白皮书,总结一套通用、可复用、百分百准确的AI硬件TOPS理论计算方法,彻底解决边缘GPU算力计算的所有误区。
本文部门内容参考了英伟达的安培架构白皮书,感兴趣的话请移步:nvidia-ampere-architecture-whitepaper.pdf
💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫
二、算力计算核心前提:分清GPU两套独立计算硬件
NVIDIA GPU包含两套完全独立、互不干扰的计算单元,算力统计完全分开,AI推理算力只看Tensor Core。
2.1 CUDA Core(通用标量单元)
负责网络中的逐元素运算:激活函数、归一化、偏置相加、数据预处理。不支持矩阵加速、不支持稀疏加速,不参与官方AI TOPS算力统计。
2.2 Tensor Core(专用AI矩阵单元)
专门负责卷积、矩阵乘、GEMM等深度学习核心计算,是唯一的AI算力来源 。我们看到的稠密TOPS、稀疏TOPS,全部基于Tensor Core的INT8整型矩阵乘指令(IMMA)计算得出。
💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫
三、核心基石:FMA融合乘加指令与双统计口径
所有INT8算力混乱的根源,不是硬件差异,而是行业两套完全不同的统计计数规则。这是全网讲解最少、踩坑最多的核心知识点。
3.1 FMA硬件物理定义
Tensor Core的最小计算单元为FMA(融合乘加),硬件单时钟周期内,一条指令同时完成1次乘法、1次加法,硬件并行执行,不占用额外周期。
公式: D = A × B + C D = A \times B + C D=A×B+C
3.2 两套对立的TOPS统计口径(重点)
口径一:学术/教学口径(1 FMA = 2次运算)
从纯数学运算角度,乘法、加法是两次独立运算,统计算力时需要×2。该口径常用于高校课件、理论教学、学术论文。
口径二:NVIDIA工业官方口径(1 FMA = 1次运算)
从硬件指令吞吐角度,单周期仅发射一条FMA指令,官方统计TOPS时,直接统计指令数量,不再乘以2。所有Jetson设备的官方参数、商家参数全部遵循此规则。
总结:硬件行为完全一致,仅仅是"计数方式不同",这就是算力差一倍的唯一原因。
💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫
四、Ampere架构Tensor Core硬件固有参数
基于Ampere官方白皮书,固定硬件参数(Orin全系通用,不可更改):
单个Tensor Core单时钟周期可执行:256条 FP16 FMA
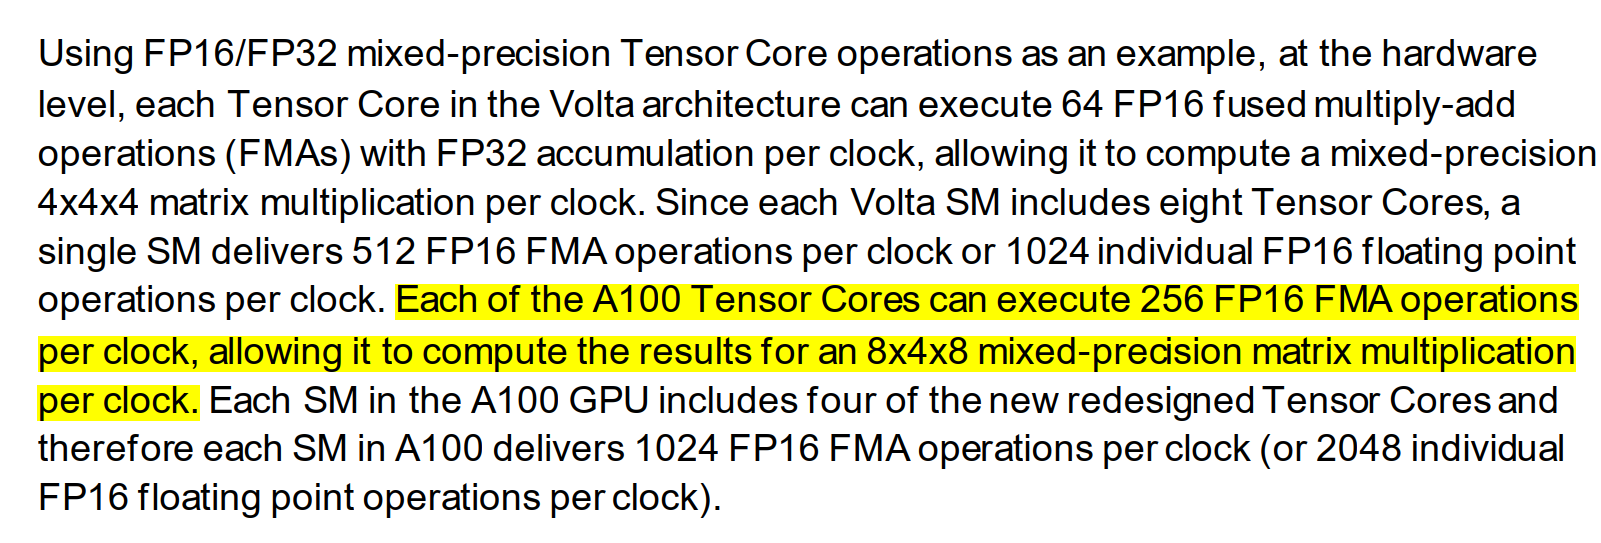
想关注更多英伟达产品的硬件架构信息,请参考:万字长文:英伟达 GPU 硬件架构发展史全景回顾
4.1 硬件计算粒度:脉动阵列
当执行FP16运算的时候,Ampere Tensor Core固定矩阵计算Tile: 8 × 4 × 8 = 256 8 \times 4 \times 8=256 8×4×8=256。
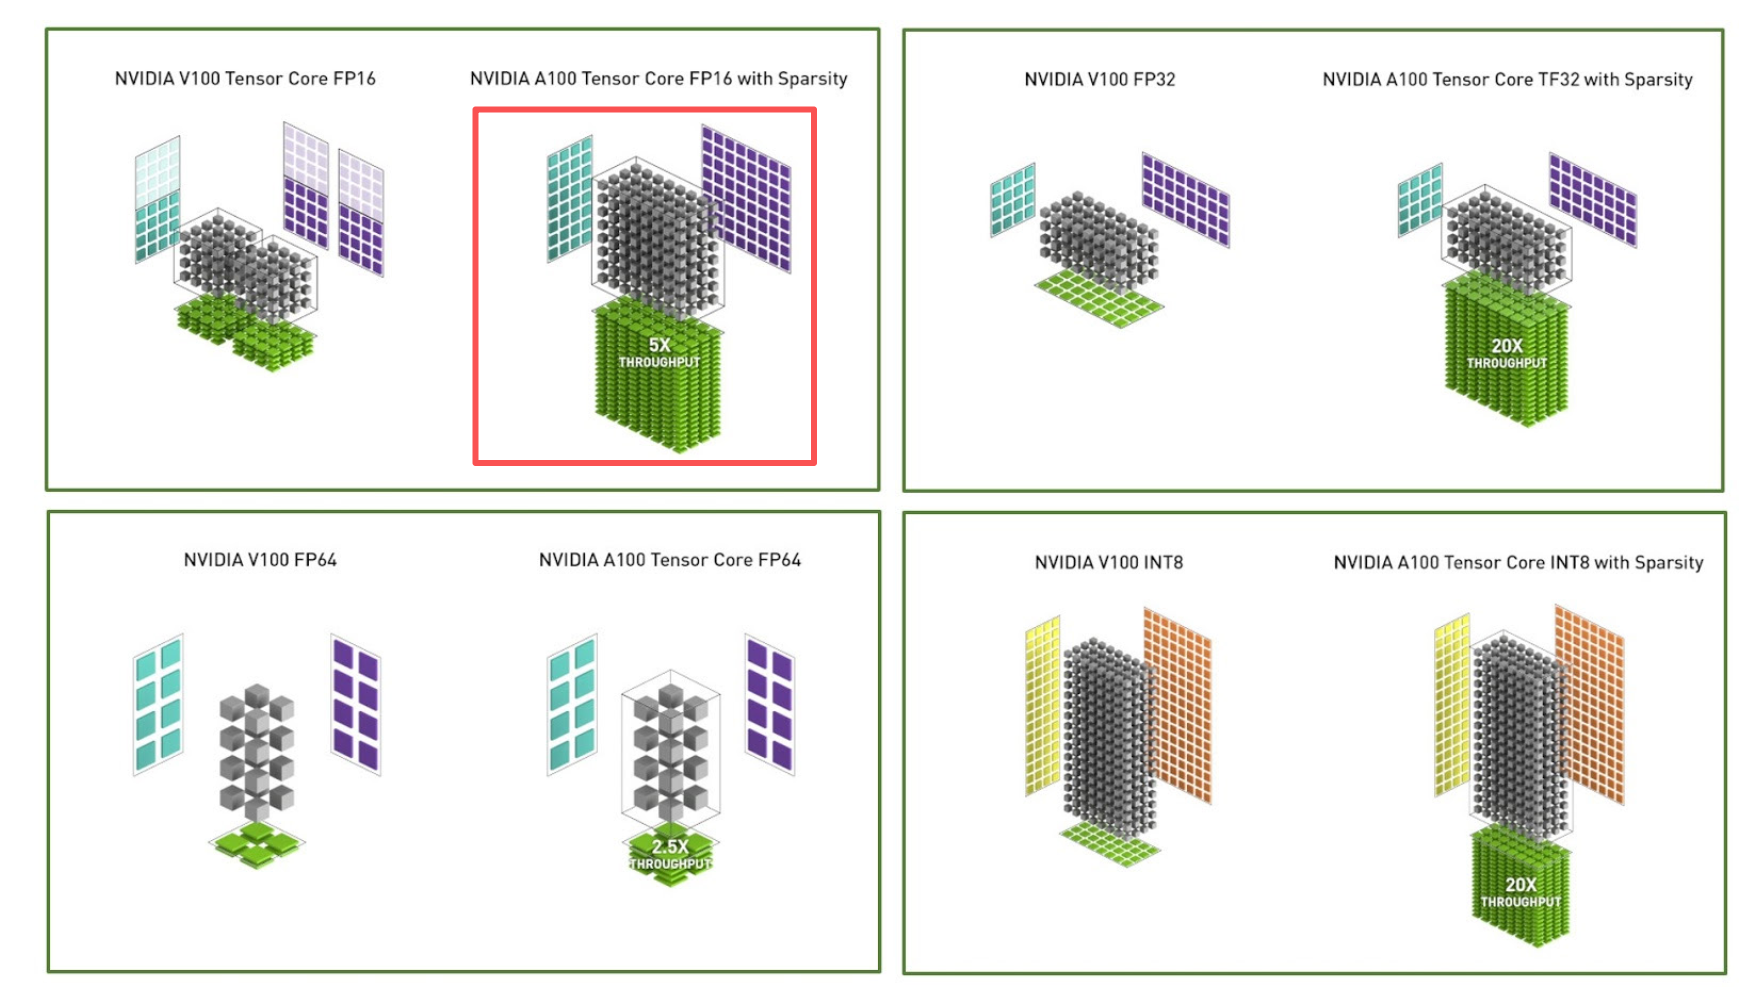
而当执行int8的计算时,运算效率会翻倍:Ampere Tensor Core固定矩阵计算Tile: 16 × 4 × 8 = 512 16 \times 4 \times 8=512 16×4×8=512。
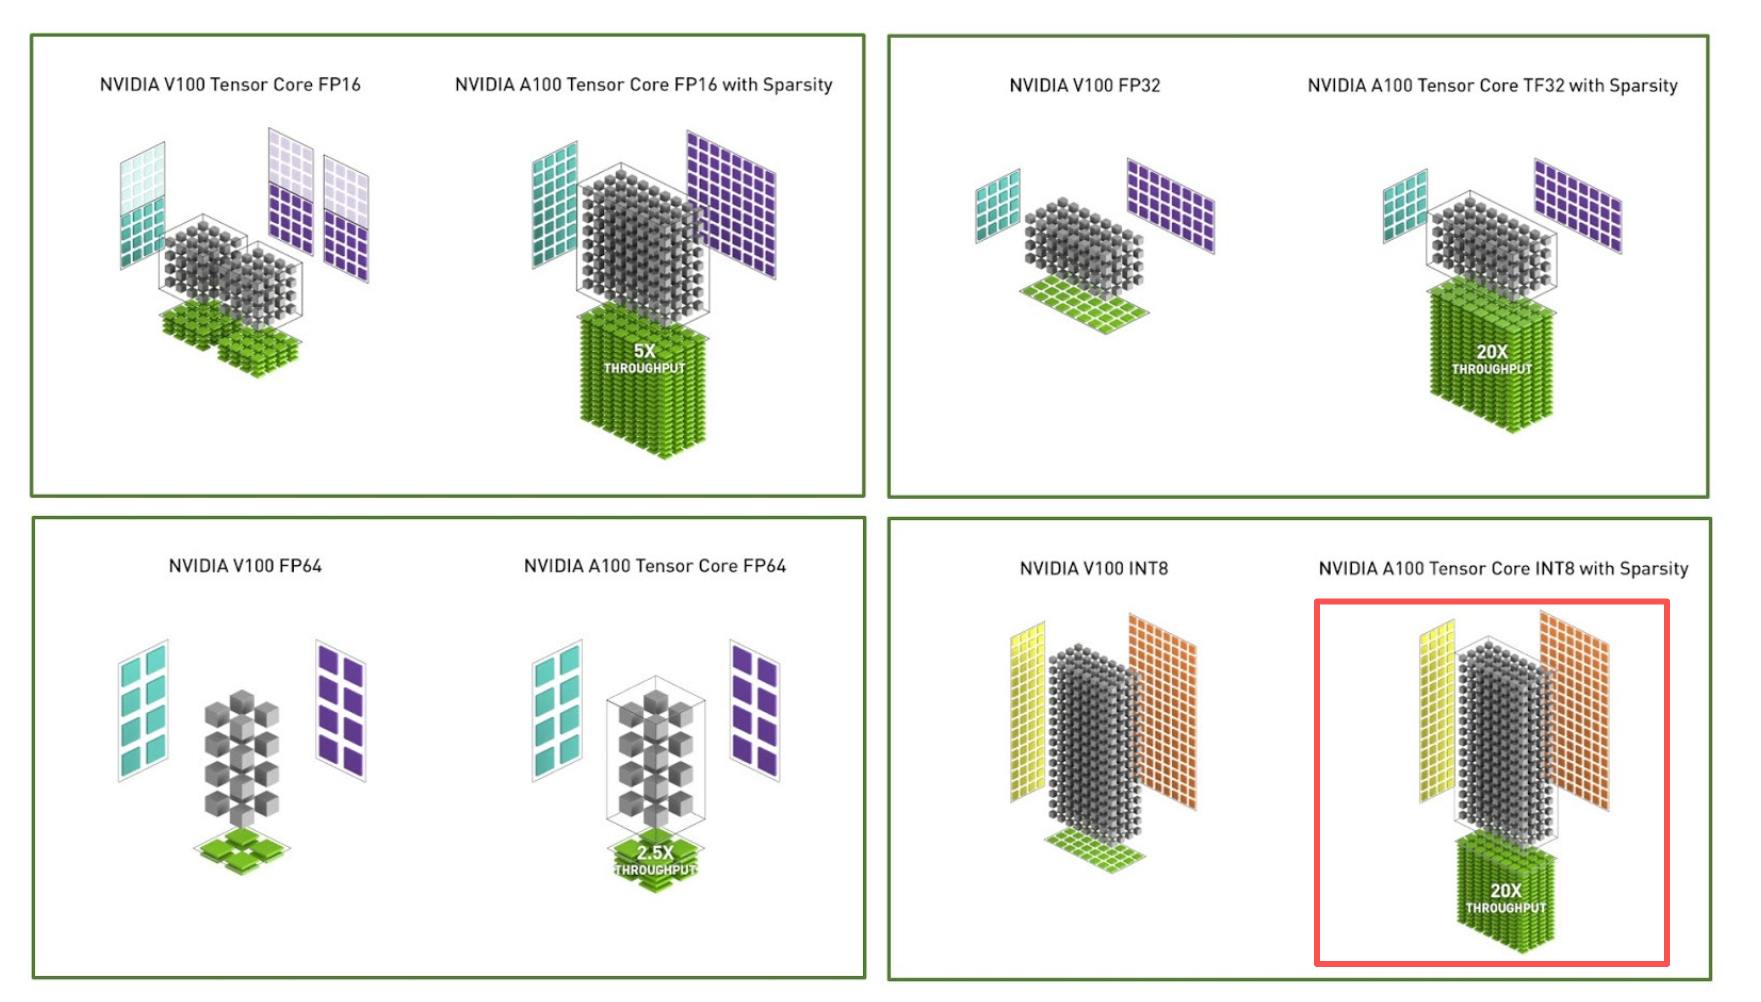
浮点数的存储方式属于非常基础的内容,感兴趣的话,可以参考:嵌入式视角下的浮点运算性能之迷
硬件采用流水线脉动阵列结构,存在填充、稳态、排空三个阶段。
注意:所有官方理论峰值算力,仅统计满负载稳态流水的吞吐能力,忽略流水线首尾延迟 ,这是行业统一标准,也是理论算力常常高于实际推理算力的核心原因。
💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫💫
五、AI芯片TOPS通用计算公式
适用于所有Ampere架构边缘GPU,纯INT8整型算力:
稠密算力 = 张量核总数 × 单周期执行的FMA数 × 2 × GPU主频 ÷ 10¹²
稀疏算力 = 稠密TOPS × 2
其中,一个FMA同时执行了一次乘法计算和一次加法计算,所以需要 × 2。
5.1 2:4结构化稀疏翻倍原理(纯硬件逻辑)
Ampere架构独有2:4结构化稀疏特性:权重维度每4个连续参数,固定保留2个非零值、置零2个参数,搭配专用元数据(Metadata)。
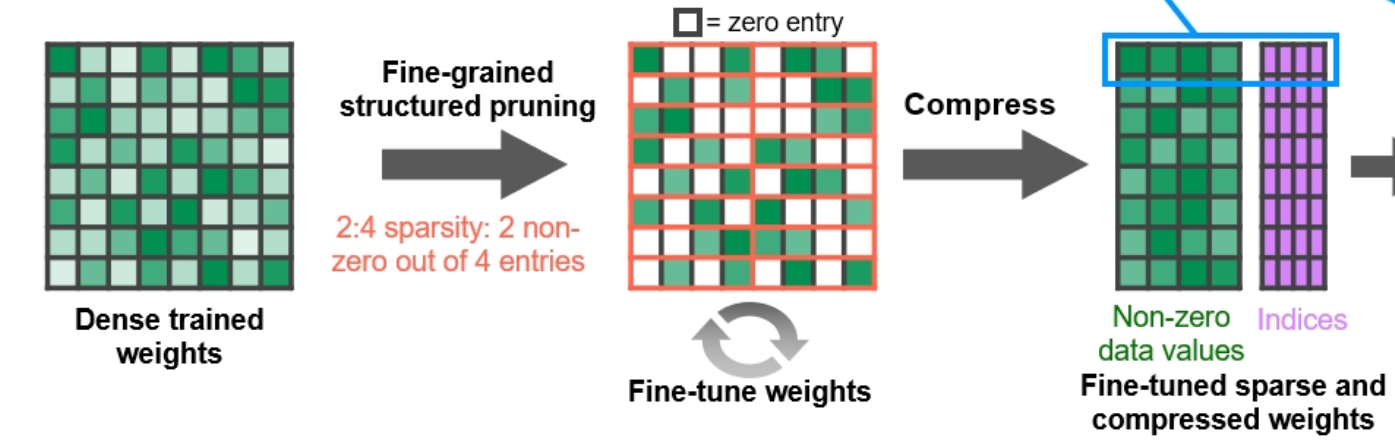
硬件可根据元数据,直接屏蔽无效零权重对应的乘法累加运算,单周期有效计算量直接翻倍。
⚠️ 关键误区:手动将权重置零无任何加速,必须是硬件识别的结构化稀疏格式。
六、实战理论推导:Jetson Orin Nano Super算力验证
硬件官方实参(无修改、纯硬件定值):
-
Tensor Core总数:32个
-
单TC单周期INT8-FMA:512,执行运算数量为512*2=1024。
-
GPU最大主频:1020MHz(CPU 1.7GHz与GPU算力无任何关联)
6.1 稠密算力推导(官方33 TOPS)
遵循NVIDIA工业统计口径:
32 × 512 × 2 × 1020 × 10 6 ÷ 10 12 = 33.4 TOPS 32 \times 512 \times 2 \times 1020 \times 10^6 \div 10^{12} = 33.4\ \text{TOPS} 32×512×2×1020×106÷1012=33.4 TOPS
厂商取整后,即为官方标注的 33 TOPS(稠密),理论推导与官方参数完全吻合。
6.2 稀疏算力推导(官方67 TOPS)
基于硬件2:4稀疏稳态吞吐翻倍特性:
33.4 × 2 = 66.8 TOPS 33.4 \times 2 = 66.8\ \text{TOPS} 33.4×2=66.8 TOPS
厂商取整后,即为官方标注的 67 TOPS(稀疏)。
七、工程与理论总结
-
所有AI整型TOPS算力,唯一由Tensor Core决定,与CUDA Core、CPU频率无关。
-
官方算力参数并非随意标注,严格遵循硬件指令吞吐+工业统计口径,可通过理论公式100%复现。
-
2:4稀疏算力翻倍是硬件流水线稳态特性,仅提升计算吞吐量,不减少数据访存开销,实际部署很难跑满理论峰值。
-
理论算力仅代表矩阵运算上限,网络中大量非矩阵运算由CUDA Core承担,真实推理性能永远低于理论TOPS。
八、结语
做AI模型部署,切忌盲从厂商宣传参数。通过官方架构白皮书推导硬件算力,是验证硬件性能、理解异构计算架构的核心能力。本文总结的INT8 TOPS通用计算方法,可复用在更多边缘GPU设备,彻底解决嵌入式AI平台的算力计算盲区。