论文原标题:MoChat: Joints-Grouped Spatio-Temporal Grounding Multimodal Large Language Model for Multi-Turn Motion Comprehension and Description
这是一篇发表在 IEEE Journal of Biomedical and Health Informatics (JBHI) 上的正式期刊论文,属于多模态大语言模型(MLLM)应用于人体运动理解与医疗康复的前沿工作。
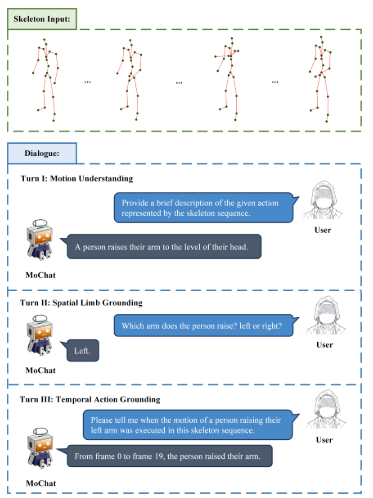
一、问题背景:
1. 康复医疗中的真实需求
| 应用场景 | 需求 | 如果没有精确时空定位 |
|---|---|---|
| 家庭康复训练 | 判断患者是否在正确的时间段完成了正确的动作 | 无法判断"抬腿"是否持续了足够时间,训练效果无法量化 |
| 帕金森病评估 | 区分左右肢体的不对称性(如左臂摆动幅度是否小于右臂) | 无法做"左右侧对比",漏掉关键的早期诊断信号 |
| 远程医疗监测 | 精准捕捉动作的起止时间,判断动作执行是否规范 | 只能知道"在动",不知道"动了多久、什么时候开始异常" |
2. 现有模型的两大缺陷
| 缺陷 | 具体表现 | 后果 |
|---|---|---|
| ① 无法进行时空定位 | 现有MLLM(如MotionGPT、TM2T)只能生成动作的整体描述,但不能精确指出动作的起止时间 或具体涉及哪个身体部位 | 在康复评估中,医生需要知道"左手抬了多久"、"右膝弯曲是否达标"------纯文本描述远远不够 |
| ② 只支持单轮交互 | 用户问完"这个人在做什么?"之后,无法追问"他的左臂在做什么?" | 缺乏多轮对话的上下文理解,限制了交互深度 |
本**论文提出,MoChat的核心主张:**把骨架按解剖结构分组编码(JGSE),让LLM既能理解运动语义,又能通过回归头(Regression Head)精确输出动作起止帧,并通过多轮对话支持对具体身体部位的追问。
二、核心贡献(三个关键词)
| 贡献 | 核心内容 | 通俗解释 |
|---|---|---|
| ① 首个骨架时空定位MLLM | MoChat是第一个能同时在骨架序列上做时序定位 (起止帧)和空间定位(具体身体部位)的多模态大语言模型 | 不仅能说"在挥手",还能说"左臂从第10帧到第35帧在上下摆动" |
| ② JGSE分组骨架编码器 | 按人体解剖结构把关节分成4组(手臂、腿、躯干、全局关节),分别编码后再融合 | 解决了"骨架编号一变就废"的泛化问题,增强了模型对左右侧肢体的区分能力------这在帕金森左右侧对比评估中至关重要 |
| ③ 半自动时间戳提取流水线 | 用GLM-4从文字描述中提取原子动作,找到变化最剧烈的关节和坐标轴,计算极值点作为起止帧 | 自动把"这个人弯腰"这个描述,变成"第20帧到第33帧"这个精确的时间区间 |
三、核心创新点:
整体框架流程:骨架序列 → JGSE分组编码 → 投影器转为LLM Token → 与指令拼接输入LLM → LLM输出文本描述 + 回归头利用交叉注意力从LLM隐状态中提取BOS权重,通过MLP精准回归出动作起止帧。
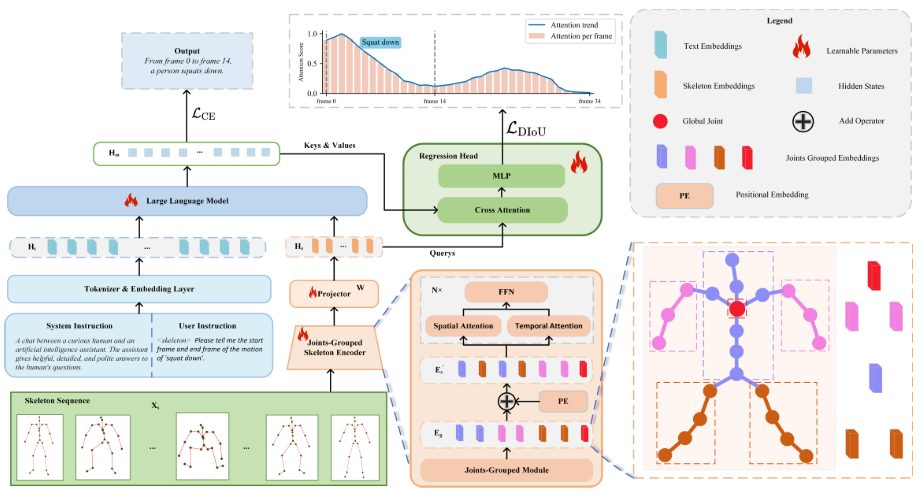
创新点1:JGSE------按解剖结构分组编码
传统方法的缺陷:
-
传统骨架编码器(如GL-Transformer)按关节编号顺序(0,1,2,3...)排列输入。
-
换个骨架格式(从25关节换到22关节),编号顺序变了,模型就得重新训练。
JGSE的解决方案:
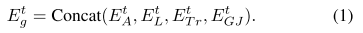
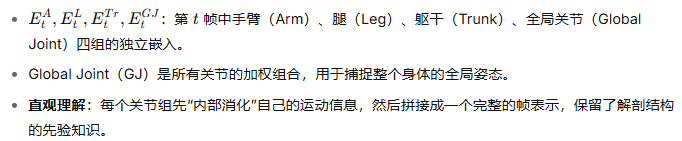
通俗例子:把一个人的骨架分成四个"部门"------手臂部、腿部、躯干部、全局部。每个部门先开内部会议(独立嵌入),然后四个部门汇总成一个报告(拼接)。
创新点2:回归头(Regression Head)------精准定位起止帧
这是MoChat区别于其他运动MLLM的核心创新。
传统方法:让LLM用自然语言生成"从第20帧到第33帧"------精度不高,且LLM输出的是文字不是数字。
MoChat的回归头:
-
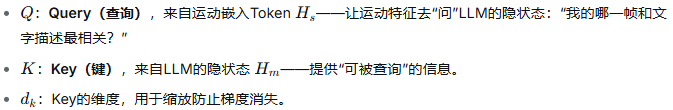
用运动Token作为Query(查询),LLM的隐状态作为Key和Value
-
通过交叉注意力计算每个运动Token与BOS(句子开始标记)的权重
-
用MLP直接从权重中回归出数值化的起止帧ID
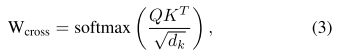
通俗例子(图6c的可视化):
-
输入:"一个人先蹲下再跳起来"
-
交叉注意力权重矩阵显示:在"蹲下"这个词上,第0-14帧的权重极高;在"跳起来"这个词上,第19-24帧的权重极高
-
模型就是用这个权重矩阵来定位起止帧的
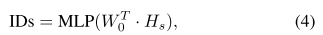
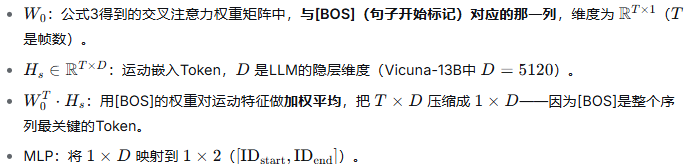
通俗例子:就像做摘要时,用文章的"标题"(BOS)的注意力权重去扫描全文,挑出最重要的两句作为起止时间。
创新点3:半自动时间戳提取流水线
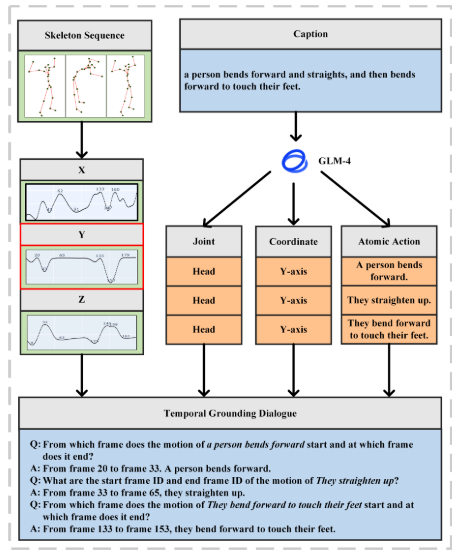
-
GLM-4分解原子动作:把"一个人先弯腰再跳起来"拆成"弯腰"和"跳起来"
-
识别变化最剧烈的关节和坐标轴:比如"弯腰"时,躯干的Y轴变化最大
-
计算极值点:在选定的关节坐标曲线上,找到峰值点和谷值点作为起止帧
-
人工审核:确保标注质量
四、比较的基准:
1. 运动理解(Motion Understanding)
| 方法 | 特点 | 备注 |
|---|---|---|
| TM2T | 用VQVAE离散化+神经机器翻译 | 经典基线 |
| MotionGPT | LLM+投影器 | 开源SOTA之一 |
| AvatarGPT | 运动理解+生成一体化 | 训练数据量大 |
| Baseline | GL-Transformer编码器+相同LLM | 消融对比 |
2. 空间定位(Spatial Limb Grounding,表III)
| 方法 | 准确率 |
|---|---|
| GPT-4V | 68.02% |
| Baseline | 80.12% |
| MoChat (Ours) | 85.70% |
| MoChat-R | 81.90% |
3. 时序定位(Temporal Action Grounding,表IV)
| 方法 | R@1 IoU=0.5 | R@1 IoU=0.7 |
|---|---|---|
| TimeChat | 2.10% | 0.40% |
| Baseline | 12.45% | 6.87% |
| MoChat | 19.31% | 5.58% |
| MoChat-R | 21.89% | 12.02% |
数据集
| 数据集 | 规模 | 骨架类型 | 特点 |
|---|---|---|---|
| HumanML3D | 14,616个运动序列,44,970条文字描述 | 22关节SMPL骨架 | 主要训练和评估集,8:1:1划分 |
| KIT-ML | 3,911个运动片段,6,278条英文描述 | 21关节骨架,10Hz采样 | 跨数据集验证泛化能力 |
总结:
MoChat通过JGSE解剖分组编码+回归头精准定位 ,让MLLM第一次真正具备了"看懂运动细节"的能力------不仅能描述"在做什么",还能精确指出"从哪帧到哪帧"和"哪个部位在做"。这为康复医疗、神经疾病早期筛查、家庭健身监测等需要精确运动分析的应用提供了关键技术基础。