一、引言:排序是什么、为什么重要
排序就是把一组数据按某种规则(如从小到大、从大到小)重新排列成有序序列。
为什么重要?
- 查得快:有序数据能用二分查找,复杂度从 O(n) 降到 O(log n)。
- 很多问题的基础:找第 k 大、去重、合并、求中位数,都依赖有序。
二、评价排序的三个维度
1. 时间复杂度
随数据量 n 增长的运行时间,通常关注 最好 / 平均 / 最坏 三种情况。
2. 空间复杂度
除输入数据外额外占用的内存(是否"原地排序")。
- 原地排序:空间 O(1),如冒泡、选择、插入、堆排序。
- 非原地:需要额外空间,如归并(O(n))、计数(O(k))。
3. 稳定性
相等的元素排序后,相对顺序是否保持不变。
- 稳定 :
[5, 3, 5, 1]→ 排序后5a仍在5b前面。 - 不稳定 :
5b跑到5a前面。
为什么重要?比如先按成绩排、再按班级排,若不稳定,同班同分的学生顺序会被打乱。
4. 复杂度记号速记
| 记号 | 含义 | 常见算法 |
|---|---|---|
| O(1) | 常数时间 | 交换、取数组元素 |
| O(log n) | 对数时间 | 二分查找 |
| O(n) | 线性时间 | 计数排序、一趟扫描 |
| O(n log n) | 线性对数 | 归并、快排、堆排 |
| O(n²) | 平方时间 | 冒泡、选择、插入 |
三、O(n²) 简单排序
3.1 冒泡排序
核心思想:相邻元素两两比较,大的往后"冒",每一轮把最大值冒到最后。
实现步骤:
- 从第一个元素开始,比较相邻两个元素。
- 若前一个 > 后一个,则交换。
- 继续往后,直到把最大值冒到本轮末尾。
- 下一轮忽略已就位的末尾元素,重复步骤 1~3。
- 若某一轮没有发生任何交换,说明已有序,提前结束。
代码
cpp
void bubbleSort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        int flag = 0;//假设有序
        for (int j = 0; j < n - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int t = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = t;
                flag = 1;//发生交换,说明无序
            }
        }
        if (!flag) break;   // 本轮无交换,已有序
    }
}| 值 | |
|---|---|
| 最好时间 | O(n)(已有序,加标志位) |
| 平均/最坏 | O(n²) |
| 空间 | O(1) |
| 稳定 | ✅ 稳定 |
3.2 选择排序
核心思想 :每一轮从未排序区选出最小元素,交换到已排序区末尾。
实现步骤:
- 假设未排序区第一个位置
i是最小值位置。 - 在
[i+1, n-1]扫描,找到真正的最小值下标minIdx。 - 若
minIdx != i,交换arr[i]和arr[minIdx]。 i加 1,重复步骤 1~3,共 n-1 轮。
代码:
cpp
void selectionSort(int arr[], int n) {
    for (int i = 0; i < n - 1; i++) {
        int minIdx = i;
        for (int j = i + 1; j < n; j++) {
            if (arr[j] < arr[minIdx])
                minIdx = j;
        }
        if (minIdx != i) {
            int t = arr[i];
            arr[i] = arr[minIdx];
            arr[minIdx] = t;
        }
    }
}| 项目 | 值 |
|---|---|
| 最好/平均/最坏时间 | 都是 O(n²)(无提前结束) |
| 比较次数 | 固定 n(n-1)/2 |
| 交换次数 | 最多 n-1(最少 0) |
| 空间 | O(1) |
| 稳定 | ❌ 不稳定 |
为什么不稳定 :swap(&arr[i], &arr[minIdx]) 是一次长距离跳跃交换,会越过相等的元素。
反例:
[5a, 8, 5b, 2],第 1 轮把 2 与 5a 交换 →[2, 8, 5b, 5a],两个 5 顺序颠倒。
3.3 插入排序
核心思想 :像打扑克牌,把当前元素插入到已排序部分中的正确位置。
实现步骤:
- 从第 2 个元素开始,把它记为
key(第一个元素视为已排序)。 - 往前比较,比
key大的元素都右移一位,腾出空位。 - 把
key放入空位。 - 继续处理下一个元素,直到末尾。
代码:
cpp
void insertionSort(int arr[], int n) {
    for (int i = 1; i < n; i++) {
        int key = arr[i];
        int j = i - 1;
        while (j >= 0 && arr[j] > key) {   // 比 key 大的右移
            arr[j + 1] = arr[j];
            j--;
        }
        arr[j + 1] = key;                  // 放入正确位置
    }
}| 项目 | 值 |
|---|---|
| 最好时间 | O(n)(已有序) |
| 平均/最坏 | O(n²) |
| 空间 | O(1) |
| 稳定 | ✅ 稳定 |
注意:
while (arr[j] > key)用严格大于保证稳定(相同值不会右移)。
特点:对"近有序"数据极快,常被用作快排/归并的小数组优化。
3.4 希尔排序(Shell Sort)
核心思想 :插入排序的改进。先用较大间隔 gap 分组做插入排序,让元素大步提前就位,再逐步缩小 gap,最后 gap=1 时就是普通插入排序(此时数据已近有序,接近 O(n))。
实现步骤:
- 取初始 gap(常用 n/2)。
- 对间距为 gap 的元素分别做插入排序。
- 缩小 gap(常用 gap/2),重复步骤 2。
- 直到 gap = 1,完成最后一次整体插入排序。
代码:
cpp
void shellSort(int arr[], int n) {
    for (int gap = n / 2; gap > 0; gap /= 2) {
        for (int i = gap; i < n; i++) {
            int key = arr[i];
            int j = i;
            while (j >= gap && arr[j - gap] > key) {
                arr[j] = arr[j - gap];
                j -= gap;
            }
            arr[j] = key;
        }
    }
}| 项目 | 值 |
|---|---|
| 最好时间 | O(n log n)(取决于 gap 序列) |
| 平均时间 | O(n^1.3) 左右 |
| 最坏时间 | O(n²) |
| 空间 | O(1) |
| 稳定 | ❌ 不稳定 |
四、O(n log n) 高级排序
这几种算法利用分治或堆结构,把复杂度降到 O(n log n),是真正实用的一档。
4.1 归并排序
核心思想 :分治法 。递归地把数组对半拆分,直到每段只剩一个元素(天然有序),再两两合并成有序段。
实现步骤:
- 拆分 :找到中点 mid,把当前区间
[left, right]拆成[left, mid]和[mid+1, right]。 - 递归:对左右两半分别递归排序。
- 合并:用双指针比较两半,谁小先取谁,放入临时数组。
- 收尾:把剩余元素追加进临时数组。
- 拷贝:把临时数组的有序结果拷回原数组。
代码:
cpp
void _MergeSort(int* arr, int left, int right, int* tmp)
{
	if (left >= right)
	{
		return;
	}
	int mid = (left + right) / 2;// 左半:[left, mid]   右半:[mid+1, right]
	_MergeSort(arr, left, mid, tmp);// 先让左边有序
	_MergeSort(arr, mid+1, right, tmp);// 再让右边有序
	int begin1 = left, end1 = mid;        // 左序列:[begin1, end1]
    int begin2 = mid + 1, end2 = right;   // 右序列:[begin2, end2]
    int index = left;                     // tmp 的写入位置,从 left 开始
	while (begin1 <= end1 && begin2 <= end2)
	{
		if (arr[begin1] <= arr[begin2])
		{
			tmp[index++] = arr[begin1++];
		}
		else
		{
			tmp[index++] = arr[begin2++];
		}
	}
	while (begin1 <= end1)// 右边先排完,把左边剩下的接上
	{
		tmp[index++] = arr[begin1++];
	}
	while (begin2 <= end2)// 左边先排完,把右边剩下的接上
	{
		tmp[index++] = arr[begin2++];
	}
	for (int i = left; i <= right; i++)
	{
		arr[i] = tmp[i];
	}
}
void MergeSort(int* arr, int n)
{
	int* tmp = (int*)malloc(n * sizeof(int));
	if (tmp == NULL)
	{
		perror("malloc");
		return;
	}
	_MergeSort(arr, 0, n - 1, tmp);
	free(tmp);
	tmp = NULL;
}| 项目 | 值 |
|---|---|
| 最好/平均/最坏时间 | 都是 O(n log n) |
| 空间 | O(n)(辅助数组) |
| 稳定 | ✅ 稳定(等值优先取左边) |
特点 :性能最稳定,适合外部排序(数据在磁盘、内存放不下)和链表排序。
4.2 快速排序------ Lomuto 与 Hoare 两种分区
核心思想 :分治法 。选一个基准值 pivot ,把小于它的放左边、大于它的放右边(分区),再递归排序左右两部分。
实现步骤:① 选 pivot(Lomuto 取最右,Hoare 取最左)→ ② 分区成左小右大 → ③ 递归左右两部分 → ④ 子数组只剩一个元素时停止。
版本一:Lomuto 分区(单指针,pivot 取末尾)
- 返回的
p就是 pivot 的最终位置。 - 递归区间用
[low, p-1]和[p+1, high]。
cpp
int partitionLomuto(int arr[], int low, int high) {
      int pivot = arr[high];          // 选最右元素作为基准
    int i = low - 1;                  // i 指向"小于等于区"的末尾
    for (int j = low; j < high; j++)
    {                                 // j 从左往右扫描
        if (arr[j] <= pivot)
        {                             //  发现小于等于基准的元素
            i++;                      //  扩展"小于等于区"
            swap(&arr[i], &arr[j]);   //  把它换到该区末尾
        }
    }
    swap(&arr[i + 1], &arr[high]);    // 把基准放到正确位置
    return i + 1;                     // 返回基准的最终下标
}
void quickSortLomuto(int arr[], int low, int high) {
   if (low < high)
{                                                   //  递归终止条件
        int p = partitionLomuto(arr, low, high);    //  分区,拿到基准位置
        quickSortLomuto(arr, low, p - 1);           //  递归左半(不含 p)
        quickSortLomuto(arr, p + 1, high);          //  递归右半(不含 p)
}
}
注意 :这里跳过了 p (用 p-1 和 p+1),因为 arr[p] 已经排好了。这正是 Lomuto 方案的特点------返回值就是基准的最终位置。
版本二:Hoare 分区(双指针相向,pivot 取开头)
- 返回的
j只是分界点,pivot 不一定在最终位置。 - 递归区间用
[low, p]和[p+1, high]。
cpp
int _partitionHoare(int* arr, int left, int right)
{
	int key = left;
	left++;
	while (left <= right)
	{
		while (left <= right && arr[key] < arr[right])
		{
			right--;
		}
		while (left <= right && arr[key] > arr[left])
		{
			left++;
		}
		if (left <= right)
		{
			swap(&arr[left++], &arr[right--]);
		}
	}
	swap(&arr[key], &arr[right]);
	return right;
}
void QuickSort(int* arr, int left, int right)
{
	if (left >= right)
		return;
	int key = _partitionHoare(arr, left, right);
	QuickSort(arr, left, key - 1);
	QuickSort(arr, key + 1, right);
}
外层循环
while (left <= right)只要两指针没有交错,就继续处理。
右指针左移:找"≤ 基准"的元素
while (left <= right && arr[key] < arr[right])
right--;- 当
arr[right]大于 基准时,说明它本来就该待在右半区,right--继续往前找。 - 停下来的位置
arr[right] <= 基准,这个元素应该被换到左边去。
左指针右移:找"≥ 基准"的元素
while (left <= right && arr[key] > arr[left])
left++;- 当
arr[left]小于 基准时,它本来就该待在左半区,left++继续往后找。 - 停下来的位置
arr[left] >= 基准,这个元素应该被换到右边去。
交换错位的一对
if (left <= right)
swap(&arr[left++], &arr[right--]);- 此时
arr[left]是左边"偏大"的,arr[right]是右边"偏小"的,正好错位,交换它们。 - 交换后
left++、right--,两指针各前进一格。 if (left <= right)的判断很关键:如果两指针已经交错,说明没有可交换的元素了,直接跳过。
基准归位
swap(&arr[key], &arr[right]);循环结束时 left > right,right 就是左半区的最后一个位置 。把基准从 key 换到 right,基准就落在了最终正确位置上。
返回基准下标
return right;返回基准的最终位置,供 QuickSort 递归使用。
| 项目 | 值 |
|---|---|
| 最好/平均时间 | O(n log n) |
| 最坏时间 | O(n²)(pivot 选到最大/最小,如已有序数组) |
| 空间 | O(log n)(递归栈) |
| 稳定 | ❌ 不稳定 |
关键坑(重点记忆):
| Lomuto | Hoare | |
|---|---|---|
| pivot 位置 | 取 arr[high] |
取 arr[low] |
| 返回分界点 | pivot 最终位置 | 只是分界点,pivot 不在最终位置 |
| 递归区间 | [low, p-1]、[p+1, high] |
[low, p]、[p+1, high] |
| 交换次数 | 较多 | 较少(约 1/3) |
| 速度 | 稍慢 | 更快 |
优化建议:随机选 pivot 或三数取中,避免有序数组退化 O(n²);小数组改用插入排序。
4.3 堆排序
核心思想 :利用大顶堆(父节点 ≥ 子节点的完全二叉树)。反复取堆顶最大值放到末尾,再重建堆。
实现步骤:① 建大顶堆(从最后一个非叶子节点自底向上逐个"下沉")→ ② 把堆顶(最大)与末尾元素交换 → ③ 堆大小减 1 → ④ 让新堆顶下沉 → ⑤ 重复直到堆空。
代码:
cpp
void swap(int* x, int* y) { int t = *x; *x = *y; *y = t; }

// 大顶堆下沉:把 parent 位置的元素下沉到正确位置
void adjustDown(int arr[], int n, int parent) {   // (arr, 堆大小, 父节点)
    int child = parent * 2 + 1;                    // 左孩子
    while (child < n) {
        if (child + 1 < n && arr[child] < arr[child + 1])
            child++;                               // 选较大的孩子
        if (arr[child] > arr[parent]) {
            swap(&arr[child], &arr[parent]);
            parent = child;
            child = parent * 2 + 1;
        } else {
            break;    // 已满足堆性质,避免死循环!
        }
    }
}

void heapSort(int arr[], int n) {
    // 1. 建大顶堆:从最后一个非叶子节点 (n-2)/2 往前逐个下沉
    for (int i = (n - 2) / 2; i >= 0; i--)
        adjustDown(arr, n, i);

    // 2. 依次把最大值放到末尾
    for (int end = n - 1; end > 0; end--) {
        swap(&arr[0], &arr[end]);        // 堆顶(最大)换到末尾
        adjustDown(arr, end, 0);          // 缩小堆后下沉堆顶
    }
}| 项目 | 值 |
|---|---|
| 最好/平均/最坏时间 | 都是 O(n log n) |
| 空间 | O(1)(原地) |
| 稳定 | ❌ 不稳定 |
重点坑:
- 最后一个非叶子节点下标是
(n - 2) / 2,建堆循环从这里往前。 adjustDown一定要有else break,否则满足堆性质时会死循环。- 参数顺序要一致:本实现是
(arr, size, parent),调用时别写反。
特点:原地、无递归栈风险、最坏情况也稳定在 O(n log n),适合内存受限、需要最坏性能保证的场景。
五、O(n) 非比较排序
这三类算法不靠比较元素大小,而是利用值分布的规律,能突破 O(n log n) 的比较排序下界。但有前提:数据是整数、取值范围有限。
5.1 计数排序
核心思想:统计每个值出现的次数,再按值从小到大顺序展开。范围大时用偏移(min)法支持负数。
实现步骤:
- 找最小值 min 和最大值 max,算出范围
range = max - min + 1。 - 开计数数组
count[range],统计每个值出现次数(下标记arr[i] - min)。 - 求前缀和:
count[i]表示"值 ≤ i 的元素个数"。 - 从后往前遍历原数组,把每个元素放到正确位置(保证稳定)。
- 拷贝回原数组。
代码:
cpp
void CountSort(int* arr, int n)
{
	int min = arr[0];
	int max = arr[0];
	for (int i = 0; i < n; i++)//找最小值和最大值
	{
		if (arr[i] < min)
		{
			min = arr[i];
		}
		if (arr[i] > max)
		{
			max = arr[i];
		}
	}
	int range = max - min + 1;//值的总个数。比如 min=2、max=8,range = 7,对应值 2~8。
	int* count = (int*)malloc(range * sizeof(int));
	if (count == NULL)
	{
		perror("malloc");
		return;
	}
	memset(count, 0, sizeof(int) * range);//把数组全部置 0。
	for (int i = 0; i < n; i++)//统计每个值出现的次数
	{
		count[arr[i] - min]++;
	}
	int index = 0;
	for (int i = 0; i < range; i++)//按值从小到大铺回原数组
	{
		while (count[i]--)
		{
			arr[index++] = min + i;
		}
	}
}
以 arr = [3, 6, 2, 3, 8, 6, 4, 6, 8, 4],n = 10 为例。
阶段 1 :遍历得 min = 2,max = 8 → range = 7
阶段 2 :count 大小 7,全 0
阶段 3:统计
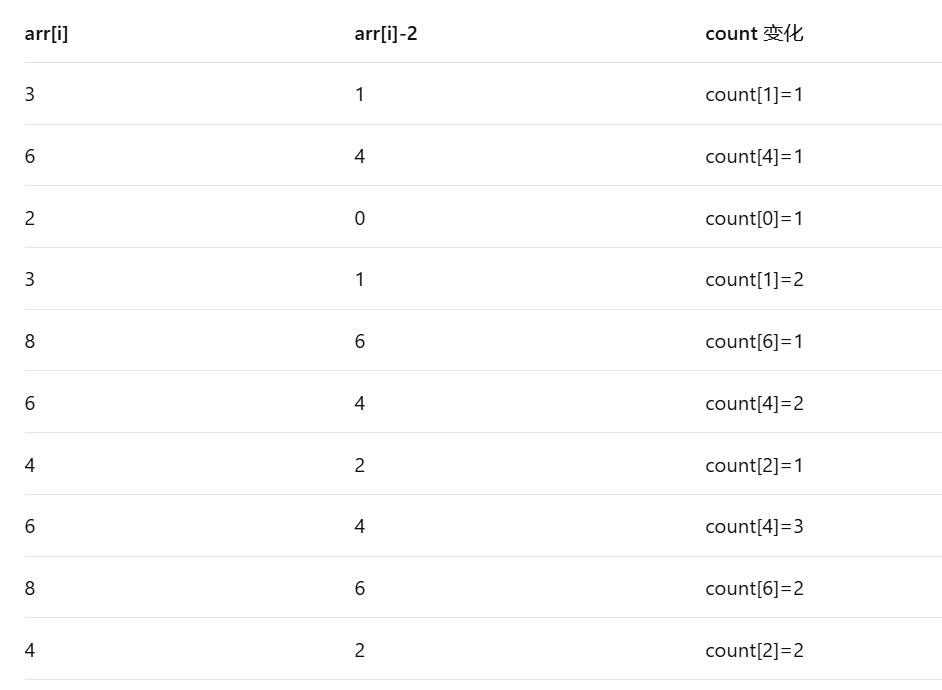
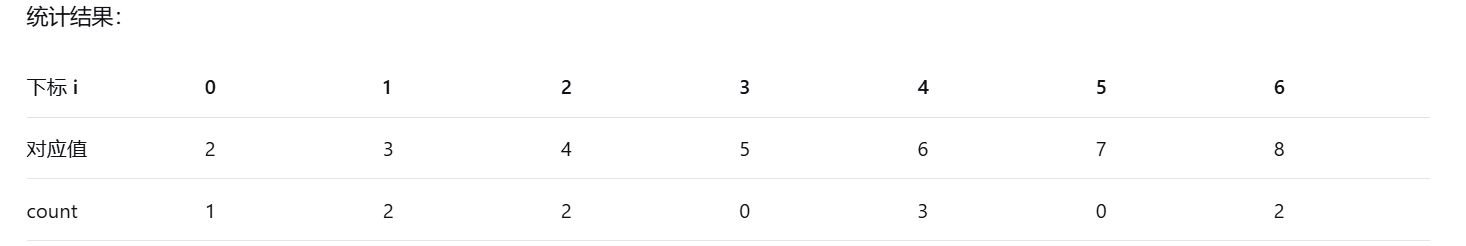
阶段 4:铺回
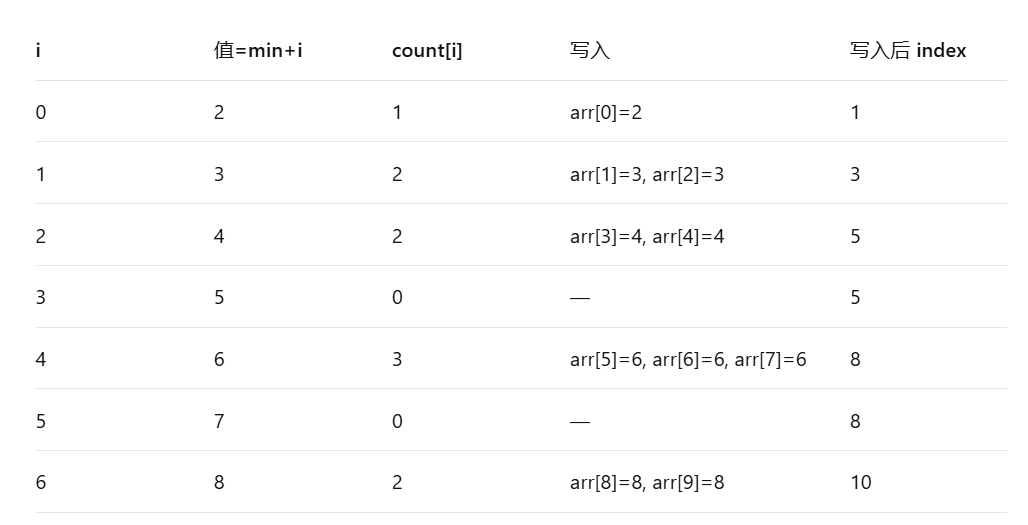
结果 :[2, 3, 3, 4, 4, 6, 6, 6, 8, 8]
| 项目 | 值 |
|---|---|
| 时间 | O(n + k),k 为取值范围大小 |
| 空间 | O(k)(或 O(n + k)) |
| 稳定 | ✅(前缀和 + 逆序) |
适用 :整数、取值范围小(如成绩 0100、年龄 0150)。
重点:
- 必须
free申请的数组,否则内存泄漏。 n == 0时不能直接arr[0],要加保护。- 还原时
arr[index++]中的index一定要自增。 - k 很大时(如范围 0~10⁹)时间和内存都爆炸,不适用。
六、总结对比
6.1 总对比表
| 算法 | 平均时间 | 最坏时间 | 空间 | 稳定 | 特点 |
|---|---|---|---|---|---|
| 冒泡 | O(n²) | O(n²) | O(1) | ✅ | 简单,教学用 |
| 选择 | O(n²) | O(n²) | O(1) | ❌ | 交换次数最少 |
| 插入 | O(n²) | O(n²) | O(1) | ✅ | 小规模/近有序极快 |
| 希尔 | O(n^1.3) | O(n²) | O(1) | ❌ | 插入排序改进 |
| 归并 | O(n log n) | O(n log n) | O(n) | ✅ | 稳定,外部排序 |
| 快速 | O(n log n) | O(n²) | O(log n) | ❌ | 实践中最快 |
| 堆 | O(n log n) | O(n log n) | O(1) | ❌ | 原地,最坏保证 |
| 计数 | O(n+k) | O(n+k) | O(k) | ✅ | 整数、范围小 |
6.2 稳定性汇总
| 稳定 | 不稳定 |
|---|---|
| 冒泡、插入、归并、计数 | 选择、希尔、快速、堆 |
记忆:稳定的大多是"相邻逐步移动"(冒泡/插入/归并),或"非比较"(计数/基数)。
6.3 复杂度速记
| 复杂度 | 算法 |
|---|---|
| O(n²) | 冒泡、选择、插入 |
| O(n^1.3) | 希尔 |
| O(n log n) | 归并、快排、堆排 |
| O(n) | 计数 |