基于目标变量梯度着色与排序展开的三维瀑布图
文章目录
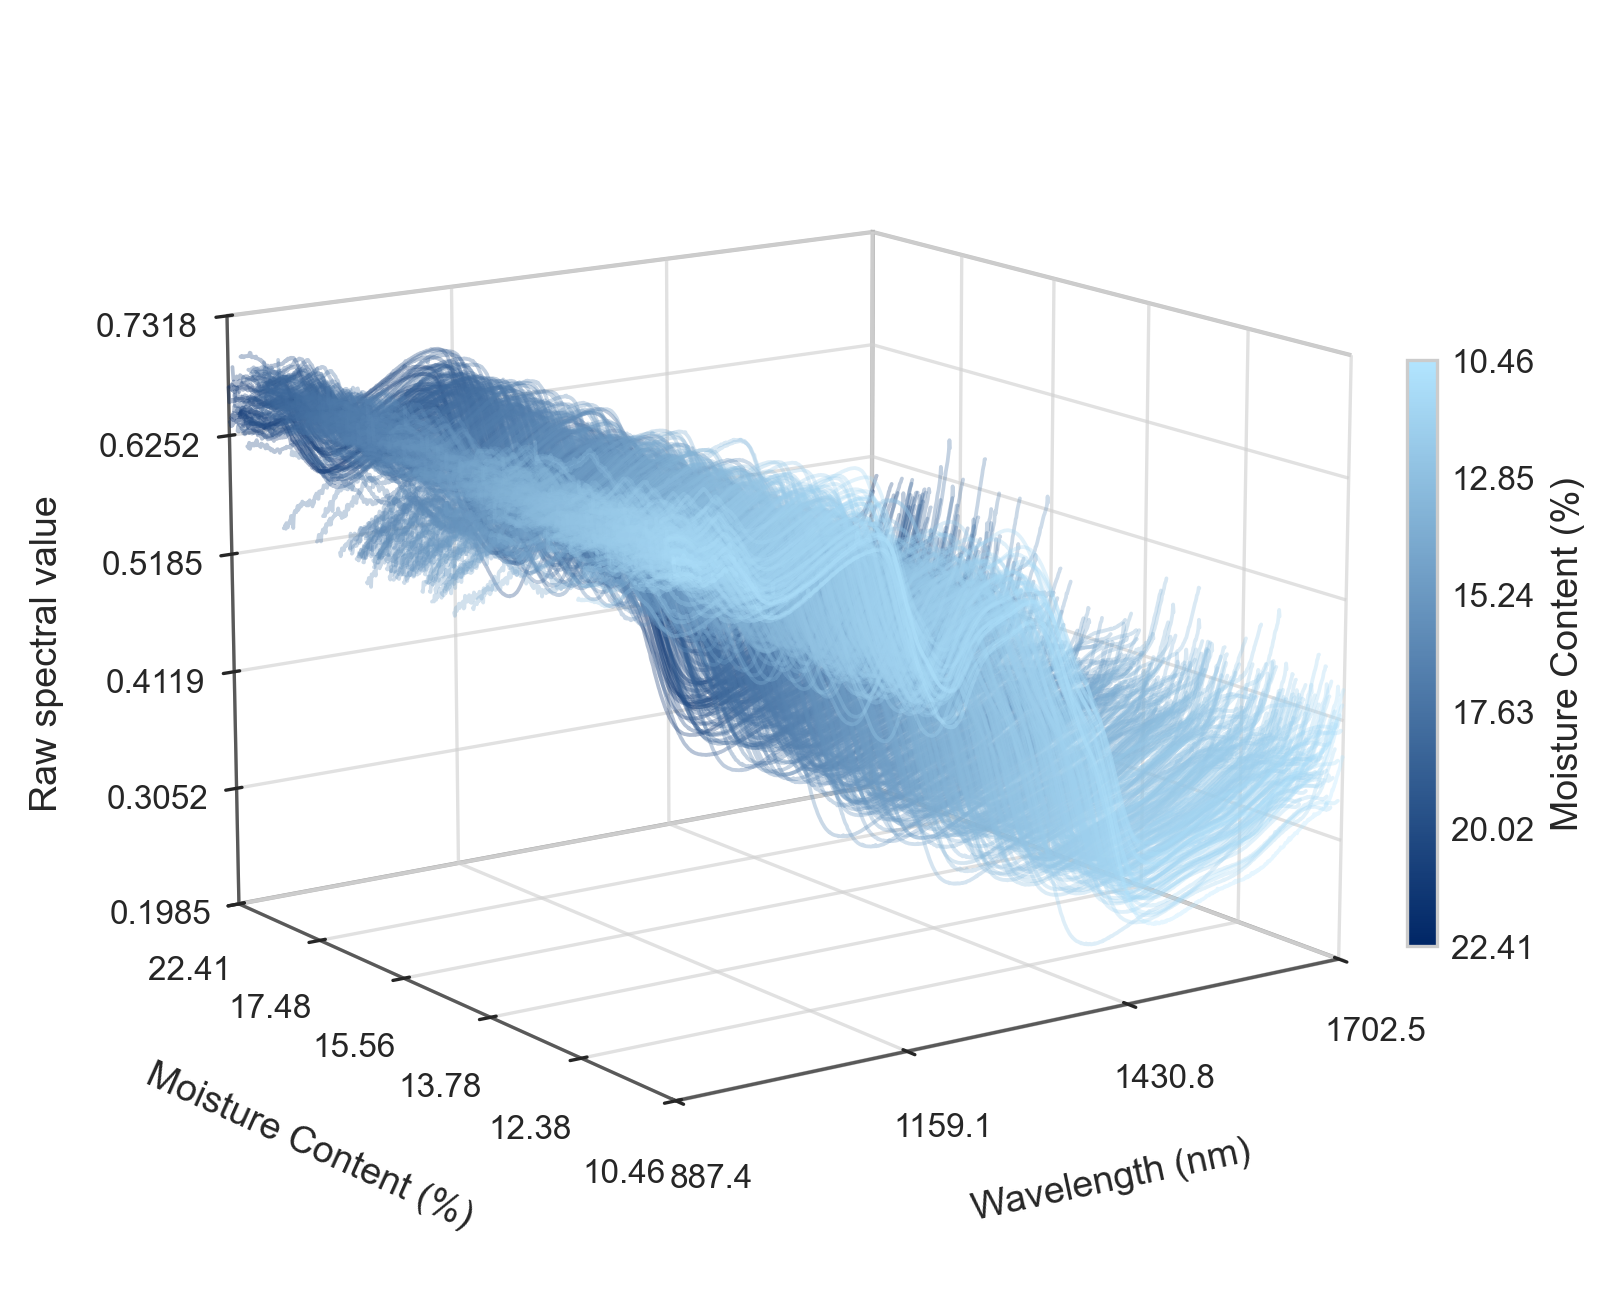
生成的图以波长为 x 轴,以含水率为 y 轴,以原始光谱值为 z 轴。每条曲线对应一个样本,颜色也由含水率决定。它适合先看整批样本的光谱轮廓、样本间差异和异常曲线,也可以作为后续预处理与建模之前的原始数据检查图。
代码仓库:https://github.com/kaixin-aa/figure-code/tree/main/examples/002-raw-spectra-3d
准备运行环境
脚本使用 Python,并依赖下面几个包。
text
numpy
pandas
matplotlib
openpyxl
前三个包负责数值处理、表格读取和绘图。读取 .xlsx 文件时还需要 openpyxl。旧版 .xls 文件通常还要安装 xlrd。
当前计算机上的 CNN 环境已经通过实际绘图验证。进入脚本所在目录后,可以先检查 Python 和依赖是否可用。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" -c "import numpy, pandas, matplotlib, openpyxl; print('环境可用')"缺少依赖时,在准备运行脚本的同一个 Python 环境中安装。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" -m pip install numpy pandas matplotlib openpyxl这里有一个常见的小坑。电脑上可能同时装着系统 Python、Conda 环境和编辑器自己选择的解释器。安装包时用了一个 Python,运行脚本时又用了另一个,程序依旧会报告缺少模块。最稳妥的办法是让安装命令和运行命令使用同一个 python.exe。
看懂输入表的结构
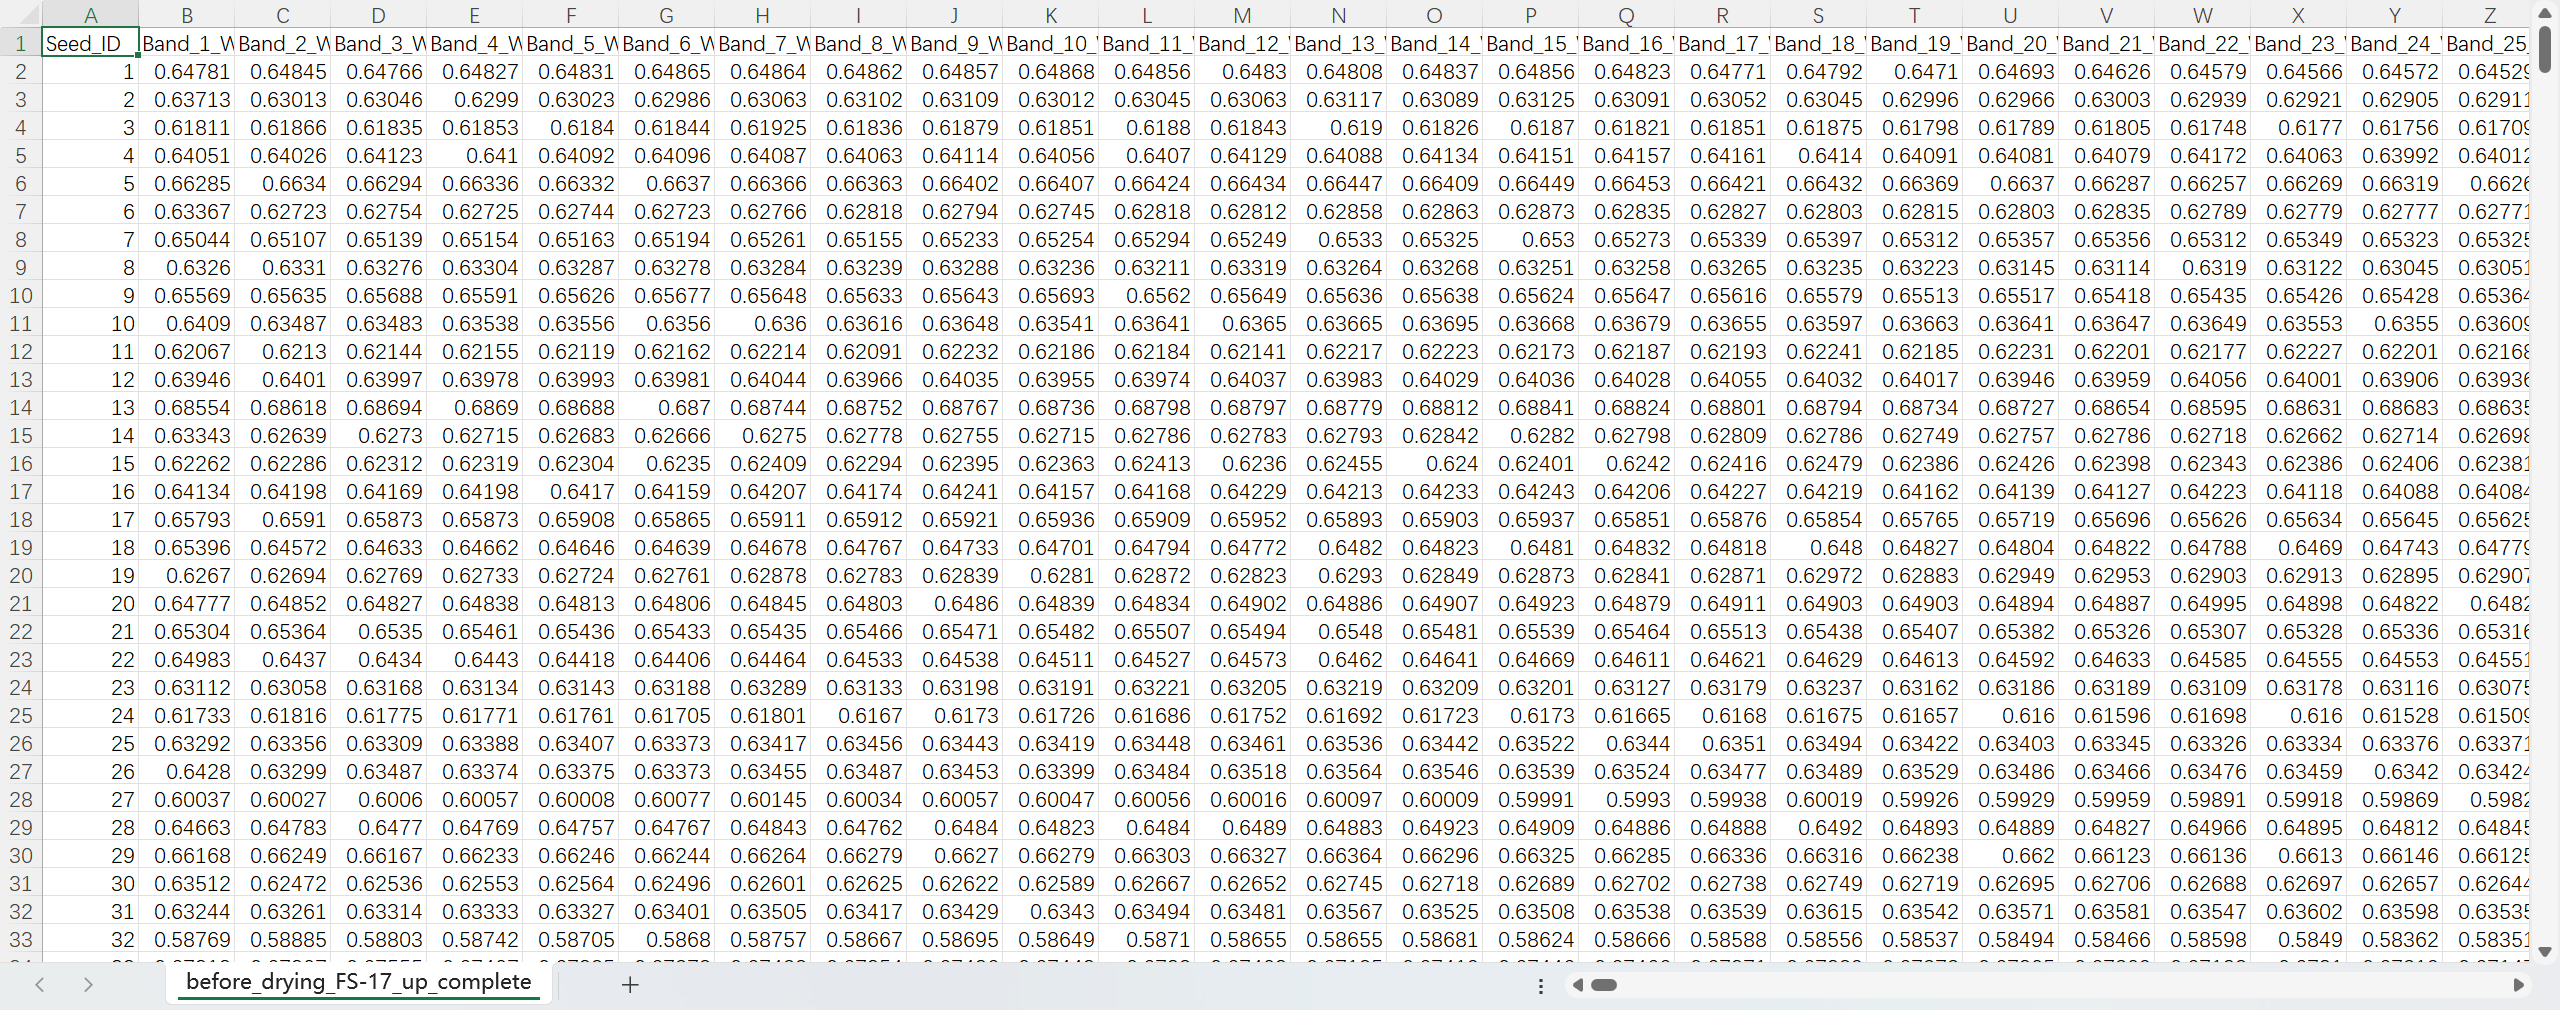
当前输入文件虽然可以用 Excel 打开,实际格式是 CSV。文件中共有 1026 列。
其中一列是 Seed_ID,用于保存样本编号。一列是 Moisture_Content,用于保存含水率。其余 1024 列是原始光谱,列名采用下面这种形式。
text
Band_1_Wavelength_887.39
Band_2_Wavelength_888.2
Band_3_Wavelength_889.0
...
Band_1024_Wavelength_1702.46
脚本会寻找列名中的 Wavelength、wave 或 nm,随后提取对应的波长数字。Seed_ID 虽然也带有字符和数字含义,却不符合波长列规则,因此不会混入光谱矩阵。
以后换表时,建议继续保留这种列名。也可以直接把数值波长写成列名,例如 900、901.5 和 903。两种格式都能让脚本得到真实的波长坐标。
如果新表完全没有波长信息,脚本会把可用的数值列当作光谱,并用 1、2、3 这样的波段序号充当横坐标。这种退回方式能让图画出来,却无法恢复真实波长。准备数据表时把波长留在列名里,会省掉后续核对工作。
绝对路径写在哪里
脚本顶部的默认输入文件已经改成绝对路径。
python
DEFAULT_DATA_FILE = Path(
    r"G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\data_fs17"
    r"\before_drying_FS-17_up_complete_dataset.csv"
)
默认输出目录同样使用绝对路径。
python
DEFAULT_OUTPUT_DIR = Path(
    r"G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\raw_spectra_output"
)
路径前面的 r 很重要。Python 普通字符串会把部分反斜杠组合当作转义字符,原始字符串可以直接保留 Windows 路径。绝对路径也让脚本不再依赖当前终端位于哪个目录。
换一份数据时,可以直接修改 DEFAULT_DATA_FILE。例如,新文件位于 D:\spectral_data\batch_02.xlsx,配置可以写成下面这样。
python
DEFAULT_DATA_FILE = Path(r"D:\spectral_data\batch_02.xlsx")绝对路径会绑定当前电脑的盘符与文件夹。文件移动以后,配置也要跟着改。需要频繁切换数据时,命令行参数更方便。
直接运行默认数据
脚本的完整路径如下。
text
G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py在 PowerShell 中运行默认数据,可以使用这条命令。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py"
运行结束后,终端会显示输入文件、目标列、样本数、光谱列数、波长范围和输出文件位置。默认图片保存在 raw_spectra_output 文件夹中,文件名由输入表名称自动生成。
当前数据对应的默认输出文件为下面这个文件。
text
before_drying_FS-17_up_complete_dataset_raw_spectra_3d.png不改代码就更换数据
--input 可以临时覆盖脚本顶部的默认路径。下一次拿到新的 Excel 文件时,直接把绝对路径放进命令即可。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py" `
  --input "D:\spectral_data\batch_02.xlsx"
脚本内部会对传入路径调用 resolve(),最终仍按绝对路径读取。这样可以保留一份固定脚本,只在命令中更换文件。
读取 CSV 时,脚本先尝试 UTF-8 编码,失败后再尝试 GBK。读取 Excel 时,默认选择第一个工作表。工作表名称不是第一个时,可以显式指定。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py" `
  --input "D:\spectral_data\batch_02.xlsx" `
  --sheet "原始光谱"
--sheet 0 代表第一个工作表,--sheet 1 代表第二个工作表。使用 CSV 时,这个参数会被忽略。
更换目标列
默认目标列是 Moisture_Content。新表如果仍用这个名称,无需调整。列名发生变化时,使用 --target 指定。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py" `
  --input "D:\spectral_data\batch_02.xlsx" `
  --target "Water_Content"
图中的轴标签默认由目标列名生成,下划线会被替换为空格。想使用更适合论文或汇报的名称,可以增加 --target-label。
powershell
--target-label "Moisture content (%)"目标列必须能够转换为数值。空单元格、文本和无穷值都会触发检查,脚本会报告光谱异常行数和目标列异常行数。这种做法会让问题尽早暴露,避免带着缺失值继续出图。
确认含水率的单位
当前数据中的含水率以比例值保存,例如 0.1046。脚本默认使用 --target-unit auto。当目标值的最大绝对值不超过 1.5 时,它会自动乘以 100,因此图上显示为 10.46。
新数据已经写成 10.46 这类百分数时,自动模式会保持原值。也可以明确指定单位。
powershell
# 输入是 0.1046 这类比例值
--target-unit ratio

# 输入已经是 10.46 这类百分数
--target-unit percent

# 保留目标列原值,不附加百分号含义
--target-unit raw
自动判断适合当前含水率数据。目标变量换成浓度、硬度或其他指标时,建议明确使用 raw,并通过 --target-label 写清单位。
这里的乘以 100 只用于目标轴和颜色映射,不会改动光谱矩阵。图中的 z 轴始终来自输入表内的原始光谱值。
选择曲线在 y 轴上的排布
640 条曲线同时放进三维坐标系,很容易互相遮挡。脚本默认使用 rank 模式。它先按目标值从小到大排序,再把曲线等距放开。y 轴刻度和颜色条仍显示真实目标值。
powershell
--y-mode rank如果研究任务要求曲线之间的距离严格对应目标值差异,可以使用 actual。
powershell
--y-mode actual目标值分布很密时,actual 会让曲线挤在一起。查看整批光谱轮廓时,rank 通常更清楚。分析目标值间隔本身时,再考虑 actual。
裁剪波长范围
默认配置不会裁剪波长,输入表中识别到的原始波段都会进入绘图。只查看某个范围时,可以指定上下限。
powershell
--wavelength-min 900 --wavelength-max 1650完整命令可以写成下面这样。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py" `
  --input "D:\spectral_data\batch_02.xlsx" `
  --sheet "原始光谱" `
  --target "Moisture_Content" `
  --target-unit ratio `
  --wavelength-min 900 `
  --wavelength-max 1650
这一步只选择波段,没有对保留下来的光谱进行数学变换。
排除额外的数值元数据列
列名中带有明确波长时,脚本只会选择这些波长列。某些数据表没有规范波长列名,脚本便会退回到数值列识别。此时,批次号、温度或质量等数值列可能需要手动排除。
powershell
--exclude-columns "Batch_ID,Temperature,Weight"多个列名用英文逗号分隔。列名必须与表格中的内容一致,包括空格和大小写。
更稳妥的数据整理办法,是让光谱列名携带真实波长。手动排除适合接收格式不统一的旧表,规范列名更适合长期使用。
输出不同格式
默认只输出 300 dpi 的 PNG。论文排版需要可编辑文字或矢量线条时,可以同时输出 SVG 和 PDF。TIFF 适合需要高分辨率位图的场合。
powershell
--formats png svg pdf tiff --dpi 600输出目录和文件名也能临时指定。
powershell
--output-dir "D:\spectral_results\batch_02" `
--output-name "batch_02_raw_spectra"
SVG 与 PDF 中的文字会尽量保持可编辑。PNG 和 TIFF 会使用 --dpi 指定的分辨率。三维 z 轴标签采用稳定的轴坐标定位,可以避开部分 Matplotlib 版本在紧凑保存时裁掉标签的问题。
调整观察角度和配色
默认仰角为 14 度,方位角为 55 度。
powershell
--elev 14 --azim 55曲线遮挡方向不理想时,可以小幅修改这两个数。一次调整五度到十度比较容易观察变化。色图默认使用脚本内置的低饱和蓝色,也可以换成 Matplotlib 提供的其他色图。
powershell
--cmap viridis颜色承担目标值编码,颜色条与 y 轴都按同一目标变量显示。用于论文时,建议保留连续且明度变化清楚的色图,避免彩虹色图带来的视觉断层。
一条适合长期复用的命令
下面这条命令覆盖了 Excel 工作表、目标列、目标单位、波长范围和多格式输出。以后只需替换输入文件路径和输出名称。
powershell
& "C:\Users\86195\.conda\envs\CNN\python.exe" `
  "G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\plot_raw_spectra_reusable.py" `
  --input "D:\spectral_data\batch_02.xlsx" `
  --sheet "原始光谱" `
  --target "Moisture_Content" `
  --target-label "Moisture content (%)" `
  --target-unit ratio `
  --wavelength-min 900 `
  --wavelength-max 1650 `
  --y-mode rank `
  --formats png svg pdf `
  --dpi 600 `
  --output-dir "D:\spectral_results\batch_02" `
  --output-name "batch_02_raw_spectra"
常见报错怎样处理
数据文件不存在
先检查盘符、文件夹名称和扩展名。Windows 资源管理器可能隐藏已知扩展名,看到的 data.xlsx 有时实际是 data.xlsx.xlsx。把文件完整路径复制到 PowerShell 中,再确认该路径能被找到。
找不到目标列
检查表头是否真的包含 Moisture_Content。前后空格、大小写差异和中文括号都会造成列名不一致。可以修改脚本顶部的 DEFAULT_TARGET_COLUMN,也可以用 --target 传入真实列名。
无法识别光谱列
至少需要两个可用光谱列。优先检查列名中是否包含波长,再检查光谱单元格能否转换为数字。合并单元格、多行表头和单位说明行都可能干扰 pandas 读取,运行前应整理成一行表头和一行一个样本的矩形数据表。
数据含缺失值或非数值
脚本不会静默删除异常行。回到原表查找空白、文本标记、无穷值和公式错误。缺失值如何处理会影响科研结论,应该在数据整理阶段明确决定,不能由绘图脚本临时猜测。
找不到 matplotlib
运行脚本的 Python 环境缺少绘图库。确认命令中的 python.exe 与安装依赖时使用的是同一个文件。当前 CNN 环境已经验证可运行,可以直接使用前文给出的完整解释器路径。
图中曲线过于拥挤
先保留 --y-mode rank,再适当调整 --elev 和 --azim。样本很多时,透明度与绘制顺序会影响可读性。当前脚本按远到近绘制曲线,并使用较低透明度,能够减轻前方曲线完全盖住后方曲线的情况。
出图以后检查什么
先核对终端输出中的样本数和波段数。它们应该与原表一致。当前文件的正确结果是 640 个样本和 1024 个波段。如果输出成了 1025 个波段,往往说明某个数值元数据列混了进去。
随后查看波长范围。当前文件应为 887.39 至 1702.46 nm。范围突然从 1 开始,通常说明脚本没有从表头提取到真实波长,已经退回到波段序号。
最后检查目标值。当前含水率应显示为 10.46% 至 22.41%。如果图上出现 0.1046 至 0.2241,需要检查 --target-unit。如果数值被放大了两次,输入表很可能已经使用百分数,却又指定了 ratio。
这些数字都对得上,图才与原始数据一致。以后每次换文件,先看终端里的四行信息,再看图片本身,通常一分钟就能发现路径、列名和单位方面的问题。
Python代码
python
#!/usr/bin/env python
# -*- coding: utf-8 -*-

"""可复用的原始光谱三维绘图脚本。

特点
----
1. 只绘制原始光谱,不调用任何预处理方法或项目内模块。
2. 支持 CSV、XLSX 和 XLS 文件。
3. 优先从列名中的 ``Wavelength``/``nm`` 自动识别光谱列及波长。
4. 可直接修改下方"常用配置",也可通过命令行临时覆盖配置。

最简单的用法
------------
直接运行(使用下方 DEFAULT_DATA_FILE)::

    python plot_raw_spectra_reusable.py

临时更换数据文件::

    python plot_raw_spectra_reusable.py --input "另一份数据.xlsx"

指定目标列、工作表和波长范围::

    python plot_raw_spectra_reusable.py --input "data.xlsx" \
        --sheet Sheet1 --target Moisture_Content --wavelength-min 900 \
        --wavelength-max 1700
"""

from __future__ import annotations

import argparse
import re
from pathlib import Path
from typing import Sequence

import matplotlib

matplotlib.use("Agg")

import matplotlib.cm as cm
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from matplotlib.colors import LinearSegmentedColormap, Normalize


# ============================================================================
# 常用配置:日后通常只需修改 DEFAULT_DATA_FILE(或运行时使用 --input)
# ============================================================================
DEFAULT_DATA_FILE = Path(
    r"G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\data_fs17"
    r"\before_drying_FS-17_up_complete_dataset.csv"
)
DEFAULT_TARGET_COLUMN = "Moisture_Content"
DEFAULT_OUTPUT_DIR = Path(
    r"G:\001_school\004_实验室\1_corn\0_毕设\0_code\data\raw_spectra_output"
)

# auto:目标值绝对值不超过 1.5 时按比例值处理并乘以 100,否则保持原值。
# ratio:始终乘以 100;percent/raw:保持原值。
DEFAULT_TARGET_UNIT = "auto"

# None 表示不裁剪波长,使用输入表内识别到的全部原始光谱波段。
DEFAULT_WAVELENGTH_MIN: float | None = None
DEFAULT_WAVELENGTH_MAX: float | None = None

# rank 会将曲线按目标值排序后等距展开,减少重叠;actual 使用真实目标值位置。
DEFAULT_Y_MODE = "rank"
DEFAULT_CMAP = "paper_like"
DEFAULT_FORMATS = ("png",)
DEFAULT_DPI = 300

ELEV = 14.0
AZIM = 55.0
LINE_WIDTH = 0.90
LINE_ALPHA = 0.32
Y_TICK_COUNT = 6
Z_PAD_RATIO = 0.05


PAPER_LIKE_CMAP = LinearSegmentedColormap.from_list(
    "paper_like",
    ["#002666", "#2c568c", "#5985b2", "#85b5d8", "#b2e5ff"],
    N=256,
)

WAVELENGTH_PATTERN = re.compile(
    r"(?:wavelength|wave(?:length)?|nm)[^0-9+-]*([+-]?\d+(?:\.\d+)?)",
    flags=re.IGNORECASE,
)
NUMERIC_HEADER_PATTERN = re.compile(r"^[+-]?\d+(?:\.\d+)?$")
ID_LIKE_PATTERN = re.compile(
    r"(?:^|[_\s-])(id|index|sample|seed|label)(?:$|[_\s-])",
    flags=re.IGNORECASE,
)


def build_parser() -> argparse.ArgumentParser:
    parser = argparse.ArgumentParser(
        description="读取 CSV/Excel 中的原始光谱并生成三维光谱图。"
    )
    parser.add_argument(
        "--input",
        type=Path,
        default=DEFAULT_DATA_FILE,
        help=f"输入 CSV/XLSX/XLS 文件(默认:{DEFAULT_DATA_FILE})。",
    )
    parser.add_argument(
        "--sheet",
        default="0",
        help="Excel 工作表名称或从 0 开始的序号;读取 CSV 时忽略(默认:0)。",
    )
    parser.add_argument(
        "--target",
        default=DEFAULT_TARGET_COLUMN,
        help=f"用于排序和着色的目标列(默认:{DEFAULT_TARGET_COLUMN})。",
    )
    parser.add_argument(
        "--target-label",
        default=None,
        help="图中 y 轴名称;省略时根据目标列与单位自动生成。",
    )
    parser.add_argument(
        "--target-unit",
        choices=("auto", "ratio", "percent", "raw"),
        default=DEFAULT_TARGET_UNIT,
        help="目标值单位。ratio 会乘 100;percent/raw 保持不变(默认:auto)。",
    )
    parser.add_argument(
        "--exclude-columns",
        default="",
        help="额外排除的非光谱列,多个列名用英文逗号分隔。",
    )
    parser.add_argument(
        "--wavelength-min",
        type=float,
        default=DEFAULT_WAVELENGTH_MIN,
        help="可选的最小波长;省略则不裁剪下限。",
    )
    parser.add_argument(
        "--wavelength-max",
        type=float,
        default=DEFAULT_WAVELENGTH_MAX,
        help="可选的最大波长;省略则不裁剪上限。",
    )
    parser.add_argument(
        "--y-mode",
        choices=("rank", "actual"),
        default=DEFAULT_Y_MODE,
        help="rank 等距展开曲线,actual 使用真实目标值位置(默认:rank)。",
    )
    parser.add_argument(
        "--output-dir",
        type=Path,
        default=DEFAULT_OUTPUT_DIR,
        help=f"输出目录(默认:{DEFAULT_OUTPUT_DIR})。",
    )
    parser.add_argument(
        "--output-name",
        default=None,
        help="不含扩展名的输出文件名(默认:输入文件名_raw_spectra_3d)。",
    )
    parser.add_argument(
        "--formats",
        nargs="+",
        choices=("png", "svg", "pdf", "tiff"),
        default=list(DEFAULT_FORMATS),
        help="输出格式,可同时指定多个(默认:png)。",
    )
    parser.add_argument("--dpi", type=int, default=DEFAULT_DPI, help="位图分辨率。")
    parser.add_argument("--cmap", default=DEFAULT_CMAP, help="Matplotlib 色图名称。")
    parser.add_argument("--elev", type=float, default=ELEV, help="三维视角仰角。")
    parser.add_argument("--azim", type=float, default=AZIM, help="三维视角方位角。")
    return parser


def parse_sheet(value: str) -> str | int:
    """将纯整数工作表参数转为序号,其余内容作为工作表名称。"""
    try:
        return int(value)
    except ValueError:
        return value


def read_table(data_file: Path, sheet: str | int = 0) -> pd.DataFrame:
    """读取 CSV 或 Excel 表格。"""
    data_file = data_file.expanduser().resolve()
    if not data_file.is_file():
        raise FileNotFoundError(f"数据文件不存在:{data_file}")

    suffix = data_file.suffix.lower()
    if suffix == ".csv":
        try:
            return pd.read_csv(data_file, encoding="utf-8-sig")
        except UnicodeDecodeError:
            return pd.read_csv(data_file, encoding="gbk")
    if suffix in {".xlsx", ".xls"}:
        return pd.read_excel(data_file, sheet_name=sheet)
    raise ValueError(f"不支持的文件格式:{suffix};请使用 CSV、XLSX 或 XLS。")


def wavelength_from_header(column: object) -> float | None:
    """从常见光谱列名中提取波长,不把 Seed_ID 等数字误当成波长。"""
    if isinstance(column, (int, float)) and not isinstance(column, bool):
        return float(column)

    name = str(column).strip()
    if NUMERIC_HEADER_PATTERN.fullmatch(name):
        return float(name)

    match = WAVELENGTH_PATTERN.search(name)
    if match:
        return float(match.group(1))
    return None


def detect_spectral_columns(
    df: pd.DataFrame,
    target_column: str,
    excluded_columns: Sequence[str] = (),
) -> tuple[list[object], np.ndarray, str]:
    """识别光谱列,返回列名、波长和识别方式说明。"""
    excluded = {target_column, *excluded_columns}
    parsed: list[tuple[object, float]] = []

    for column in df.columns:
        if str(column) in excluded or column in excluded:
            continue
        wavelength = wavelength_from_header(column)
        if wavelength is not None:
            parsed.append((column, wavelength))

    if len(parsed) >= 2:
        parsed.sort(key=lambda item: item[1])
        columns = [column for column, _ in parsed]
        wavelengths = np.asarray([wave for _, wave in parsed], dtype=float)
        return columns, wavelengths, "从列名自动提取波长"

    # 对没有波长列名的表,退回到所有数值列,并以波段序号作为横坐标。
    fallback_columns: list[object] = []
    for column in df.columns:
        name = str(column)
        if name in excluded or column in excluded or ID_LIKE_PATTERN.search(name):
            continue
        converted = pd.to_numeric(df[column], errors="coerce")
        if converted.notna().all():
            fallback_columns.append(column)

    if len(fallback_columns) < 2:
        raise ValueError(
            "无法识别至少两个光谱列。建议将光谱列命名为 "
            "'Band_1_Wavelength_900.0' 或直接使用数值波长作为列名。"
        )

    wavelengths = np.arange(1, len(fallback_columns) + 1, dtype=float)
    return fallback_columns, wavelengths, "未找到波长列名,使用波段序号"


def load_raw_spectra(
    data_file: Path,
    sheet: str | int,
    target_column: str,
    excluded_columns: Sequence[str],
) -> tuple[np.ndarray, np.ndarray, np.ndarray, list[object], str]:
    """加载原始光谱矩阵、目标值和波长。"""
    df = read_table(data_file, sheet=sheet)
    if target_column not in df.columns:
        preview = ", ".join(map(str, df.columns[:10]))
        raise ValueError(
            f"数据中未找到目标列 '{target_column}'。前 10 个列名为:{preview}"
        )

    spectral_columns, wavelengths, detection_note = detect_spectral_columns(
        df,
        target_column=target_column,
        excluded_columns=excluded_columns,
    )

    spectra_df = df[spectral_columns].apply(pd.to_numeric, errors="coerce")
    target_series = pd.to_numeric(df[target_column], errors="coerce")

    invalid_spectra = ~np.isfinite(spectra_df.to_numpy(dtype=float))
    invalid_target = ~np.isfinite(target_series.to_numpy(dtype=float))
    if invalid_spectra.any() or invalid_target.any():
        bad_spectral_rows = int(np.any(invalid_spectra, axis=1).sum())
        bad_target_rows = int(invalid_target.sum())
        raise ValueError(
            "数据含缺失值或非数值:"
            f"光谱异常行 {bad_spectral_rows},目标列异常行 {bad_target_rows}。"
        )

    return (
        spectra_df.to_numpy(dtype=float),
        target_series.to_numpy(dtype=float),
        wavelengths,
        spectral_columns,
        detection_note,
    )


def crop_wavelengths(
    spectra: np.ndarray,
    wavelengths: np.ndarray,
    wavelength_min: float | None,
    wavelength_max: float | None,
) -> tuple[np.ndarray, np.ndarray]:
    """按可选上下限裁剪原始光谱波段。"""
    lower = -np.inf if wavelength_min is None else wavelength_min
    upper = np.inf if wavelength_max is None else wavelength_max
    if lower > upper:
        raise ValueError("wavelength-min 不能大于 wavelength-max。")

    mask = (wavelengths >= lower) & (wavelengths <= upper)
    if not np.any(mask):
        raise ValueError(
            f"波长范围 [{lower}, {upper}] 内没有数据;"
            f"当前数据范围为 [{wavelengths.min()}, {wavelengths.max()}]。"
        )
    return spectra[:, mask], wavelengths[mask]


def scale_target(values: np.ndarray, unit: str) -> tuple[np.ndarray, bool]:
    """按配置处理目标值单位,返回转换后数值及是否转换成百分数。"""
    if unit == "ratio":
        return values * 100.0, True
    if unit in {"percent", "raw"}:
        return values.copy(), unit == "percent"

    should_scale = float(np.nanmax(np.abs(values))) <= 1.5
    return (values * 100.0, True) if should_scale else (values.copy(), False)


def make_target_label(column: str, requested_label: str | None, is_percent: bool) -> str:
    if requested_label:
        return requested_label
    label = column.replace("_", " ").strip()
    if is_percent:
        label += " (%)"
    return label[:1].upper() + label[1:]


def setup_style() -> None:
    plt.style.use("seaborn-v0_8-whitegrid")
    matplotlib.rcParams.update(
        {
            "font.family": "sans-serif",
            "font.sans-serif": [
                "Arial",
                "Helvetica",
                "DejaVu Sans",
                "Microsoft YaHei",
                "SimHei",
            ],
            "axes.unicode_minus": False,
            "axes.facecolor": "white",
            "figure.facecolor": "white",
            "axes.linewidth": 0.8,
            "svg.fonttype": "none",
            "pdf.fonttype": 42,
        }
    )


def resolve_cmap(cmap_name: str):
    if cmap_name.lower() == "paper_like":
        return PAPER_LIKE_CMAP
    return matplotlib.colormaps.get_cmap(cmap_name)


def style_3d_axis(ax: plt.Axes) -> None:
    background = (1.0, 1.0, 1.0, 1.0)
    pane_edge = (0.55, 0.55, 0.55, 1.0)
    grid_color = (0.82, 0.82, 0.82, 0.65)
    axis_color = (0.35, 0.35, 0.35, 1.0)
    ax.set_facecolor(background)

    for axis in (ax.xaxis, ax.yaxis, ax.zaxis):
        axis.pane.set_facecolor(background)
        axis.pane.set_edgecolor(pane_edge)
        axis.pane.fill = True
        axis._axinfo["grid"]["color"] = grid_color

    ax.xaxis.line.set_color(axis_color)
    ax.yaxis.line.set_color(axis_color)
    ax.zaxis.line.set_color(axis_color)
    ax.tick_params(axis="both", which="major", labelsize=8)
    ax.tick_params(axis="z", which="major", labelsize=8)
    ax.set_box_aspect((1.3, 1.3, 1.0))


def dynamic_limits(values: np.ndarray, pad_ratio: float = Z_PAD_RATIO) -> tuple[float, float]:
    vmin = float(np.min(values))
    vmax = float(np.max(values))
    if np.isclose(vmin, vmax):
        pad = max(abs(vmin) * pad_ratio, 1e-6)
    else:
        pad = (vmax - vmin) * pad_ratio
    return vmin - pad, vmax + pad


def linear_ticks(vmin: float, vmax: float, count: int) -> np.ndarray:
    if np.isclose(vmin, vmax):
        return np.asarray([vmin])
    return np.linspace(vmin, vmax, min(count, max(2, count)))


def display_positions(target_sorted: np.ndarray, mode: str) -> np.ndarray:
    if mode == "actual":
        return target_sorted.copy()
    return np.arange(len(target_sorted), dtype=float)


def y_ticks_and_labels(
    display_y: np.ndarray,
    target_sorted: np.ndarray,
    count: int = Y_TICK_COUNT,
) -> tuple[np.ndarray, list[str]]:
    if len(display_y) == 1:
        return display_y.copy(), [f"{target_sorted[0]:.2f}"]
    indices = np.unique(np.linspace(0, len(display_y) - 1, count).round().astype(int))
    return display_y[indices], [f"{target_sorted[i]:.2f}" for i in indices]


def plot_raw_spectra_3d(
    spectra: np.ndarray,
    target: np.ndarray,
    wavelengths: np.ndarray,
    target_label: str,
    y_mode: str,
    cmap_name: str,
    elev: float,
    azim: float,
) -> plt.Figure:
    """创建原始光谱三维图,不修改输入光谱数值。"""
    order = np.argsort(target, kind="stable")
    spectra_sorted = spectra[order]
    target_sorted = target[order]
    display_y = display_positions(target_sorted, y_mode)

    cmap = resolve_cmap(cmap_name).reversed()
    target_min = float(target_sorted.min())
    target_max = float(target_sorted.max())
    if np.isclose(target_min, target_max):
        norm = Normalize(vmin=target_min - 0.5, vmax=target_max + 0.5)
    else:
        norm = Normalize(vmin=target_min, vmax=target_max)

    fig = plt.figure(figsize=(8.4, 5.4), dpi=150)
    ax = fig.add_subplot(1, 1, 1, projection="3d")

    for index in np.argsort(display_y)[::-1]:
        ax.plot(
            wavelengths,
            np.full_like(wavelengths, display_y[index], dtype=float),
            spectra_sorted[index],
            color=cmap(norm(target_sorted[index])),
            linewidth=LINE_WIDTH,
            alpha=LINE_ALPHA,
        )

    x_min, x_max = float(wavelengths.min()), float(wavelengths.max())
    y_min, y_max = float(display_y.min()), float(display_y.max())
    if np.isclose(y_min, y_max):
        y_min, y_max = y_min - 0.5, y_max + 0.5
    z_min, z_max = dynamic_limits(spectra_sorted)

    ax.set_xlabel("Wavelength (nm)", labelpad=8, fontsize=9)
    ax.set_ylabel(target_label, labelpad=10, fontsize=9)
    # 3D z 轴标签在部分 Matplotlib 版本中会被 tight bbox 错误裁切;
    # 使用轴坐标放置等价的二维标签,保证导出图片中完整可见。
    ax.set_zlabel("")
    ax.text2D(
        -0.075,
        0.50,
        "Raw spectral value",
        transform=ax.transAxes,
        rotation=90,
        va="center",
        ha="center",
        fontsize=9,
    )
    ax.set_xlim(x_max, x_min)
    ax.set_ylim(y_max, y_min)
    ax.set_zlim(z_min, z_max)
    ax.set_xticks(linear_ticks(x_min, x_max, 4))

    tick_positions, tick_labels = y_ticks_and_labels(display_y, target_sorted)
    ax.set_yticks(tick_positions)
    ax.set_yticklabels(tick_labels)
    ax.set_zticks(linear_ticks(z_min, z_max, 6))
    ax.view_init(elev=elev, azim=azim)
    style_3d_axis(ax)

    scalar_mappable = cm.ScalarMappable(norm=norm, cmap=cmap)
    scalar_mappable.set_array([])
    colorbar = fig.colorbar(
        scalar_mappable,
        ax=ax,
        fraction=0.015,
        pad=0.01,
        shrink=0.52,
    )
    colorbar.set_label(target_label, fontsize=9)
    colorbar.set_ticks(linear_ticks(target_min, target_max, Y_TICK_COUNT))
    colorbar.ax.invert_yaxis()
    colorbar.ax.tick_params(labelsize=8)
    colorbar.outline.set_linewidth(0.8)
    return fig


def save_figure(
    fig: plt.Figure,
    output_dir: Path,
    output_name: str,
    formats: Sequence[str],
    dpi: int,
) -> list[Path]:
    output_dir = output_dir.expanduser().resolve()
    output_dir.mkdir(parents=True, exist_ok=True)
    saved: list[Path] = []
    for file_format in dict.fromkeys(formats):
        path = output_dir / f"{output_name}.{file_format}"
        save_kwargs = {"bbox_inches": "tight"}
        if file_format in {"png", "tiff"}:
            save_kwargs["dpi"] = dpi
        fig.savefig(path, **save_kwargs)
        saved.append(path)
    return saved


def main() -> None:
    args = build_parser().parse_args()
    input_file = args.input.expanduser().resolve()
    excluded_columns = [
        item.strip() for item in args.exclude_columns.split(",") if item.strip()
    ]

    spectra, target, wavelengths, spectral_columns, detection_note = load_raw_spectra(
        data_file=input_file,
        sheet=parse_sheet(args.sheet),
        target_column=args.target,
        excluded_columns=excluded_columns,
    )
    spectra, wavelengths = crop_wavelengths(
        spectra,
        wavelengths,
        wavelength_min=args.wavelength_min,
        wavelength_max=args.wavelength_max,
    )
    target_for_plot, is_percent = scale_target(target, args.target_unit)
    target_label = make_target_label(args.target, args.target_label, is_percent)

    setup_style()
    fig = plot_raw_spectra_3d(
        spectra=spectra,
        target=target_for_plot,
        wavelengths=wavelengths,
        target_label=target_label,
        y_mode=args.y_mode,
        cmap_name=args.cmap,
        elev=args.elev,
        azim=args.azim,
    )
    output_name = args.output_name or f"{input_file.stem}_raw_spectra_3d"
    saved_files = save_figure(
        fig,
        output_dir=args.output_dir,
        output_name=output_name,
        formats=args.formats,
        dpi=args.dpi,
    )
    plt.close(fig)

    print("=== 原始光谱绘图完成 ===")
    print(f"输入文件:{input_file}")
    print(f"目标列:{args.target}")
    print(f"样本数:{spectra.shape[0]}")
    print(f"光谱列数:{len(spectral_columns)};绘图波段数:{spectra.shape[1]}")
    print(f"波长范围:{wavelengths.min():.2f}--{wavelengths.max():.2f}")
    print(f"光谱列识别:{detection_note}")
    print("预处理:无(直接使用输入表中的原始光谱值)")
    print("输出文件:")
    for path in saved_files:
        print(f"  - {path}")


if __name__ == "__main__":
main()复现代码仓库:https://github.com/kaixin-aa/figure-code/tree/main/examples/002-raw-spectra-3d