注意:该项目只展示部分功能,如需了解,文末咨询即可。
本文目录
- [1 开发环境](#1 开发环境)
- [2 系统设计](#2 系统设计)
- [3 系统展示](#3 系统展示)
- [3.1 功能展示视频](#3.1 功能展示视频)
- [3.2 大屏页面](#3.2 大屏页面)
- [3.3 语义识别页面](#3.3 语义识别页面)
- [3.4 分析页面](#3.4 分析页面)
- [3.5 基础页面](#3.5 基础页面)
- [4 更多推荐](#4 更多推荐)
- [5 部分功能代码](#5 部分功能代码)
1 开发环境
发语言:python
采用技术:Spark、Hadoop、Django、Vue、Echarts等技术框架
数据库:MySQL
开发环境:PyCharm
2 系统设计
电信网络诈骗已成为当前社会治理中危害最广、增长最快的犯罪形态之一,诈骗分子借助社交工程话术对受害人实施心理操控,其话术文本蕴含丰富的语义诱饵模式与诱导行为路径。现有反诈研究多聚焦于号码黑名单、资金流追踪或单一统计特征,缺乏从文本语义层面对诈骗话术进行系统性解构与模式挖掘的有效手段。随着大数据技术的成熟,基于Hadoop分布式存储与Spark并行计算框架的海量文本处理能力,为从语义粒度深入剖析诈骗话术的内在结构提供了技术可行性。本系统以五类典型诈骗话术(正常短信、公检法诈骗、贷款诈骗、冒充客服、冒充领导熟人)为分析对象,融合分布式计算、机器学习分类与可视化分析技术,构建面向反诈场景的话术语义特征挖掘与分析平台。
基于机器学习的电信网络诈骗话术语义识别与可视化分析系统统围绕电信网络诈骗话术的语义特征挖掘、模式识别与智能分类展开研究,基于Hadoop分布式存储与PySpark并行计算框架,对五类标注语料进行全流程预处理与多维度特征量化,构建涵盖诱饵信号、诱导动作、句式结构在内的语义特征指标体系;在此基础上,运用关联规则挖掘揭示复合诱饵共现规律,通过聚类分析实现风险话术的自动分群,利用TF-IDF提取各类别的风险关键词,形成从底层特征到高层模式的完整语义画像;进一步集成XGBoost分类器完成诈骗类型的自动识别与评估验证,最终以结构化表格输出全部分析结果,为反诈语义研判提供数据驱动的技术方案。具体研究内容包括:
HDFS数据上传与预处理:将五类诈骗话术CSV文件上传至HDFS分布式存储,完成多编码格式合并、中文类型统一映射、缺失值清洗及长度分箱,派生诱饵命中标记、诱导动作标记、数字密度与标点计数等语义特征,生成标准化的分析宽表。
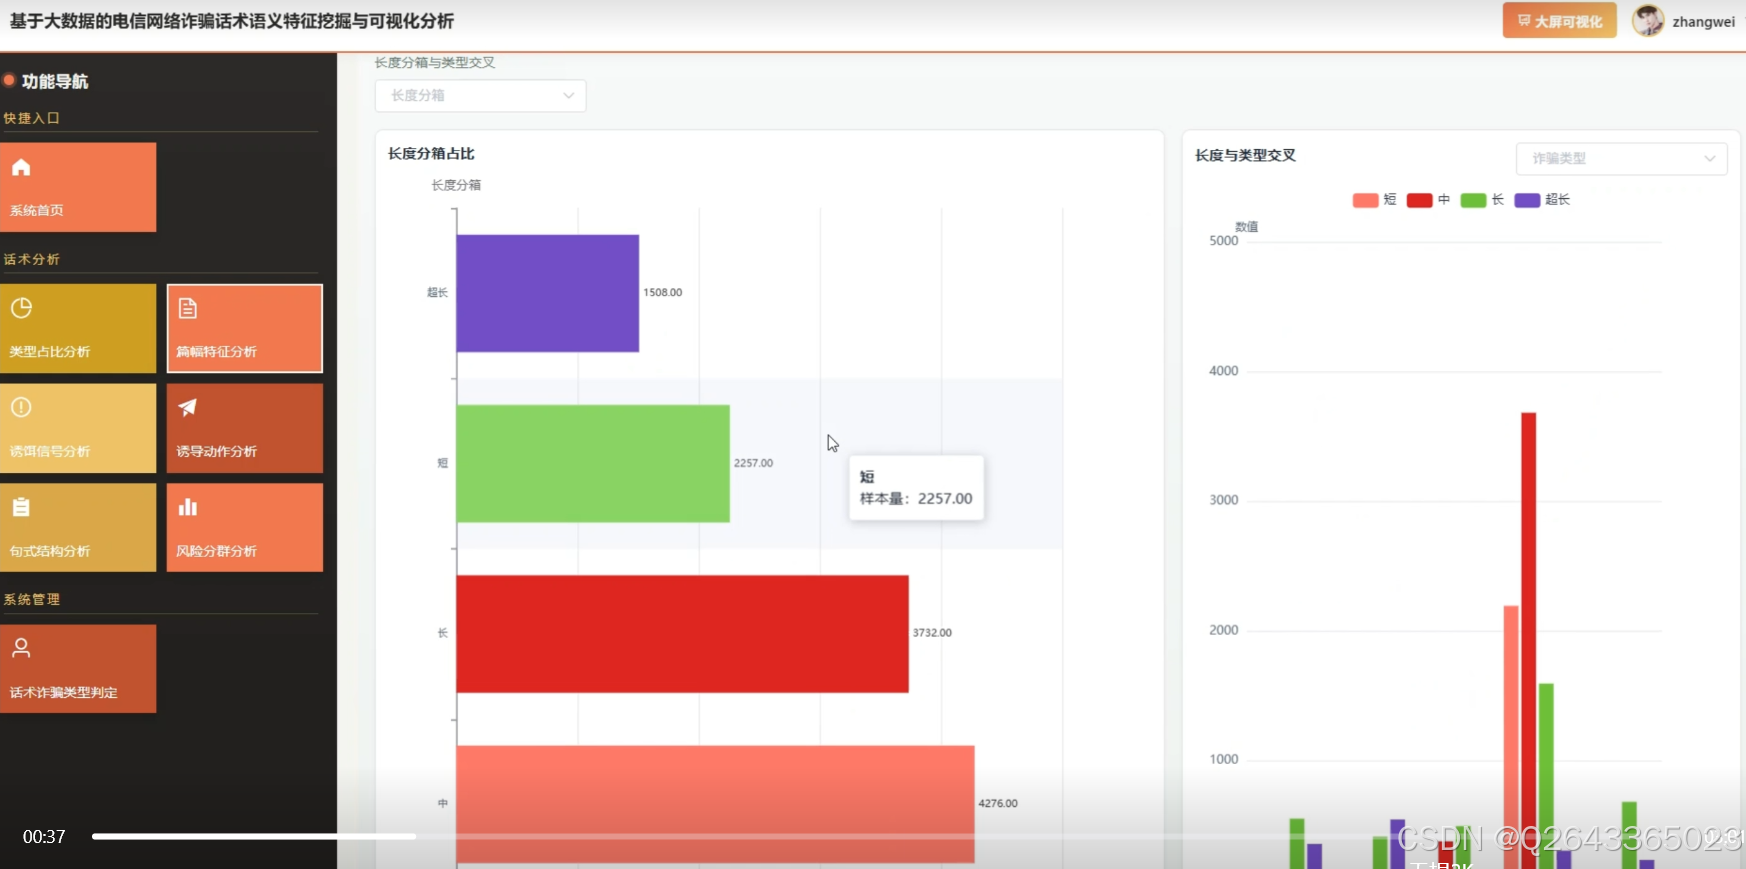
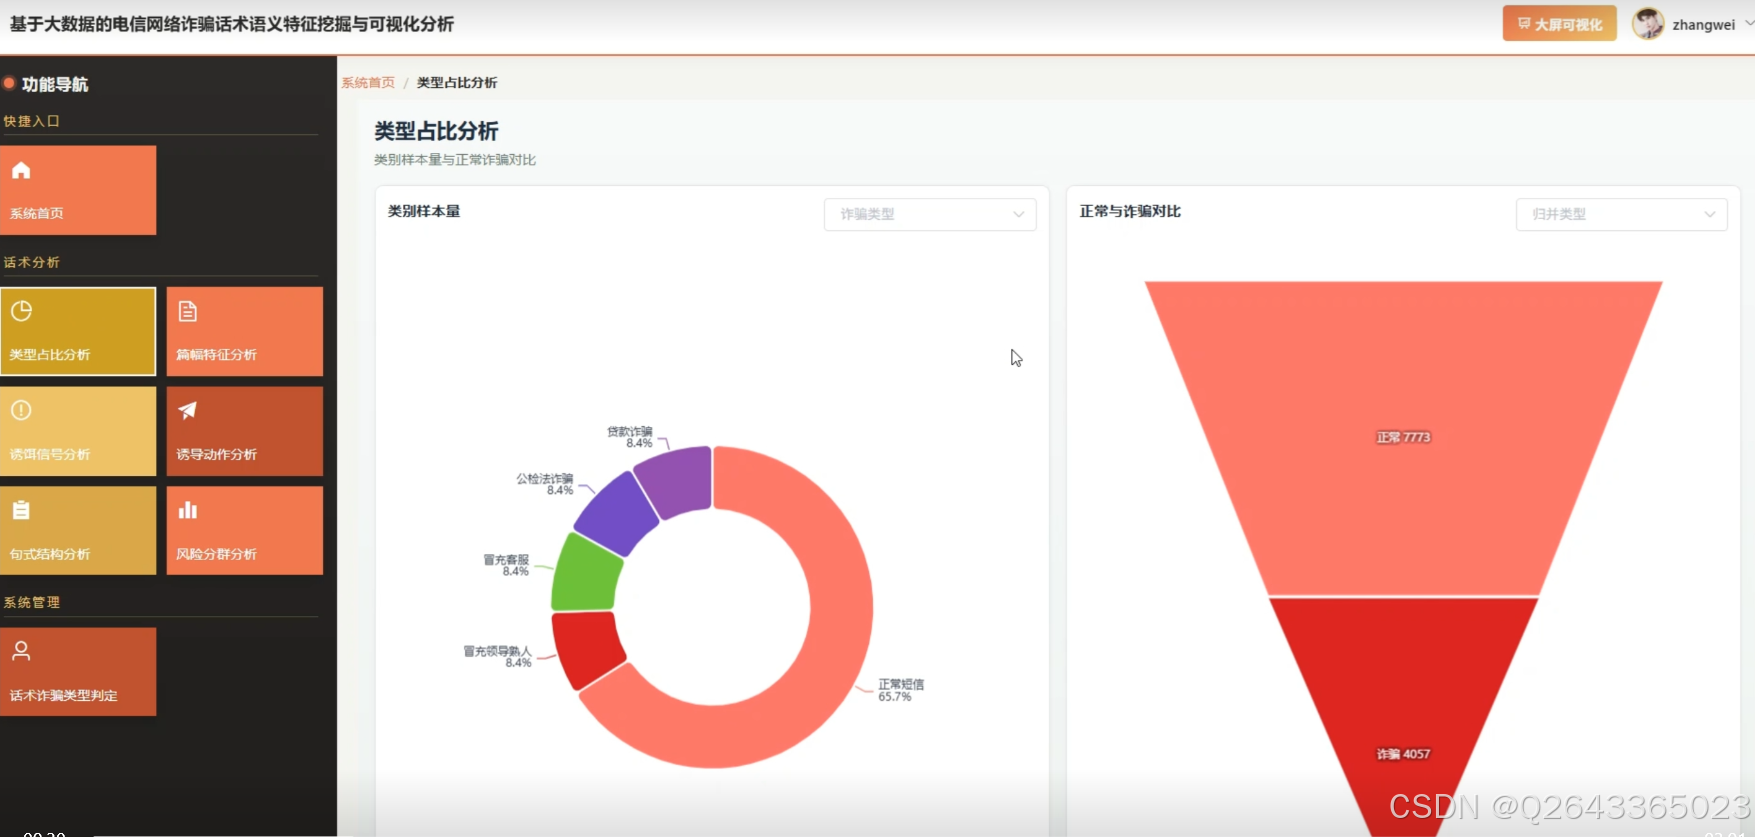
类型占比与篇幅特征分析:统计五类话术的样本量占比及正常/诈骗二分类对比,计算各长度分箱(短/中/长/超长)的分布比例,交叉分析不同类型在不同篇幅区间的聚集规律,揭示诈骗话术的文本规模偏好。
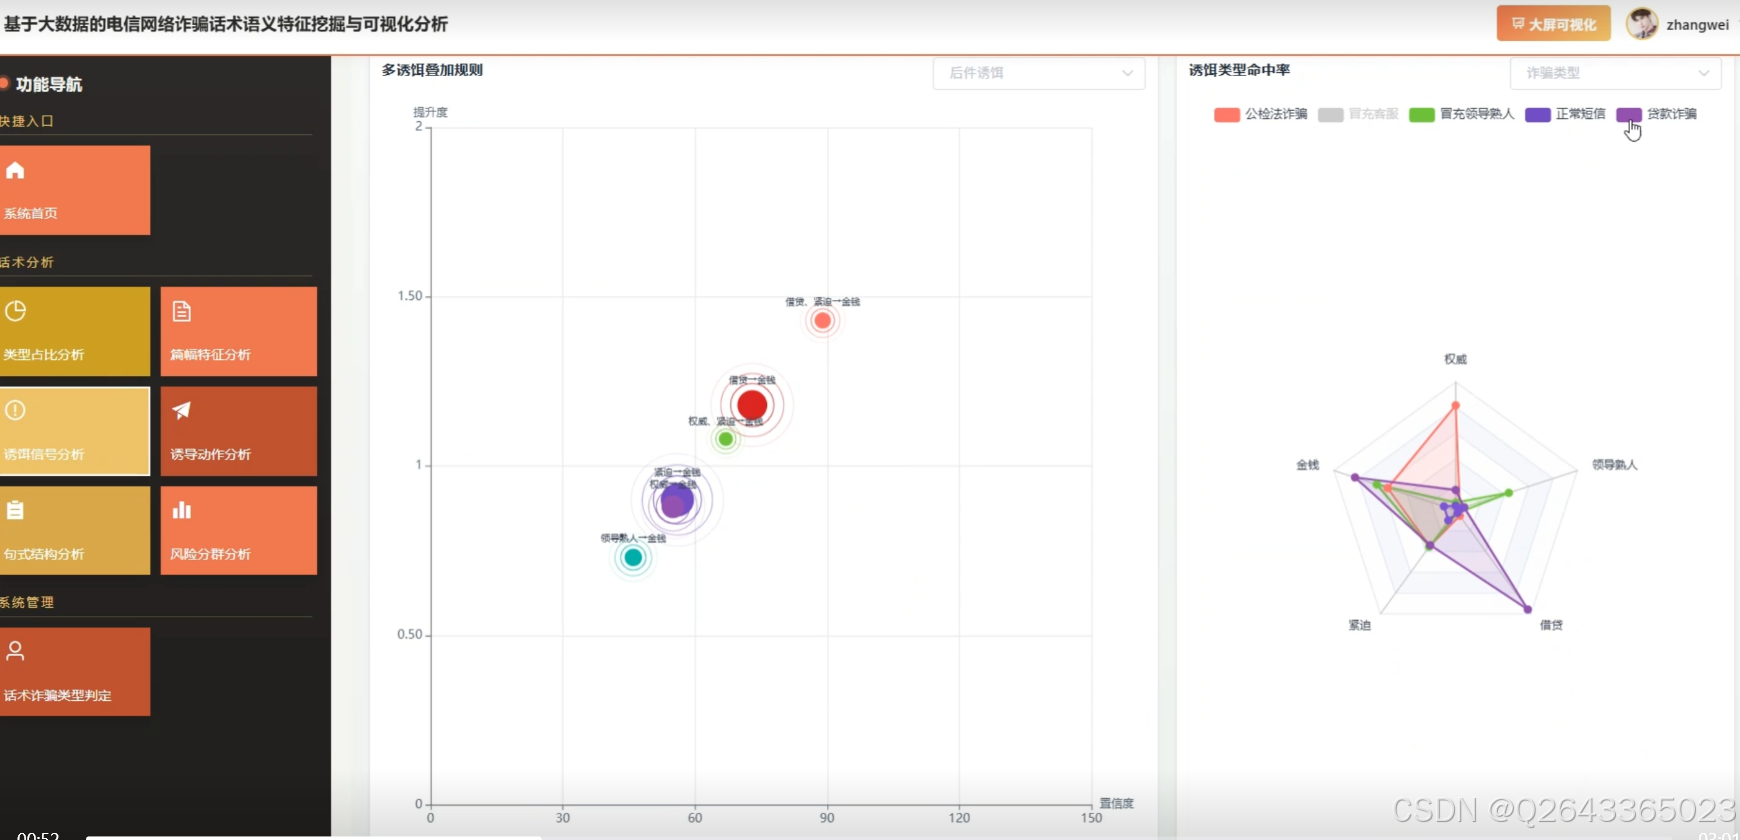
诱饵信号模式挖掘:按诈骗类型统计权威、紧迫、借贷、金钱、领导熟人五类诱饵的命中率,运用FP-Growth算法挖掘多诱饵复合出现的频繁项集与关联规则(置信度与提升度),揭示诈骗话术中的典型诱饵组合模式。
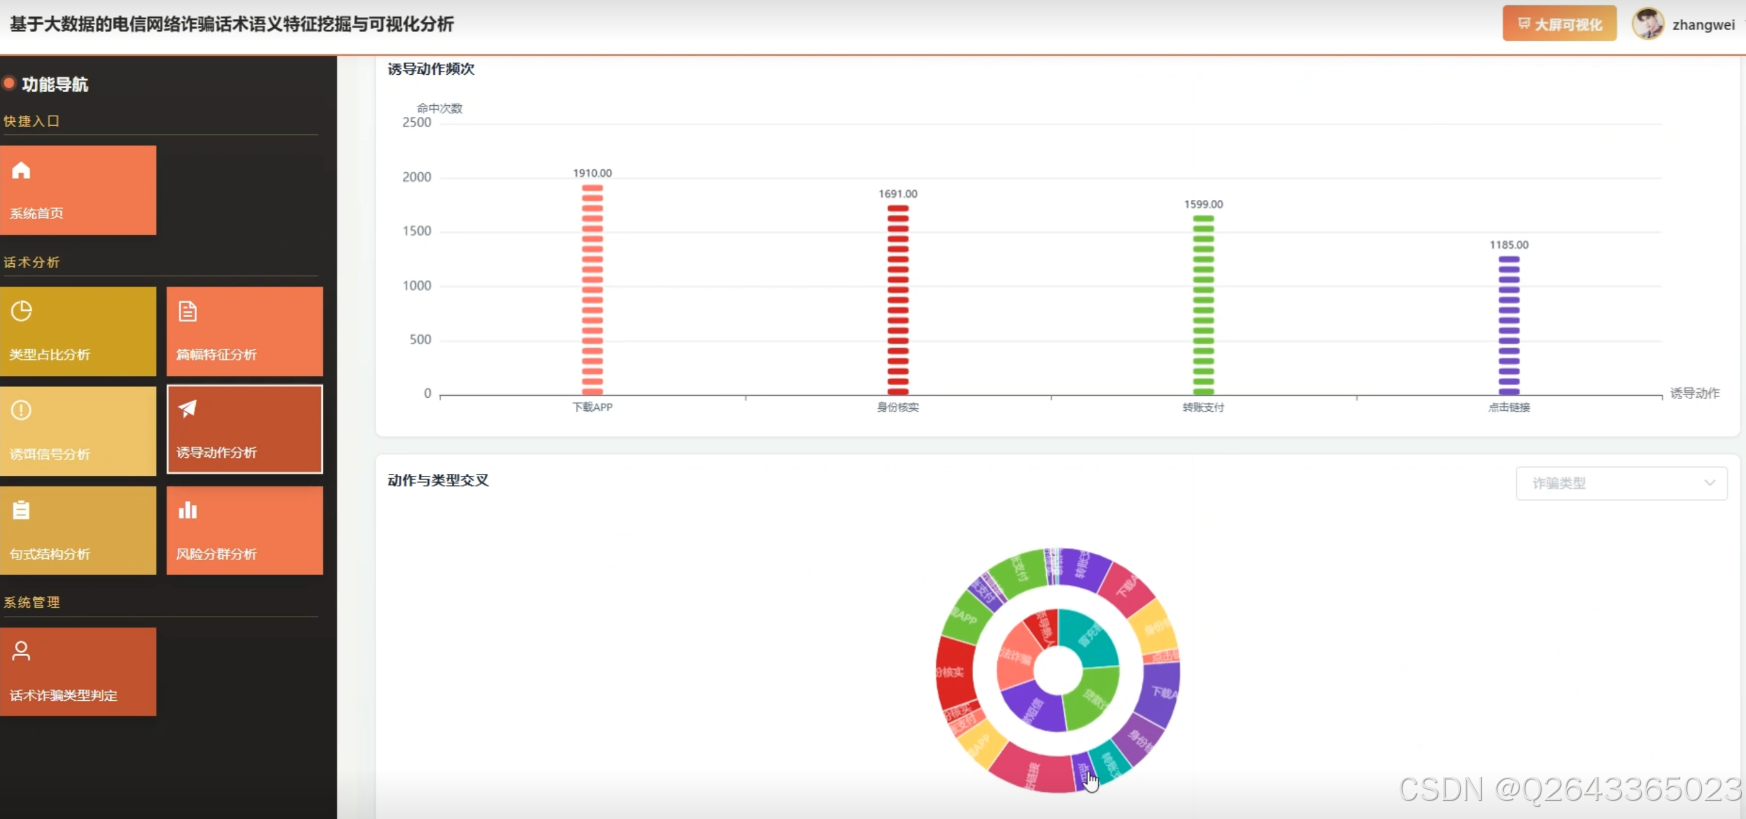
诱导动作行为分析:统计点击链接、下载APP、转账支付、身份核实四类诱导动作的全局频次与命中率,交叉分析各诈骗类型偏好的诱导动作,还原不同类型话术的典型诱导路径。
句式结构量化分析:按类型统计标点计数与标点密度均值、数字密度均值及极值分布,从标点使用习惯与数字信息密度两个维度刻画不同类型话术的句式结构差异,补充句式形态层面的量化证据。
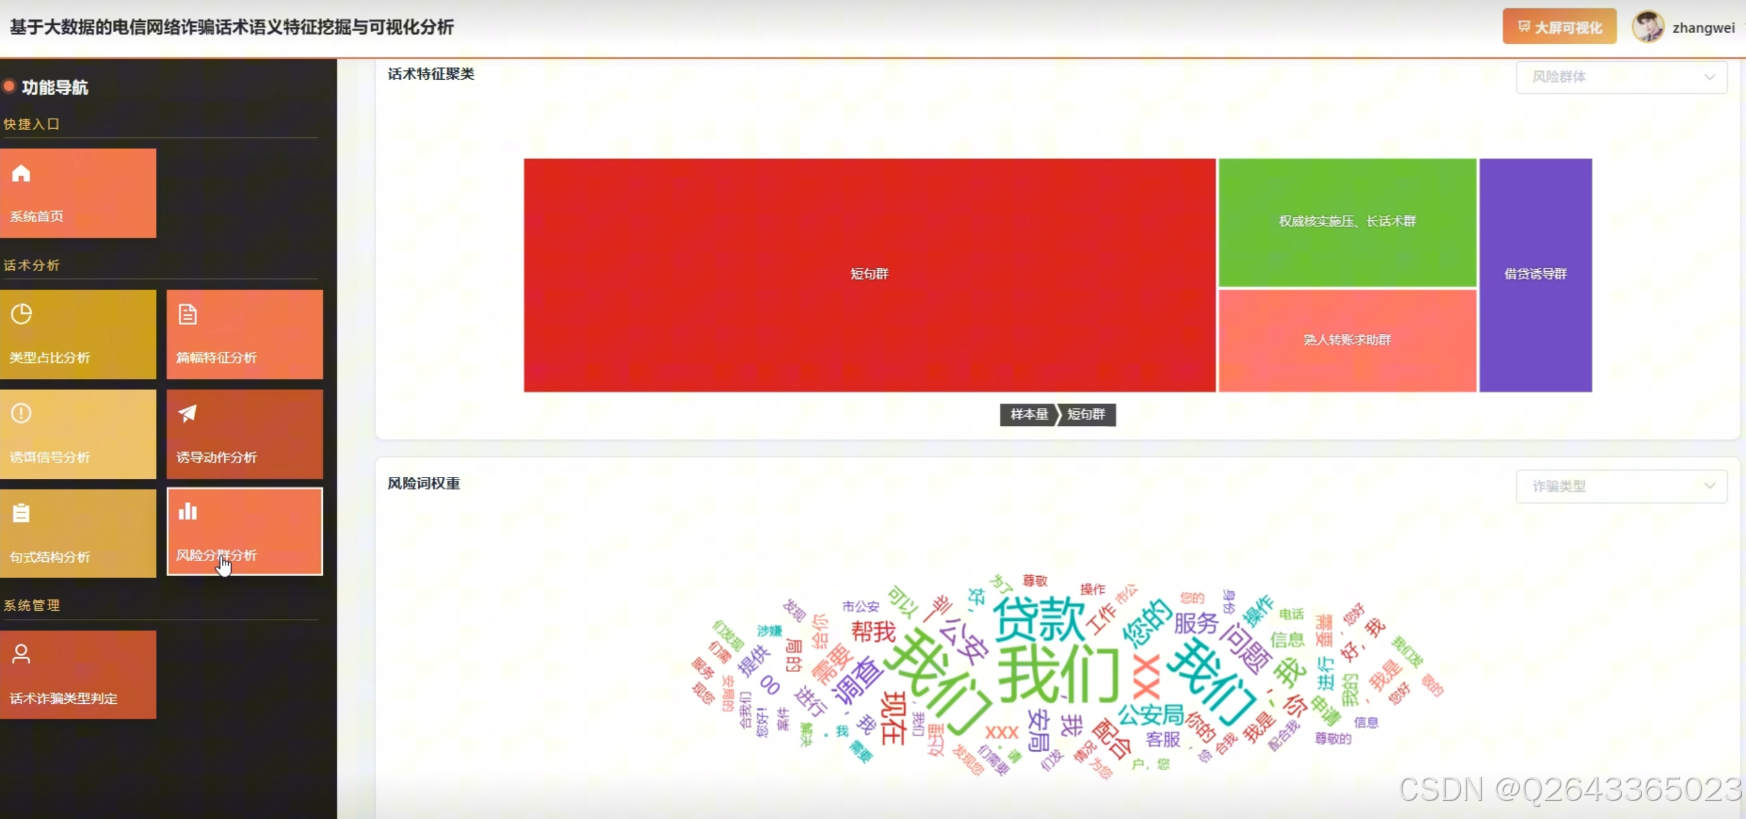
风险分群与词权重分析:选取文本长度、诱饵计数、五类诱饵标记、四类动作标记共13维数值特征,经标准化后运用K-Means聚类(轮廓系数自动选择K值)实现话术风险分群并赋予语义标签;对各诈骗类型文本提取字符级TF-IDF高权重词,构建类型风险词画像,支撑语义层面的精细研判。
XGBoost五分类模型构建:对数值特征进行中位数填补与标准化、分类特征进行One-Hot编码,构建XGBoost多分类器,基于训练/测试集划分完成模型训练与超参优化,输出准确率、宏平均F1分数、混淆矩阵等评估指标,实现诈骗类型的自动判别。
3 系统展示
3.1 功能展示视频
基Spark大数据的电信网络诈骗话术语义识别与可视化分析源码
!!!请点击这里查看功能演示!!!
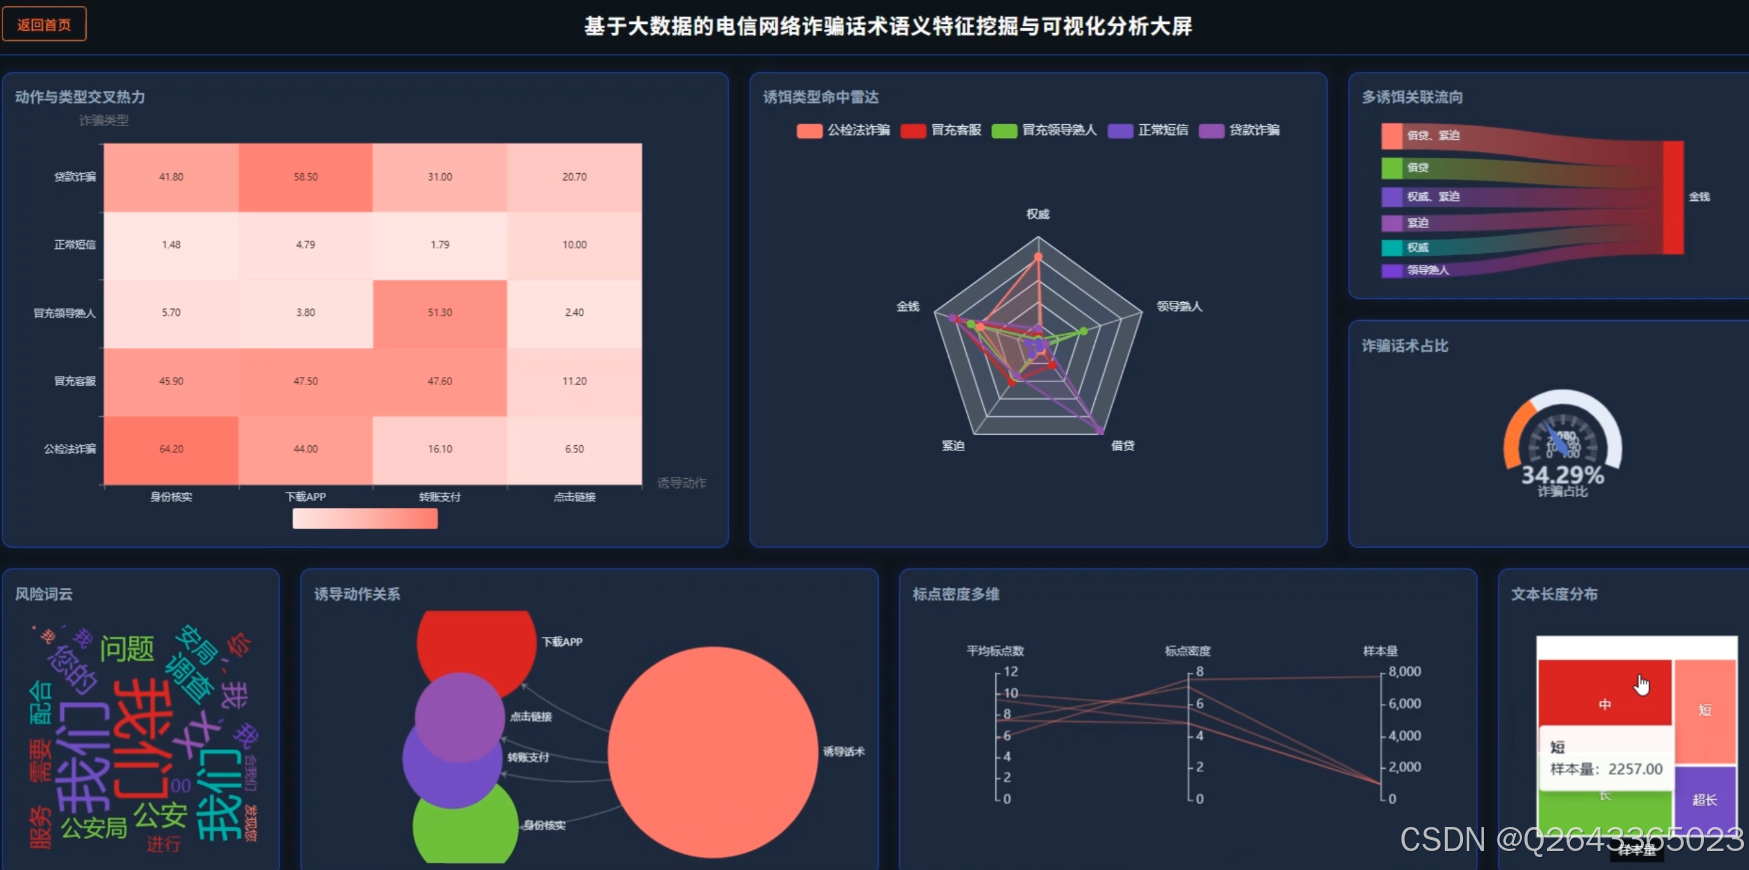
3.2 大屏页面
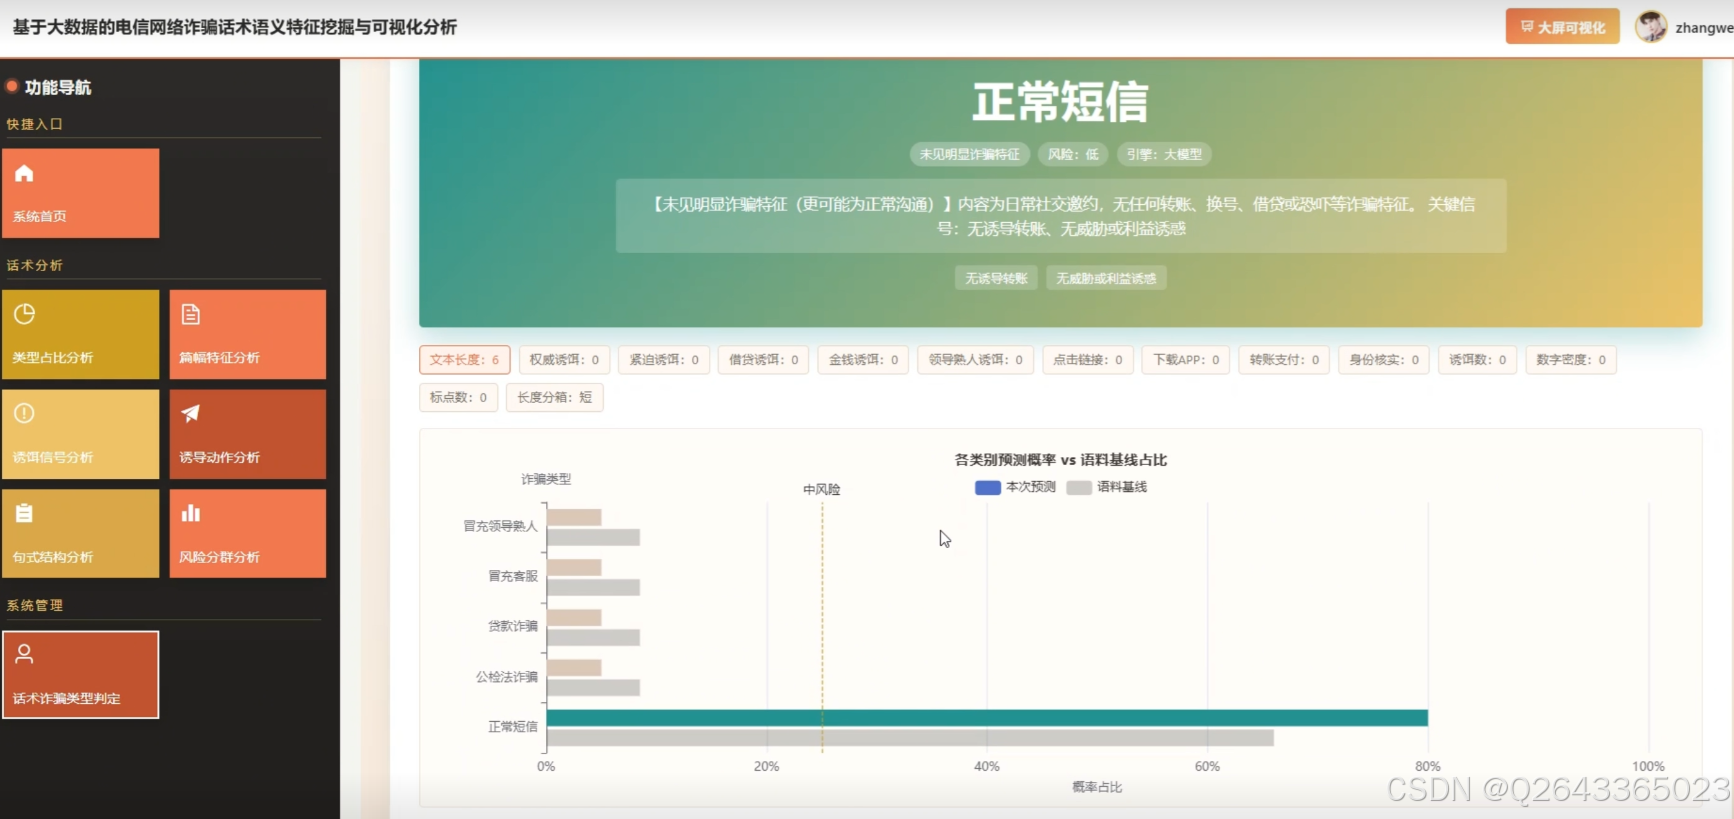
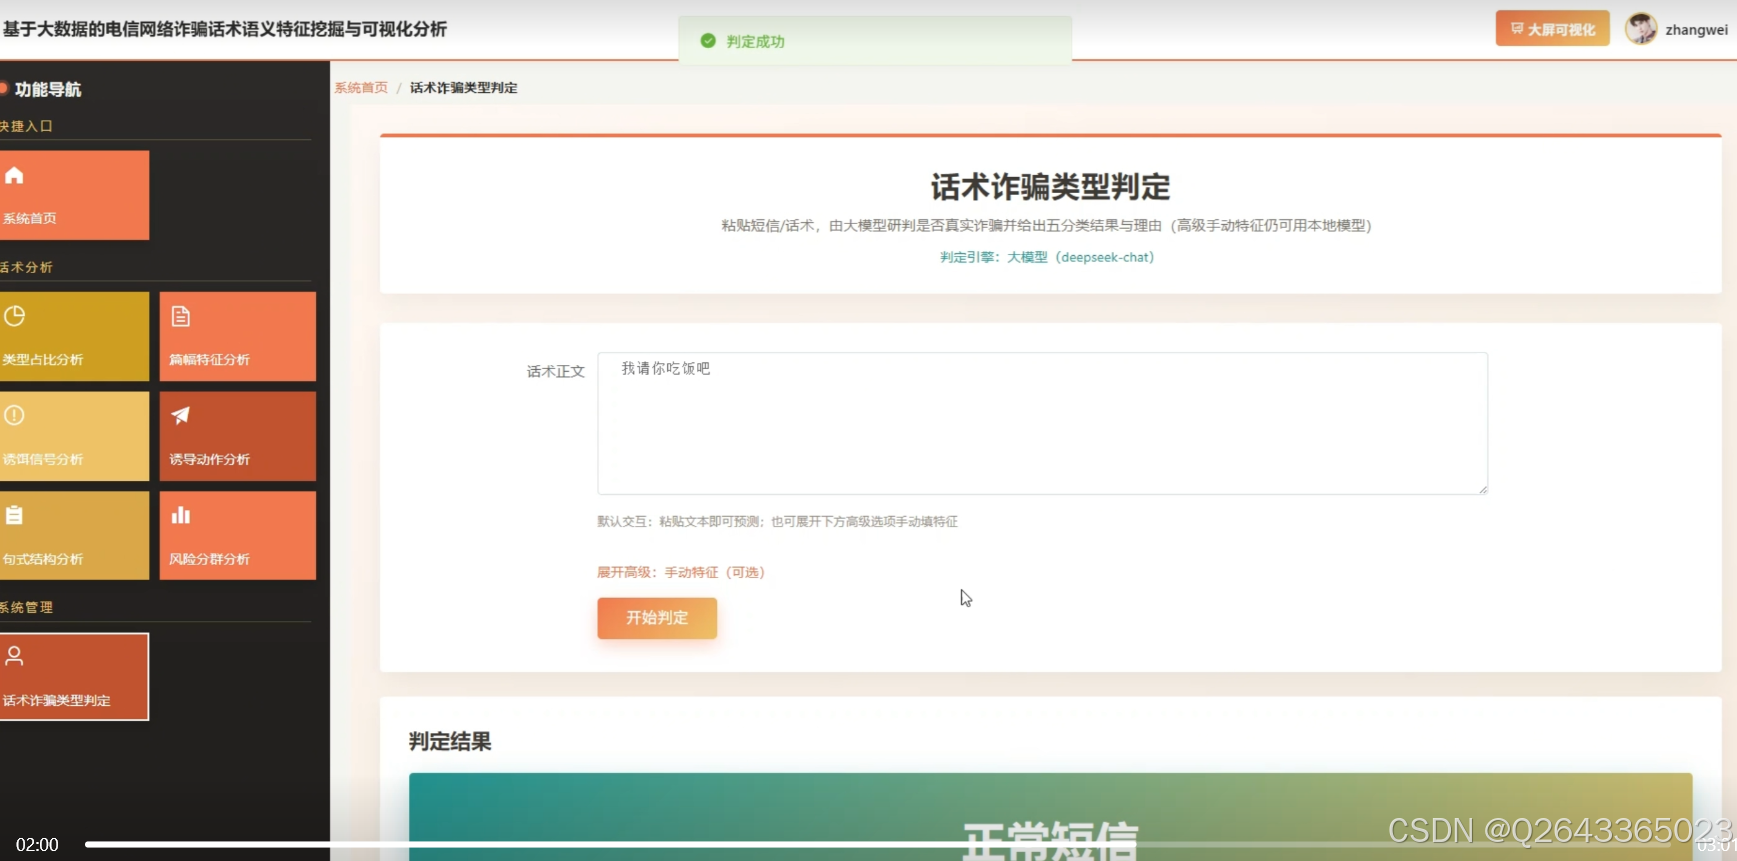
3.3 语义识别页面
3.4 分析页面
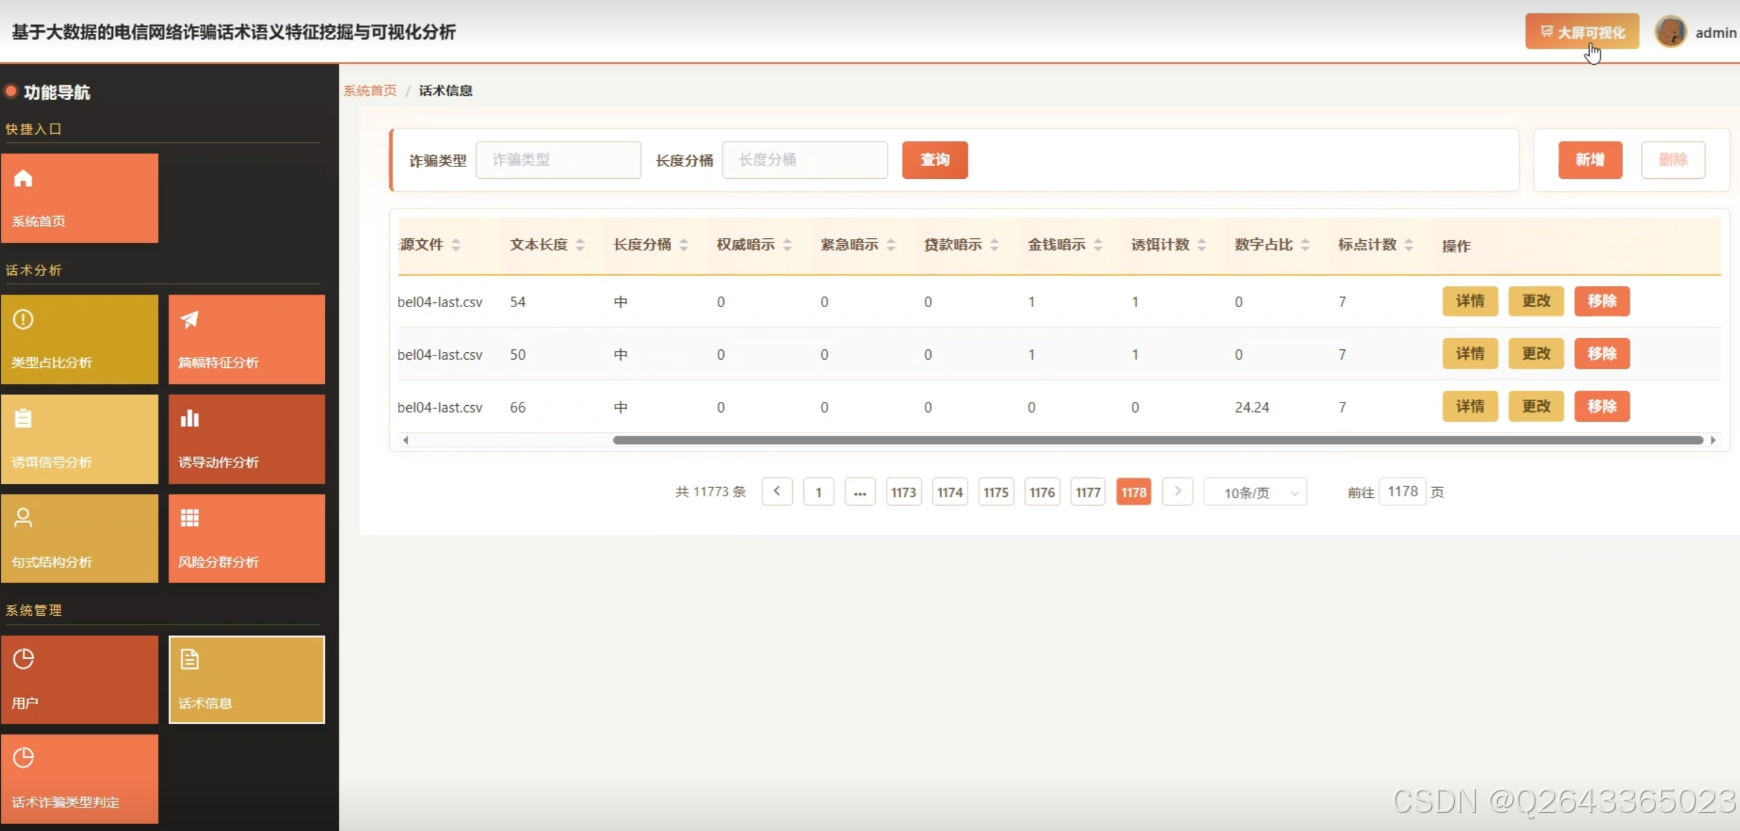
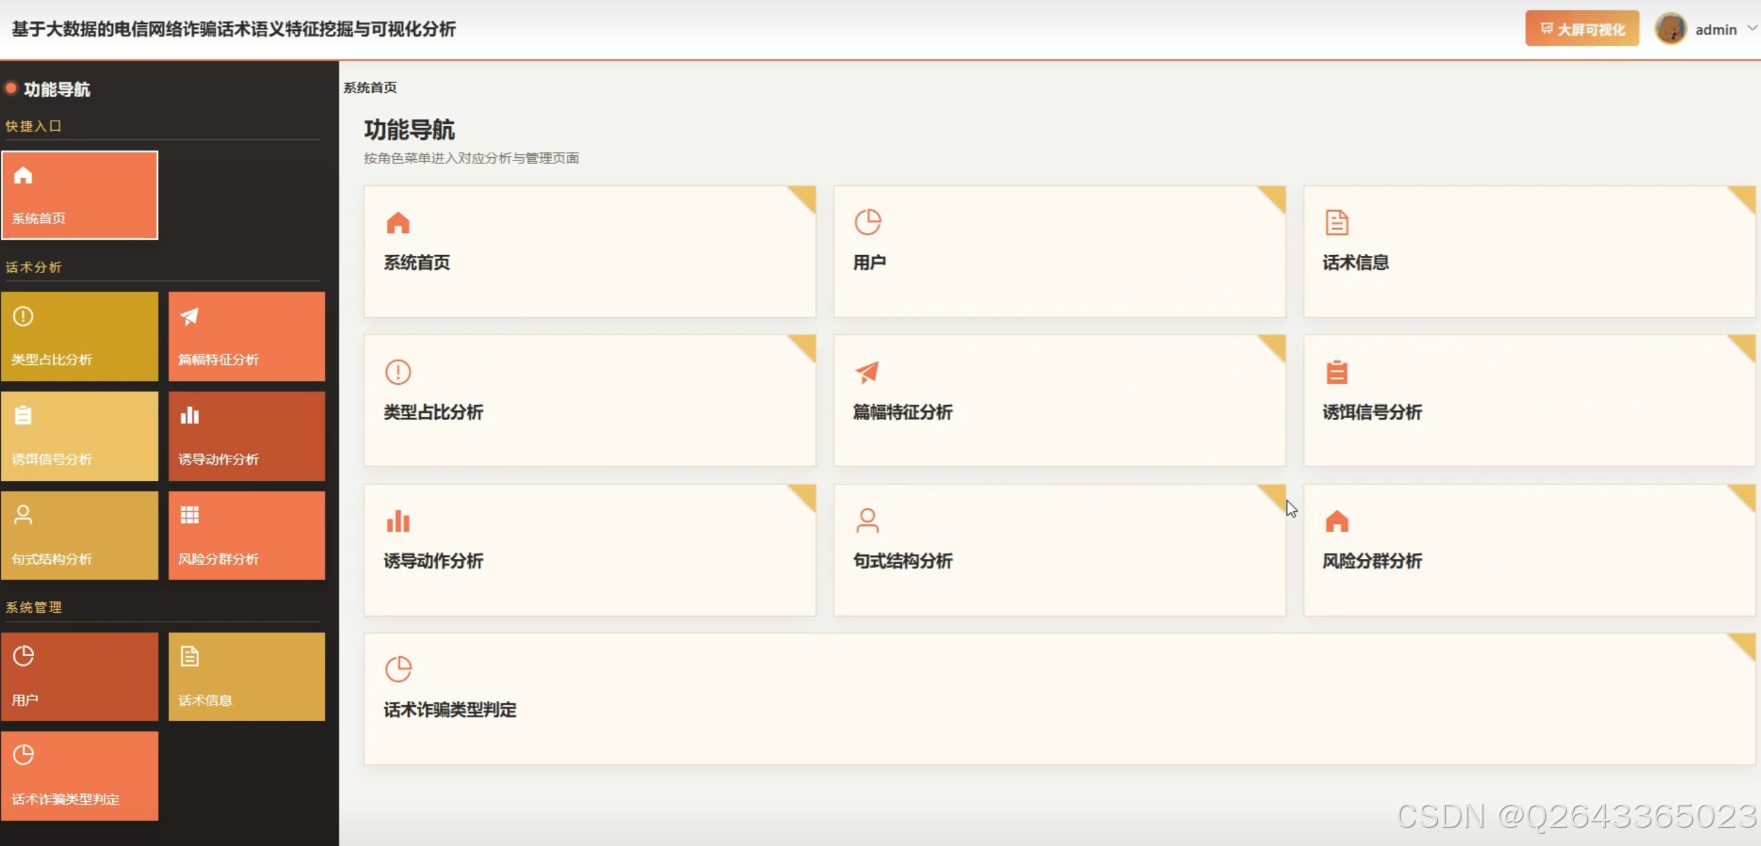
3.5 基础页面
4 更多推荐
计算机专业毕业设计新风向,2026年大数据 + AI前沿60个毕设选题全解析,涵盖Hadoop、Spark、机器学习、AI等类型
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
【避坑必看】26届计算机毕业设计选题雷区大全,这些毕设题目千万别选!选题雷区深度解析
紧跟风口!2026计算机毕设新赛道:精选三大热门领域下的创新选题, 拒绝平庸!毕设技术亮点+功能创新,双管齐下
纯分享!2026届计算机毕业设计选题全攻略(选题+技术栈+创新点+避坑),这80个题目覆盖所有方向,计算机毕设选题大全收藏
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
5 部分功能代码
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, size, udf, desc, round as spark_round
from pyspark.sql.types import ArrayType, StringType
from pyspark.ml.fpm import FPGrowth

def multi_bait_fpgrowth_analysis(spark, input_df):
    """FP-Growth挖掘多诱饵叠加关联规则"""

    # 每条话术转换为诱饵项列表
    def build_items(auth, urg, loan, money, leader):
        items = []
        mapping = [
            (auth, '权威'), (urg, '紧迫'), (loan, '借贷'),
            (money, '金钱'), (leader, '领导熟人'),
        ]
        for v, name in mapping:
            try:
                if float(v) >= 1.0:
                    items.append(name)
            except:
                pass
        return items

    build_udf = udf(build_items, ArrayType(StringType()))

    items_df = input_df.select(
        build_udf(
            col('cue_authority'), col('cue_urgency'), col('cue_loan'),
            col('cue_money'), col('cue_leader')
        ).alias('items')
    ).filter(size(col('items')) >= 1)

    n_trans = items_df.count()
    print(f"非空诱饵事务数: {n_trans}")

    # FP-Growth训练(支持度5%,置信度40%)
    fp = FPGrowth(itemsCol='items', minSupport=0.05, minConfidence=0.4)
    model = fp.fit(items_df)

    # 关联规则
    rules = model.associationRules.select(
        concat_ws('、', col('antecedent')).alias('前项'),
        concat_ws('、', col('consequent')).alias('后项'),
        spark_round(col('confidence'), 2).alias('置信度'),
        spark_round(col('lift'), 2).alias('提升度'),
        spark_round(col('support'), 2).alias('支持度')
    ).orderBy(desc('置信度'), desc('提升度'))

    return rules
源码项目、定制开发、文档报告、PPT、代码答疑
希望和大家多多交流 ↓↓↓↓↓