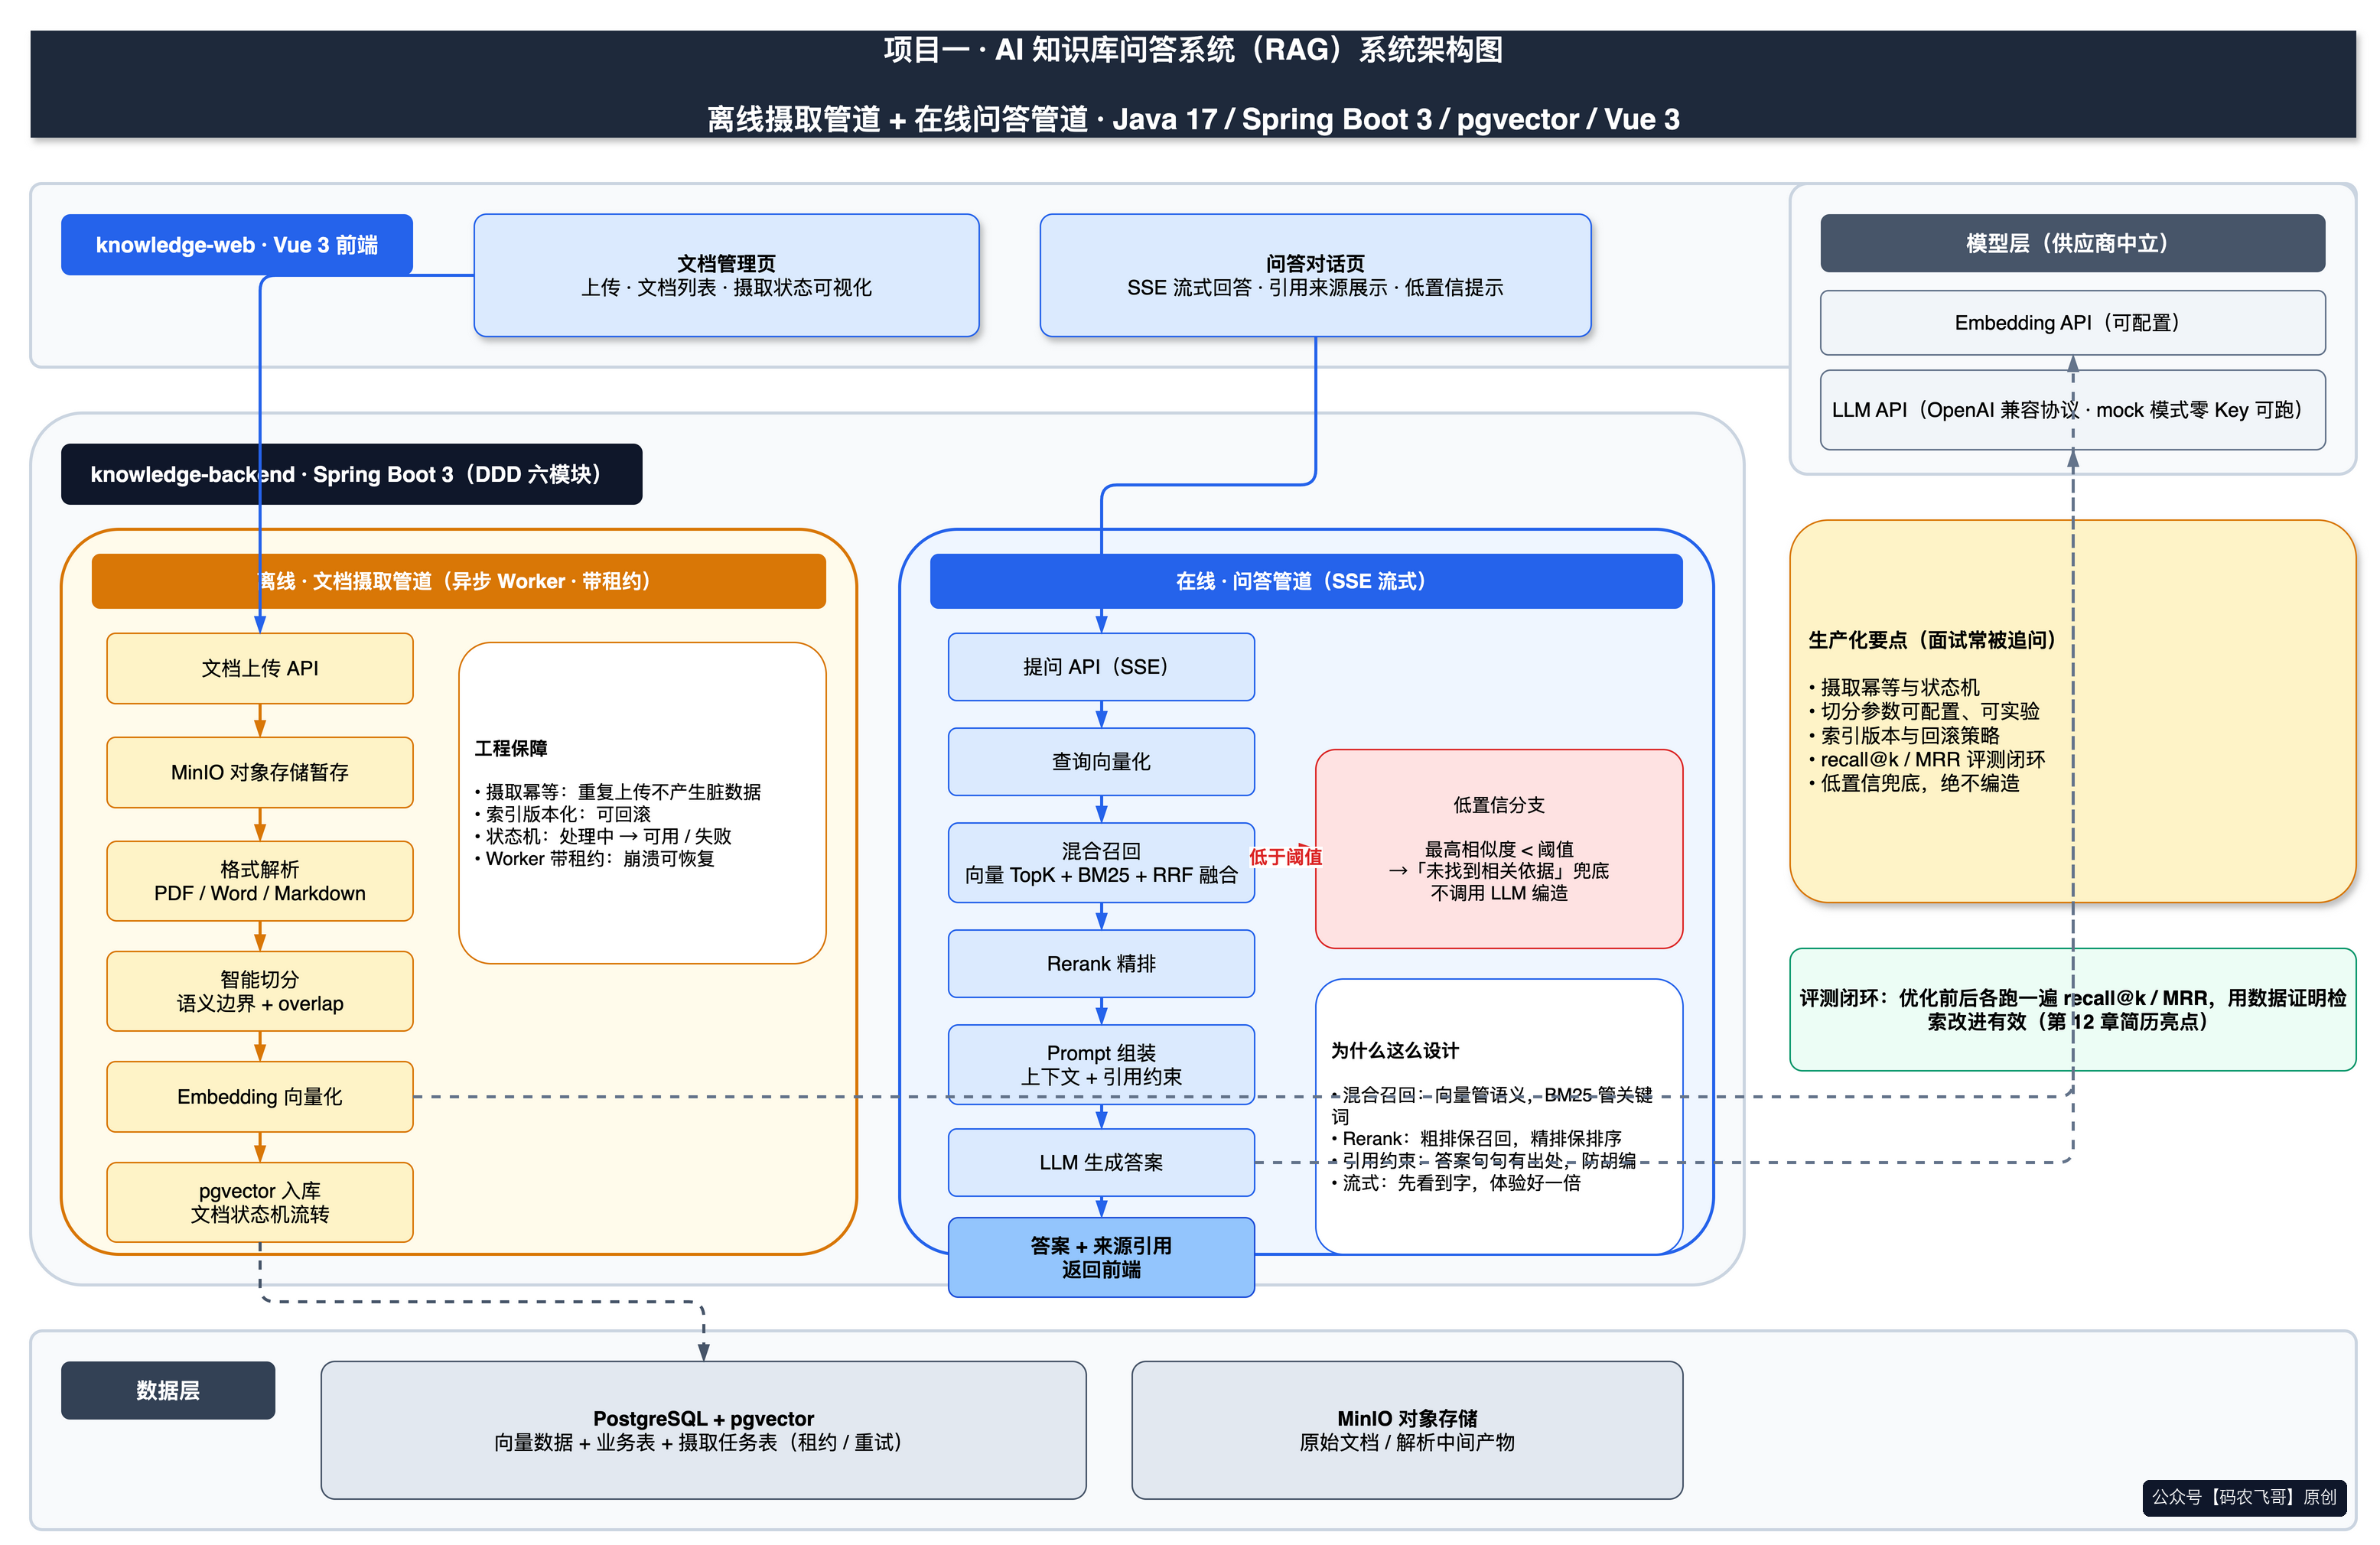
企业级 RAG 系统架构总览(公众号【码农飞哥】原创)
很多 Java 同胞学 RAG 的方式是:先看一周名词解释------chunk、embedding、rerank、RRF、向量数据库------每个词都认识了,连起来还是不知道一个能上生产的 RAG 系统长什么样。
这篇文章反过来:直接给系统,再看零件。我把它拆成"两条管道 + 四个工程细节"。
一、总体架构:两条管道
企业级 RAG 和教程 demo 最大的区别,是它天然分成两条独立的管道:
离线摄取管道负责把文档变成可检索的向量索引。文档上传后接口立刻返回 202(受理),真正的解析、切分、向量化由异步 Worker 完成。
在线问答管道负责把用户问题变成带引用的回答。查询向量化 → 混合召回 → 精排 → 组装上下文 → 生成 → 溯源返回。
用 Java 后端的经验翻译一下:离线管道就是一个数据同步任务系统,在线管道就是一个"先查库、再拼响应"的查询接口。你过去做接口、做异步任务、做数据一致性的经验,80% 直接复用------这也是我一直在讲的"Java 转 AI 不清零"。
二、离线摄取管道:状态机是灵魂
文档从上传到可检索,走的是一条显式状态机:
bash
UPLOADED → PARSING → CHUNKING → EMBEDDING → READY
    ↘ 任意一步失败 → FAILED(可重试)
三个生产级设计,教程里通常不讲:
**1. 异步 + 状态机。**PDF 解析和向量化是秒级耗时操作,同步接口必超时。所以上传接口只做受理和校验,摄取交给 Worker 轮询执行,前端轮询文档状态展示进度。每一步带阶段标记和进度百分比,出问题能定位到具体环节。
**2. 幂等。**三个层面:上传按内容幂等,重复上传不产生脏索引;重试/删除接口要求携带 Idempotency-Key,重复点击不产生重复任务;重试只允许对 FAILED 状态的文档发起,非失败状态重试直接返回业务冲突。
**3. 索引版本。**每个知识库维护一个 activeIndexVersion,检索只取索引版本等于当前激活版本的 chunk。它的价值在知识库更新期间:新文档还在摄取时,问答只基于已激活的稳定索引,不会检索到"半新半旧"的数据;换 Embedding 模型需要全量重建索引时,版本切换就是切流开关。
三、文件校验:三层一致性,一个都不能少
上传环节做一个容易忽略的安全设计:扩展名、multipart 声明类型、服务端内容探测(magic bytes)三者必须一致才受理。
实际运行里它真的拦得住事:用 curl 上传 。md 文件时默认声明为 application/octet-stream,被直接拒绝(FILE_TYPE_INVALID)。攻击者把恶意文件改个 。pdf 后缀,同样过不了内容探测。纵深防御的最外层,就该这么薄而硬。
四、在线问答管道:召回、精排、兜底、溯源
**混合召回。**向量检索管语义泛化("请假"能召回"年假"文档),BM25 管精确词(制度编号、专有名词、型号)。两路结果用 RRF(倒数排名融合)合并------按排名倒数计分,避免了向量分数和 BM25 分数量纲不可比的问题。
**Rerank 精排。**召回模型要快(毫秒级捞回 TopK),精排模型要准(cross-encoder 逐对打分,慢一个量级)。先保 recall 再保 precision,两段式架构。Rerank 只对 TopK 做,延迟可控。
**低置信兜底。**这是 RAG 系统的底线设计:最高相似度低于阈值时,直接回答"未找到相关依据",不把问题送给模型硬编。幻觉没法被消灭,但可以被架构拦住。阈值不是拍脑袋------用评测集里"库外问题"的相似度分布校准。
**引用溯源。**回答的每条引用带 chunk 级信息:chunkId、文档名、排名、相似度分数、原文片段(quote)。用户可以点开核对"这句话的依据是哪段原文"。严格口径下,全部引用命中才算一次合格回答。
五、回答生成:SSE 流式与事件设计
流式输出用 SSE,事件协议四类,顺序有讲究:
bash
meta(messageId + traceId)→ token(增量)→ citation(逐条引用)→ done(answerType + token 用量)meta 放第一个事件:客户端第一时间拿到 traceId,出问题能立刻上报定位。token 计量随 done 下发,成本是一等公民指标。异常时发 error 事件并优雅收尾,不挂死连接。
六、反馈闭环:让坏案例变成评测题
用户对回答可以赞/踩(带原因码:答案错误 / 引用错误 / 已过时 / 库里应该有),管理员对反馈做分诊(ACCEPTED_TO_EVAL / REJECTED),被采纳的坏案例一键导出成评测集条目。
这条管道的意义:线上问题 → 评测集 → 回归门禁形成飞轮。RAG 系统最缺的不是优化技巧,是"优化之后怎么证明没变坏"的机制。
七、评测:没有数字的优化是玄学
简单说结论(细节我单独写了一篇):搭了一套 50 问、五种难例的评测集,指标用 Recall@K、引用正确率(strict)、拒答准确率、误拒率。第一次全量跑出来的数字很有意思------召回 0.96,严格引用正确率只有 0.17:该找的都找回来了,但引用里混了一半凑数的。这组对照说明"找得到"和"排得对"是两种能力,必须分开度量。
质量门禁的规则只有一条:阈值必须来自真实环境基线并人工冻结,没冻结就不许发布------评测脚本里写死了"禁止预造数字"。
八、Java 经验迁移对照表
| 你会的东西 | 在 RAG 系统里的位置 |
|---|---|
| 异步任务 + 状态机 | 文档摄取管道 |
| 数据库版本 / 灰度切流 | 索引版本 activeIndexVersion |
| 接口幂等(流水号去重) | clientMessageId / Idempotency-Key |
| 接口鉴权 + RBAC | JWT + 知识库级 OWNER/ADMIN/VIEWER |
| 日志链路追踪 | traceId 串联回答、引用、token 计量 |
| 单测 / 回归测试 | 评测集 + 质量门禁 |
转 AI 应用开发,真不是推倒重来。
写在最后:这套系统的完整设计文档(需求边界、领域模型、数据库、API 时序、异常安全、部署验收,共 12 篇/项目 × 3 个项目),我整理成了一套体系化资料库,还有 27 道 AI 应用开发面试追问的参考答案。
关注公众号【码农飞哥】,回复"地图",免费领《Java 转 AI 学习路线图》高清版 + 10 道高频追问精讲。
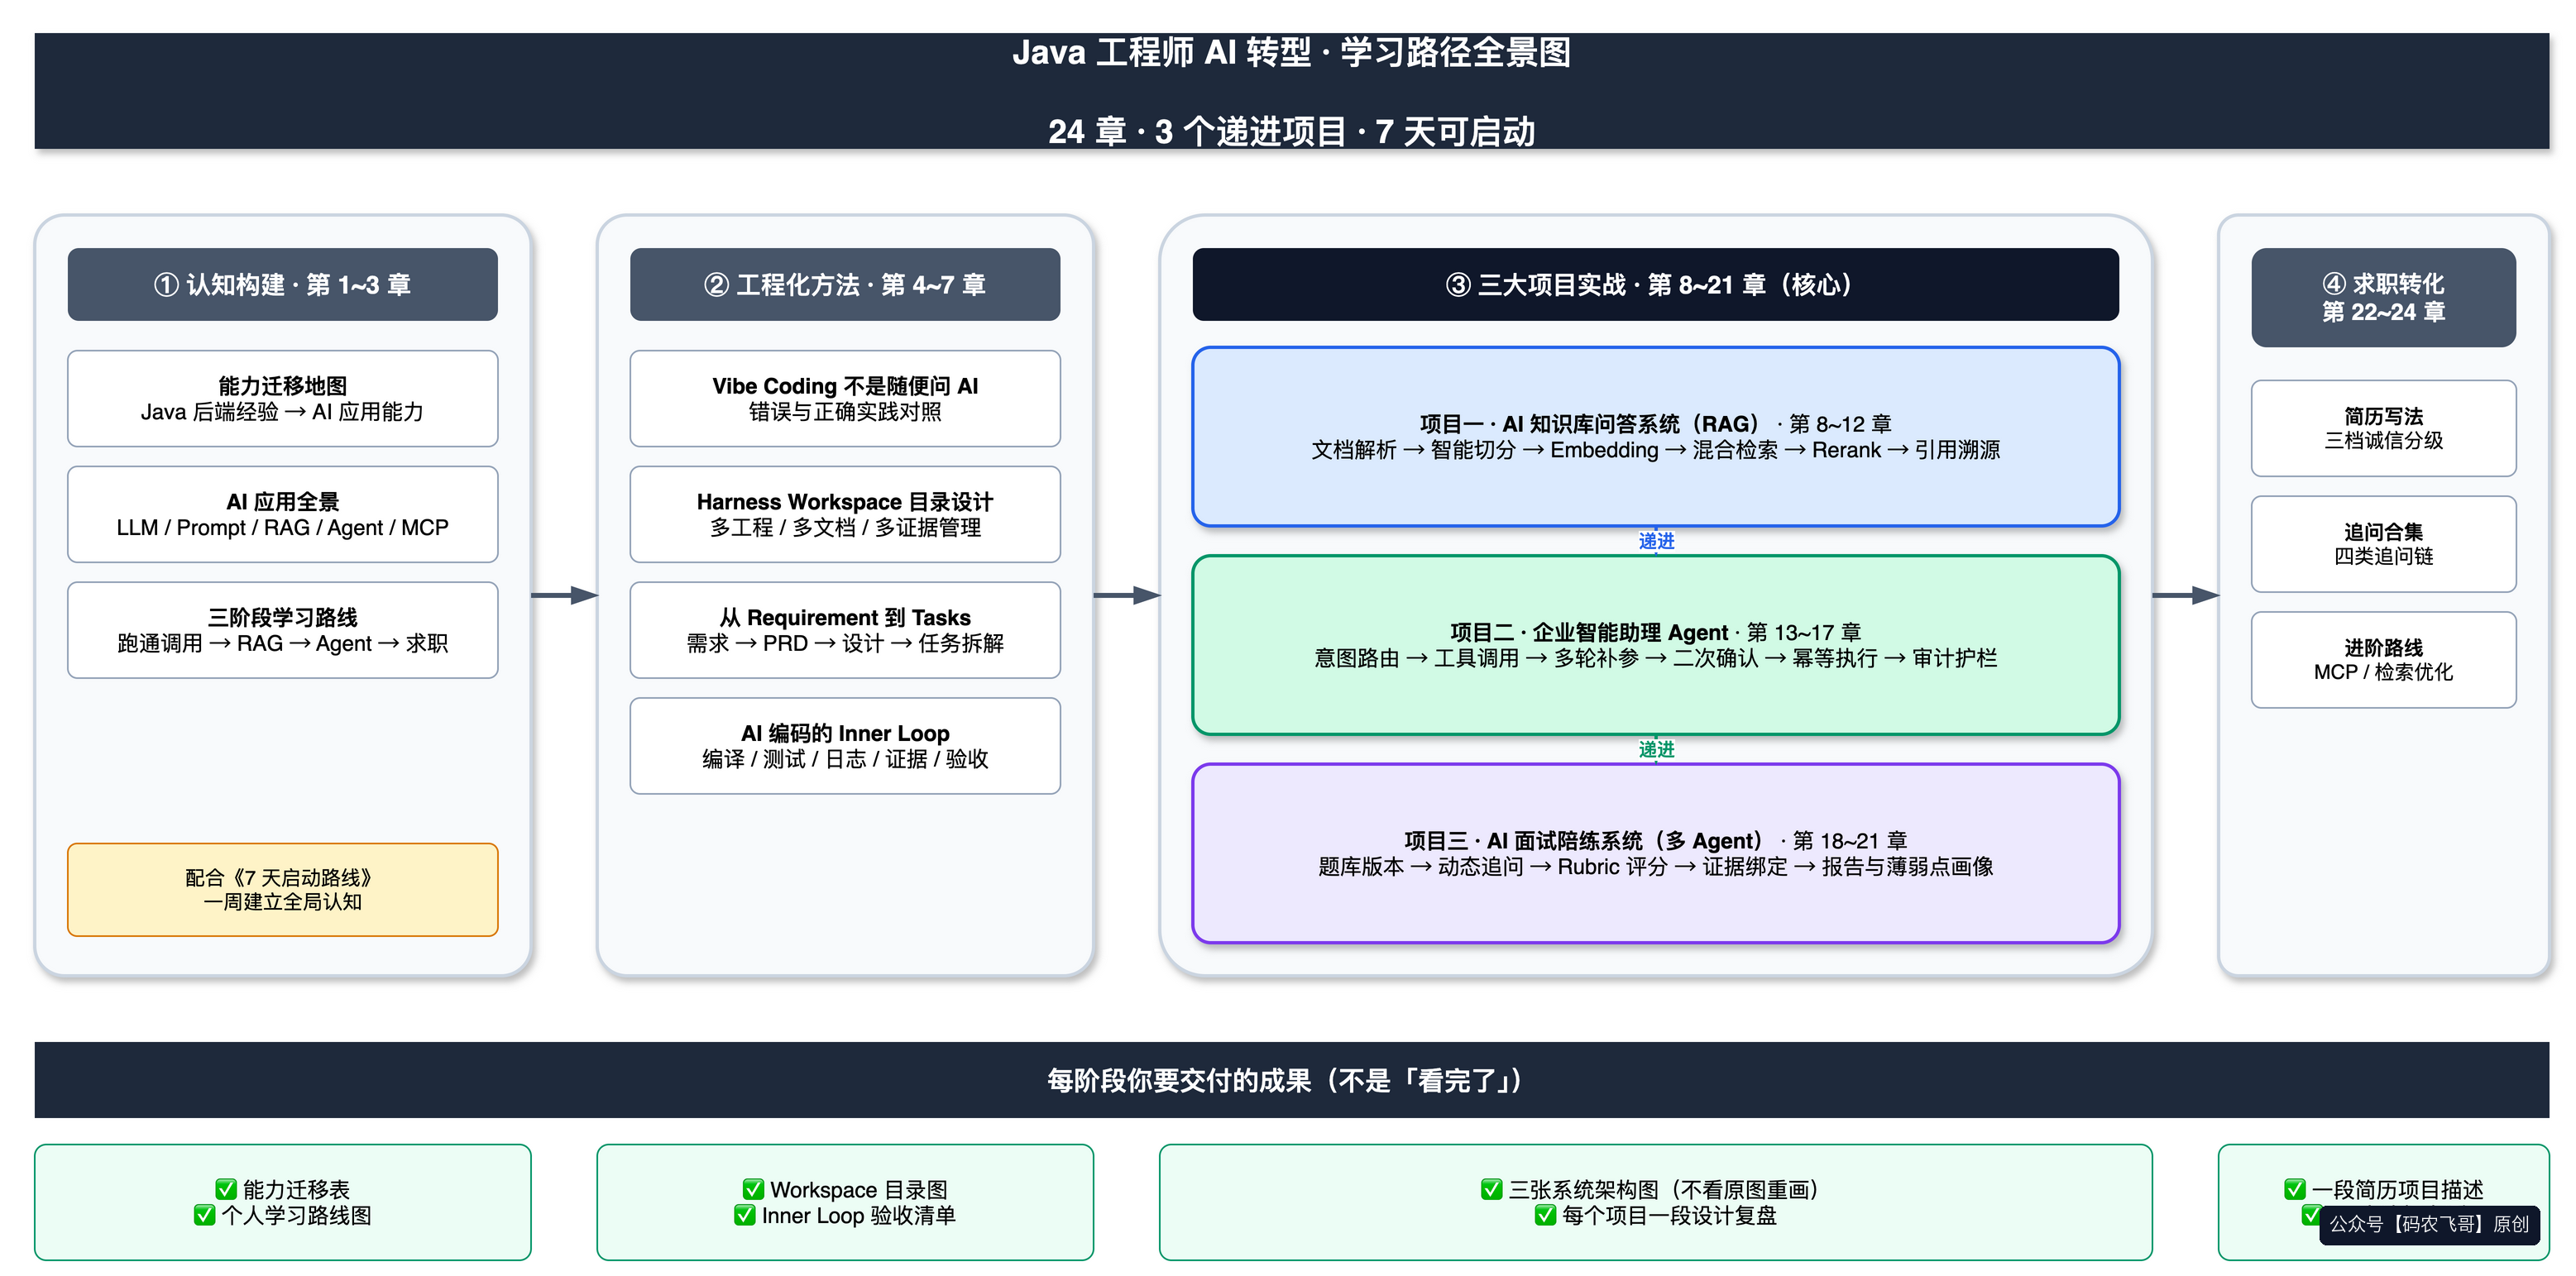
本文系统所处的 Java 转 AI 完整学习体系(公众号【码农飞哥】原创)