Agent 记忆的难点不是存储,而是判断什么值得写、什么时候合并、召回多少,以及团队资产如何治理。
阅读时间:约 7 分钟
很多 Agent Memory 方案看起来都差不多:分层记忆、向量召回、长期画像、少用 token。
真正拉开差距的地方,不在这些名词,而在边界条件。
拆这类系统,最好先问四个问题:
- 同一条信息要不要写
- 新旧事实冲突时保留谁
- 召回超时是等,还是放弃
- 团队管理员能不能看个人记忆
TencentDB Agent Memory 值得拆,是因为它把这些判断写进了代码和 prompt。
图:Agent 记忆工程取舍
记忆系统先要敢丢东西
这套系统最重要的原则可以概括成四个字:宁缺毋滥。
原始对话不会直接变成高层记忆。每轮对话先落到 L0,再由异步流水线逐层提炼。
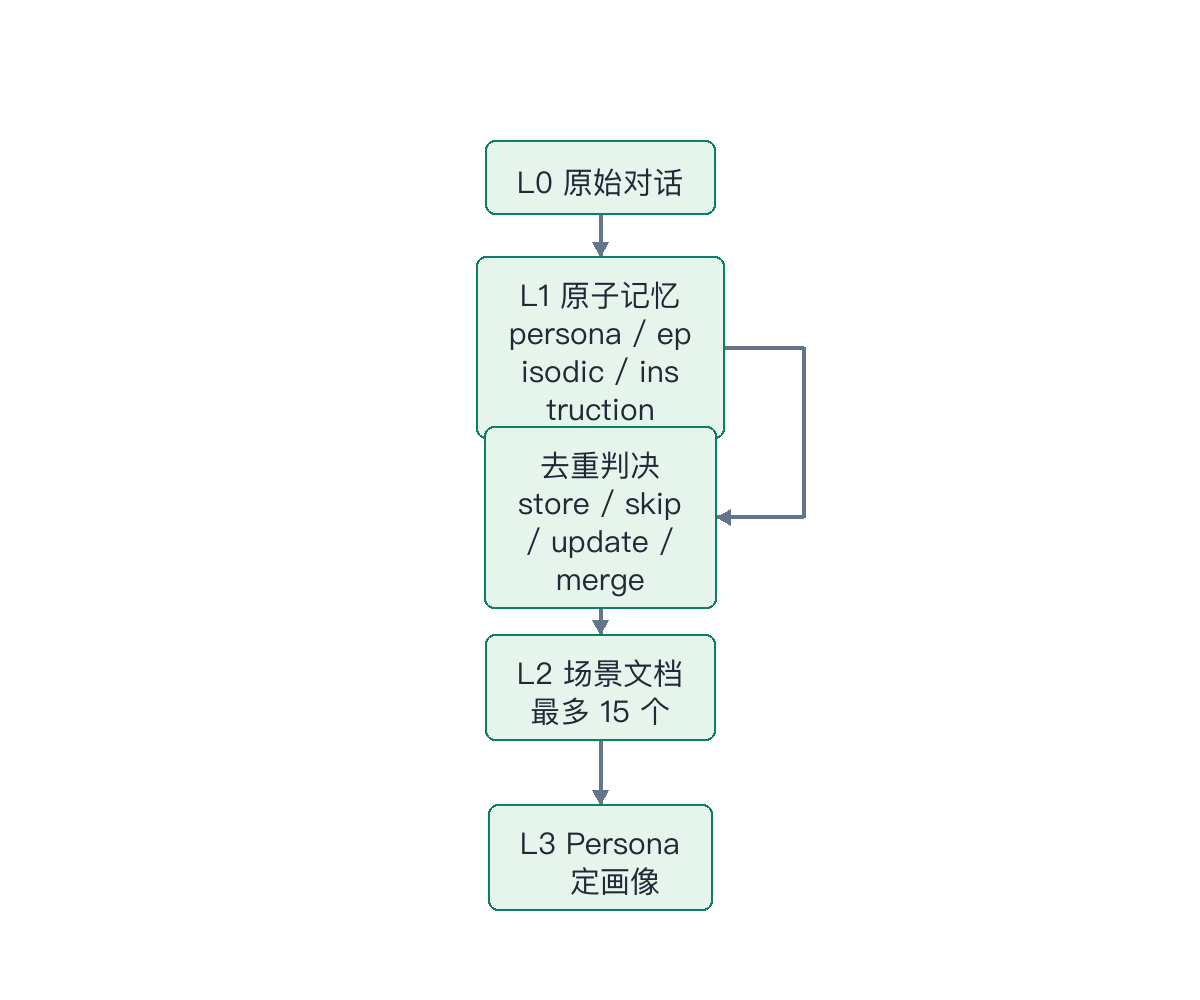
L0 不是单一存储。它会写 SQLite 表、向量表和按天分片的 JSONL。
这看着冗余,但用途不同:
| 存储 | 作用 |
|---|---|
| SQLite 表 | 结构化查询,保留 team_id/user_id/agent_id/task_id |
| 向量表 | 语义召回 |
| JSONL | 数据库异常时可回捞原话 |
从最底层就埋下 team_id、user_id、agent_id、task_id,说明它一开始就不是个人单机备忘录。后面的团队资产治理,靠这些字段才能成立。
L0 到 L3 是一条异步提炼链
L1 抽取不会每轮都跑。默认每 5 轮触发一次,或者会话空闲 600 秒后触发。
配置里还有一个冷启动优化:enableWarmup 会按 1、2、4、5 轮提前触发,让第一条记忆更早出现。
关键配置大致如下:
pipeline: {
  everyNConversations: 5,
  enableWarmup: true,
  l1IdleTimeoutSeconds: 600,
  l2DelayAfterL1Seconds: 10,
  l2MinIntervalSeconds: 900,
  l2MaxIntervalSeconds: 3600,
  sessionActiveWindowHours: 24,
}
这个节奏说明一件事:记忆不能影响对话主链路。写入和聚合放到异步流程里,用户先拿到回答,系统随后整理记忆。
L1 的抽取 prompt 同时做两件事:
- 判断情境是否切换
- 提取结构化记忆
记忆只分三类:
| 类型 | 内容 | 例子 |
|---|---|---|
persona |
用户稳定属性、偏好、技能、价值观 | 用户偏好简洁回答 |
episodic |
客观发生过的事件、决定、计划 | 用户在某天决定推进某项目 |
instruction |
长期行为规则、格式和语气要求 | 回复时先给结论 |
它刻意排除了"没有客观事件支撑的情绪表达"。这是个很实用的限制。用户随口抱怨一句,不应该被系统永久写成稳定偏好。
还有一个特殊值:priority = -1。它留给极严格的全局命令。正常优先级是 0~100,负数反而代表最高约束,说明后续排序或过滤会为这类规则走特殊分支。
去重和聚合交给 LLM 判决
很多记忆系统用向量相似度阈值去重。TencentDB Agent Memory 没这么做。
它先召回 Top-5 候选,再让 LLM 判断动作:
| 动作 | 含义 |
|---|---|
store |
新信息,直接新增 |
skip |
旧记忆更好,新记忆没有增量 |
update |
同一事实,新记忆更具体、更新或纠错 |
merge |
多条记忆互补,合成一条 |
这比纯阈值更接近人类整理笔记的方式。向量只能判断"像不像",LLM 可以判断"是不是同一事实""谁更新""能不能合并"。
代价也明确:每次抽取后要多一次 LLM 判决。结果也不是完全可复现。同样两条记忆,不同运行可能得到不同合并结果。
L2 聚合更大胆。它不给聚类算法,而是给 LLM 一个目录的读写权限,让它维护场景文档。
关键约束是 maxScenes = 15。场景文件接近上限时,LLM 必须先合并相似场景,再处理新记忆。
这个上限很关键。没有容量约束,记忆只会越堆越多;有了上限,系统被迫持续归纳。
删除也不是让 LLM 真删文件。LLM 只能写 [DELETED] 标记,由工程侧清理。这个设计把"语义判断"交给模型,把"危险操作"留给代码。
召回侧把预算写进代码
召回链路走混合检索:关键词一路,向量一路。
关键词路线使用 SQLite FTS5 的 BM25。中文先做分词,再拼成 OR 查询。
向量路线使用 sqlite-vec 做余弦相似度。两路并行,各取 maxResults * 3 个候选。
融合使用 RRF:
export const RRF_K = 60;

export function rrfMerge<T>(
  lists: T[][],
  getId: (item: T) => string,
  k: number = RRF_K,
): Array<T & { rrfScore: number }> {
  const map = new Map<string, { item: T; rrfScore: number }>();

  for (const list of lists) {
    for (let rank = 0; rank < list.length; rank++) {
      const item = list[rank];
      const id = getId(item);
      const score = 1 / (k + rank + 1);
      const existing = map.get(id);
      if (existing) existing.rrfScore += score;
      else map.set(id, { item, rrfScore: score });
    }
  }

  return [...map.values()]
    .sort((a, b) => b.rrfScore - a.rrfScore)
    .map(({ item, rrfScore }) => ({ ...item, rrfScore }));
}
RRF 的好处是不用比较原始分数。BM25 分数和余弦相似度不是一个量纲,直接相加需要调权重。RRF 只看排名,天然适合合并异构检索结果。
召回注入也做了预算控制。
稳定内容放在 system prompt 末尾,例如 persona、场景导航和工具指南。每轮变化的 L1 相关记忆放在 user prompt 前面。
这个位置选择会影响账单。如果每轮都把变化内容塞进 system prompt,prompt cache 会不断失效。把稳定内容和动态内容拆开,能保住缓存命中率。
召回还有 5 秒超时保护。超时后返回空注入,让主流程继续。
这条判断很重要:记忆是增强功能,不该拖垮对话主链路。宁可无记忆回答,也不能让用户等一个不确定的后台依赖。
上下文压缩才是省 token 的主战场
很多文章会把节省 token 归功于长期记忆召回。真正每天发生的压力,是上下文窗口快满。
系统里有三档阈值:
mildOffloadRatio: 0.5,
aggressiveCompressRatio: 0.85,
emergencyCompressRatio: 0.95,
mmdMaxTokenRatio: 0.2,
含义如下:
| 档位 | 触发比例 | 处理动作 |
|---|---|---|
| Mild | 50% | 替换非当前任务的工具结果 |
| Aggressive | 85% | 删除更早消息,用状态图回填 |
| Emergency | 95% | 紧急压缩到目标比例 |
Mild 档只扫描最近 70% 的消息,并优先处理最可替换的前 40%。这说明系统不做简单 FIFO,而是先移走对当前决策价值较低的内容。
Aggressive 档更像手术:从最老消息开始删除,每轮削掉约 40% 的消息 token,同时通过 L1.5 判断任务边界,避免把同一任务切断。
被删掉的内容不会彻底消失。系统会用一张 Mermaid 状态图回填,告诉模型"任务走到哪一步"。
可以把这个机制理解成:
删除几十条工具调用原文
  -> 保留关键状态和证据
  -> 用一张状态图回填当前进展
mmdMaxTokenRatio = 0.2 是必要的刹车。压缩产物最多占 20% token,避免"用压缩摘要把上下文再次塞满"。
团队记忆的核心是治理
个人记忆只要能搜回来就行。团队记忆需要回答更多问题:
- 这份记忆属于谁
- 哪个 Agent 可以用
- 团队成员能不能看
- 历史版本能不能回滚
- 同一份知识如何挂给不同任务
这就是治理。
系统把记忆资产登记成有 Owner、版本、可见性和装配关系的资源,再按权限决定 Agent 能不能读取。
private 语义最值得看:只有 owner 可以访问,团队 admin 也不能直接读。
这个选择很产品化。Chat Memory 里会有用户偏好、工作习惯和私下表达。如果管理员也能看,很多人不会愿意打开这个功能。
可见性可以粗略分成三类:
| 可见性 | 语义 |
|---|---|
private |
个人隐私资产,只有 owner 可见 |
team |
团队共享,成员可读,owner/admin 可管理 |
restricted |
严格白名单,按 ACL 授权 |
权限判定顺序也经过优化:先判断资源和 owner,再看成员、visibility、角色默认权限和 ACL。高频路径尽量不查 ACL,减少每次装配记忆的额外成本。
接入层比算法层更重
这个项目有一个很现实的比例:接入层代码量远大于知识引擎。
原因不难理解。做 Agent Memory,算法只是其中一部分;真正麻烦的是怎么接入不同客户端。
早期插件模式要适配每个 Agent 框架的生命周期。换一个闭源客户端,就可能接不进去。
v2.x 换成代理模式:拦截 Anthropic、OpenAI 或其他兼容协议,把请求转发给上游,同时在旁路解析消息、工具调用和 usage,流结束后异步写入 L0。
流式响应的关键是 SSE 边界处理。网络 chunk 不保证刚好按 \n\n 切开,所以代理必须保留未完成的缓冲区,等下一个 chunk 拼完整再解析。
会话识别也靠一组 header 兜底,例如:
x-conversation-id
x-session-id
x-claude-code-session-id
x-chat-id
x-thread-id
这就是"零侵入接入"的真实代价。用户只改 base URL,看起来很轻;兼容性压力转移到了代理层。
不同客户端会塞不同的系统提示、补全请求、压缩请求和工具调用格式。代理必须识别哪些要写记忆,哪些只是辅助请求。
所以,记忆系统从个人玩具走向团队工具时,接入和治理常常比算法更费工程量。
收束
TencentDB Agent Memory 给出的几个判断可以迁移到很多 Agent 产品里:
- 记忆系统先设计"丢弃规则",再设计存储
- LLM 适合做归纳、去重和合并,但危险动作要由代码执行
- 容量上限能逼系统持续整理,而不是无限堆积
- 召回失败要可降级,不能阻塞主流程
- 团队记忆必须先解决权限和可见性,算法效果排在后面
它用到的技术并不神秘:SQLite、FTS5、向量检索、RRF、异步队列、prompt cache、SSE 解析。
真正值得学的是这些技术被放在了正确的边界上。该让模型判断的地方让模型判断,该让代码兜底的地方让代码兜底,该让权限拒绝的地方就直接拒绝。
记忆系统的核心能力,最后会落到一句很朴素的话上:存得少一点,取准一点,错了能改回来。