第 09 篇:实践一 ------ 文本摘要(Map-Reduce 分块)
系列:《Java 大模型应用开发入门》第 09 篇。
源码定位:
- 服务:
com.example.llm.service.SummaryService- DTO:
com.example.llm.dto.biz.SummaryDtos- 提示词:
com.example.llm.prompt.Prompts#SUMMARY_SYSTEM/#mapSummarySystem- 接口:
POST /ai/summarize- 配置:
ai.summary.max-input-chars=4000、ai.summary.chunk-size=1200
一、背景
文本摘要看起来是最简单的 AI 场景:一段文本进去,一段摘要出来,一个提示词的事。
但一放到真实业务里,第一个撞上的墙就是:文章比上下文窗口还长。
一份 3 万字的行业研报、一篇 5 万字的会议纪要、一份 8 万字的合同 ------ 直接塞进 messages 里,要么超过模型的上下文窗口被截断,要么超出 max-tokens 报错,要么即使塞进去了,你也在为几十万 Token 付钱。
这篇解决的就是这件事:用 Map-Reduce 分块,把「无限长」的输入变成「有限长」的调用。
二、目标
- 短文本走一次调用,长文本自动切换到分块 Map-Reduce;
- 切块必须按段落边界切,不能按固定字符数硬切;
- 摘要结果结构化(
summary+keyPoints+keywords),并告诉调用方有没有走分块、分了几块; - 大模型不可用时能降级,接口永远有可用返回。
三、前置
- 第 05 篇的结构化输出(
AiInvoker.chatJson(..., Class))已就绪; - 第 08 篇的容错与降级已就绪。
四、核心概念:Map-Reduce 分块
   原文(可能是 5 万字)
        │
        │  按段落边界切块
        ▼
   [块1] [块2] [块3] ... [块N]
     │     │     │         │
     ▼     ▼     ▼         ▼        (Map:每块单独摘要,彼此独立)
 [摘要1][摘要2][摘要3] ... [摘要N]
     └─────┴─────┴─────────┘
               │
               ▼                    (Reduce:把 N 段摘要合成一篇)
           [最终摘要]
有两个关键决策要说清楚。
为什么一定要按段落切
假设原文是「......本次发布重构了大模型客户端......」,你按 1200 字符硬切,正好切在「重构」中间:
块 A:......本次发布重
块 B:构了大模型客户端......
模型拿到块 A,看不到完整信息,但它不会说「我不知道」,它会编。这是大模型最危险的行为特性 ------ 有强烈的编造内容以「补全语义」的倾向。
所以 splitByParagraph 的分块单位是段落,只有当单个段落本身就超过 chunk-size 时,才退而求其次按字符切。
为什么 Map 阶段的提示词要额外加一句约束
java
public static String mapSummarySystem(AiProperties properties) {
    return SUMMARY_SYSTEM + "\n注意:这是长文的一个片段,请只总结本片段,不要补充片段之外的信息。";
}
因为 Map 阶段每一块都是孤立的,模型看不到上下文。如果不加这句,它会脑补出这一块之外的内容 ------ 比如看到「如上所述,第 3 点的结论是......」,它会自己编一个第 3 点。
加上这句,是明确告诉模型:你的世界只有这一段。
五、代码实操
入口:按长度分流
java
public SummaryDtos.Result summarize(SummaryDtos.Request request) {
    long start = System.currentTimeMillis();
    int[] tokens = new int[2];
    try {
        String text = request.getText();
        int maxInput = aiProperties.getSummary().getMaxInputChars();
        SummaryDtos.Result result;
        if (text.length() <= maxInput) {
            result = summarizeOnce(text, request.getMaxLength(), tokens);
            result.setChunked(false);
            result.setChunkCount(1);
        } else {
            result = summarizeChunked(text, maxInput, request.getMaxLength(), tokens);
        }
        result.setDegraded(false);
        logService.record(ENDPOINT, aiProperties.getModel(),
                usageOf(tokens), System.currentTimeMillis() - start, true, null, false);
        return result;
    } catch (AiException e) {
        log.warn("摘要失败,返回降级结果: {}", e.getMessage());
        logService.record(ENDPOINT, aiProperties.getModel(), usageOf(tokens),
                System.currentTimeMillis() - start, false, e.getErrorCode(), true);
        return fallback(request.getText(), e);
    }
}
注意 int[] tokens 这个写法:用一个一维数组在多次调用间累加 Token 数。因为 Map 阶段可能调用 5 次、Reduce 再 1 次,这些调用的 Token 都要计入这一次业务请求的成本,否则 /ai/stats 里的成本统计就是错的。
短文本:一次调用
java
private SummaryDtos.Result summarizeOnce(String text, Integer maxLength, int[] tokens) {
    String user = Prompts.wrap("【待摘要文本】", text)
            + (maxLength == null ? "" : "\n摘要长度控制在 " + maxLength + " 字以内。");
    AiInvoker.AiResult<SummaryDtos.Result> result = aiInvoker.chatJson(
            List.of(Message.system(Prompts.SUMMARY_SYSTEM), Message.user(user)),
            0.3, SummaryDtos.Result.class);
    accumulate(tokens, result);
    return normalize(result.data());
}temperature=0.3,因为摘要要稳定,不能用 0.7 那种偏创意的值。长度约束写在 user 消息里,跟着数据走,而不是写在 system 里,这样可以对同一次业务做不同长度的摘要。
长文本:Map-Reduce
java
private SummaryDtos.Result summarizeChunked(String text, int maxInput, Integer maxLength, int[] tokens) {
    List<String> chunks = splitByParagraph(text, aiProperties.getSummary().getChunkSize());
    log.info("summary.chunked totalChars={} chunks={}", text.length(), chunks.size());

    // Map 阶段
    List<String> partialSummaries = new ArrayList<>(chunks.size());
    for (String chunk : chunks) {
        AiInvoker.AiResult<SummaryDtos.Result> part = aiInvoker.chatJson(
                List.of(Message.system(Prompts.mapSummarySystem(aiProperties)),
                        Message.user(Prompts.wrap("【待摘要文本】", chunk))),
                0.3, SummaryDtos.Result.class);
        accumulate(tokens, part);
        partialSummaries.add(part.data().getSummary());
    }

    // Reduce 阶段
    String merged = String.join("\n", partialSummaries);
    if (merged.length() > maxInput) {
        merged = merged.substring(0, maxInput);   // 二次保护:合并后仍超长就截断
    }
    String user = Prompts.wrap("【待摘要文本】", merged)
            + "\n这是长文各段落的摘要,请合成一篇完整摘要。"
            + (maxLength == null ? "" : "\n最终摘要控制在 " + maxLength + " 字以内。");
    AiInvoker.AiResult<SummaryDtos.Result> reduce = aiInvoker.chatJson(
            List.of(Message.system(Prompts.SUMMARY_SYSTEM), Message.user(user)),
            0.3, SummaryDtos.Result.class);
    accumulate(tokens, reduce);

    SummaryDtos.Result result = normalize(reduce.data());
    result.setChunked(true);
    result.setChunkCount(chunks.size());
    return result;
}
Reduce 阶段复用了 SUMMARY_SYSTEM。因为它的输入已经不是长文片段了,而是一段由摘要拼成的中等长度文本,跟短文本摘要的语义是一致的。
merged 的截断是必要的保护。5 个块各 150 字的摘要拼起来才 750 字,不超长;但如果块特别多(比如 30 块),合并后就可能超过 max-input-chars,这里必须兜一手。
按段落切块
java
List<String> splitByParagraph(String text, int chunkSize) {
    List<String> chunks = new ArrayList<>();
    String[] paragraphs = text.split("\\n+");
    StringBuilder current = new StringBuilder();
    for (String paragraph : paragraphs) {
        // 当前累积块 + 这一段超长 → 先把当前块收起来,另起一块
        if (current.length() > 0 && current.length() + paragraph.length() > chunkSize) {
            chunks.add(current.toString());
            current.setLength(0);
        }
        // 单段本身就超长 → 只能按字符硬切(退化路径)
        if (paragraph.length() > chunkSize) {
            int cursor = 0;
            while (cursor < paragraph.length()) {
                int end = Math.min(paragraph.length(), cursor + chunkSize);
                chunks.add(paragraph.substring(cursor, end));
                cursor = end;
            }
            continue;
        }
        current.append(paragraph).append('\n');
    }
    if (current.length() > 0) {
        chunks.add(current.toString());
    }
    return chunks;
}
这段逻辑有两个易错点:
current.length() > 0这个判断不能省。否则第一个段落就会触发一次「收块」,产出一个空字符串块,空块送给模型会浪费一次调用;- 超长单段的处理是
continue,不能让它继续往下走。如果超长单段已经按字符切完,不能再append到current里,否则会把已经切出去的重复内容又加回来。
降级
java
private SummaryDtos.Result fallback(String text, AiException e) {
    SummaryDtos.Result result = new SummaryDtos.Result();
    String plain = text.replaceAll("\\s+", " ").trim();
    String head = plain.length() <= 120 ? plain : plain.substring(0, 120);
    result.setSummary("【摘要服务暂不可用,以下为原文开头】" + head + "...");
    result.setKeyPoints(List.of("AI 摘要不可用(" + e.getErrorCode().getMessage() + "),建议稍后重试"));
    result.setKeywords(List.of(AiJsonUtils.brief(text, 6)));
    result.setChunked(text.length() > aiProperties.getSummary().getMaxInputChars());
    result.setChunkCount(0);
    result.setDegraded(true);
    return result;
}
降级的核心是结构一致:返回的还是一个 SummaryDtos.Result,只是内容退化成了「原文前 120 字加一句提示」。前端拿到后判断 degraded == true,就知道这是兜底数据,可以直接给用户一个「稍后重试」的提示,而不用崩。
六、验证
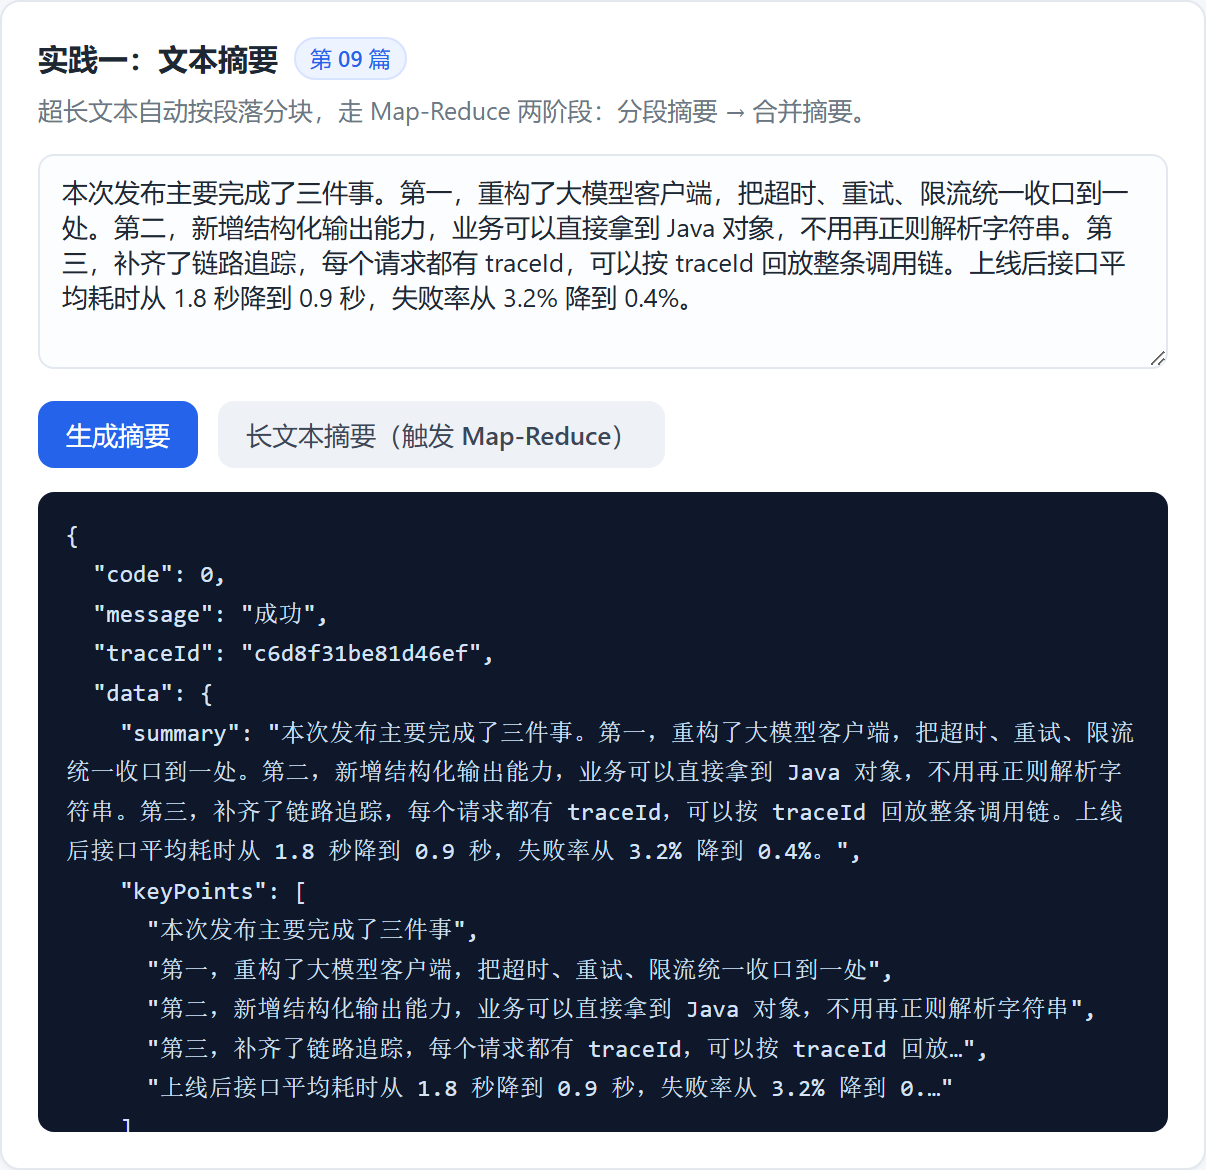
短文本(chunked=false)
$ curl -X POST http://127.0.0.1:8080/ai/summarize -d '{"text":"本次发布主要完成了三件事..."}'
HTTP 200
{
  "code": 0,
  "message": "成功",
  "traceId": "5d3907d3ca95456b",
  "data": {
    "summary": "本次发布主要完成了三件事。第一,重构了大模型客户端,把超时、重试、限流统一收口到一处。第二,新增结构化输出能力,业务可以直接拿到 Java 对象。第三,补齐了链路追踪,每个请求都有 traceId,可以按 traceId 回放整条调用链。上线后接口平均耗时从 1.8 秒降到 0.9 秒,失败率从 3.2% 降到 0.4%。",
    "keyPoints": [
      "本次发布主要完成了三件事",
      "第一,重构了大模型客户端,把超时、重试、限流统一收口到一处",
      "第二,新增结构化输出能力,业务可以直接拿到 Java 对象",
      "第三,补齐了链路追踪,每个请求都有 traceId,可以按 traceId 回放...",
      "上线后接口平均耗时从 1.8 秒降到 0.9 秒,失败率从 3.2% 降到 0...."
    ],
    "keywords": ["降到", "本次发布", "主要完成", "了三件事", "重构了大"],
    "chunked": false,
    "chunkCount": 1,
    "degraded": false
  }
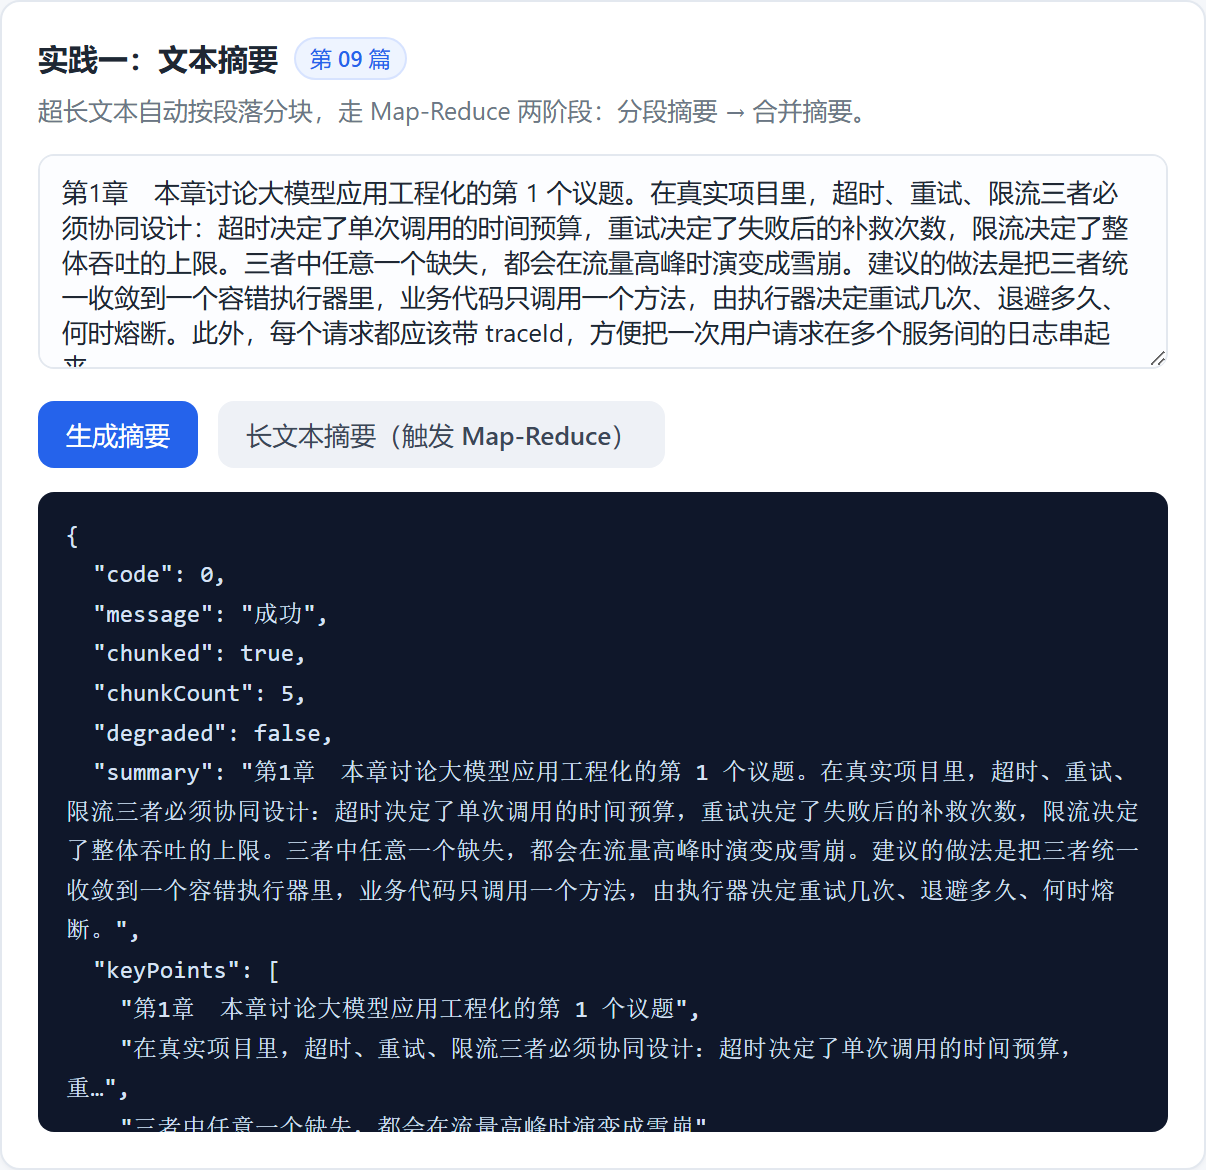
}长文本(chunked=true,输入 5166 字)
$ curl -X POST http://127.0.0.1:8080/ai/summarize -d '{...5166 字长文...}'
HTTP 200
{
  "code": 0,
  "traceId": "4ab1b5a9261d42b2",
  "data": {
    "summary": "第1章 本章讨论大模型应用工程化的第 1 个议题。在真实项目里,超时、重试、限流三者必须协同设计:超时决定了单次调用的时间预算,重试决定了失败后的补救次数,限流决定了整体吞吐的上限。三者中任意一个缺失,都会在流量高峰时演变成雪崩。建议的做法是把三者统一收敛到一个容错执行器里,业务代码只调用一个方法,由执行器决定重试几次、退避多久、何时熔断。",
    "keyPoints": [
      "第1章 本章讨论大模型应用工程化的第 1 个议题",
      "在真实项目里,超时、重试、限流三者必须协同设计:超时决定了单次调用的时间预算,重...",
      "三者中任意一个缺失,都会在流量高峰时演变成雪崩",
      "建议的做法是把三者统一收敛到一个容错执行器里,业务代码只调用一个方法,由执行器决...",
      "第6章 本章讨论大模型应用工程化的第 6 个议题"
    ],
    "keywords": ["决定", "重试", "三者", "执行器", "超时"],
    "chunked": true,
    "chunkCount": 5,
    "degraded": false
  }
}
5166 字切成 5 块,6 次调用(5 次 Map 加 1 次 Reduce),产出一篇全局摘要。
这里能清楚看到 mock 服务的语义局限:
keywords出现「了三件事」「重构了大」这种明显被硬切出来的碎片,summary也偏向复述第 1 块。原因很简单,mock 是规则引擎,不是真模型。
这恰好说明一个原则:教学环境可以用 mock 验证「链路对不对」,但绝不能用来「评估效果好不好」。评估摘要质量必须换真模型。
看日志确认分块
summary.chunked totalChars=5166 chunks=5演示页实拍
短文本摘要(chunked=false):
长文本触发 Map-Reduce(chunked=true, chunkCount=5):
七、常见坑
坑 1:按固定字符数硬切。
硬切会把一句话劈成两半,模型会据此编造。切块的第一原则是语义完整,不是长度均匀。
坑 2:Map 阶段忘了传「只总结本片段」的约束。
模型会跨块脑补,最终摘要里出现原文根本没有的内容。
坑 3:Token 统计只算了 Reduce,忘了 Map。
Map 阶段可能调用 N 次,这 N 次的 Token 都要累加。否则你看到的成本会远远低于真实成本,做预算时会严重误判。
坑 4:合并后的文本不做超长保护。
块数多的时候,merged 可能又超过 max-input-chars,Reduce 阶段直接报「输入过长」。
坑 5:把「摘要服务不可用」当成 500 抛给前端。
摘要是一个可以在降级下继续服务的能力。返回原文开头加 degraded=true,用户至少能看到点东西;直接抛异常,用户看到的就是白屏。
八、小结与下一篇
Map-Reduce 分块是处理超长输入的通用模式,不止用于摘要。长文问答、长文分类、长文翻译,都可以套这个骨架。
下一篇做内容分类:怎么把标签约束住(不让模型自创标签)、怎么用置信度决定是否需要人工介入,以及分类场景特有的兜底策略。