从单张推理到视频工程化:Ultralytics YOLO 批量处理与逐帧落地
前言:推理不只是"跑通一张图"
很多朋友在学会用 YOLO 做单张图片推理后,会觉得"模型能用了"。但当你真正要把视觉能力落地到业务里,问题才刚刚开始:
- 几百张图片,总不能一张张手动跑吧?批量一次
forward真的更快吗? - 检测结果出来了,怎么变成 CSV 给下游业务系统用?
- 视频要逐帧跑,满屏 30fps 每帧都推理太浪费,跳帧时框会不会一闪一闪消失?
这篇文章对照配套 notebook test_4.ipynb,把从 batch vs 逐张计时 → 目录批量导出 CSV → 视频逐帧检测并落盘 → 跳帧 + 复用上一帧标注 的完整链路走一遍。权重使用目录里实际存在的 yolov8n.pt(写成 yolo8n.pt 会直接 FileNotFoundError)。
一、如何做批量推理?
Ultralytics 的 predict 支持把多张图一次喂进去,用 batch= 控制每次 forward 的张数。
1.1 计时脚本在测什么
配套代码做了三件事:
- 不要污染验证集 :测试图写到独立目录
./bench_images,不要写进yolo_dataset/images/val。 - 没有现成图就造噪声图 :随机
uint8图也能走完整推理路径,专门用来比吞吐,不看检测质量。 - 预热可加、对比必须公平 :下面示例里逐张和 batch 都走
model.predict,并固定device=0、stream=False。
python
"""
batch vs 逐张推理 时间对比
"""
import time
from pathlib import Path

import cv2
import numpy as np
from ultralytics import YOLO

MODEL_PATH = "./yolov8n.pt"
NUM_IMAGES = 512
IMG_SIZE = 640
BATCH_SIZE = 64
TEST_DIR = Path("./bench_images")


def make_test_images(num=NUM_IMAGES, size=IMG_SIZE, out_dir=TEST_DIR):
    out_dir.mkdir(parents=True, exist_ok=True)
    existing = sorted(out_dir.glob("*.jpg"))
    if len(existing) >= num:
        print(f"[i] 已有 {len(existing)} 张测试图片,跳过生成")
        return existing[:num]

    print(f"[i] 生成 {num} 张 {size}x{size} 测试图片...")
    for i in range(num):
        img = np.random.randint(0, 255, (size, size, 3), dtype=np.uint8)
        cv2.imwrite(str(out_dir / f"test_{i:04d}.jpg"), img)
    return sorted(out_dir.glob("*.jpg"))[:num]


def bench_one_by_one(model, img_paths):
    """逐张推理:每次 forward 1 张"""
    t0 = time.perf_counter()
    for p in img_paths:
        model.predict(source=str(p), verbose=False, stream=False, device=0)
    return time.perf_counter() - t0


def bench_batch(model, img_paths, batch_size):
    """batch 推理:一次调用里按 batch_size 切分 forward"""
    t0 = time.perf_counter()
    model.predict(
        source=[str(p) for p in img_paths],
        batch=batch_size,
        verbose=False,
        stream=False,
        device=0,
    )
    return time.perf_counter() - t0


img_paths = make_test_images()
n = len(img_paths)
model = YOLO(MODEL_PATH)

t_one = bench_one_by_one(model, img_paths)
t_batch = bench_batch(model, img_paths, BATCH_SIZE)

print(f"逐张总耗时 : {t_one:.3f} s  |  {n / t_one:.1f} img/s")
print(f"Batch 总耗时: {t_batch:.3f} s  |  {n / t_batch:.1f} img/s")
print(f"加速比     : {t_one / t_batch:.2f}x")
1.2 一次实测结果(不要照抄成结论)
在本机 notebook 里,512 张 640×640、yolov8n.pt、batch=64 的结果是:
| 方式 | 总耗时 | 平均每张 | 吞吐 |
|---|---|---|---|
| 逐张(每次 1 张) | 4.818 s | 9.41 ms | 106.3 img/s |
| Batch=64 | 4.721 s | 9.22 ms | 108.4 img/s |
加速比大约 1.02x ,只省了约 2% 时间。这说明:当单张已经很快(小模型 + GPU 已经吃得较满、或 I/O / 后处理占比高)时,加大 batch 未必有数量级提升。换更大模型、更大分辨率、更慢的磁盘,数字会完全不一样------所以工程里要把这段基准留下来,改配置后重跑。
关键点 :batch 是"一次 predict 调用内部每次 forward 的张数";
二、图片批量推理:从文件夹到 CSV
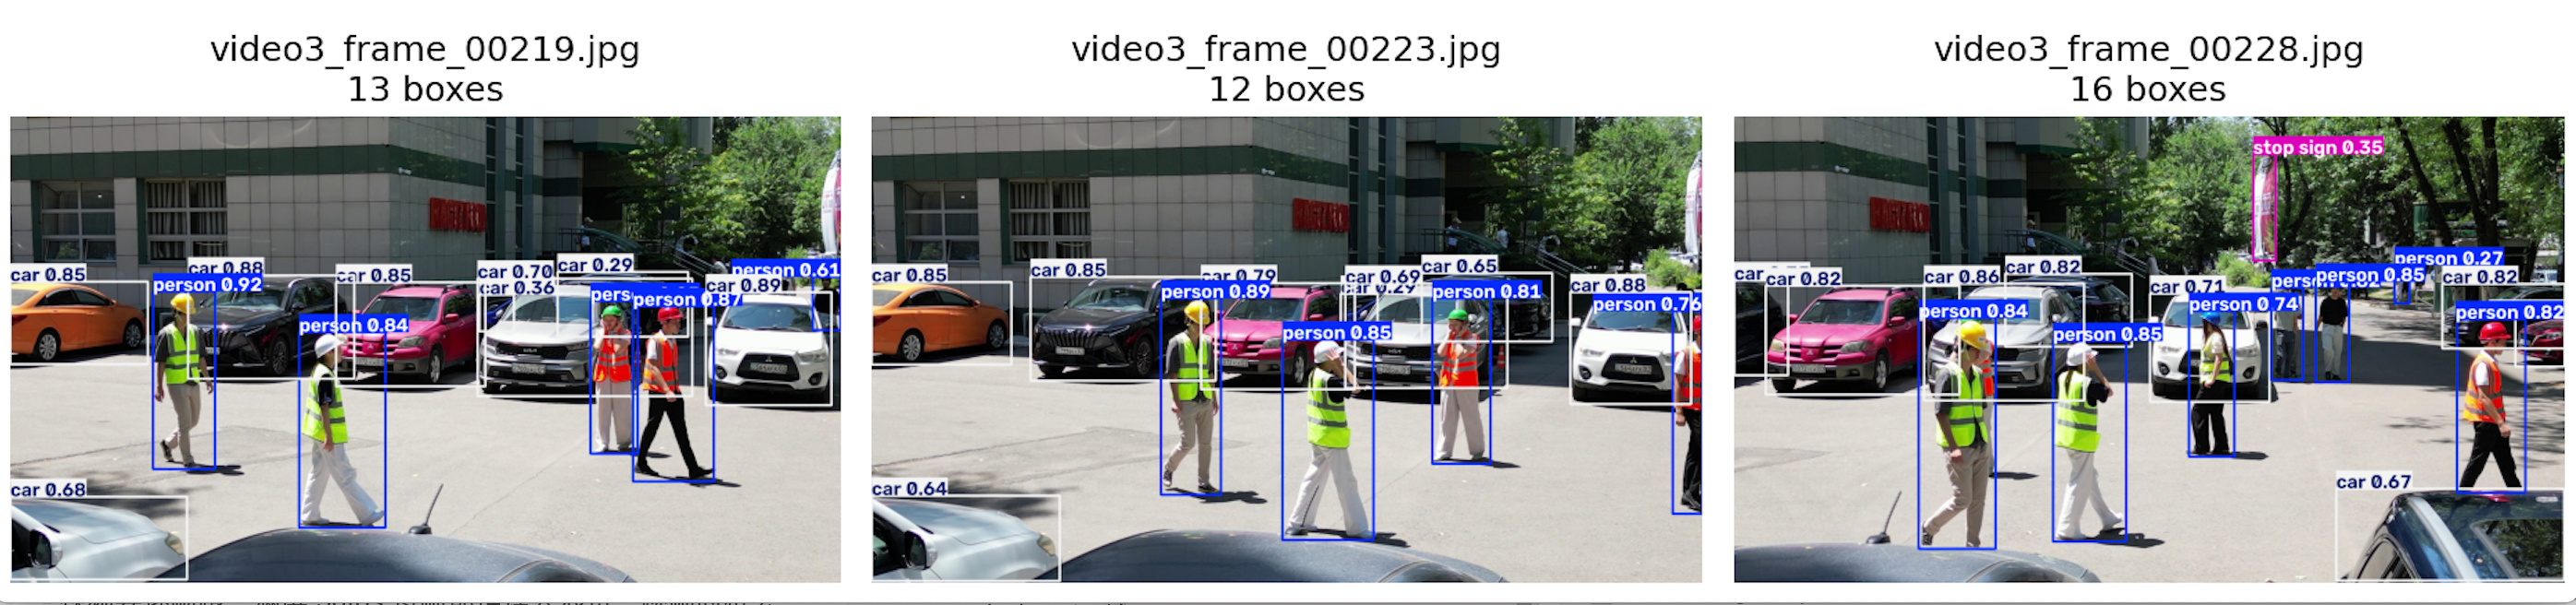
可视化图片只是给人看的,业务系统通常要结构化记录:哪张图、什么类、置信度、框坐标。下面三张来自 yolo_dataset/images/val,conf=0.25 时每张大约十几个框(人、车为主):
2.1 目录预测
predict 可以直接吃目录或文件列表,不必自己写读图循环。需要自定义字段时,遍历 Results.boxes 比依赖 to_csv() 更稳(旧版本没有这些方法):
python
import csv
from pathlib import Path
from ultralytics import YOLO

model = YOLO("yolov8n.pt")
image_dir = Path("./yolo_dataset/images/val")

image_files = list(image_dir.glob("*.jpg")) + list(image_dir.glob("*.png"))

with open("detections.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["image", "class_id", "class_name", "conf", "x1", "y1", "x2", "y2"])

    results = model.predict(source=image_files, stream=True, conf=0.25, verbose=False)

    for r in results:
        image_name = Path(r.path).name
        boxes = r.boxes
        if boxes is None:
            continue
        for box in boxes:
            x1, y1, x2, y2 = box.xyxy[0].tolist()
            conf = float(box.conf[0])
            cls_id = int(box.cls[0])
            cls_name = model.names[cls_id]
            writer.writerow([image_name, cls_id, cls_name, conf, x1, y1, x2, y2])

print("CSV 已生成:detections.csv")写出后每一行对应一个检测框(不是一张图一行)。
关键点 :stream=True 让 results 变成生成器,逐张写出 CSV,不会一次性把所有 Results 堆在内存里。几百上千张图时,这是避免 OOM 的常规设置。注意它和上一节的 batch= 可以同时存在,职责不同:一个管吞吐,一个管内存。
三、视频逐帧推理:先能写出文件,再谈窗口
用 OpenCV 读帧 + 逐帧 model(frame) 最可控:输入可以是本地文件、摄像头编号或 RTSP。落地时有两件比"会调用 imshow"更重要的事。
3.1 写出视频时的三个坑
- 打开失败要立刻报错 ,不要带着坏的
VideoCapture空转。 - 部分视频
CAP_PROP_FPS会是 0 ,写出时退回 25,否则VideoWriter参数非法。 VideoWriter的宽高必须和即将write的图一致 ,否则经常是静默失败、文件打不开或几乎是空的。plot()默认不改分辨率,用原视频的w, h即可。
另外:循环结束后一定要 cap.release() / out.release(),否则 mp4 可能无法播放。读到文件尾 ret=False 就停。
python
import os
from pathlib import Path

import cv2
from ultralytics import YOLO

HAS_DISPLAY = bool(os.environ.get("DISPLAY"))

VIDEO_IN = Path("video.mp4")
VIDEO_OUT = Path("yolo_video_out.mp4")

model = YOLO("./yolov8n.pt")

cap = cv2.VideoCapture(str(VIDEO_IN))
if not cap.isOpened():
    raise RuntimeError(f"无法打开视频:{VIDEO_IN}")

fps = cap.get(cv2.CAP_PROP_FPS) or 25
w = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
h = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
out = cv2.VideoWriter(
    str(VIDEO_OUT),
    cv2.VideoWriter_fourcc(*"mp4v"),
    fps,
    (w, h),
)

n = 0
while True:
    ret, frame = cap.read()
    if not ret:
        break

    results = model(frame, verbose=False)
    annotated = results[0].plot()  # 在拷贝上画框,不改原 frame
    out.write(annotated)
    n += 1

    if HAS_DISPLAY:
        cv2.imshow("YOLO", annotated)
        if cv2.waitKey(1) & 0xFF == ord("q"):
            break

cap.release()
out.release()
if HAS_DISPLAY:
    cv2.destroyAllWindows()

print(f"处理 {n} 帧,已保存:{VIDEO_OUT.resolve()}")
本机对 video.mp4 跑完约 297 帧 ,输出 yolo_video_out.mp4。解码阶段有时会刷 Invalid NAL unit size 一类 h264 警告,多半是源视频封装不规范;只要 VideoCapture 能打开、帧数对得上、输出能播,可以先当噪声日志,不必和检测逻辑绑在一起排查。
model(frame) 与 model.predict(source=frame) 等价;verbose=False 避免每帧刷日志。frame 是 BGR 的 numpy 数组,形状 (H, W, 3)。
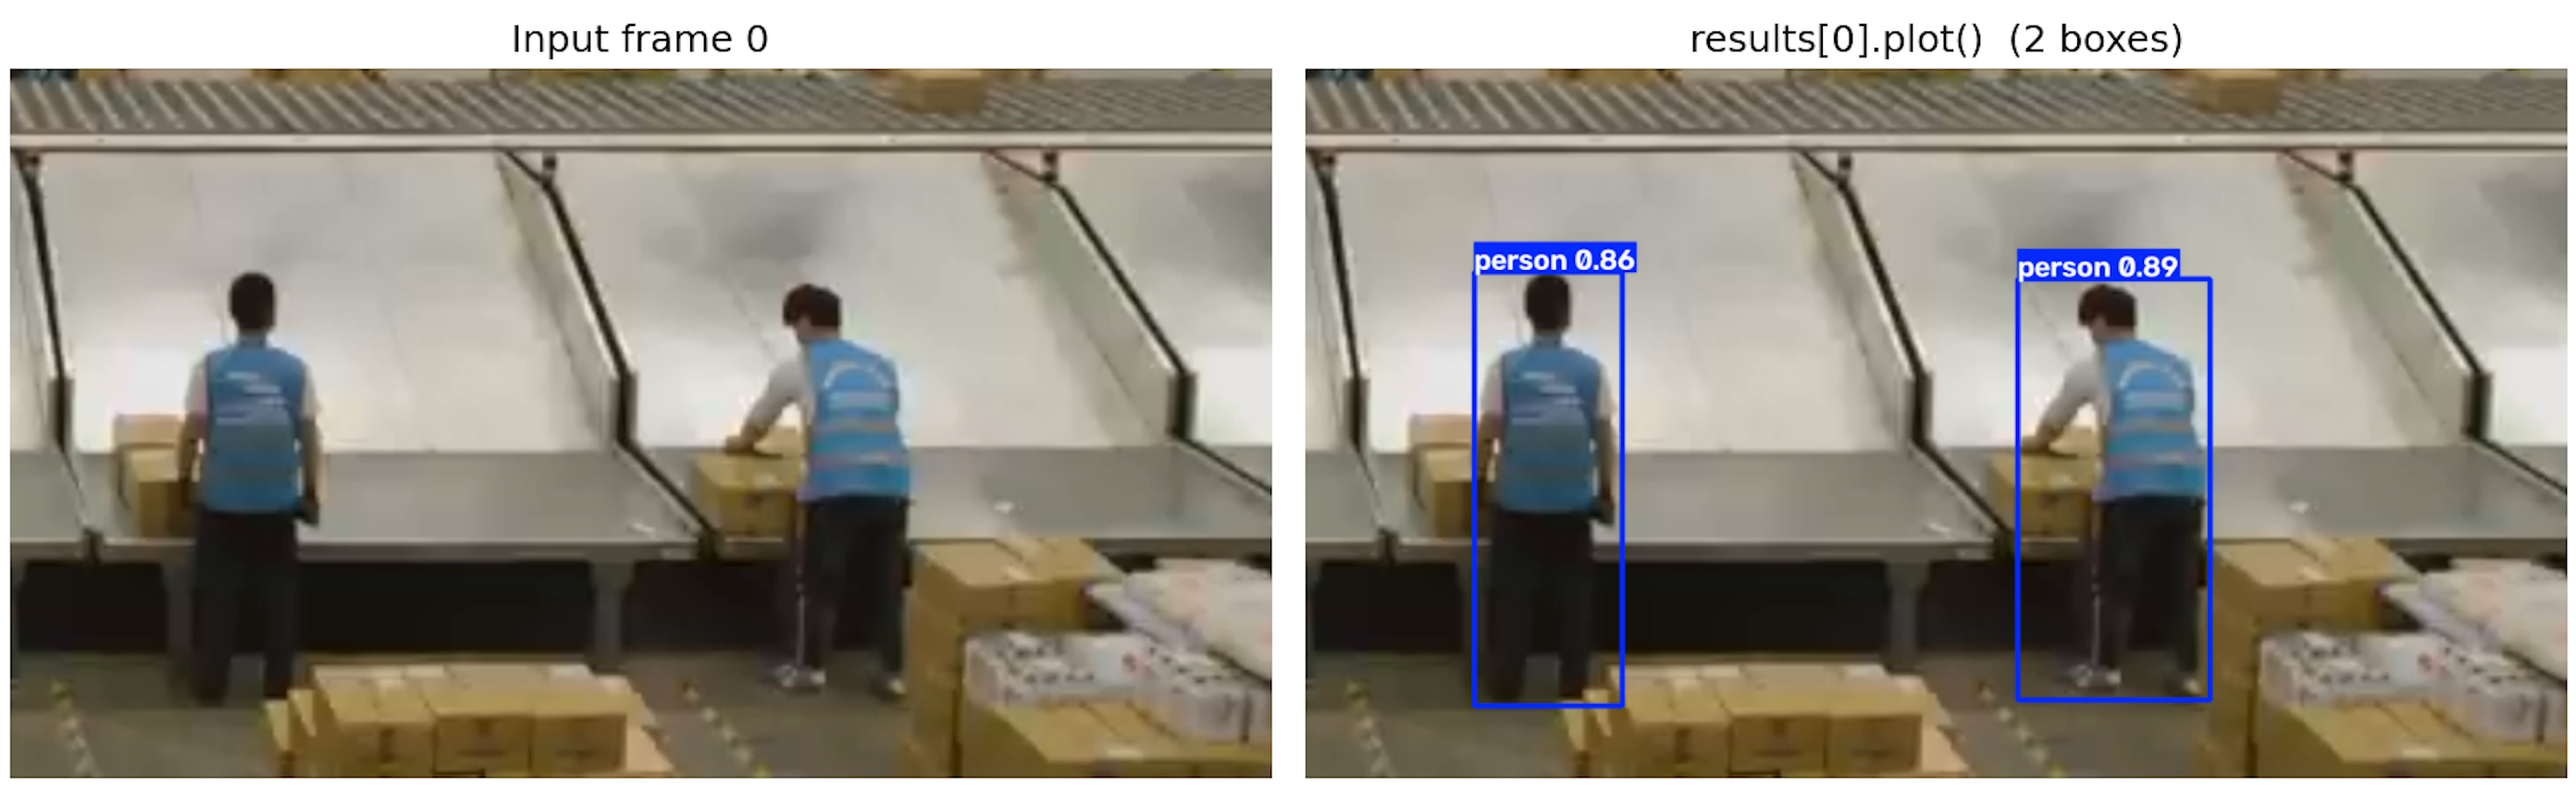
video.mp4 第 0 帧原图 vs plot() 之后(本例检出 2 个 person):
四、跳帧检测:省算力,但不要让框闪没
视频 30fps 时相邻帧差异很小,连续每帧推理往往是在重复上一帧的结论。STRIDE=3 表示只在第 0、3、6、... 帧做推理,297 帧大约只检测 99 帧。
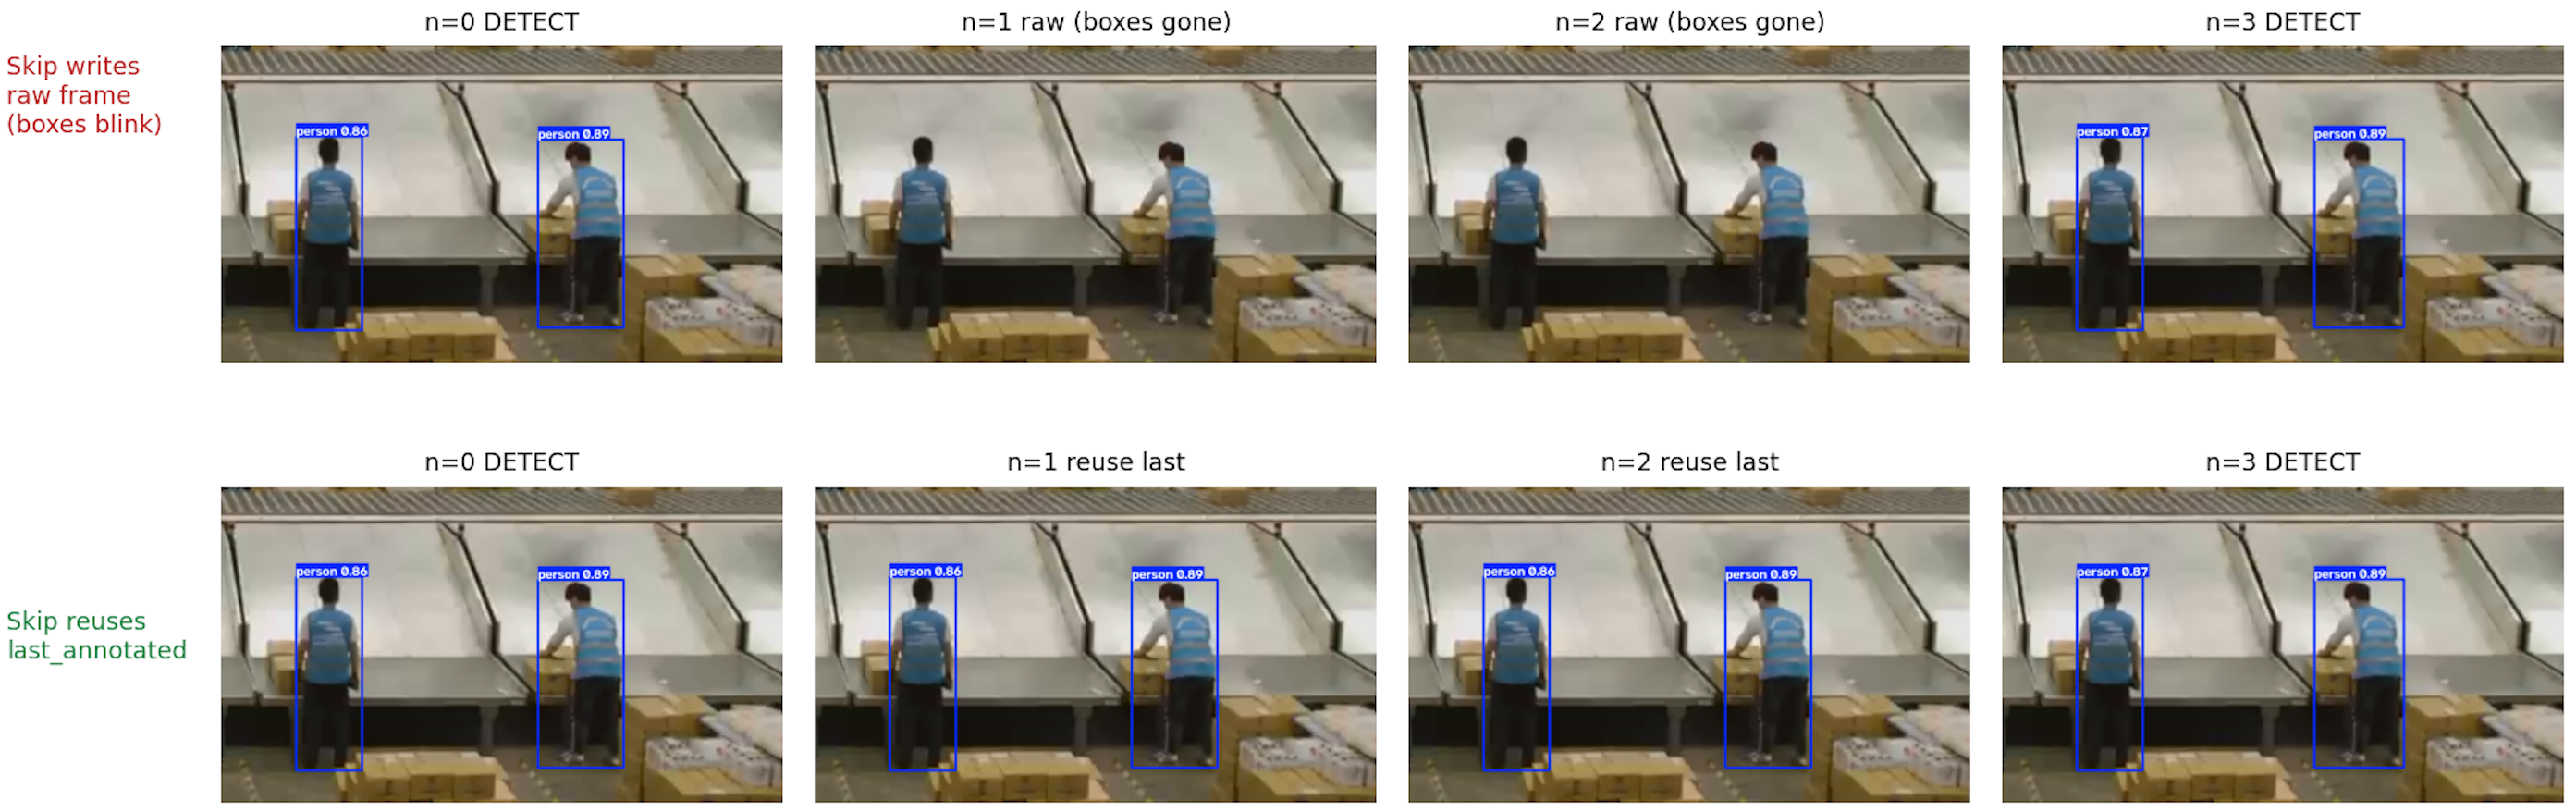
Ultralytics 的 predict 也有 vid_stride,但自己用 OpenCV 控跳帧更灵活:跳过的帧可以复用上一帧的标注图,而不是直接写原图------否则检测框会按 stride 周期"闪一下又消失",观感比省下的算力更糟。
下图用 video.mp4 前 4 帧、STRIDE=3 对比两种写法:上行把跳过的帧写成原图,框在 n=1、n=2 消失;下行缓存 last_annotated,框一直在。
python
import os
from pathlib import Path

import cv2
from ultralytics import YOLO

HAS_DISPLAY = bool(os.environ.get("DISPLAY"))

VIDEO_IN = Path("video.mp4")
VIDEO_OUT = Path("yolo_video_out_STRIDE.mp4")
STRIDE = 3  # 1 等价于逐帧;3 表示每 3 帧检测一次

model = YOLO("./yolov8n.pt")

cap = cv2.VideoCapture(str(VIDEO_IN))
if not cap.isOpened():
    raise RuntimeError(f"无法打开视频:{VIDEO_IN}")

fps = cap.get(cv2.CAP_PROP_FPS) or 25
w = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
h = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
out = cv2.VideoWriter(
    str(VIDEO_OUT),
    cv2.VideoWriter_fourcc(*"mp4v"),
    fps,
    (w, h),
)

n = 0
n_detected = 0
last_annotated = None

while True:
    ret, frame = cap.read()
    if not ret:
        break

    if n % STRIDE == 0:
        results = model(frame, verbose=False)
        annotated = results[0].plot()
        last_annotated = annotated
        n_detected += 1
    else:
        annotated = last_annotated if last_annotated is not None else frame

    out.write(annotated)
    n += 1

    if HAS_DISPLAY:
        cv2.imshow("YOLO", annotated)
        if cv2.waitKey(1) & 0xFF == ord("q"):
            break

cap.release()
out.release()
if HAS_DISPLAY:
    cv2.destroyAllWindows()

print(
    f"处理 {n} 帧,其中检测 {n_detected} 帧(STRIDE={STRIDE}),"
    f"已保存:{VIDEO_OUT.resolve()}"
)
因为循环从 n=0 开始,第一帧一定会被检测,last_annotated 随后才有缓存。跳过的帧写的是上一检测帧的画面 ,目标快速移动时框会略滞后,这是用吞吐换平滑度的代价;若要框跟着当前像素走,需要光流或跟踪,那是下一步,不是单纯 STRIDE 能解决的。
五、总结
这篇文章把 YOLO 从"单张跑通"推进到了"批量可导出、视频可落盘、跳帧可复用"的工程化闭环,但真正的落地远不止这几步:批量推理的加速比要靠基准说话,CSV 只是给下游系统的第一手结构化数据,视频逐帧则要先把打开失败、FPS 为 0、宽高不一致这些坑填平。跳帧复用上一帧标注,是用少量滞后换明显算力节省的务实取舍,而要让框真正跟住快速运动的目标,就得引入光流或跟踪------那是另一层工程问题。下一步,不妨把这套链路接到你自己的数据上,把计时、导出、跳帧参数都跑一遍,再决定哪些优化值得留在生产环境里。