🔥草莓熊Lotso: 个人主页
❄️个人专栏: 《C++知识分享》 《Linux 入门到实践:零基础也能懂》
✨生活是默默的坚持,毅力是永久的享受!
🎬 博主简介:
文章目录
- 前言:
- [一. 认识主从复制](#一. 认识主从复制)
-
- [1.1 核心概念](#1.1 核心概念)
- [1.2 解决的两个核心问题](#1.2 解决的两个核心问题)
- [二. 主从复制配置与基础操作](#二. 主从复制配置与基础操作)
-
- [2.1 启动多实例](#2.1 启动多实例)
- [2.2 建立主从关系](#2.2 建立主从关系)
- [2.3 查看主从状态](#2.3 查看主从状态)
- [2.4 断开与切换主从](#2.4 断开与切换主从)
- [2.5 安全、只读与传输优化](#2.5 安全、只读与传输优化)
- [三. 主从复制的拓扑结构](#三. 主从复制的拓扑结构)
-
- [3.1 一主一从](#3.1 一主一从)
- [3.2 一主多从](#3.2 一主多从)
- [3.3 树形结构](#3.3 树形结构)
- [四. 主从复制的完整建立流程](#四. 主从复制的完整建立流程)
- [五. PSYNC 同步协议](#五. PSYNC 同步协议)
-
- [5.1 两个核心标识](#5.1 两个核心标识)
- [5.2 PSYNC 的三种响应](#5.2 PSYNC 的三种响应)
- [六. 三种复制模式详解](#六. 三种复制模式详解)
-
- [6.1 全量复制](#6.1 全量复制)
- [6.2 部分复制](#6.2 部分复制)
- [6.3 实时复制](#6.3 实时复制)
- [七. 主从复制小结与常见问题](#七. 主从复制小结与常见问题)
-
- [7.1 优缺点总结](#7.1 优缺点总结)
- [7.2 关于从节点晋升](#7.2 关于从节点晋升)
- [7.3 常见排坑:多实例启动失败](#7.3 常见排坑:多实例启动失败)
- 结尾:
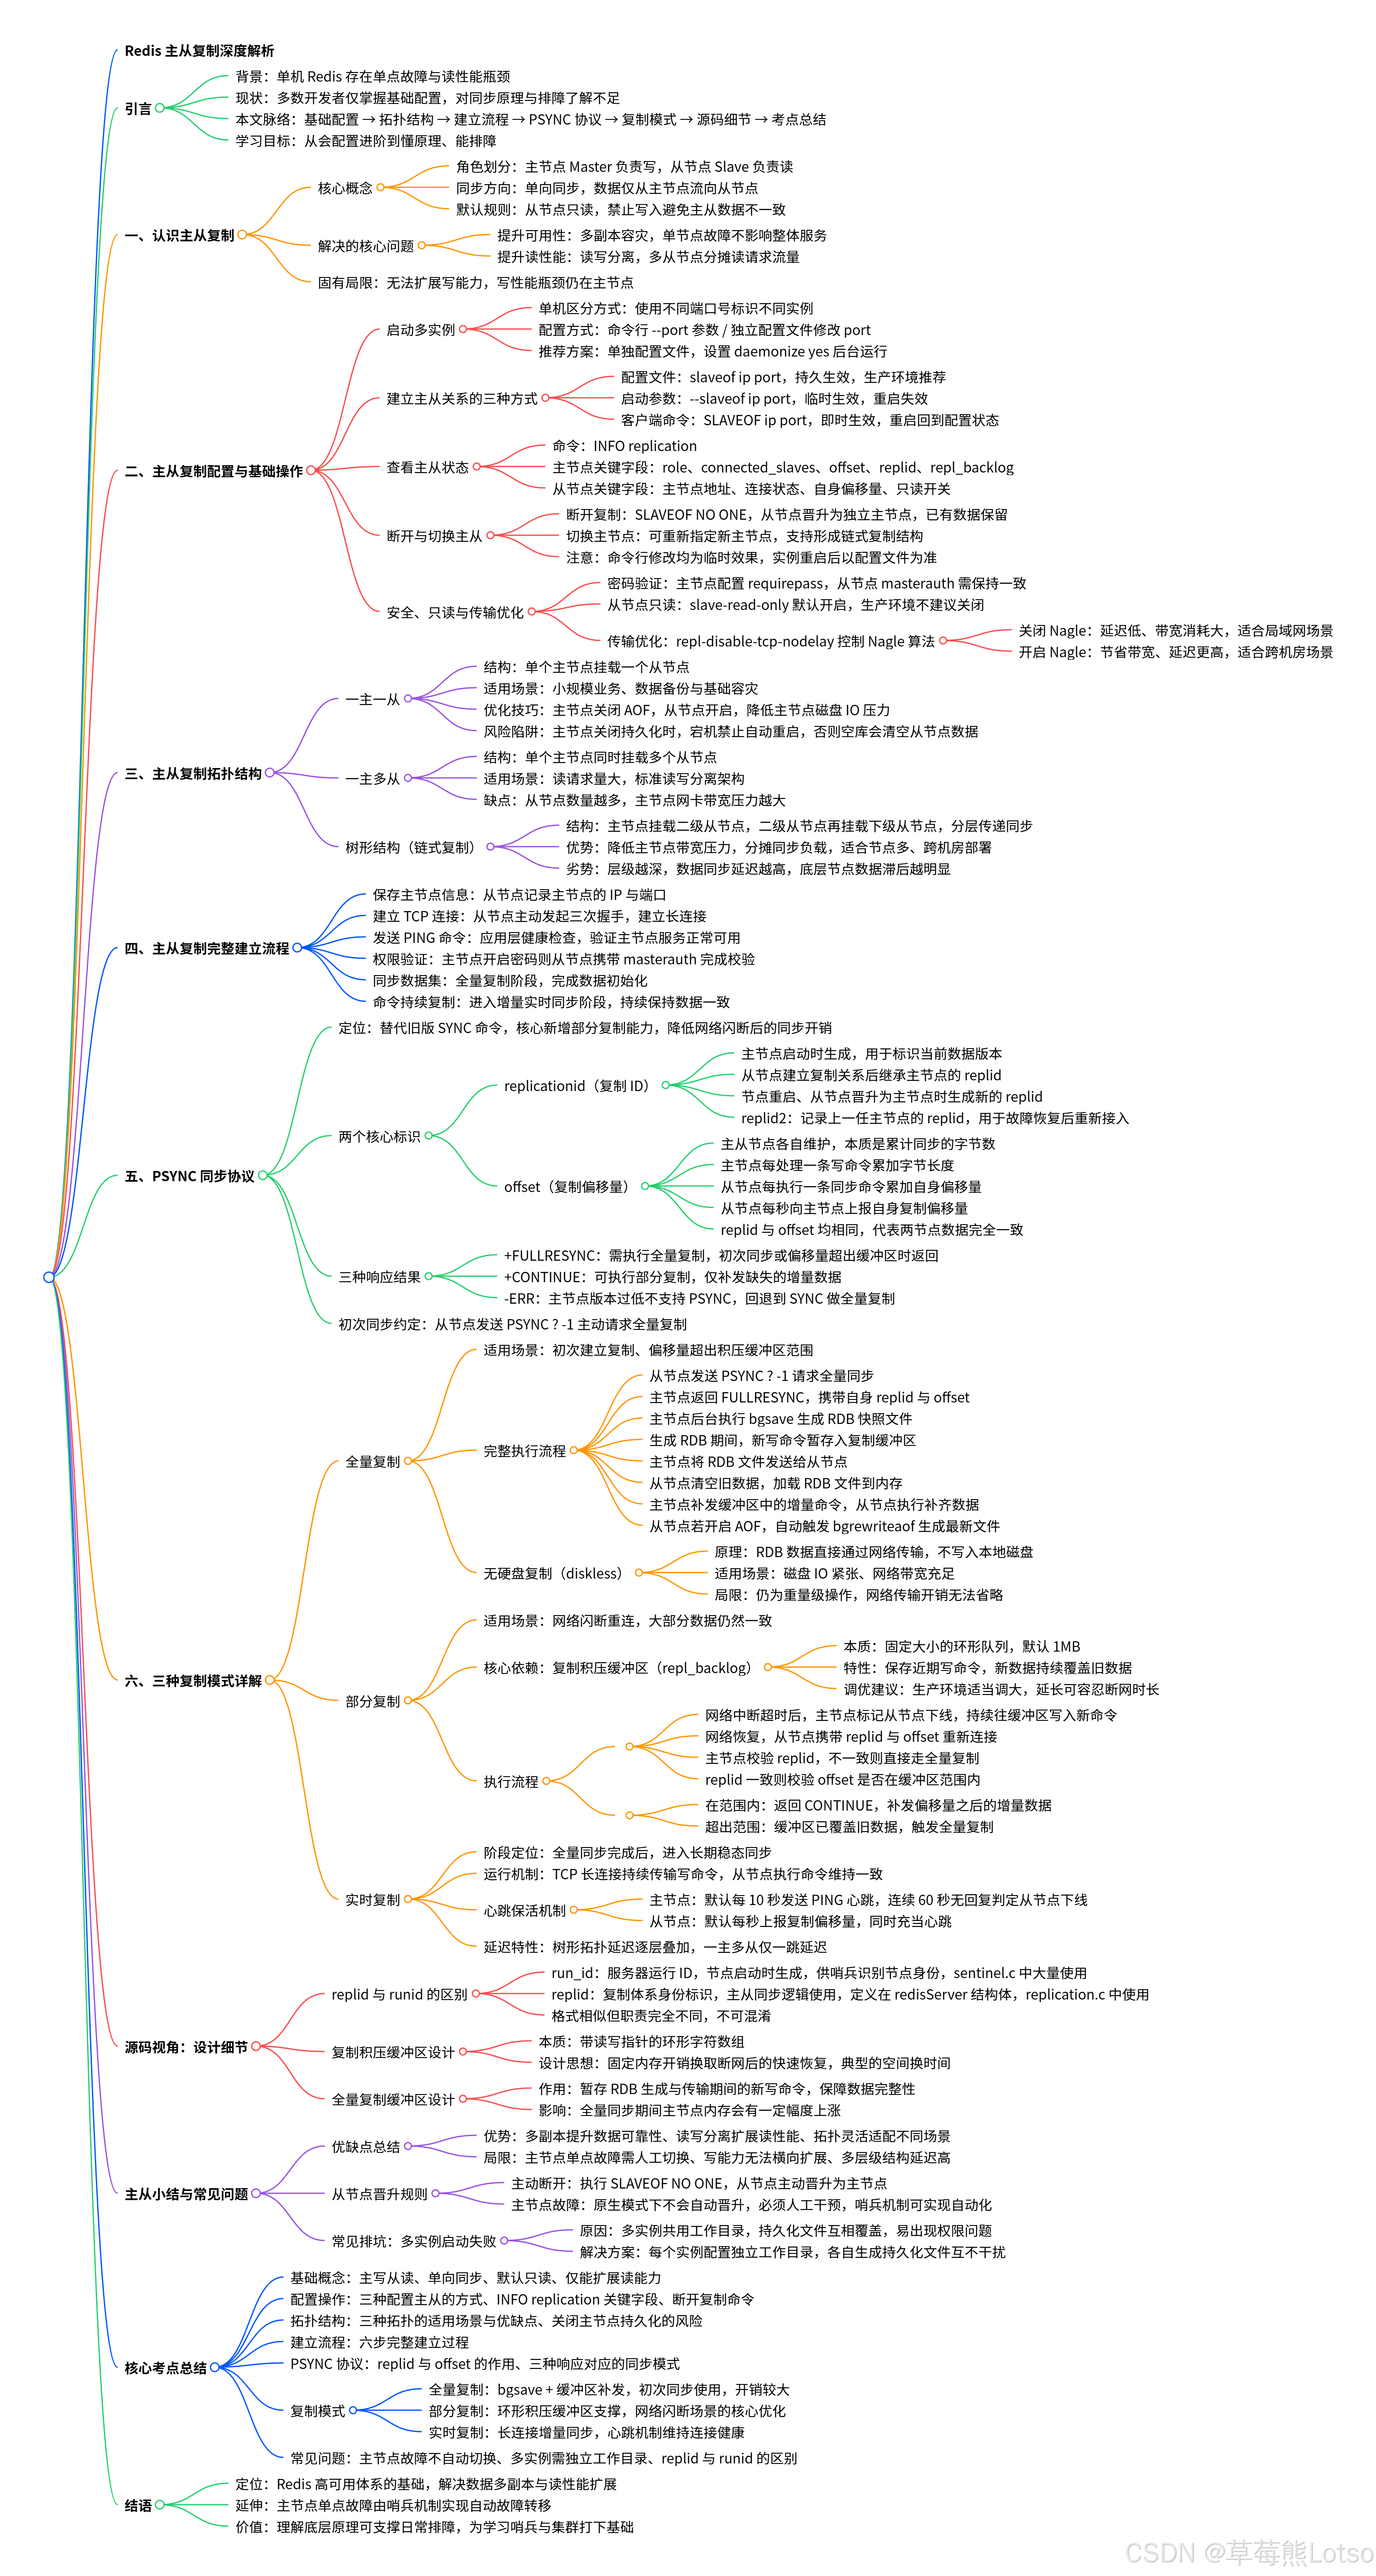
前言:
单机 Redis 虽然性能强劲,但天然存在两个无法回避的短板:一是单点故障,机器宕机则服务完全中断;二是性能上限,单节点能承载的读并发终究有瓶颈。主从复制就是解决这两个问题的基础方案:通过数据多副本实现读写分离,同时为后续的故障转移打下基础。很多开发者配置主从只会在配置文件加一行
slaveof,遇到主从不一致、频繁全量同步、复制延迟等问题时就无从下手。实际上主从复制背后有一套完整的机制:从初次全量同步到网络闪断后的部分续传,从积压缓冲区到心跳保活,每一环都有明确的设计逻辑。本文从基础概念与配置落地讲起,逐一拆解三种拓扑结构、完整同步流程、PSYNC 协议原理,以及全量、部分、实时三种复制模式的底层细节,最后结合源码视角与常见排坑,帮你把主从复制从「会配置」吃透到「懂原理、能排障」。
一. 认识主从复制
1.1 核心概念
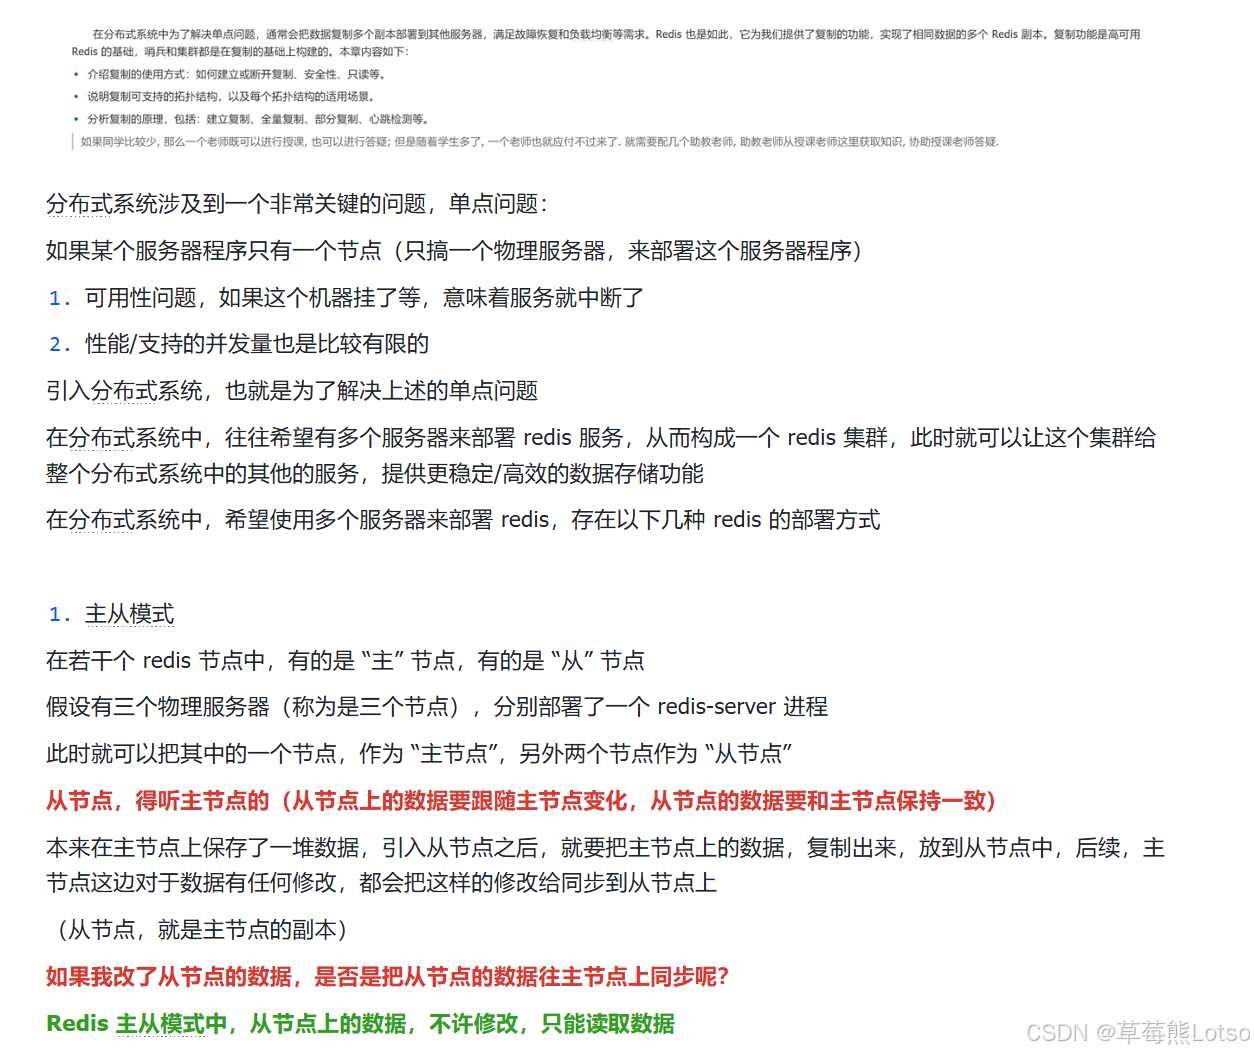
主从模式下,Redis 节点分为两种角色:
- 主节点(Master):负责处理所有写请求,也可以处理读请求;数据发生修改后,主动将变更同步给所有从节点。
- 从节点(Slave):从主节点同步数据,默认只读,不可写入;对外提供读服务,分担主节点的读压力。
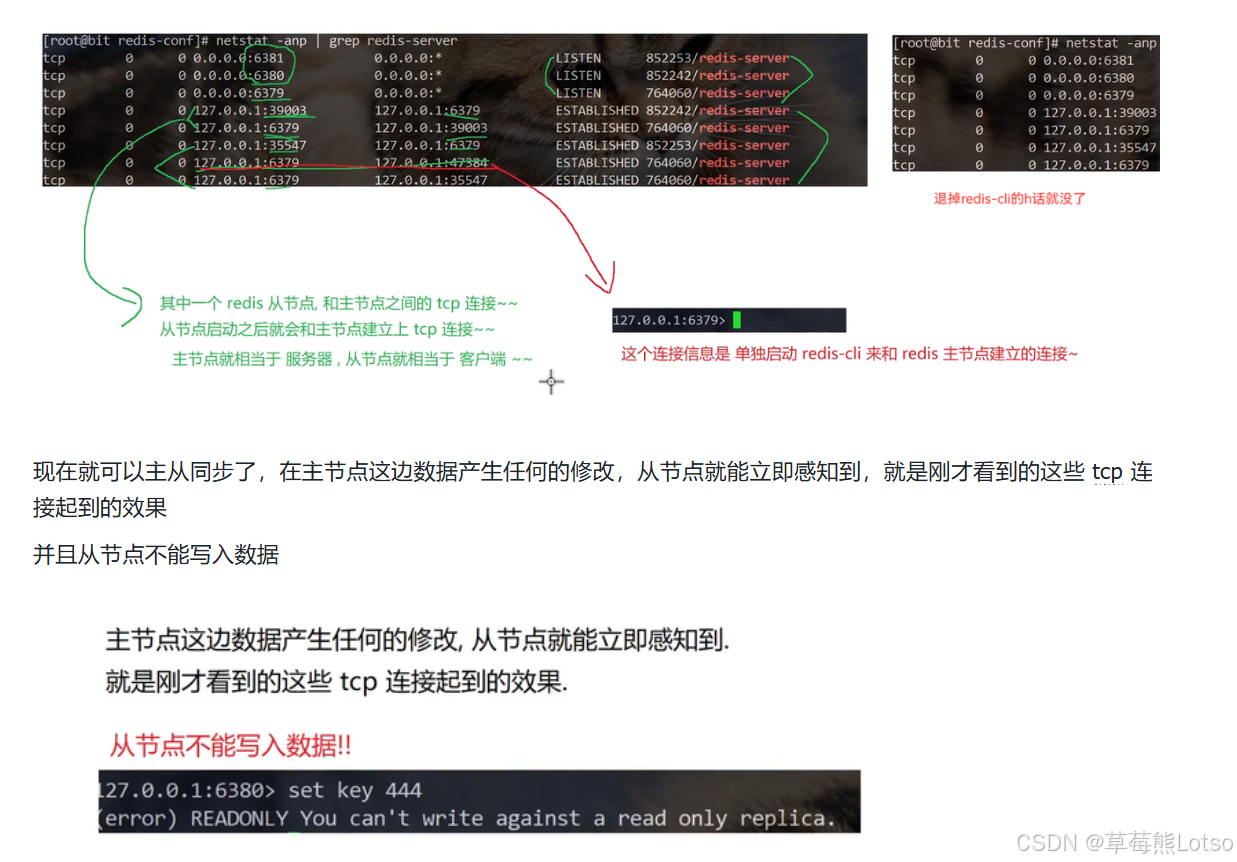
同步方向是单向的:只能从主节点同步到从节点,从节点的修改不会反向同步给主节点。也正因如此,默认从节点被配置为只读,避免人为写入造成主从数据不一致。
1.2 解决的两个核心问题
- 提升可用性 单节点挂了整个服务就不可用;主从架构下,单个从节点挂了不影响整体服务,主节点挂了也可以手动将从节点晋升为主节点,快速恢复服务。当然,原生主从模式不支持自动故障转移,需要人工干预,这也是后续哨兵机制要解决的问题。
- 提升读性能 实际业务中读请求量通常远大于写请求。通过多个从节点分担读流量,可以大幅提升整体的并发承载能力,实现读写分离。
注意:主从模式只能扩展读能力,无法扩展写能力。所有写请求仍然落在主节点上,写性能瓶颈仍然受限于单主节点。
二. 主从复制配置与基础操作
2.1 启动多实例
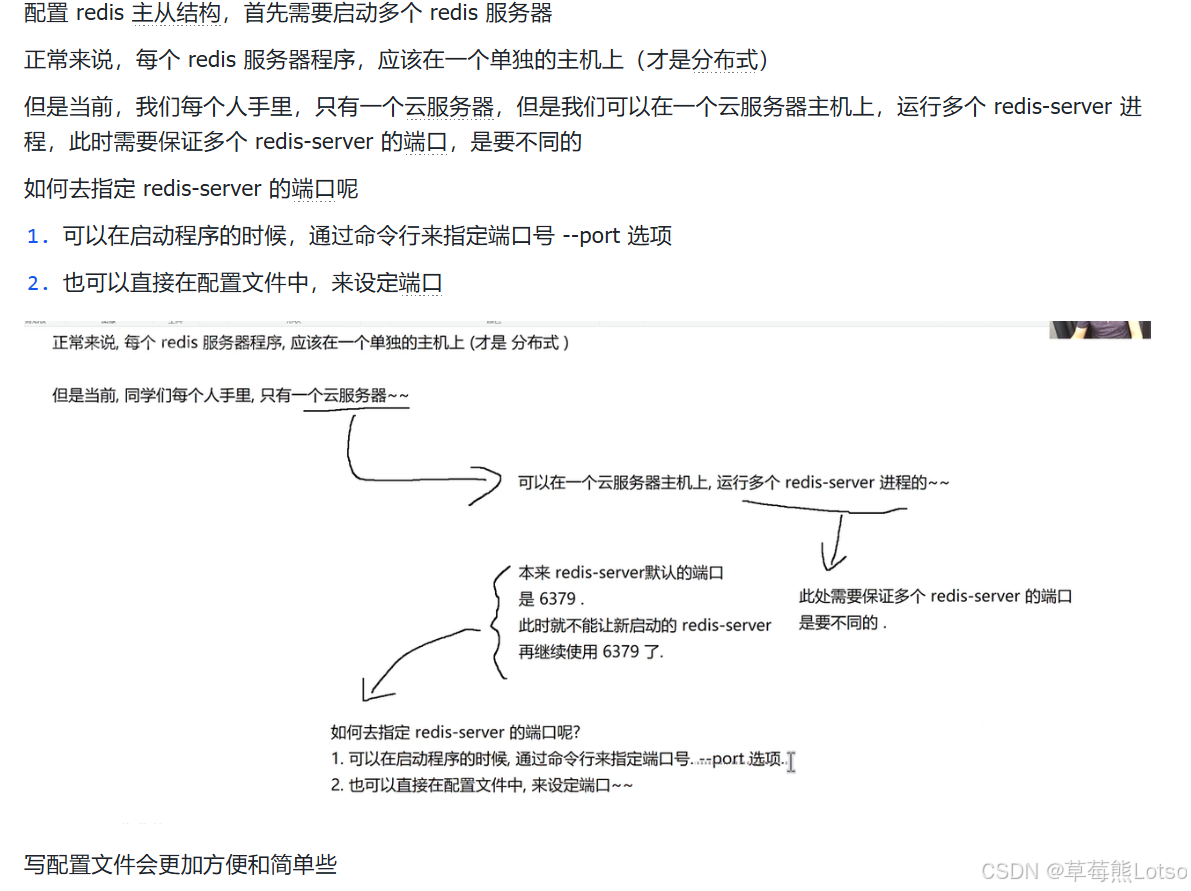
要搭建主从,首先要运行多个 Redis 实例。单机环境下通过不同端口区分,有两种配置方式:
- 命令行启动时指定
--port参数; - 为每个实例单独准备配置文件,修改
port字段,更推荐也更规范。
以一主两从为例,主节点用默认 6379 端口,两个从节点分别用 6380、6381 端口,同时将 daemonize yes 设为后台运行。
2.2 建立主从关系
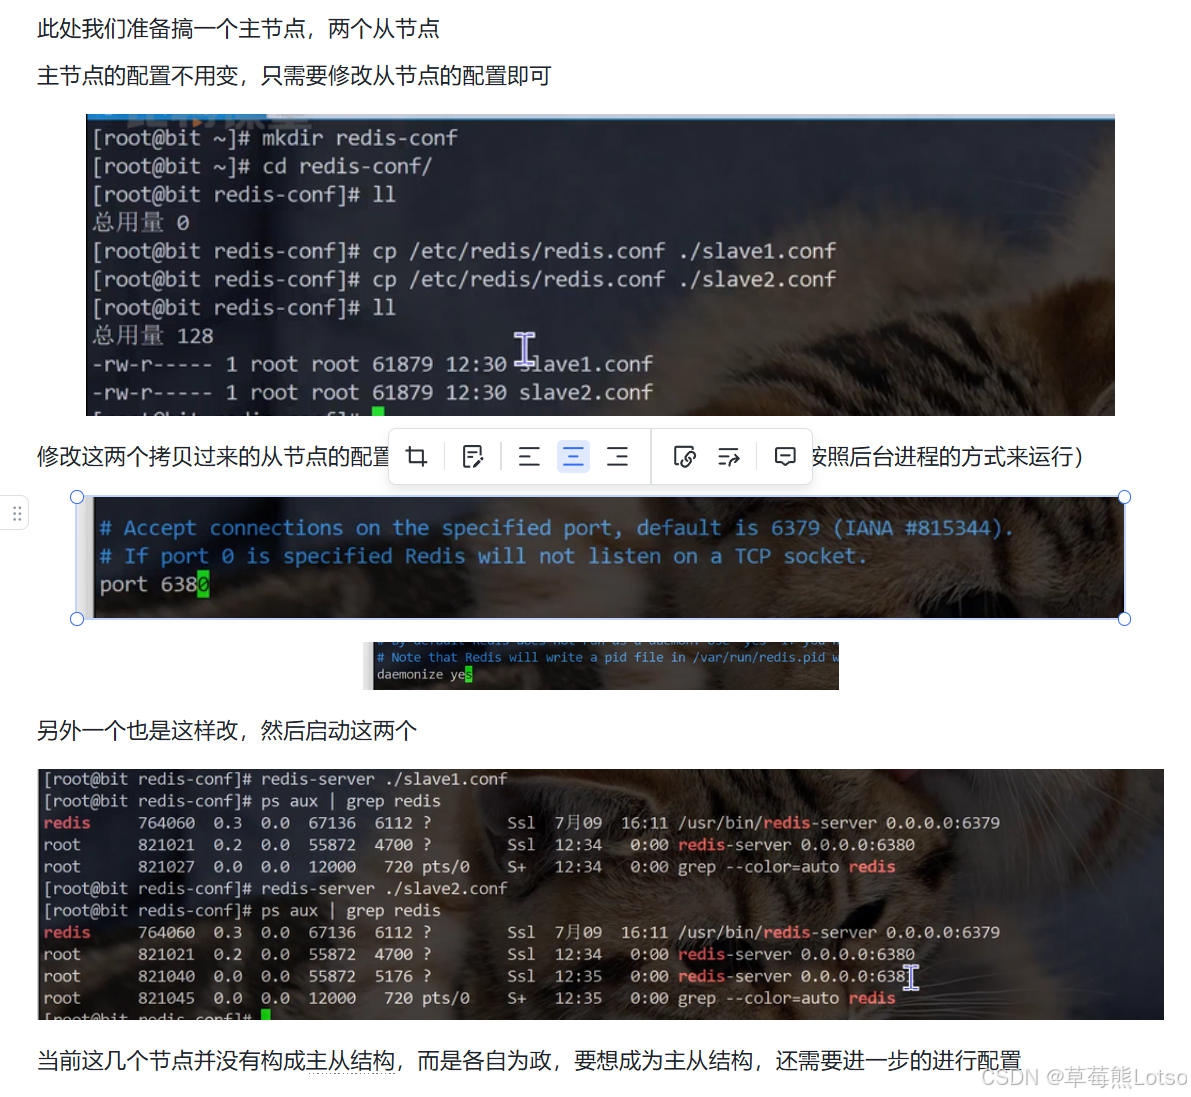
配置主从关系有三种方式,效果一致,生效周期不同:
-
配置文件(推荐,持久生效) 在从节点配置文件中加入:
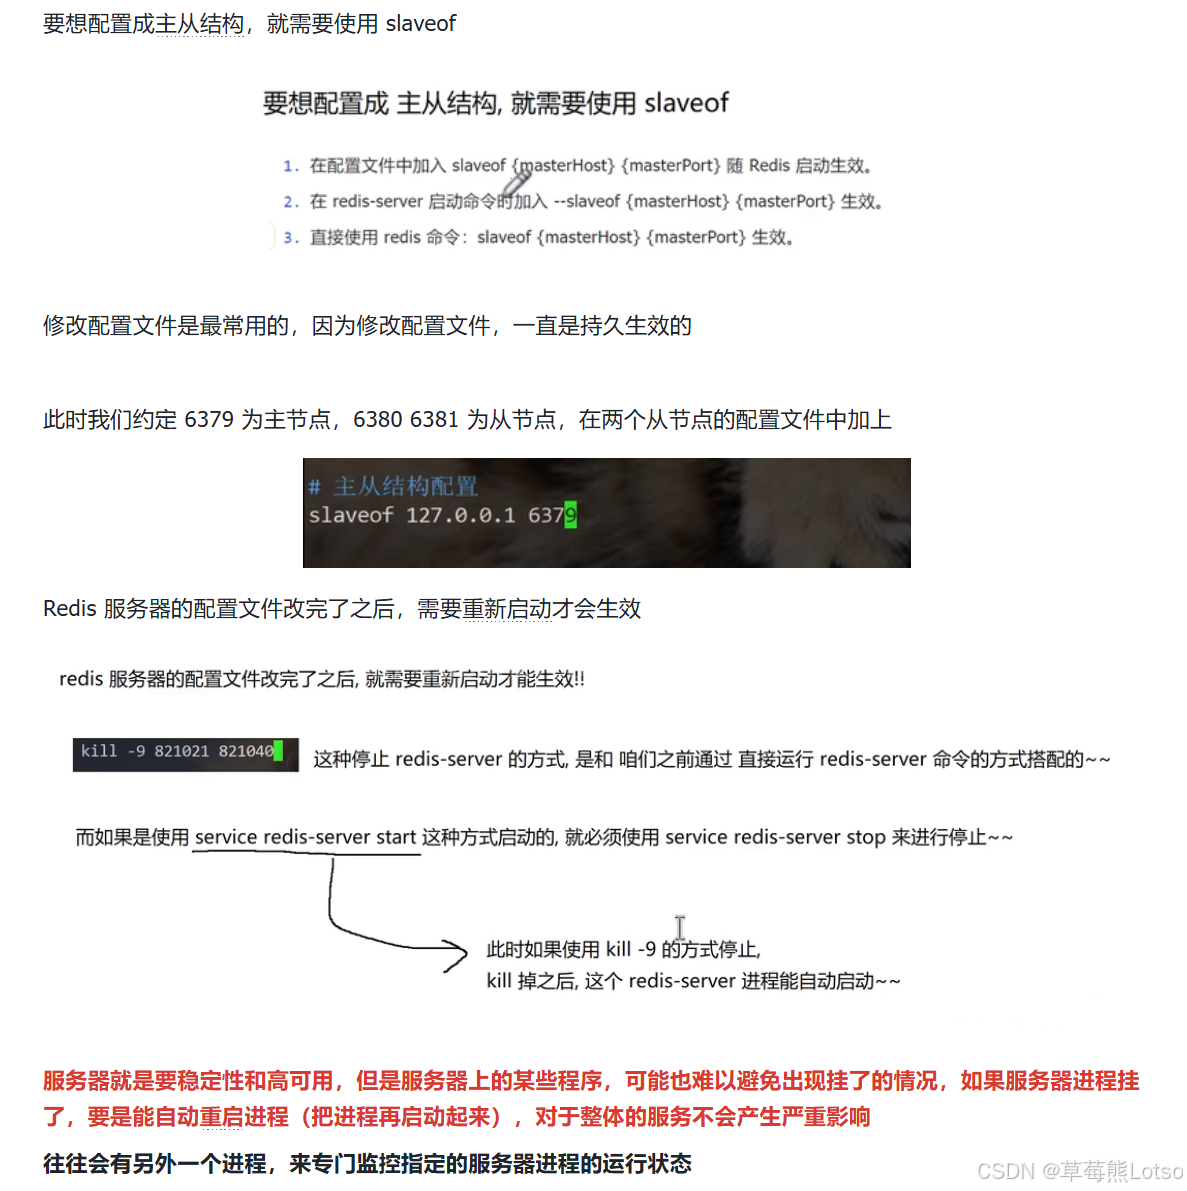
1.Plainslaveof 127.0.0.1 6379- 重启后永久生效,是生产环境的标准做法。
-
启动参数(临时) 启动时追加参数:
redis-server --slaveof 127.0.0.1 6379 -
客户端命令(临时) 连接到从节点后直接执行:
1.bash127.0.0.1:6380> SLAVEOF 127.0.0.1 6379 OK- 命令方式修改是即时生效的,但实例重启后会失效,回到配置文件中的设定。
2.3 查看主从状态
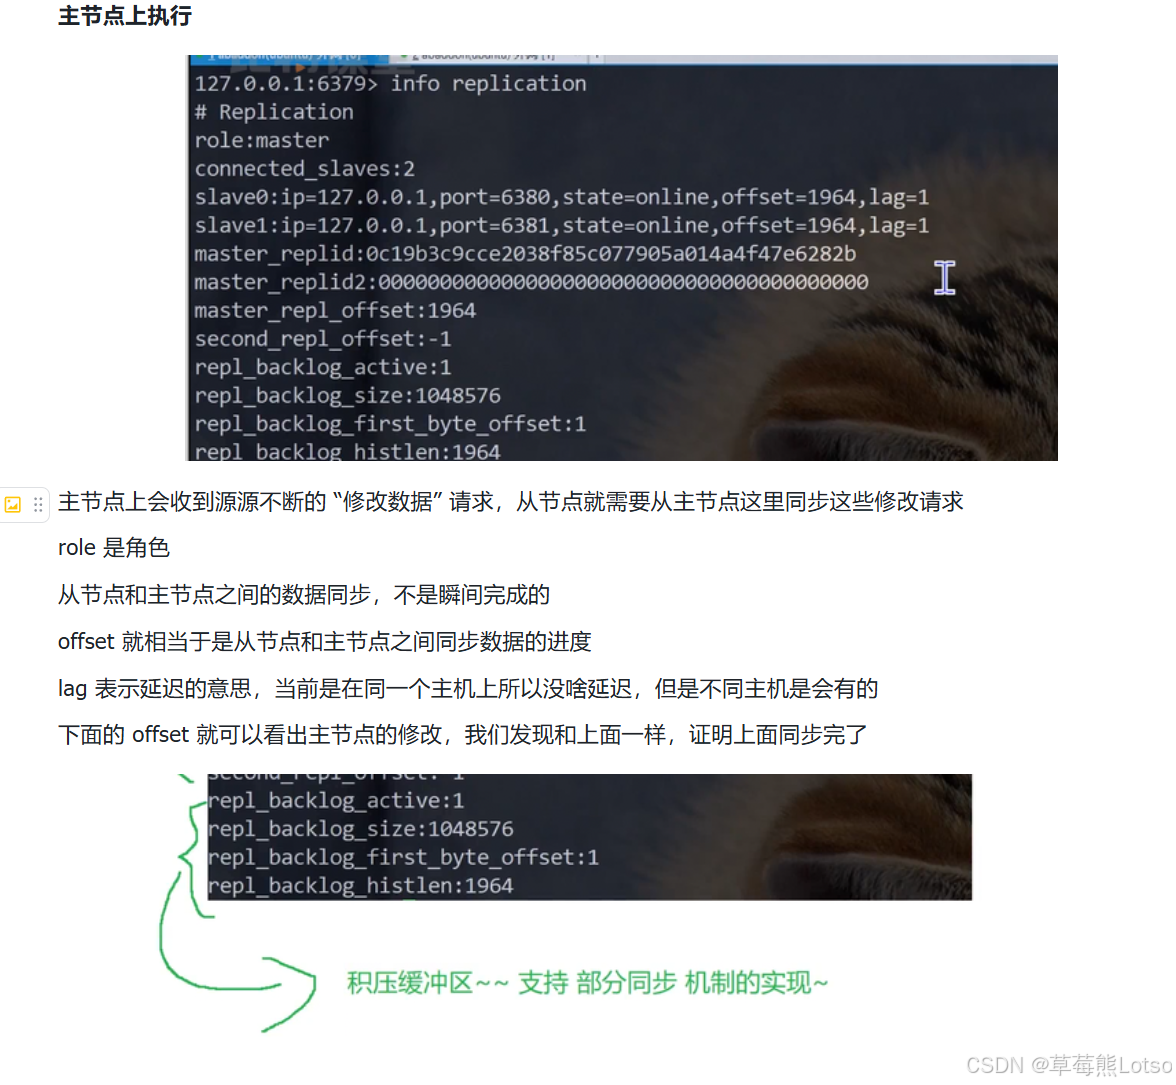
使用 INFO replication 命令可以查看完整的复制信息。
主节点视角:
bash
127.0.0.1:6379> INFO replication
# Replication
role:master
connected_slaves:2
slave0:ip=127.0.0.1,port=6380,state=online,offset=1964,lag=1
slave1:ip=127.0.0.1,port=6381,state=online,offset=1964,lag=1
master_replid:0c19b3c9cce2038f85c077905a014a4f47e6282b
master_repl_offset:1964
repl_backlog_active:1
repl_backlog_size:1048576
关键字段含义:
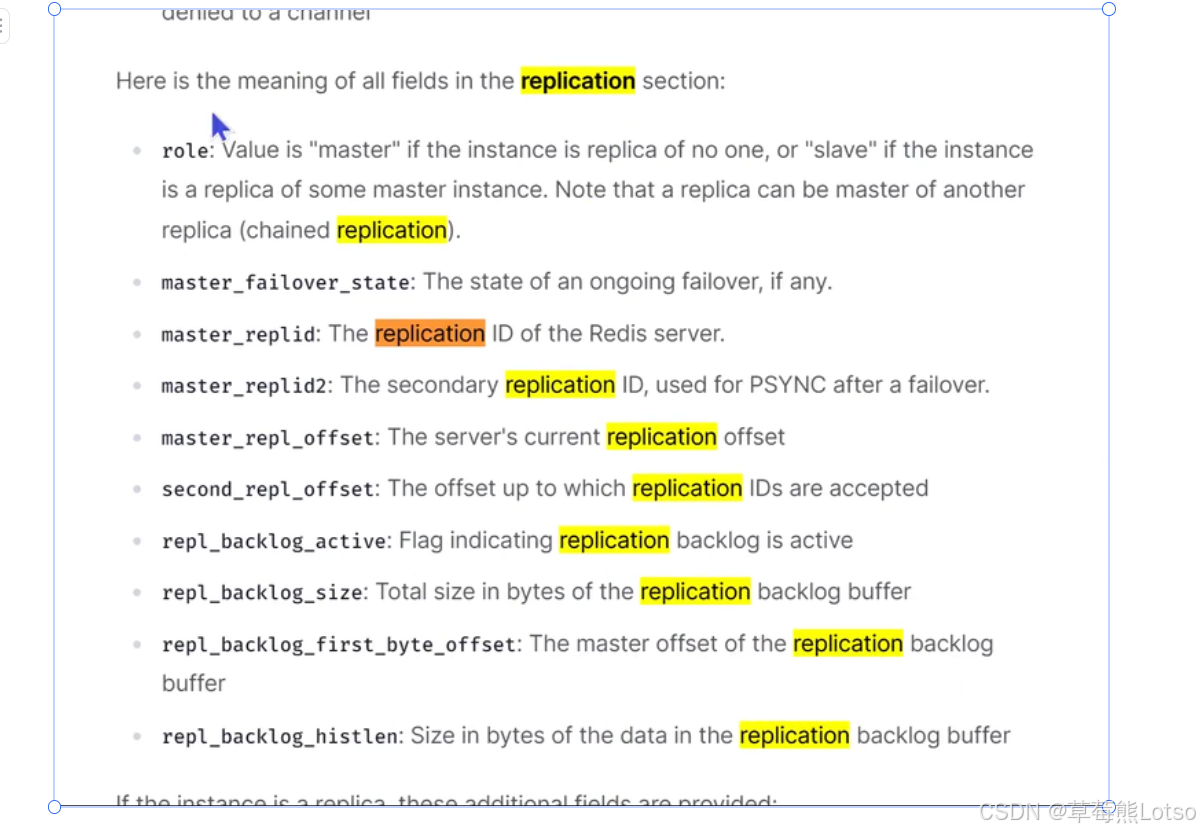
role:当前节点角色;offset:复制偏移量,代表数据同步进度;replid:复制 ID,主节点身份标识;repl_backlog:复制积压缓冲区,是部分复制的核心。
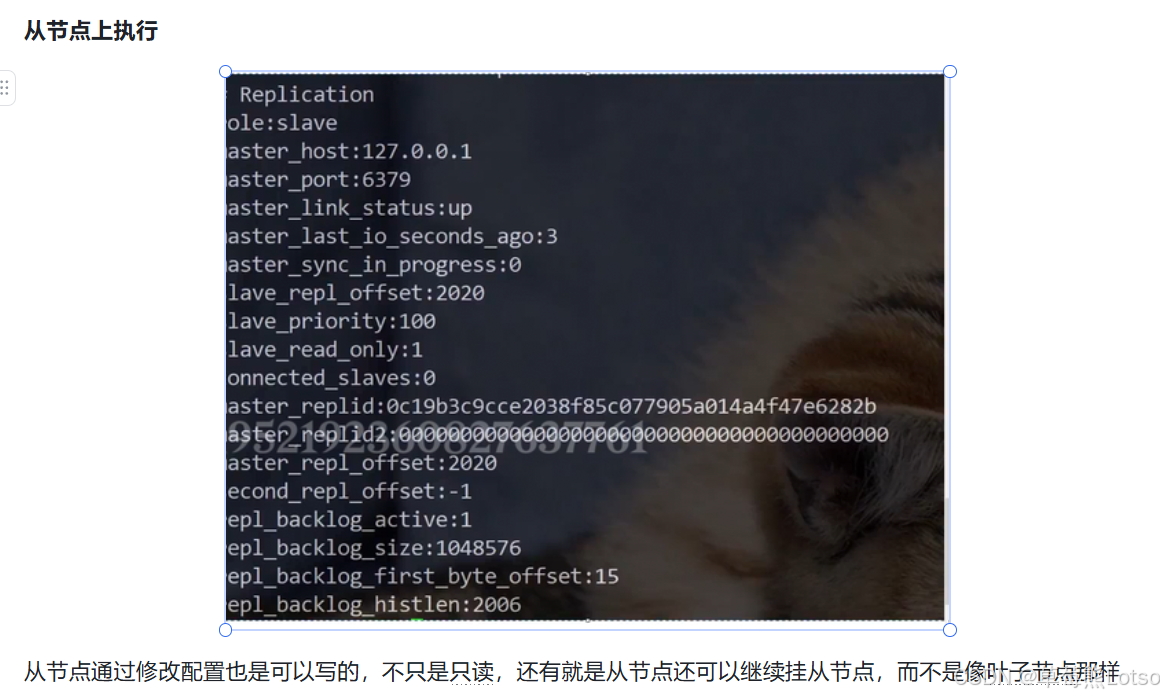
从节点视角可以看到主节点地址、连接状态、自身偏移量、只读开关等信息。
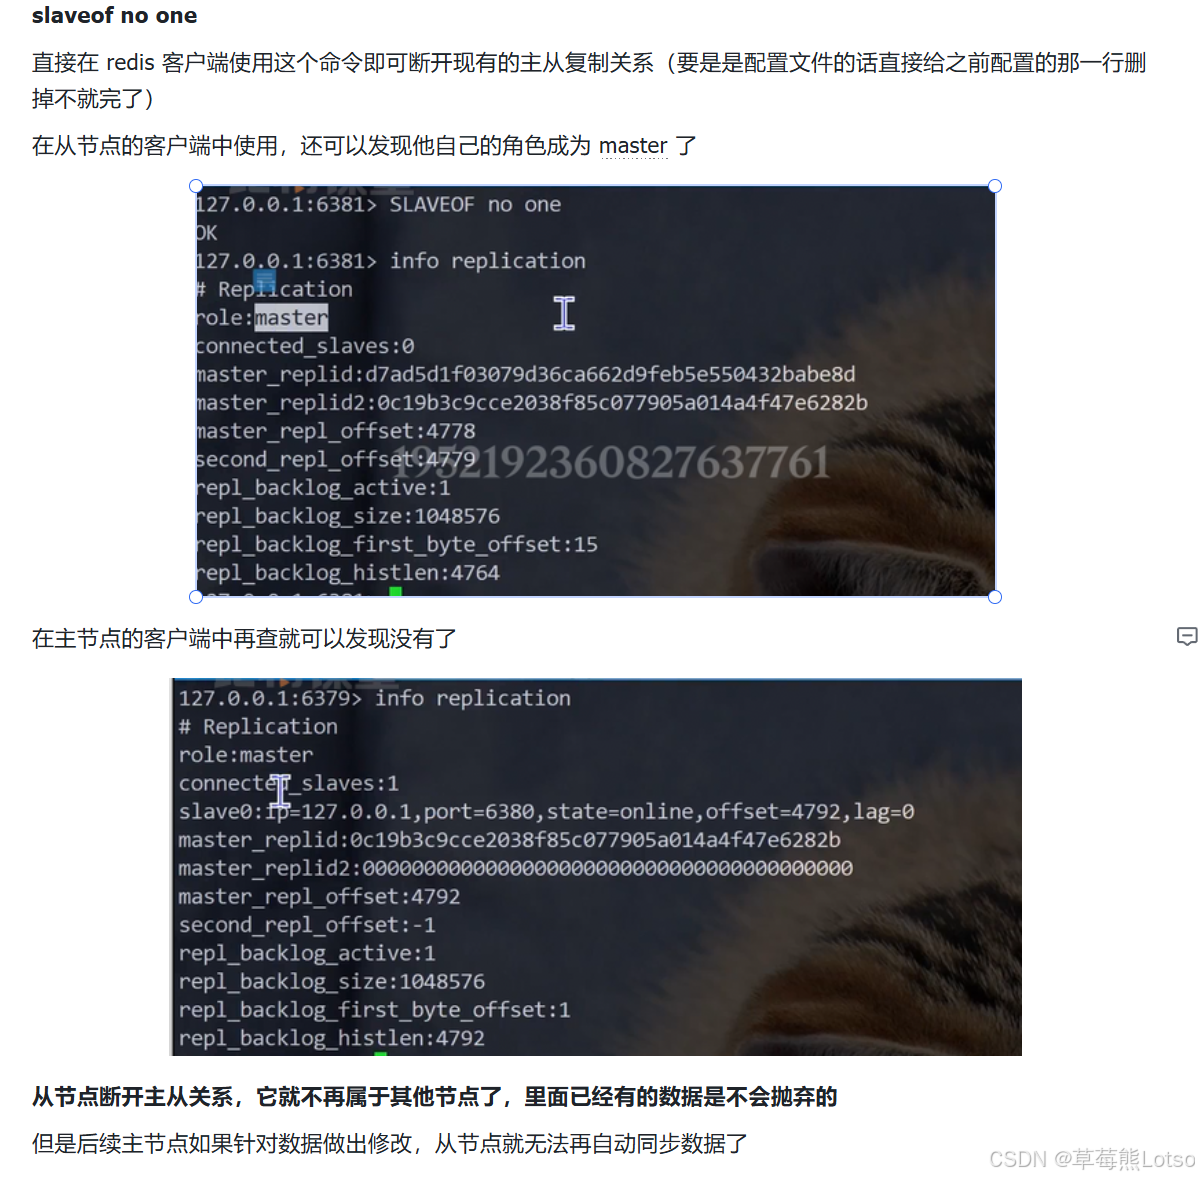
2.4 断开与切换主从
断开主从关系
在从节点执行 SLAVEOF NO ONE,即可断开与主节点的联系,晋升为独立的主节点。
bash
127.0.0.1:6381> SLAVEOF no one
OK
断开后,从节点已有的数据不会清空,但不再接收主节点的新变更。
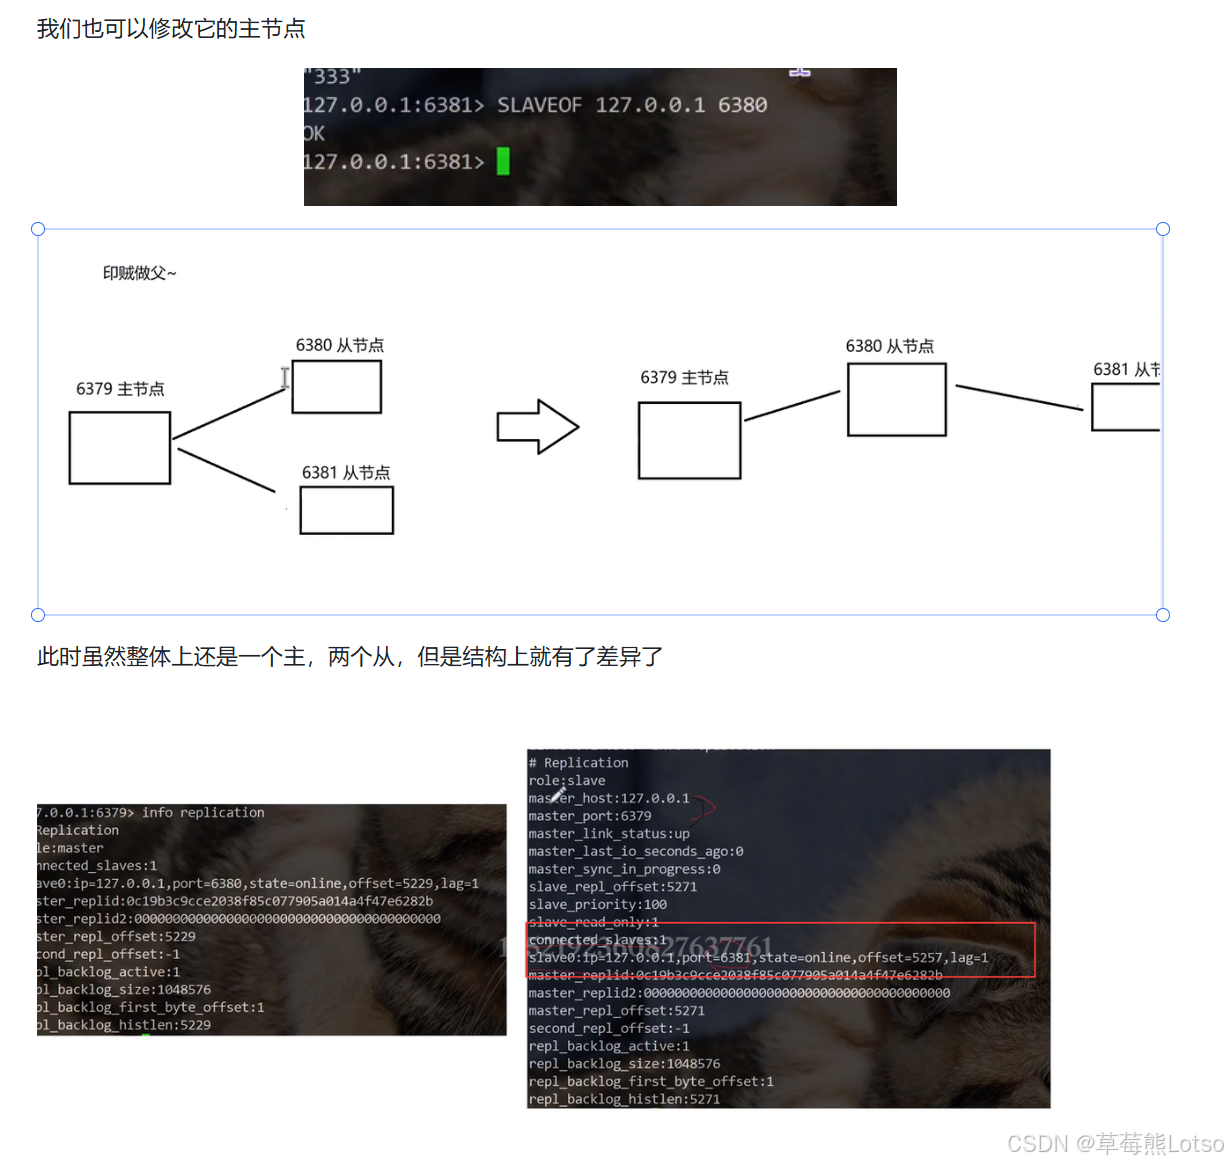
切换主节点
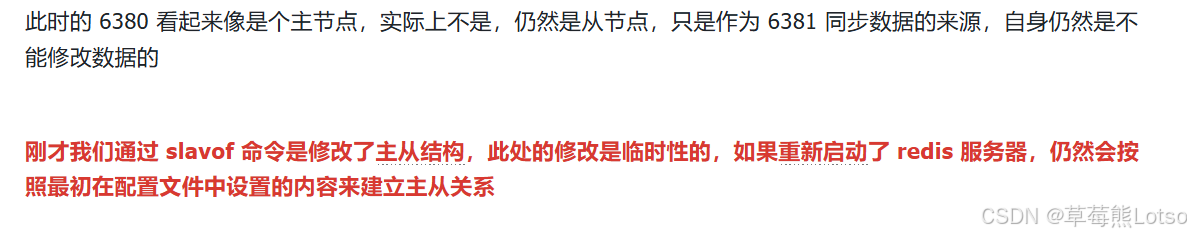
从节点也可以重新指定新的主节点,比如 SLAVEOF 127.0.0.1 6380,形成链式复制结构。注意命令行修改都是临时的,重启后会回到配置文件设定的状态。
2.5 安全、只读与传输优化
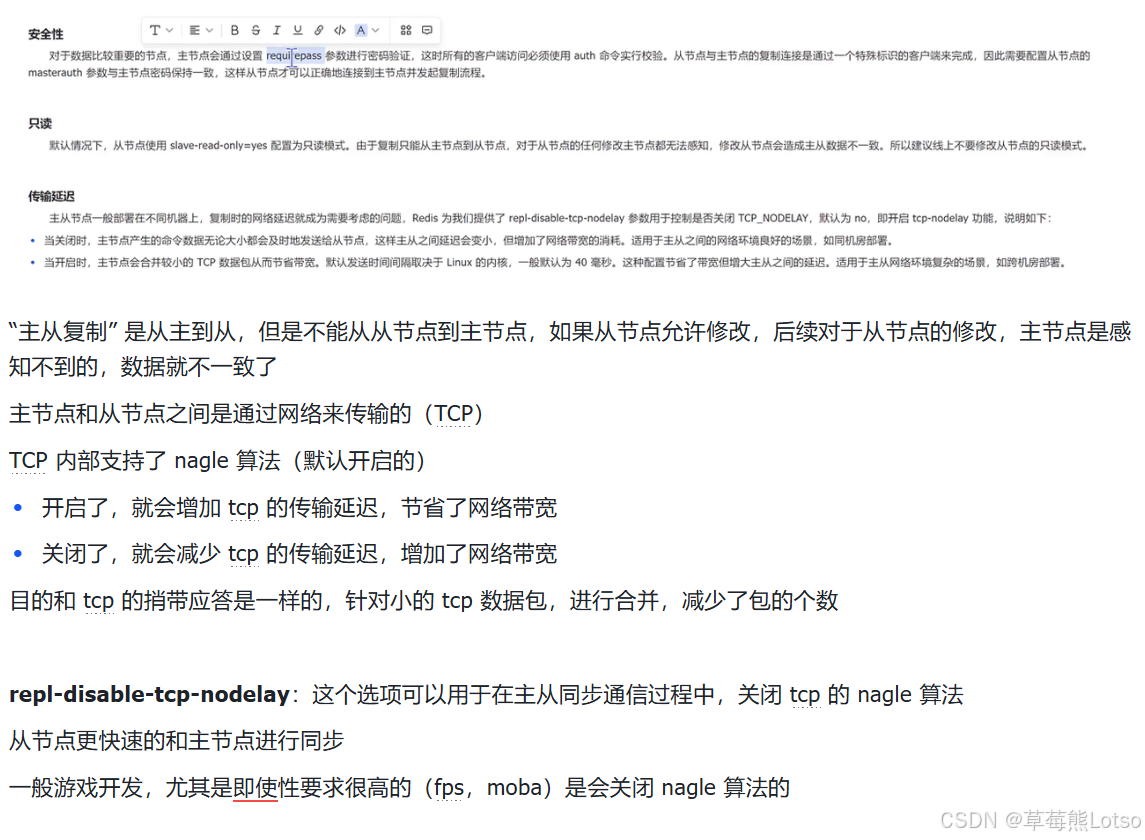
- 密码验证 如果主节点开启了
requirepass密码,从节点需要配置masterauth参数填写相同密码,才能正常建立复制连接。 - 从节点只读 默认
slave-read-only yes,从节点禁止写入,避免人为造成主从不一致。生产环境不建议关闭这个选项。 - 传输延迟优化 主从同步基于 TCP 传输,涉及 Nagle 算法的取舍:
- 开启 Nagle:小数据包合并发送,节省带宽,但延迟更高;
- 关闭 Nagle:数据立即发送,延迟更低,但带宽消耗更大。
- 对应配置
repl-disable-tcp-nodelay,默认no即开启 Nagle。局域网延迟低的场景可以关闭以获得更快的同步速度;跨机房、带宽紧张的场景建议保持开启。
三. 主从复制的拓扑结构
根据业务规模和部署环境,主从复制有三种典型拓扑。
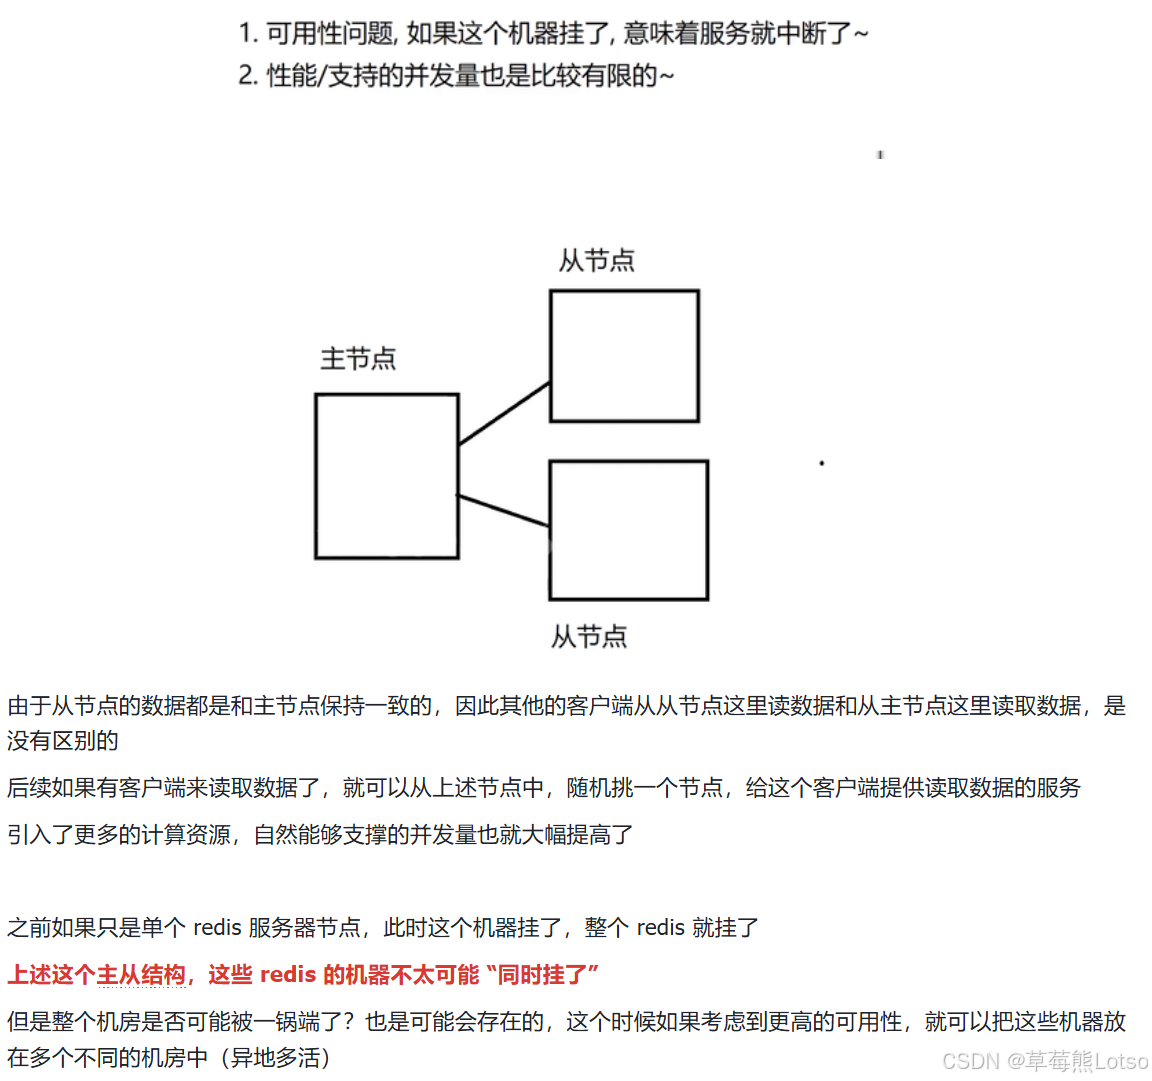
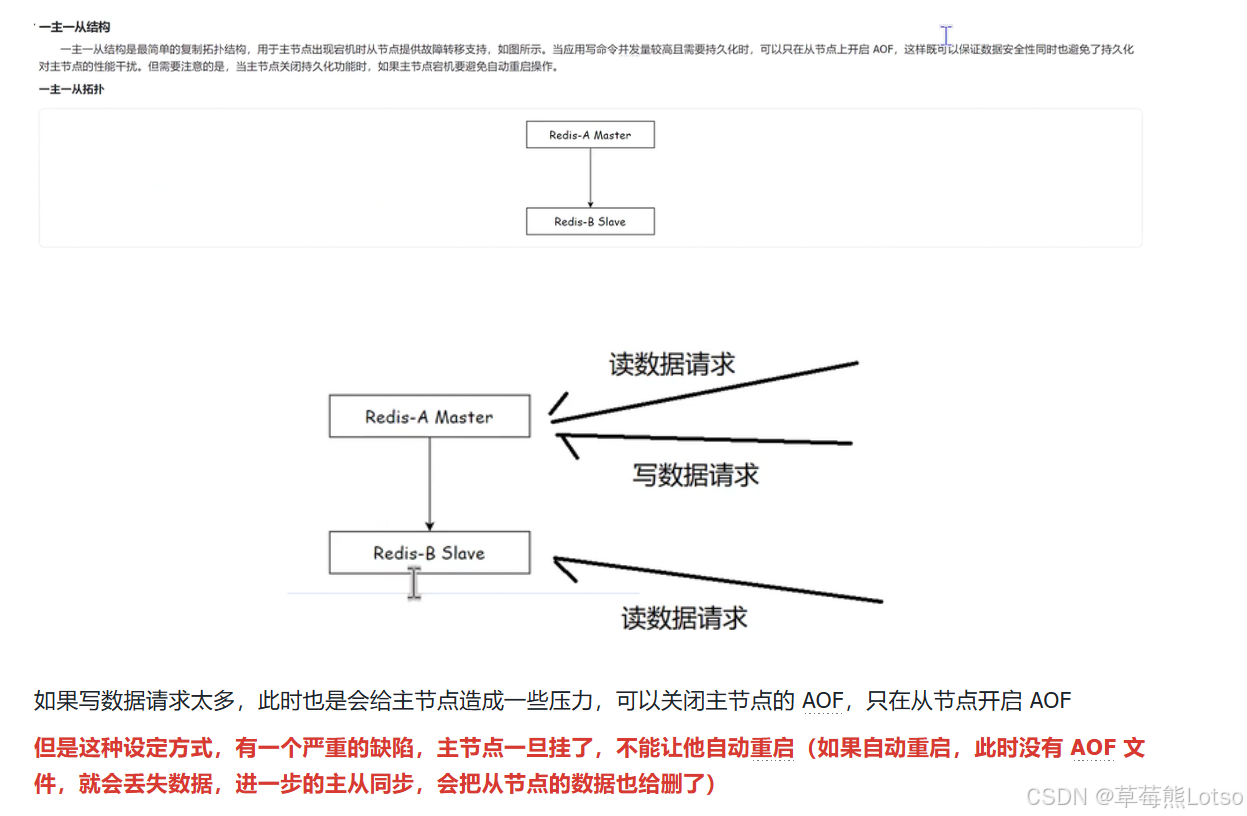
3.1 一主一从
最简单的结构,一个主节点带一个从节点。
- 适用场景:数据量小、读压力低的基础业务,主要用于数据备份和基础容灾。
- 优化技巧:可以关闭主节点的 AOF 持久化,只在从节点开启,降低主节点的磁盘 IO 压力。
- ⚠️ 注意陷阱:如果主节点关闭了持久化,宕机后千万不要自动重启。否则主节点本地没有数据,启动后是空库,同步给从节点会把从节点的数据也清空,造成严重的数据丢失。
3.2 一主多从
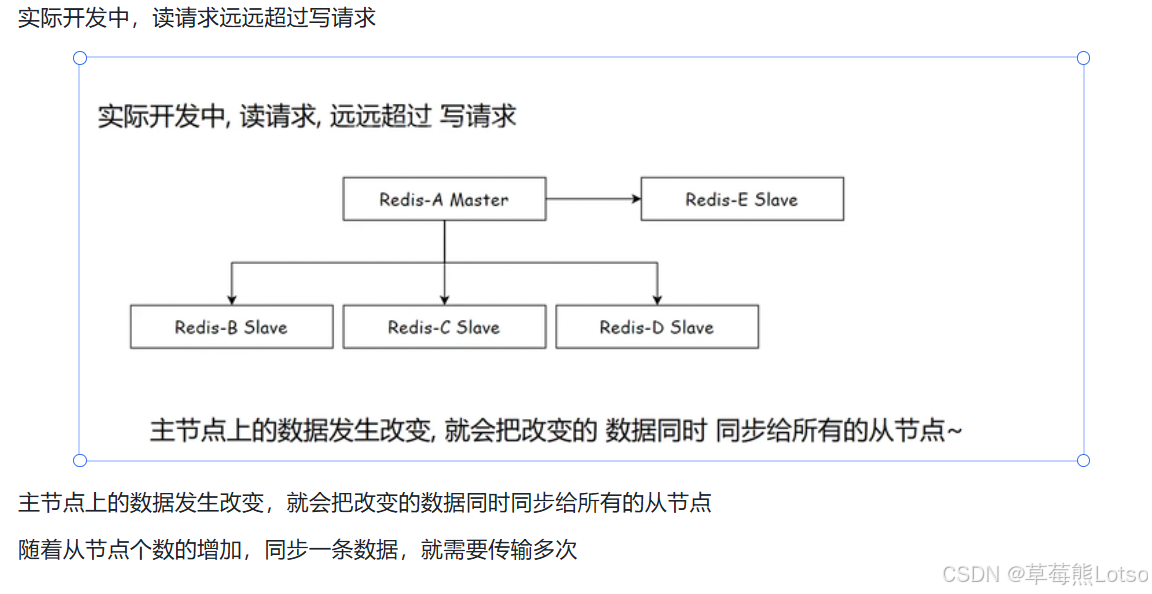
一个主节点挂载多个从节点,是最经典的读写分离架构。
- 适用场景:读请求量大,需要多个从节点分摊读流量。
- 缺点:从节点数量越多,主节点的网络带宽压力越大,每个从节点都要单独接收一份完整的同步数据流。
3.3 树形结构
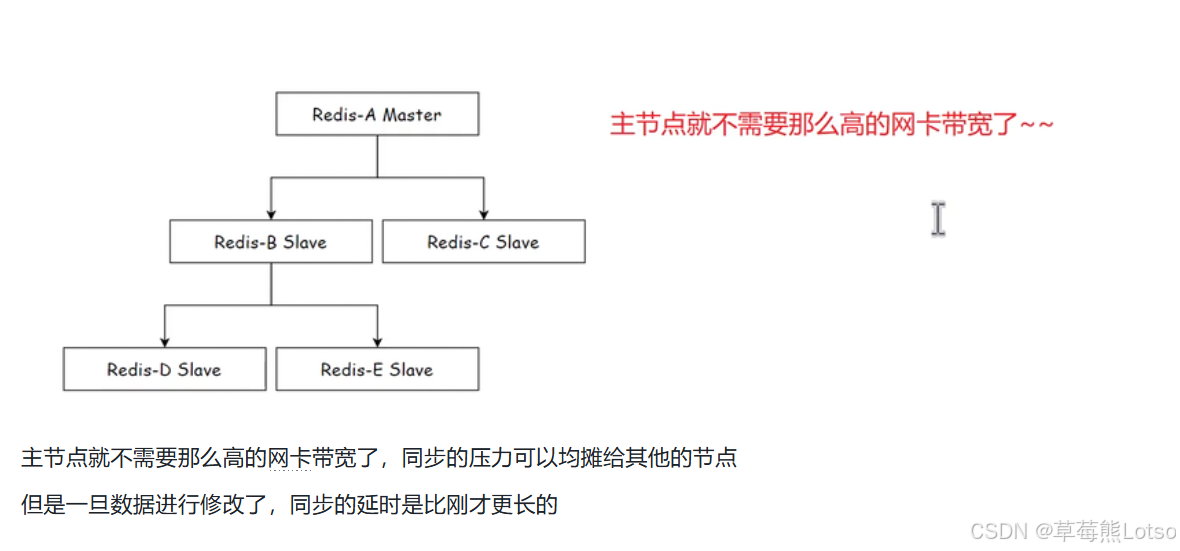
主节点只挂载少量二级从节点,二级从节点再挂载三级从节点,形成树状层级。
- 优势:大幅降低主节点的网卡带宽压力,把同步压力分摊到中间层节点;适合节点数量多、跨机房部署的场景。
- 劣势:层级越深,数据同步的延迟越高,最底层节点的数据滞后更明显。
四. 主从复制的完整建立流程
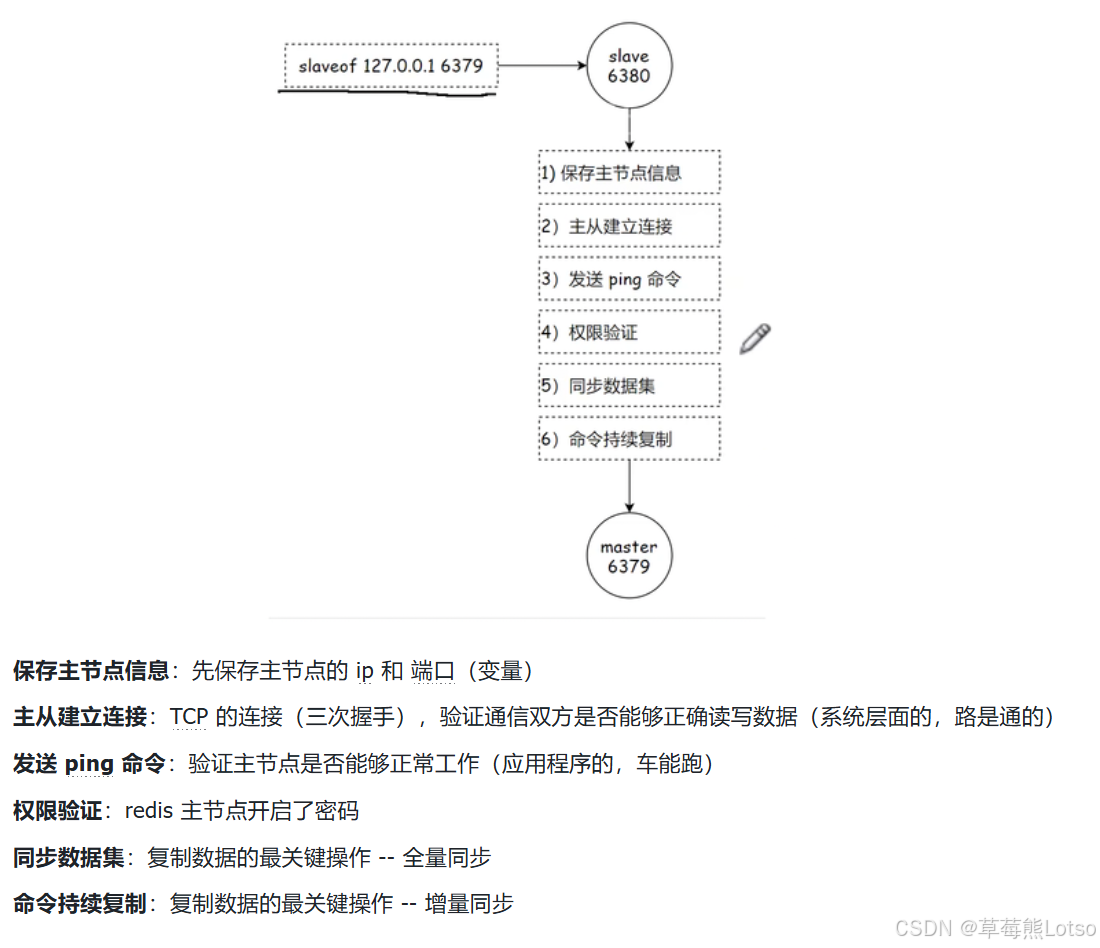
从从节点执行 slaveof 到数据完全同步,一共分为 6 个步骤:
- 保存主节点信息 从节点先把主节点的 IP 和端口记录下来,后续流程基于这个地址执行。
- 建立 TCP 连接 从节点主动向主节点发起 TCP 三次握手,建立长连接。这一步是系统层面的连通性验证。
- 发送 PING 命令 连接建立后,从节点发送 PING 命令,验证主节点服务正常可用、命令可以正常响应,相当于应用层的健康检查。
- 权限验证 如果主节点设置了密码,从节点携带
masterauth配置的密码进行身份校验。 - 同步数据集 也就是全量复制阶段,主节点把完整的数据快照发给从节点,从节点清空旧数据加载新快照,完成数据初始化。
- 命令持续复制 全量同步完成后,进入增量实时同步阶段。主节点后续收到的所有写命令,都会异步发送给从节点执行,保持数据一致。
五. PSYNC 同步协议
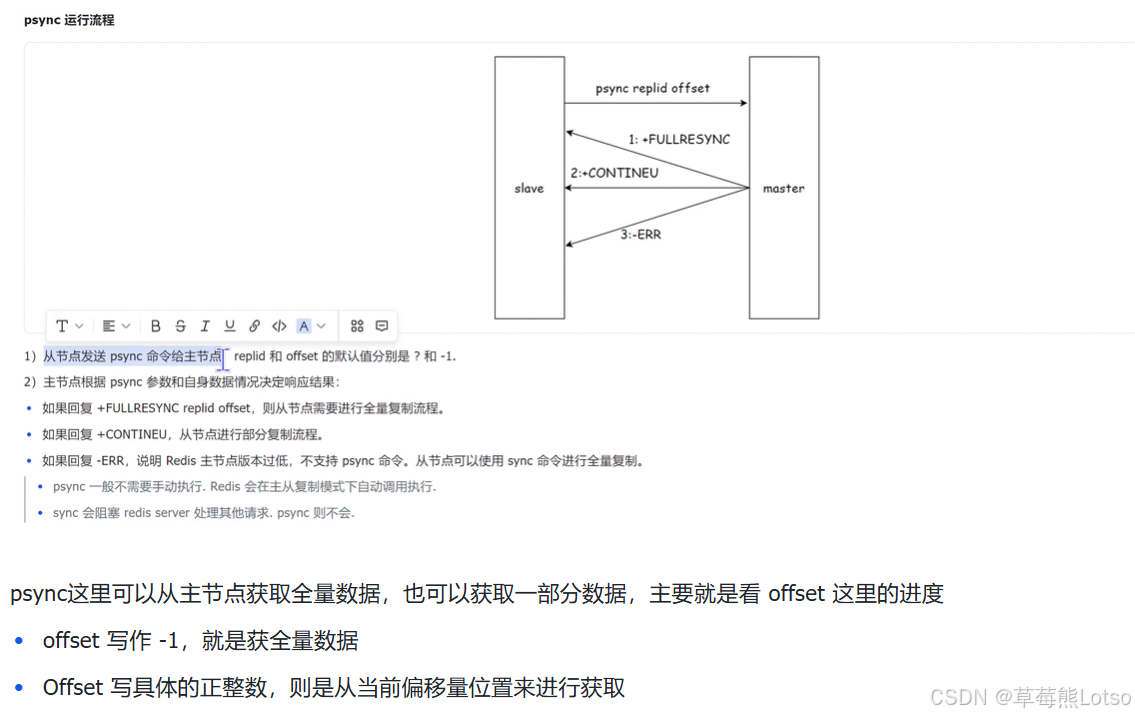
Redis 使用 PSYNC 命令来完成数据同步,它替代了早期的 SYNC 命令,核心改进是支持部分复制,避免了网络闪断后就要重新全量同步的高昂开销。
5.1 两个核心标识
PSYNC 命令携带两个参数:replicationid 和 offset,共同定位从节点的同步状态。
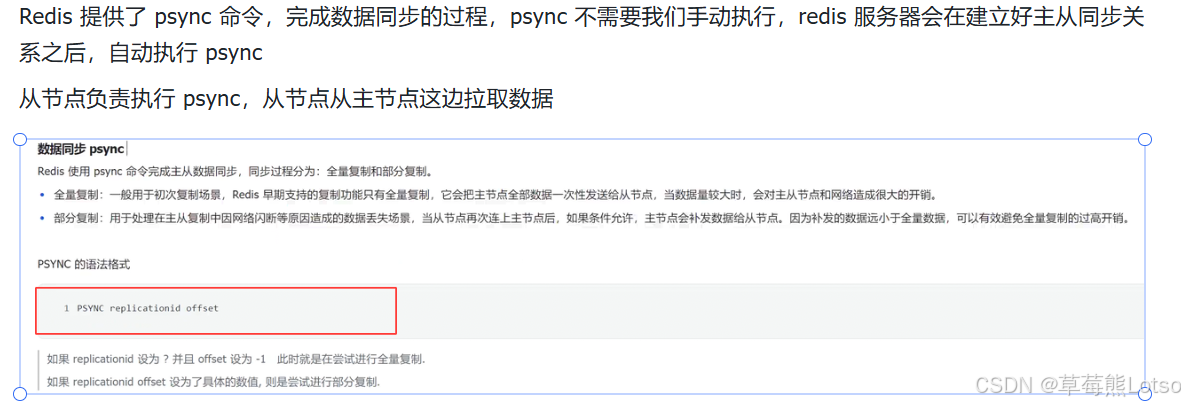
replicationid(复制 ID)
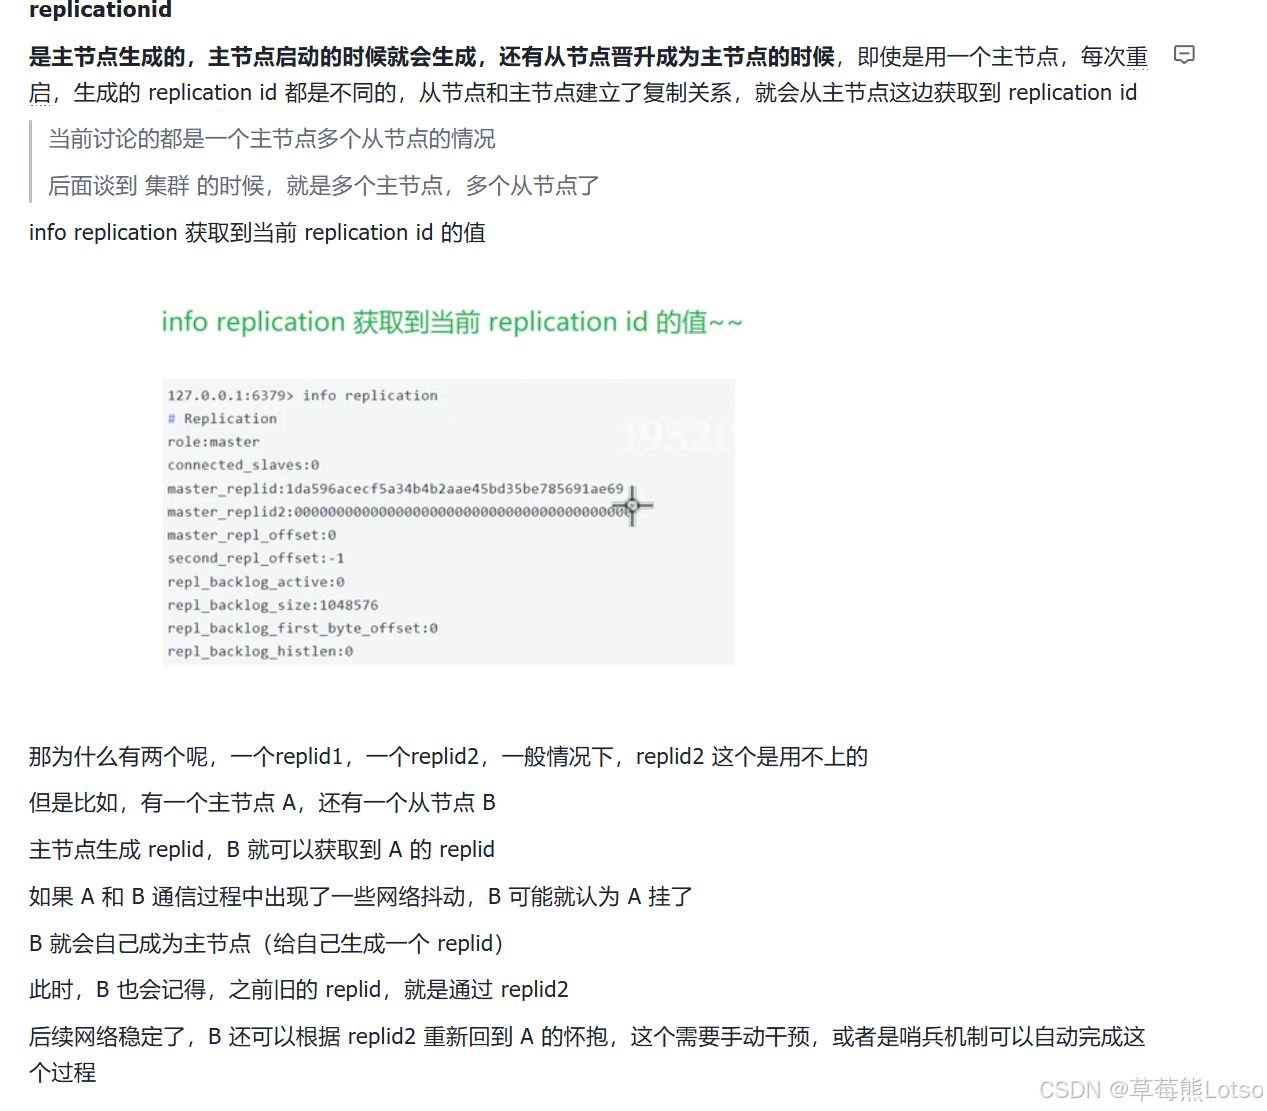
- 每个主节点启动时都会生成一个唯一的复制 ID,代表这一任主节点的数据版本;
- 从节点和主节点建立复制关系后,会继承主节点的 replid;
- 节点重启、从节点晋升为主节点时,都会生成新的 replid。
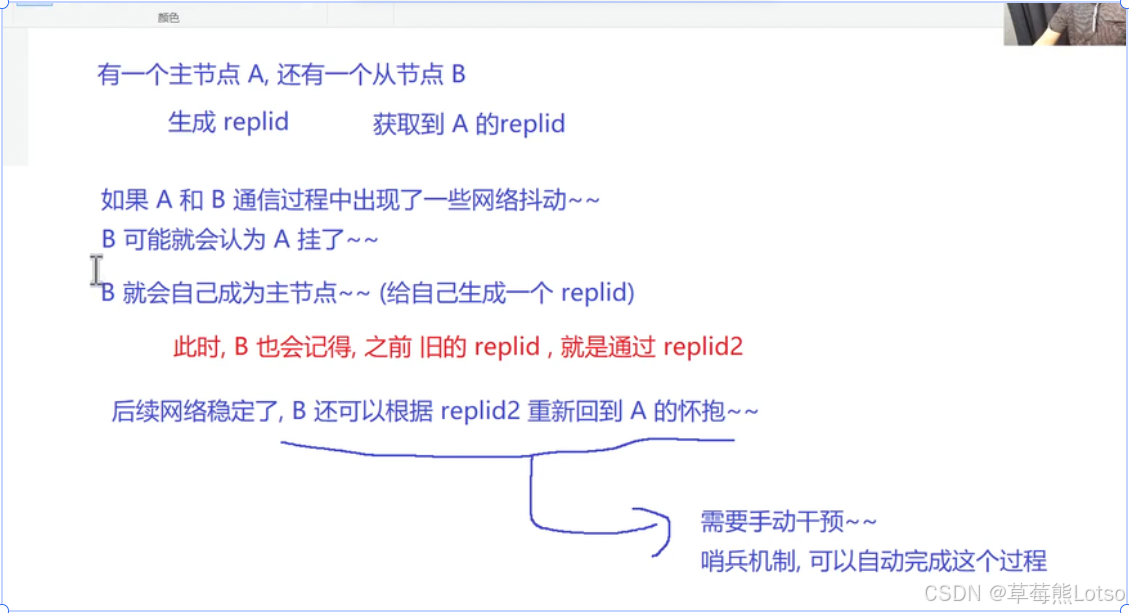
- 除了主 replid,还有
replid2,用来记录上一任主节点的复制 ID。比如从节点临时升主后,还保留着旧主的 replid,后续网络恢复后可以重新接入旧主,做部分同步。
offset(复制偏移量)
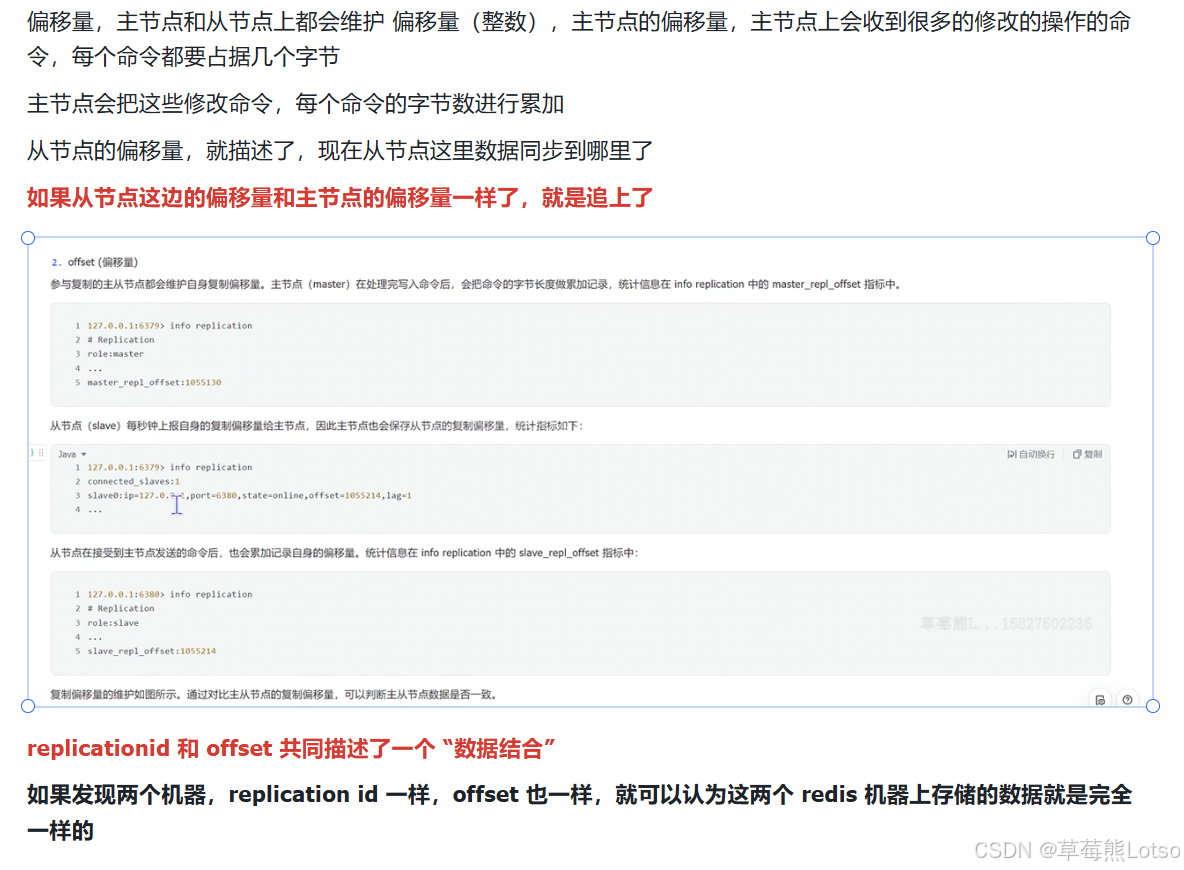
- 主从节点各自维护一个偏移量,本质是累计同步的字节数;
- 主节点每处理一条写命令,就把命令的字节长度累加到自己的偏移量上;
- 从节点每收到并执行一条同步命令,也累加自己的偏移量;
- 从节点每秒会把自己的偏移量上报给主节点。
当两个节点 replid 相同、offset 也相同时,就认为两者数据完全一致。
5.2 PSYNC 的三种响应
从节点发送 PSYNC <replid> <offset> 后,主节点会根据自身状态返回三种结果:
+FULLRESYNC <replid> <offset>:需要执行全量复制。初次同步、或者偏移量超出积压缓冲区范围时返回。+CONTINUE:可以执行部分复制,只补发缺失的增量数据。-ERR:主节点版本过低,不支持 PSYNC,从节点回退使用旧的SYNC命令做全量复制。
初次同步时,从节点不知道主节点的 replid,会发送
PSYNC ? -1,主动请求全量复制。
六. 三种复制模式详解
6.1 全量复制
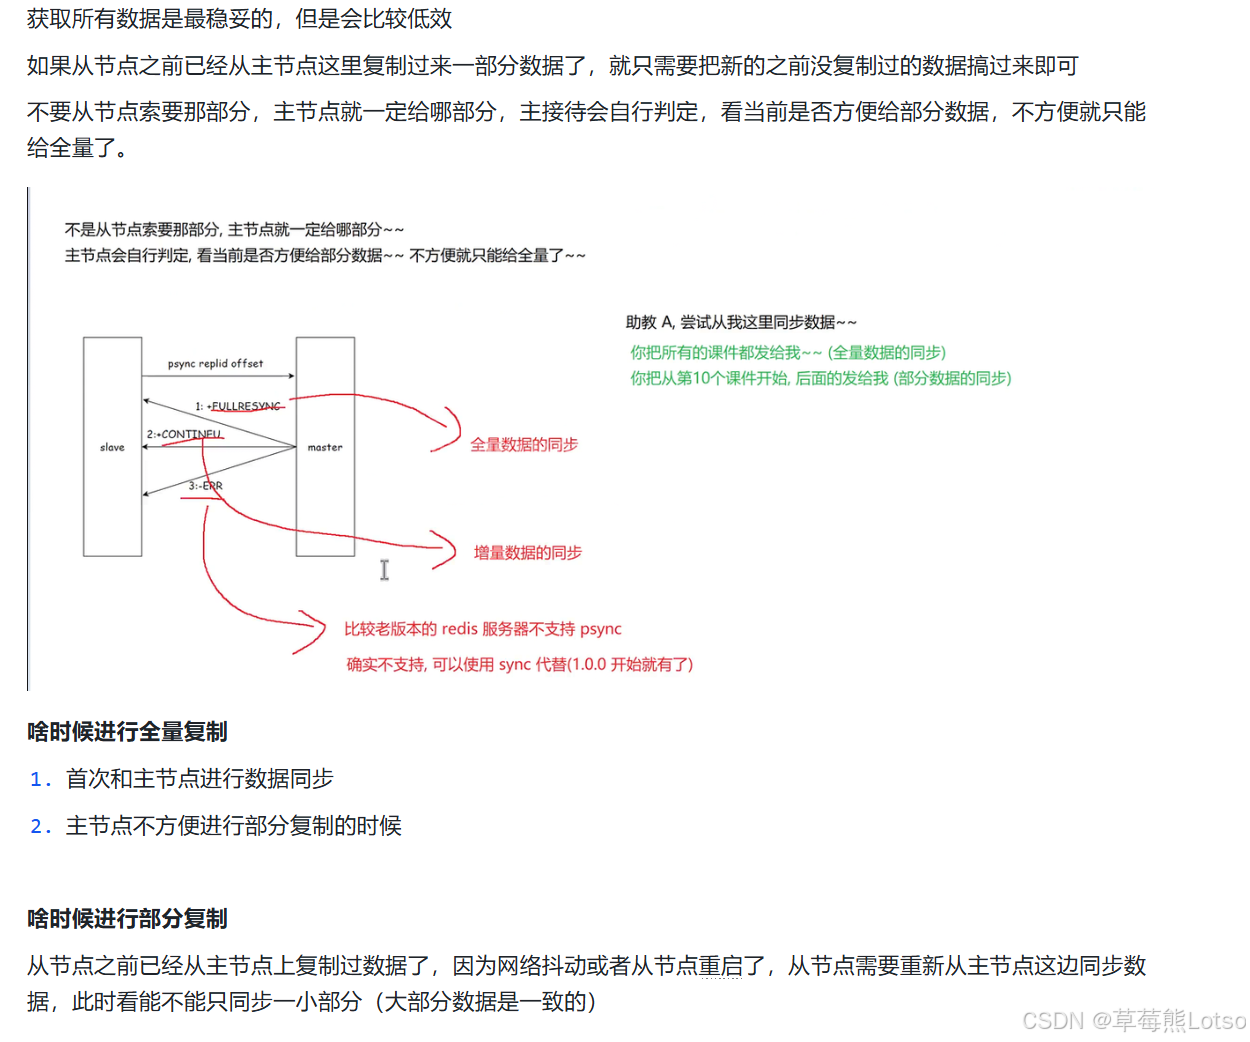
全量复制是把主节点完整数据一次性同步给从节点,开销最大,一般用于初次建立复制的场景。
完整执行流程
- 从节点发送
PSYNC ? -1请求全量同步; - 主节点返回
+FULLRESYNC响应,携带自己的 replid 和 offset; - 主节点后台执行
bgsave,生成 RDB 快照文件; - 生成 RDB 期间,主节点新收到的写命令会暂存到复制缓冲区中;
- RDB 生成完毕后,主节点把 RDB 文件发送给从节点;
- 从节点清空自身旧数据,加载 RDB 文件到内存;
- 加载完成后,主节点把缓冲区中暂存的写命令发给从节点执行,补齐 RDB 生成期间的增量数据;
- 如果从节点开启了 AOF,会自动触发一次
bgrewriteaof,生成最新的 AOF 文件。
无硬盘复制(diskless)
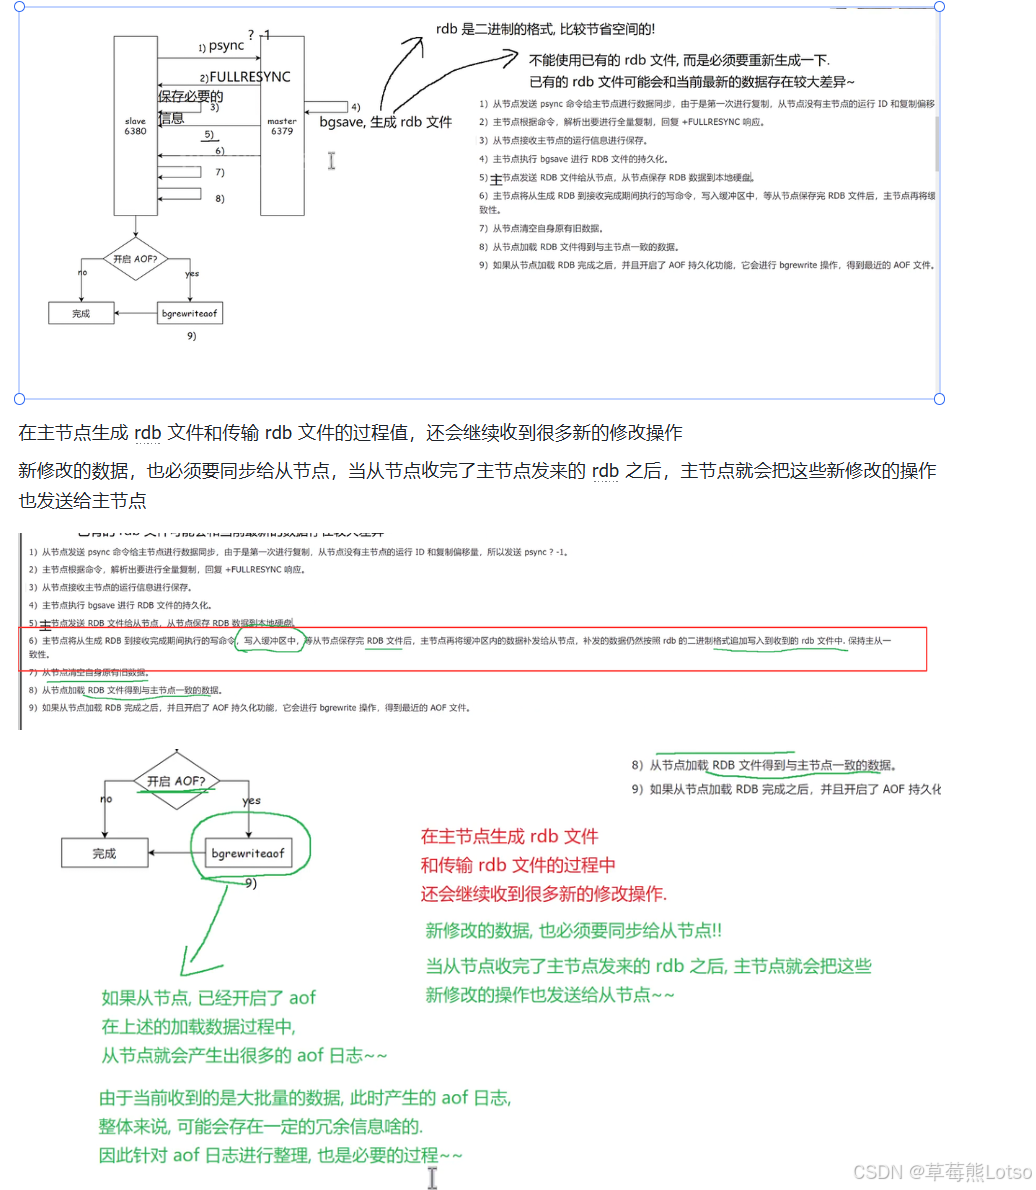
默认全量复制需要主节点先把 RDB 写入本地磁盘,再通过网络发给从节点。无硬盘模式下,主节点生成的 RDB 数据直接通过网络发送,省去本地磁盘读写的开销,适合磁盘 IO 紧张、网络带宽充足的场景。 但即使开启无硬盘模式,全量复制仍然是重量级操作,网络传输的开销是无法省略的。
6.2 部分复制
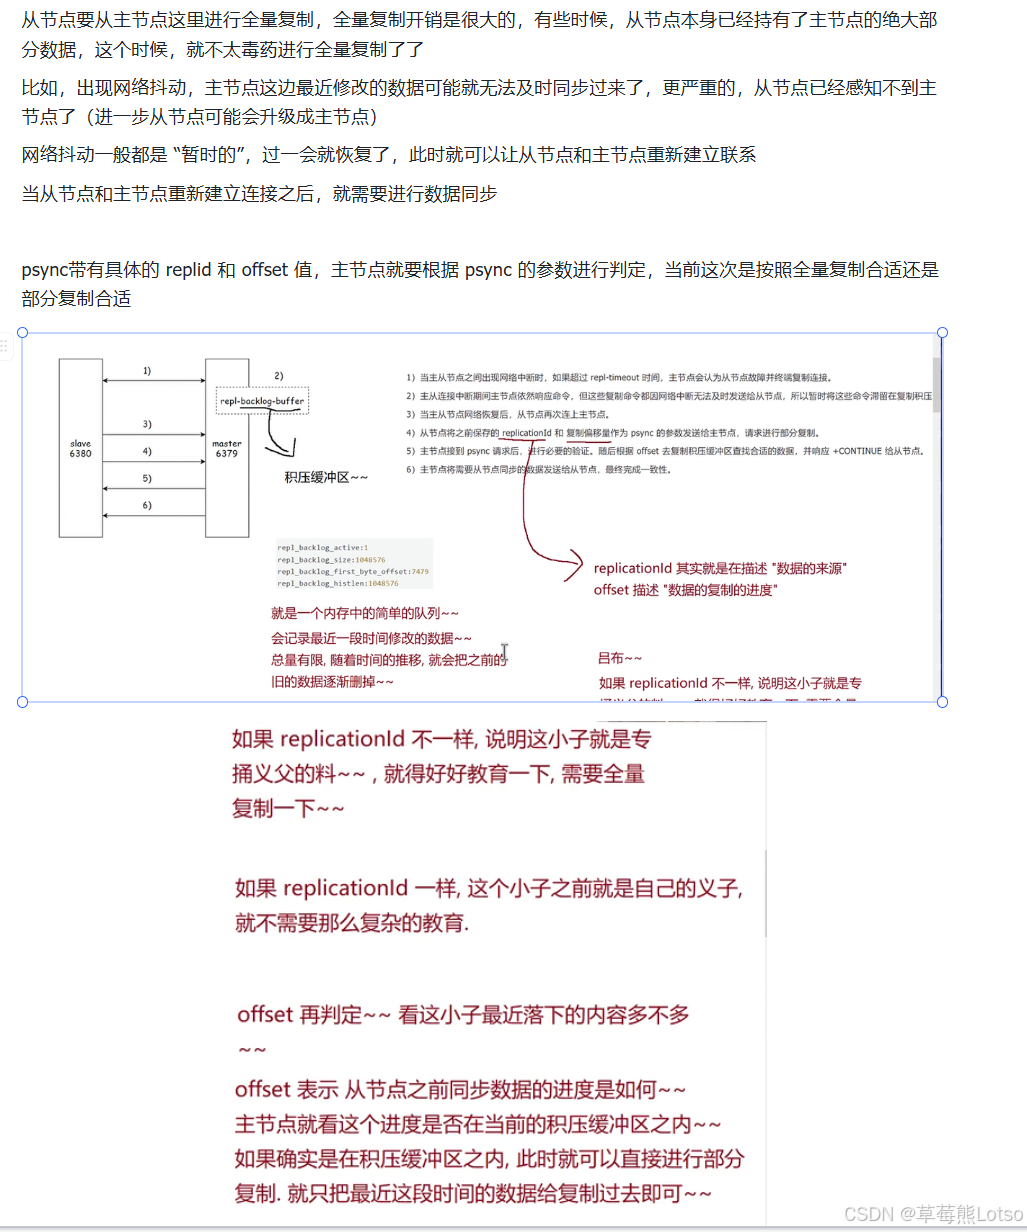
部分复制是 PSYNC 的核心价值,专门用来处理网络闪断场景:从节点短暂断开重连后,只补发缺失的那部分命令,不用重新全量同步。
核心依赖:复制积压缓冲区
主节点内部维护了一个固定大小的环形缓冲区(repl_backlog),默认 1MB,用来保存最近一段时间的写命令。
- 它是一个先进先出的队列,新数据不断写入,旧数据不断被覆盖;
- 大小由
repl_backlog_size配置,设置得越大,能容忍的断网时间就越长。
执行流程
- 网络中断后,超过超时时间主节点会认为从节点下线,但仍然持续往积压缓冲区写入新的写命令;
- 网络恢复,从节点重新连接主节点,携带自己的 replid 和 offset 发送 PSYNC 请求;
- 主节点先校验 replid 是否一致,不一致直接走全量复制;
- replid 一致则检查 offset 是否还在积压缓冲区的范围内:
- 在范围内:返回
+CONTINUE,把 offset 之后的所有命令补发过去; - 超出范围:缓冲区已经覆盖了旧数据,只能走全量复制。
- 在范围内:返回
这也是为什么生产环境建议适当调大 repl_backlog_size:可以显著降低网络抖动后触发全量复制的概率。
6.3 实时复制
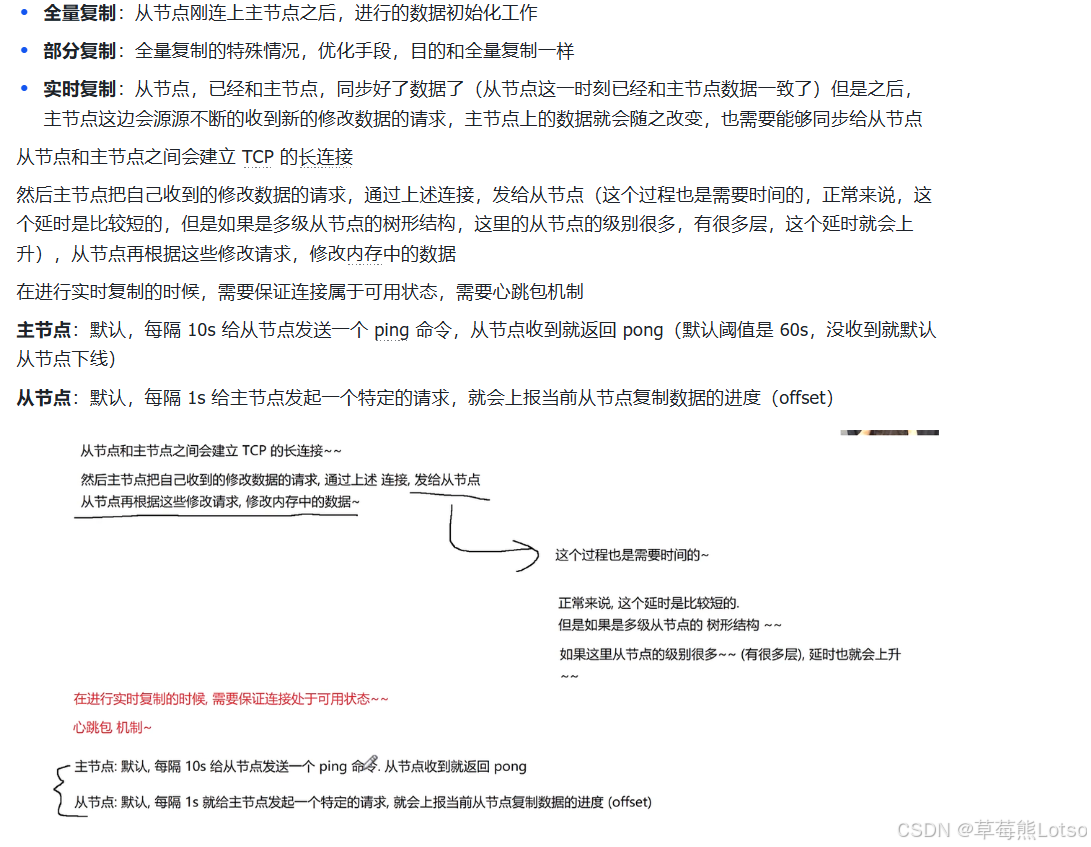
全量同步完成、主从数据一致后,就进入长期的实时复制阶段。
- 主从之间保持 TCP 长连接;
- 主节点每收到一条写命令,就异步将命令转发给所有从节点;
- 从节点接收并执行命令,维持与主节点的数据一致。
为了保证连接健康,双方通过心跳机制维持状态:
- 主节点:默认每 10 秒向从节点发送 PING 心跳,连续 60 秒没收到回复就认为从节点下线;
- 从节点:默认每秒向主节点上报自己的复制偏移量,同时相当于心跳。
树形拓扑下,数据要经过多层节点转发,延迟会逐层叠加;而一主多从结构下所有从节点的延迟都是一跳。
源码视角:主从复制的设计细节
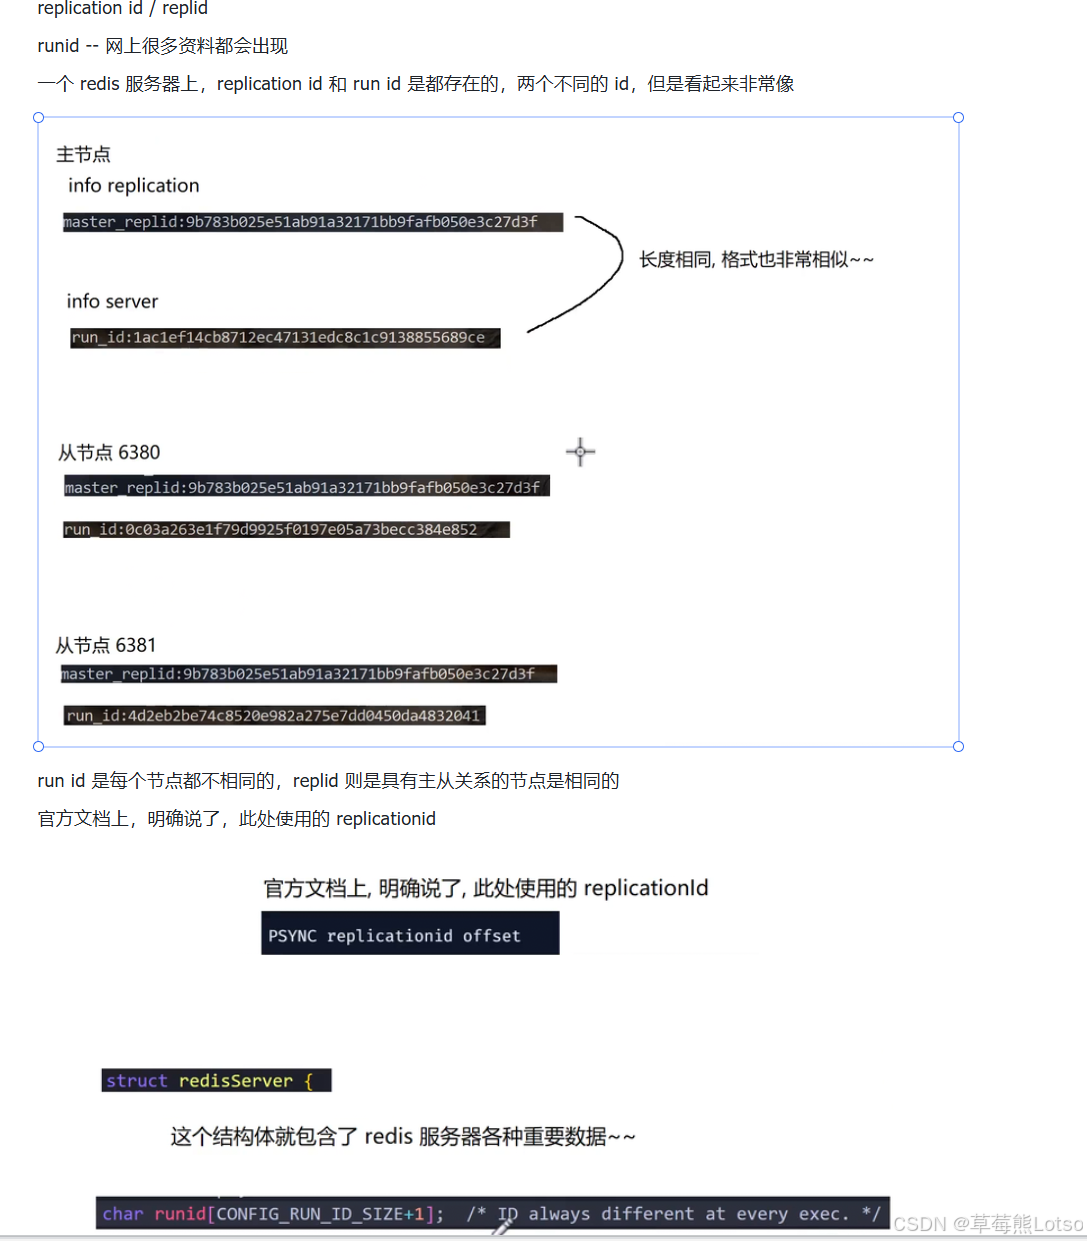
- replid 与 runid 的区别
很多资料会把两个概念混为一谈,实际上它们是完全独立的两个 ID:
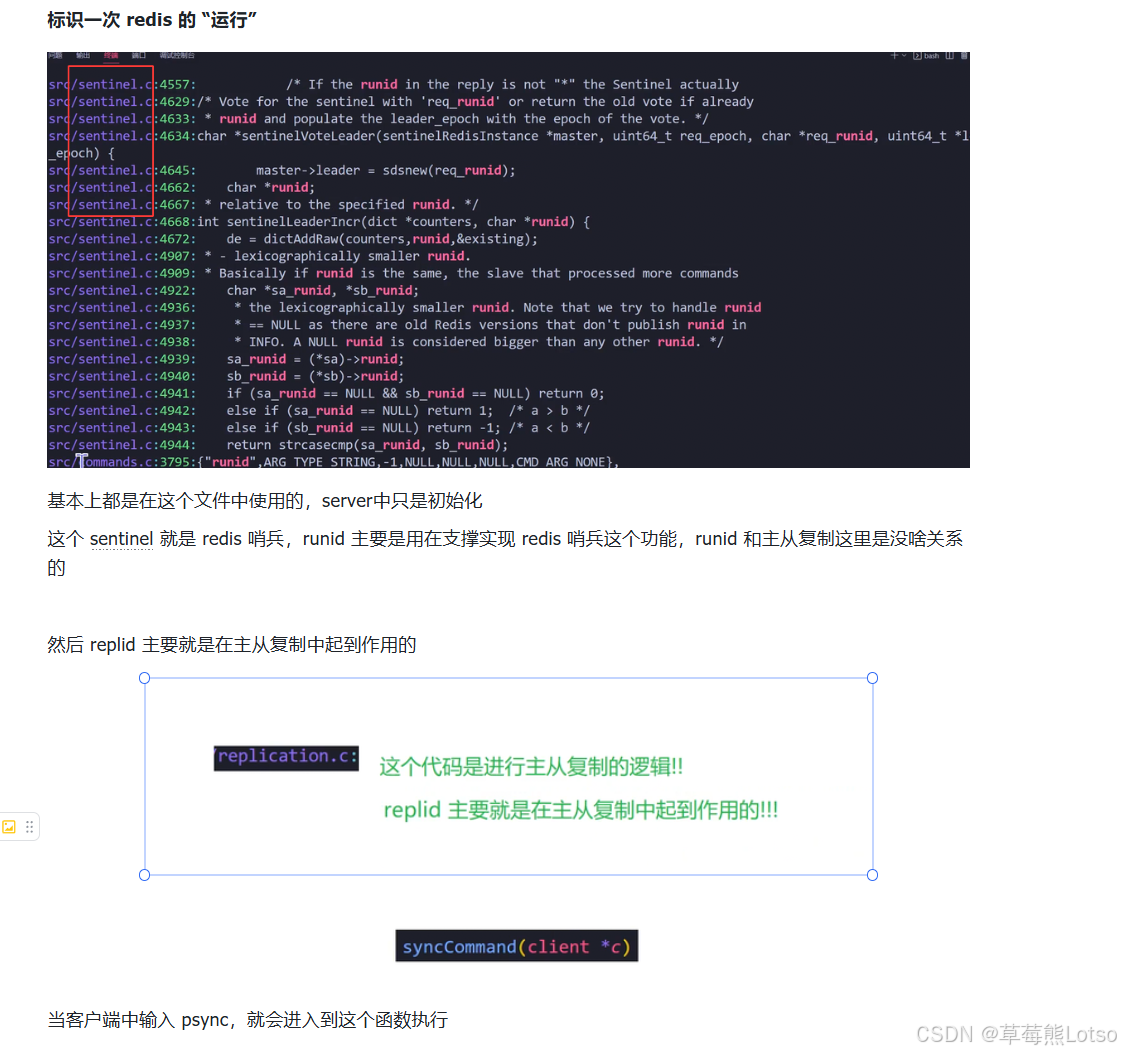
run_id:服务器运行 ID,每个节点启动时生成,主要供哨兵机制做节点身份识别,在sentinel.c中大量使用;replid:复制 ID,主从复制体系的身份标识,定义在redisServer结构体中,在replication.c的同步逻辑里使用。
两者格式相似、长度相同,但职责不同,不要混淆。
- 复制积压缓冲区的环形设计
积压缓冲区本质是一个带读写指针的环形字符数组。主节点写入时移动写指针,超出缓冲区大小时覆盖最旧的数据;部分复制时根据从节点的 offset 计算起始位置,向后读取所有增量命令。 这种设计用固定的内存开销,换取了断网重连后的快速恢复,是非常经典的用空间换时间、用概率换成本的工程思路。
- 全量复制的缓冲区设计
全量复制期间,RDB 生成和传输都需要时间,这段时间的新写命令不能丢,也不能直接发给从节点(会打乱 RDB 加载的顺序)。 Redis 的做法是暂存到客户端输出缓冲区中,等从节点加载完 RDB 再统一发送。这也是主节点在全量同步期间内存会有一定上涨的原因。
七. 主从复制小结与常见问题
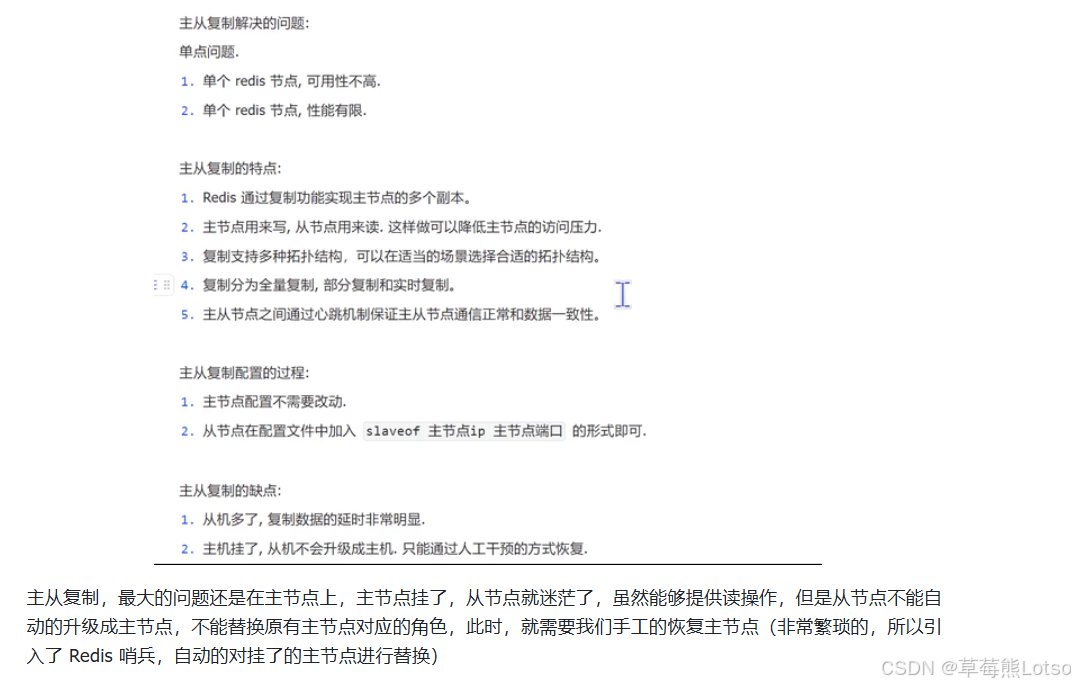
7.1 优缺点总结
优势
- 实现数据多副本,提升了数据可靠性;
- 支持读写分离,横向扩展读性能;
- 支持多种拓扑,可根据场景灵活选择。
局限
- 主节点是单点,宕机后需要人工干预切换,无法自动故障转移;
- 所有写请求都经过主节点,写能力无法横向扩展;
- 从节点数量越多、层级越深,同步延迟越明显。
7.2 关于从节点晋升
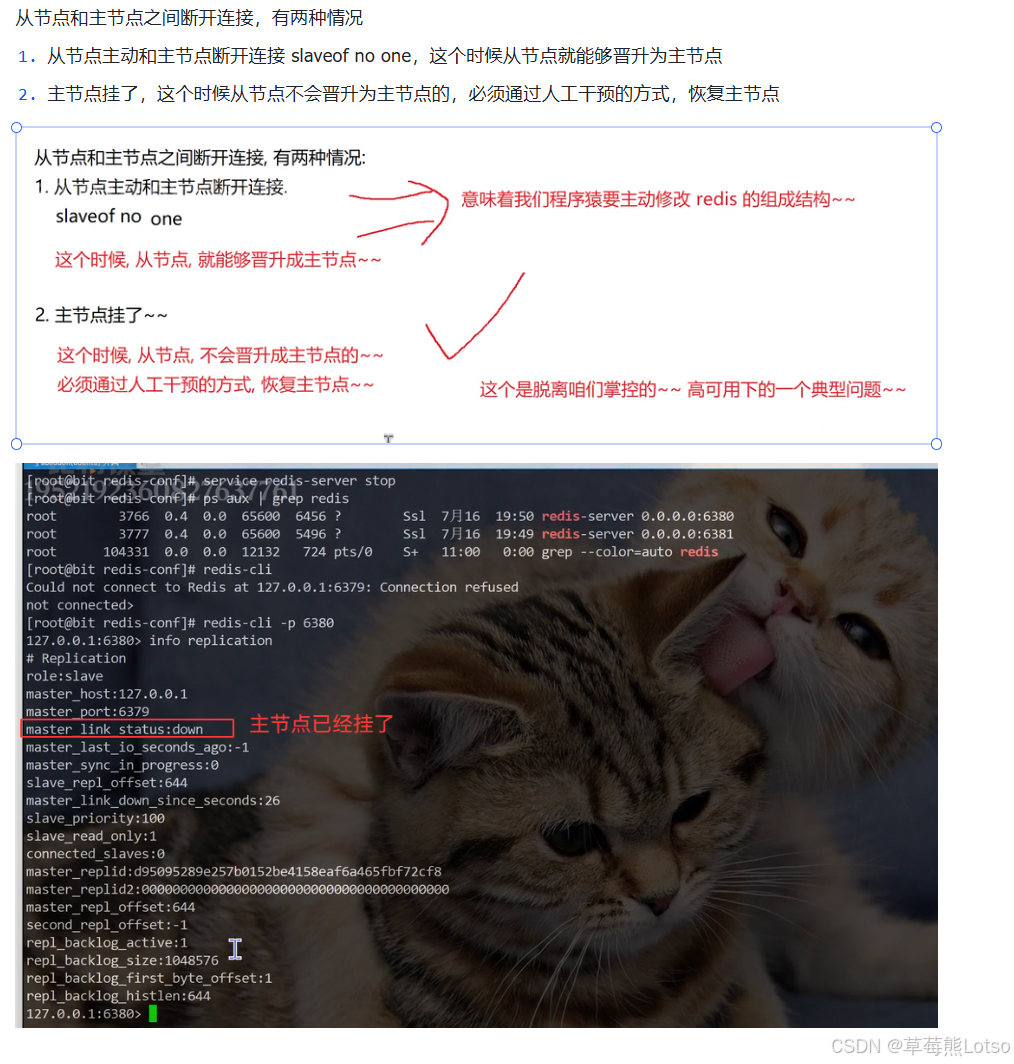
从节点成为主节点只有两种情况:
- 主动断开 :执行
SLAVEOF NO ONE,从节点主动脱离主节点,晋升为主节点; - 主节点故障 :原生主从模式下,主节点挂了从节点不会自动晋升,必须人工操作切换。这也是引入哨兵机制的核心原因 ------ 自动完成故障转移。
7.3 常见排坑:多实例启动失败
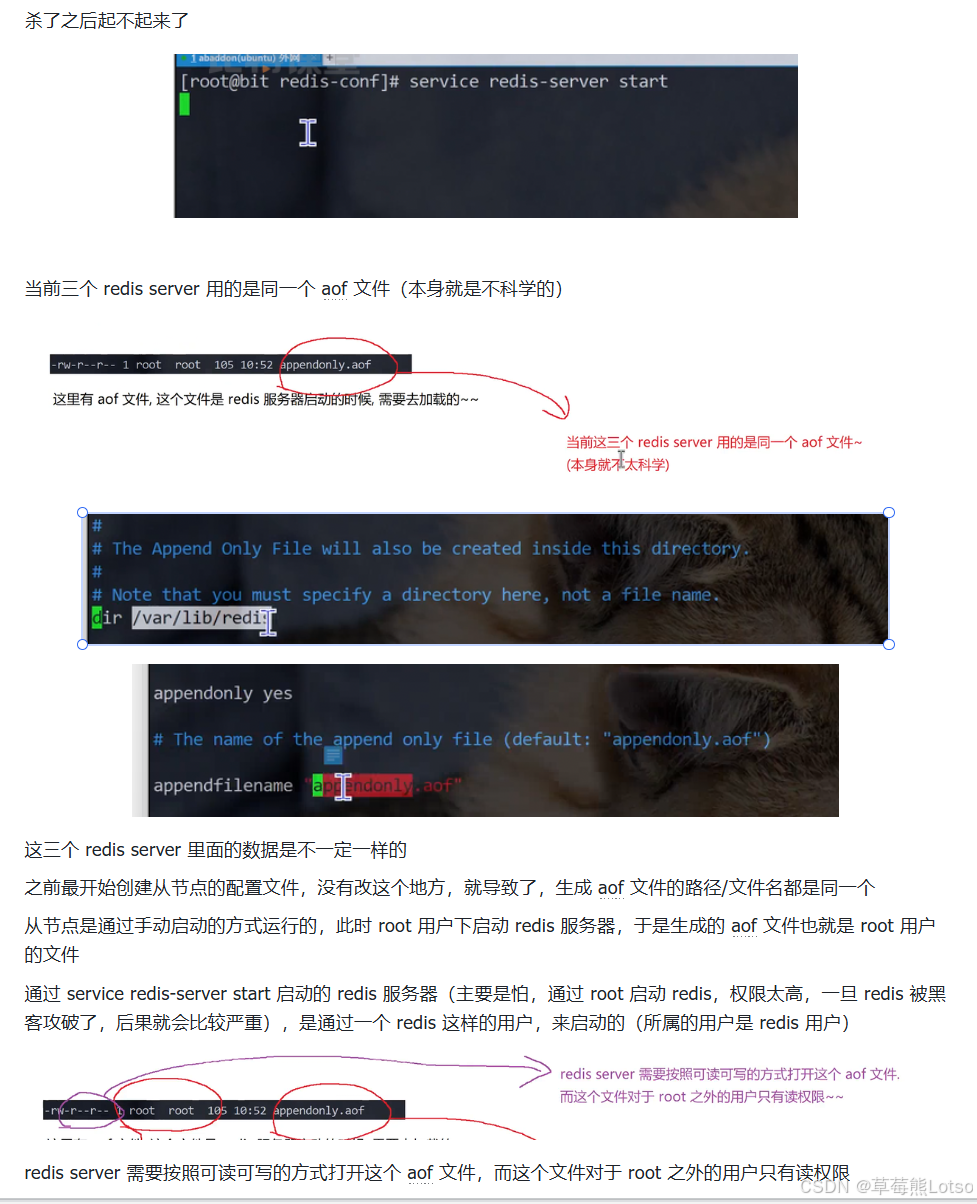
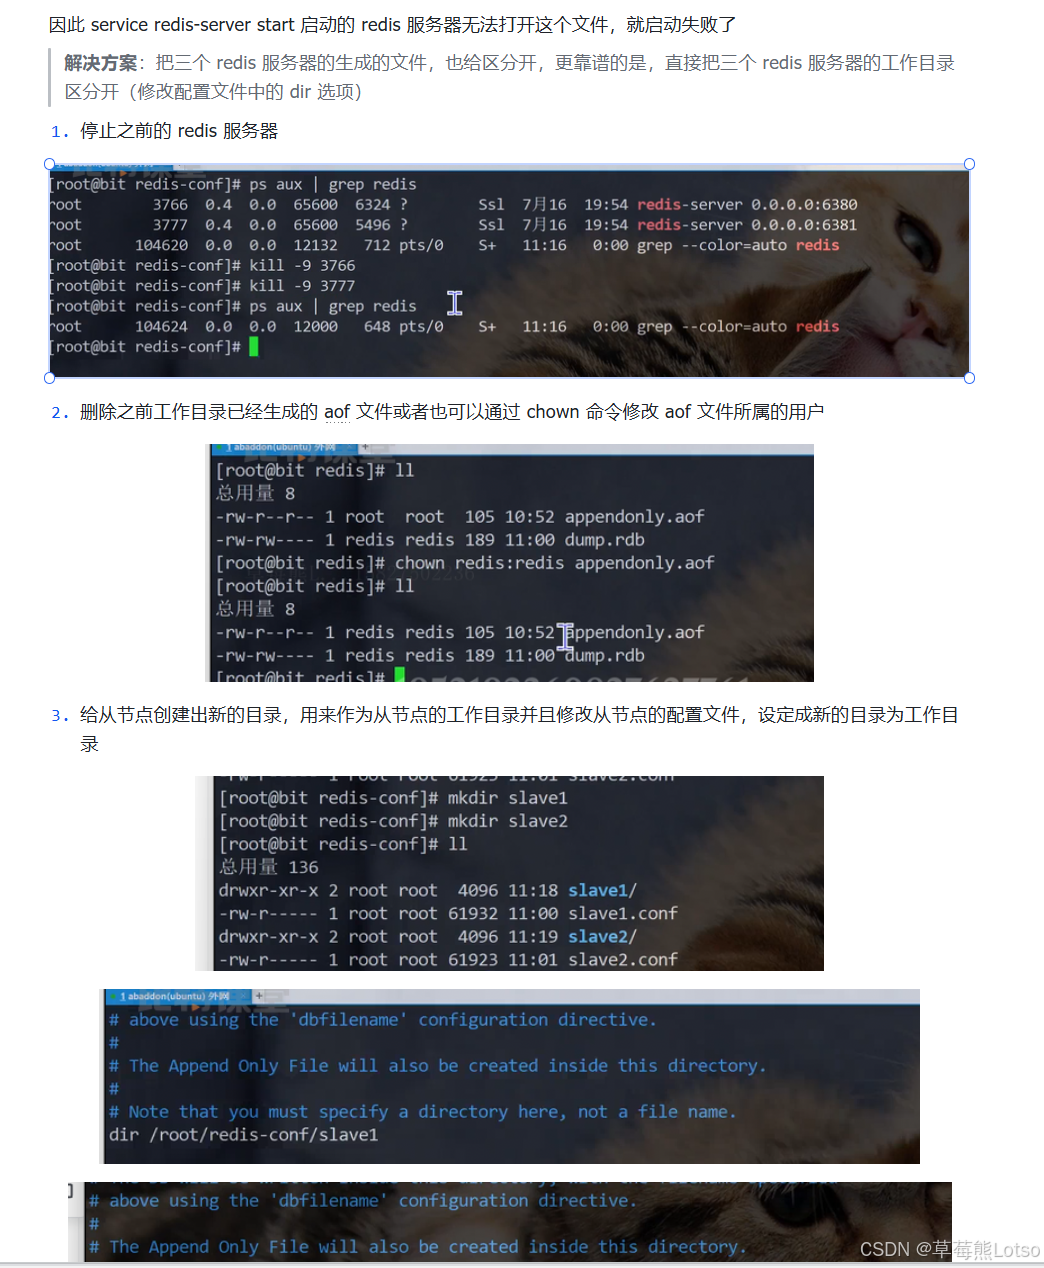
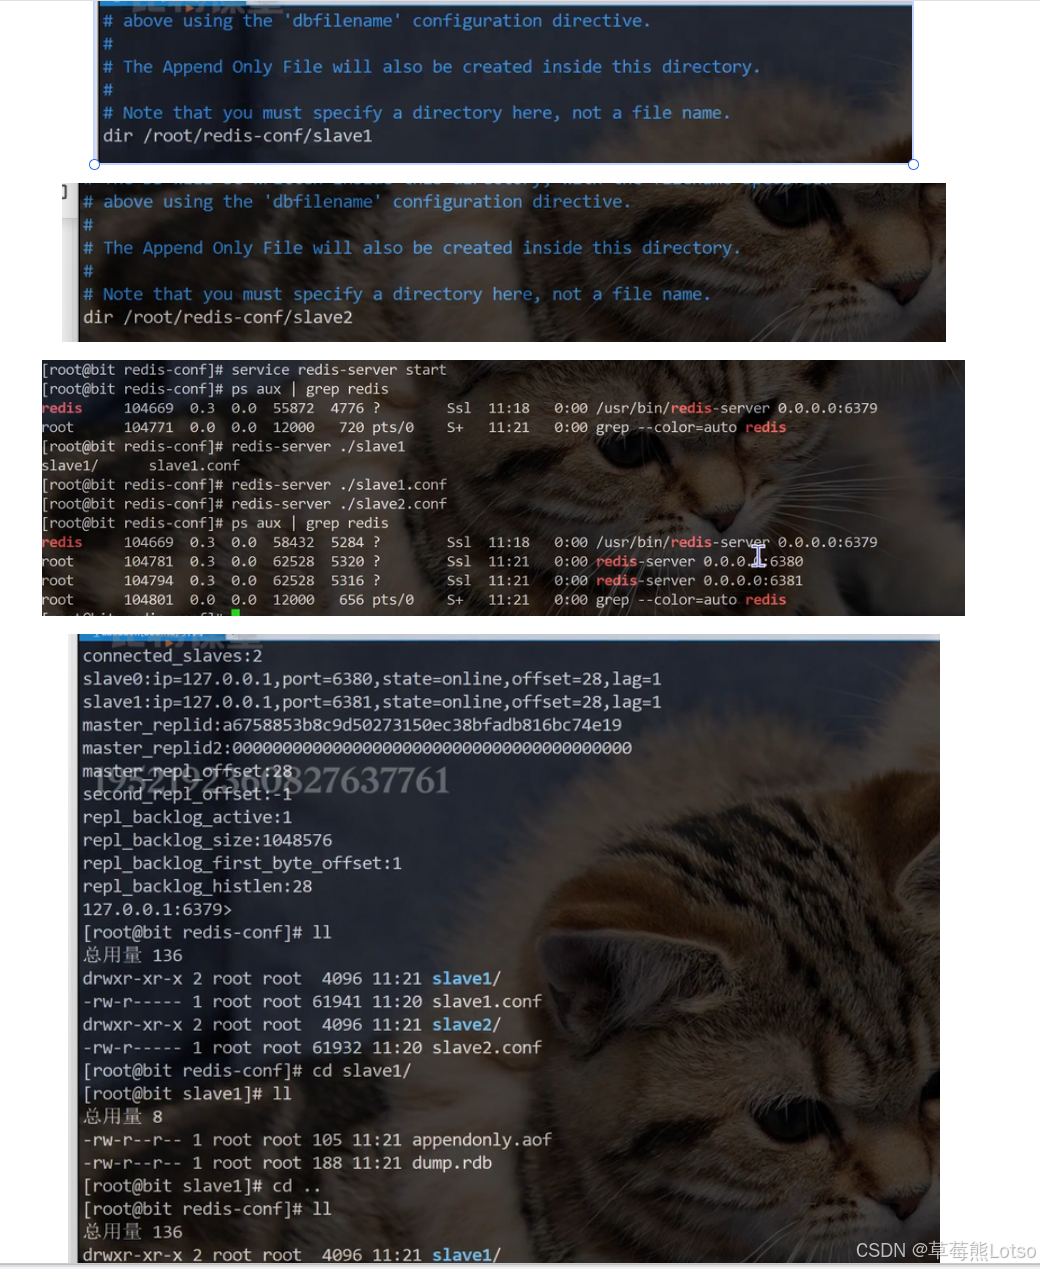
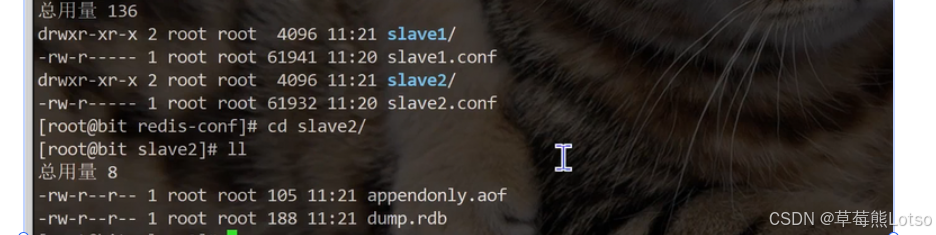
同一台机器部署多个实例时,很容易踩一个坑:所有实例共用同一个工作目录 dir,导致 RDB、AOF 文件互相覆盖,还可能出现权限问题。 比如 root 用户手动启动的实例生成了 root 权限的 AOF 文件,再用 redis 用户通过服务启动时,因为没有写权限而启动失败。 标准解决方案:每个实例单独配置独立的工作目录,各自生成持久化文件,互不干扰。
核心考点总结
- 基础概念:主写从读、单向同步、从节点默认只读;解决读扩展与基础容灾,无法扩展写能力。
- 配置操作 :三种配置主从的方式;
INFO replication关键字段含义;SLAVEOF NO ONE断开复制。 - 拓扑结构:一主一从、一主多从、树形结构的适用场景与优缺点;关闭主节点持久化的注意事项。
- 建立流程:保存信息 → 建连 → PING → 鉴权 → 全量同步 → 增量持续复制。
- PSYNC 协议:replid 标识数据版本,offset 标识同步进度;三种响应对应的同步模式。
- 复制模式
- 全量复制:bgsave 生成 RDB + 缓冲区补发增量,开销大,初次同步使用;
- 部分复制:基于环形积压缓冲区,网络闪断后补发缺失数据,核心优化点;
- 实时复制:长连接增量同步,心跳机制维持连接健康。
- 常见问题:主节点宕机不会自动切换;多实例需独立工作目录;replid 与 runid 的区别。
结尾:
html
🍓 我是草莓熊 Lotso!若这篇技术干货帮你打通了学习中的卡点:
👀 【关注】跟我一起深耕技术领域,从基础到进阶,见证每一次成长
❤️ 【点赞】让优质内容被更多人看见,让知识传递更有力量
⭐ 【收藏】把核心知识点、实战技巧存好,需要时直接查、随时用
💬 【评论】分享你的经验或疑问(比如曾踩过的技术坑?),一起交流避坑
🗳️ 【投票】用你的选择助力社区内容方向,告诉大家哪个技术点最该重点拆解
技术之路难免有困惑,但同行的人会让前进更有方向~愿我们都能在自己专注的领域里,一步步靠近心中的技术目标!
结语:主从复制是 Redis 高可用体系的第一块基石,它解决了数据多副本和读性能扩展的问题,但主节点单点故障的自动切换仍然是空白。也正是为了弥补这个短板,才有了哨兵(Sentinel)机制:自动监控主节点状态、故障时自动选举新主、完成地址切换。理解主从复制的底层原理,不仅能帮你排查日常的同步延迟、数据不一致问题,也为后续学习哨兵和集群打下扎实的基础。
✨把这些内容吃透超牛的!放松下吧✨ ʕ˘ᴥ˘ʔ づきらど