一、整体架构
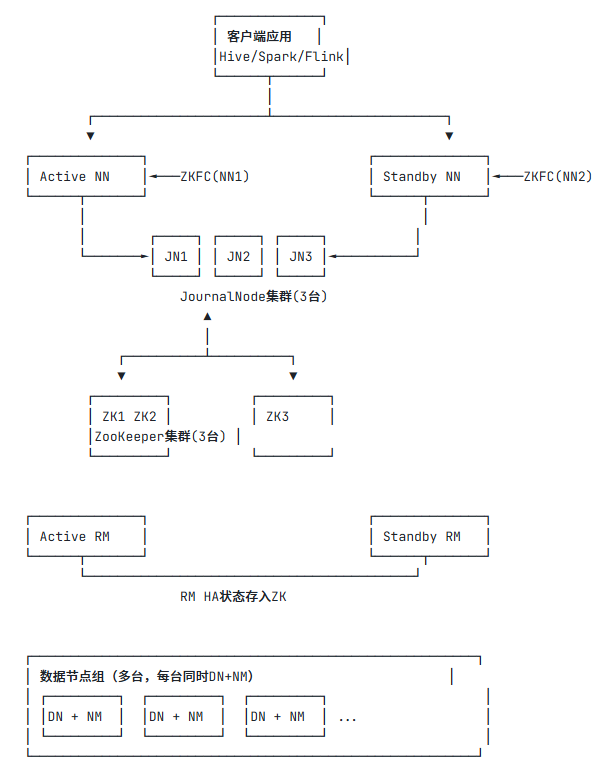
HDFS HA(2 个 NN + JN 集群 + ZKFC) + YARN HA(2 个 RM) + DataNode + NodeManager + ZooKeeper(下表额外添加hbase的服务)
部署习惯:ZK、JN、ZKFC 一般混部;NN、RM 独立;DN 和 NM 同机部署(数据节点)
|--------|----|----|----|----|----|----|---------------------|---|-------|----|-----------------|-----------------|-------------|----------------------|
| | NN | DN | JN | RM | NM | HM | Hbase Region Server | B | kafka | zk | zkfc (HDFS故障转移) | Hive Meta store | Hive Server | SPark history Server |
| Node1 | ✓ | | | ✓ | | ✓ | | | | | ✓ | ✓ | ✓ | ✓ |
| Node2 | ✓ | | | ✓ | | ✓ | | | | | ✓ | | ✓ | ✓ |
| Node3 | | | ✓ | | | | | | ✓ | ✓ | | | | |
| Node4 | | | ✓ | | | | | | ✓ | ✓ | | | | |
| Node5 | | | ✓ | | | | | | ✓ | ✓ | | | | |
| Node6 | | | | | | | | | ✓ | | | | | |
| Node7 | | | | | | | | | ✓ | | | | | |
| Node8 | | | | | | | | ✓ | | | | | | |
| Node9 | | | | | | | | ✓ | | | | | | |
| Node10 | | | | | | | | ✓ | | | | | | |
| Node11 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node12 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node13 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node14 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node15 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node16 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node17 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node18 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node19 | | ✓ | | | ✓ | | ✓ | | | | | | | |
| Node20 | | ✓ | | | ✓ | | ✓ | | | | | | | |
-
部署kafka的机器IO要好
-
Balabce 不长期启动,需要时临时执行
-
Node1、Node2 核心主节点,不部署数据节点,配置cgroup系统限制,禁止yarn任务调度上来
-
Hive 元数据库Mysql 独立部署
-
DN、RegionServer、kafka:用多块数据盘,分开挂载
-
JN部署在DN,小集群可行,但JN频繁写入editlog,若DN磁盘故障,会同时影响元数据和数据块
-
kafka与DN不同机,DN、NM本身IO压力大,kafka对disk连续读写要求高,易产生资源争抢
-
ResionServer与DN同机,离线大数据核心优势数据本地行,Hbase底层依托HDFS,RS优先读取本机DN数据,降低内网带宽压力
二、HDFS HA 相关组件
1. NM(NameNode):元数据管理,2 台做 HA(Active / Standby)
- Active NN:对外提供 HDFS 读写服务;接收客户端请求;维护目录树、文件块映射;把元数据变更写入 JN 集群的 editlog
- Standby NN:不对外提供写服务;持续从 JN 读取 editlog 并回放,保持元数据和 Active 完全一致;定期合并 fsimage+editlog,减轻 Active 压力
- 故障切换:Active 挂掉,ZKFC 自动把 Standby 提升为 Active
注意:NN不存真实文件数据,只存元数据(文件名、目录、块位置、权限)
2. ZKFC(ZooKeeper Failover Controller),每台 NN 上各部署 1 个
- 作用:监控 NN 健康状态 + 借助 ZK 实现主备选举
- 功能:
- 持续监控本机 NN 进程健康
- 在 ZK 创建临时锁节点,抢到锁的 NN 成为 Active
- Active NN 故障时,ZKFC 释放锁,另一台 ZKFC 抢到锁,将 Standby 切换成 Active
- 防脑裂:切换前尝试把旧 Active 隔离(fencing),防止双 Active 同时写 JN
3. JN(JournalNode)集群,3/5 台(奇数),QJM 仲裁存储
- 作用:分布式日志存储,保存 Active NN 产生的editlog(元数据变更流水)
- 机制:过半仲裁,写 editlog 只要超过半数 JN 写入成功即视为成功
- 意义:代替老旧 NFS 共享存储,消除单点;Standby NN 从 JN 拉取日志同步元数据
- 3 台 JN:容忍 1 台 JN 宕机;5 台容忍 2 台宕机
4. DN(DataNode):数据节点,多台(几十 / 上百台)
- 存储真实 HDFS 文件块 block,附带校验和 checksum
- 定期向 NN 上报:心跳(存活、磁盘容量)、块汇报 IBR/FBR(块信息、坏块)
- 负责块副本复制、块校验;读请求时给客户端传输 block 数据
同一台机器一般同时部署 NM
三、YARN HA 相关组件
1. ResourceManager(RM),2 台做 HA(Active / Standby)
- Active RM:全局资源调度器,接收任务提交;管理所有 NM;分配 CPU 内存资源;启动 AM
- Standby RM:不调度任务;状态持久化到 ZK;Active RM 宕机,自动切换为 Active,继续调度任务
YARN HA 依赖 ZK 保存 RM 状态,不需要 JN
2. NodeManager(NM),每台 DN 机器上部署 1 个
- 单机器资源代理,管理本机 CPU、内存
- 负责启动、监控、杀死容器 Container(Spark/Flink/MapReduce 任务跑在 Container 里)
- 定时向 RM 上报心跳:本机资源使用情况、容器运行状态
- 容器崩溃时,NM 通知 RM,RM 安排任务重试
3. ApplicationMaster(AM)【临时容器,不是常驻节点进程】
- 每个任务启动时,RM 分配容器拉起 AM
- AM:向 RM 申请资源;和 NM 通信启动 Task 容器;监控 task 运行,失败重试;任务结束后 AM 销毁
四、ZooKeeper(ZK)集群,3/5 台奇数节点(大数据 HA 底座)
ZK 是整个集群 HA 的基础,HDFS HA、YARN HA 都依赖 ZK 作用:
- 分布式锁:ZKFC 抢锁,选出 Active NN
- 存储元状态:RM HA 状态、故障标记
- 集群成员管理、临时节点、心跳检测
- 协调故障切换,防止脑裂
五、精简版
- ZK 集群(3/5):HA 底座,分布式锁、状态存储,选主
- NN(2 台 HA):HDFS 元数据,Active 对外读写,Standby 同步日志待命;ZKFC 配合 ZK 做 NN 健康监控与自动主备切换
- JN(3/5 奇数):保存 NN 的 editlog,过半仲裁,支撑 HDFS 主备元数据同步
- DN(多台):存储真实 HDFS block 数据,上报块、心跳
- RM(2 台 HA):YARN 全局资源调度,Active 负责任务资源分配,Standby 待命
- NM(多台,和 DN 同机):单机资源管理,启动 / 管理任务容器,上报资源心跳
- AM:每个任务的管理者,临时容器,申请资源、管理 task
六、高频Q&A
Q:JN 和 ZK 作用有啥区别? A:JN 存HDFS 元数据变更日志 editlog,用于 NN 之间同步元数据;ZK 是协调组件,做选主、保存 HA 状态,不存业务 / 元数据。
Q:DN 和 NM 部署在一起好处? A:数据本地性!Spark/MapReduce 任务调度到存有数据块的机器,减少网络 IO。
Q:HA 架构里,哪些组件需要奇数台? A:ZK、JN,需要过半仲裁,必须奇数;NN、RM 是主备,固定 2 台。
其余部分补充:Hadoop 核心架构与高可用-CSDN博客