写在前面
前面的排序专题中,我们已经从冒泡、插入、希尔排序一路学习到堆排序、快速排序和归并排序。上一篇归并排序重点研究了一个非常重要的思想:分治 。递归版本不断把大区间拆成小区间,非递归版本则从 gap = 1 开始,自底向上把小的有序区间不断合并成更大的有序区间。
这一篇可以作为目前排序阶段的一个阶段性收尾。除了新增一种思路完全不同的排序算法------计数排序(Counting Sort),还想顺着前面的内容继续向外延伸几个问题:
- 如果数据多到内存根本装不下,排序还能不能进行?
- 为什么计数排序能达到接近线性的速度?
- 它为什么可以处理负数,却又不能随便用于所有数据?
- 快速排序已经很快了,工程中还能怎样继续优化?
- 基数排序、桶排序又处于什么位置?
- 到目前为止学过的排序算法,时间、空间、稳定性分别有什么区别?
本次代码上单独新增了 CountSort 模块,并把计数排序同步接入原来的 SortComparison 综合测试工程。独立版本的核心接口就是:
void CountSort(int* a, int n);随后在综合测试中作为第 15 组排序算法,继续使用相同的 10 万随机数据进行计时和有序性校验。
当前独立 CountSort 工程中的两个接口也已经这样声明。此外,这两个版本已经同步加入原来的 SortComparison 综合排序工程,继续使用 10 万随机整数 + 相同输入数组 + 运行时间统计 + Check 有序性验证进行测试。
代码仓库 :
数据结构/CountSort · Luminous/Code_2026 - 码云 - 开源中国
SortComparison 排序算法综合工程
代码仓库:
数据结构/SortComparison · Luminous/Code_2026 - 码云 - 开源中国
一、从内部排序到外部排序:归并思想的延伸
1.1 内部排序的前提:数据全部装入内存
前面写的各种排序算法基本都有一个默认前提:数据能够全部放入内存 ,这种排序通常称为内部排序(Internal Sorting)。
例如 10000 个 int,一个 int 按 4 字节计算,只需要大约 400 KB,放在内存里毫无压力。但如果数据规模变成 10 亿个 int,仅原始整数本身就大约需要: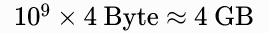 。
假设机器只允许排序程序使用约 1 GB 内存,那么显然不能一次性全部读入内存再调用排序算法。这时就需要进入外部排序(External Sorting)的思路。
1.2 外部排序的核心思路:分块排序 + 多路归并
这正好可以继续使用上一章学习的归并思想。假设待排序数据约 4 GB,可用内存约 1 GB,整体过程可以理解为:
4 GB 原始数据
        ↓
拆成多份能够放进内存的数据块
        ↓
每一块单独读入内存
        ↓
使用 QuickSort / HeapSort / MergeSort 等内部排序
        ↓
得到若干有序文件
        ↓
两两归并
        ↓
继续归并
        ↓
最终得到一个完整有序文件
例如最开始有 4 份有序数据 run1~run4,第一轮归并得到 run12、run34,第二轮归并得到最终结果。这实际上就是把归并排序从内存中的数组区间 ,扩展到了磁盘上的有序文件块。
1.3 归并排序的工程价值
归并排序一个非常重要的工程价值就是:它天然适合外部排序。
真正归并时也不需要把两个完整文件同时读进内存,只需要分别维护输入缓冲区,再维护一个输出缓冲区,就可以边读、边比较、边写入。因此即使数据远大于内存,也依然能够完成排序。
二、计数排序:非比较排序的原理与实现
2.1 比较排序的理论下界
我们前面学习的冒泡、插入、希尔、堆、快速、归并、双向选择排序,本质上都有一个共同点:通过比较两个元素的大小,决定它们的先后顺序 ,这类算法统称为比较排序。
对于通用的比较排序,理论上存在 (\Omega(N\log N)) 级别的比较次数下界。也就是说,当我们看到 QuickSort、HeapSort、MergeSort 都做到 (O(N\log N)) 时,其实已经非常接近通用比较排序能够达到的数量级极限。
那么问题来了:有没有可能排序做到 (O(N))?可以,但是必须放弃一部分"通用性",这就引出了本篇的核心------计数排序。
2.2 计数排序的核心思想
计数排序完全换了一条路:不比较两个元素谁大,而是直接统计每个数出现了多少次。
假设数组:9 2 5 4 7 8 3 2 5 7 普通排序会不断比较元素大小,而计数排序直接统计频次:
- 2 出现 2 次
- 3 出现 1 次
- 4 出现 1 次
- 5 出现 2 次
- 7 出现 2 次
- 8 出现 1 次
- 9 出现 1 次
接下来从最小数字开始依次回填,得到 2 2 3 4 5 5 7 7 8 9,排序就完成了。
本次独立测试使用的正是对应逻辑:
cpp
int arr[] = { 9,2,5,4,7,8,3,2,5,7 };
int n = sizeof(arr) / sizeof(arr[0]);
CountSort(arr, n);
PrintArray(arr, n);
2.3 实现步骤一:扫描最值,确定值域
当前实现并没有默认数据一定从 0 开始,而是先扫描一遍数组得到最小值和最大值:
cpp
int min = a[0];
int max = a[0];

for (int i = 0; i < n; i++)
{
    if (a[i] < min)
        min = a[i];
    if (a[i] > max)
        max = a[i];
}
然后计算整个数据值域:
cpp
int range = max - min + 1;例如 min = 2,max = 9,则 range = 9 - 2 + 1 = 8,只需要创建 8 个计数位置,而不是直接从 0 开到 9。当前 CountSort 正是先扫描得到 min/max,再按照 max-min+1 计算计数范围。
2.4 偏移映射:为什么能处理负数
统计阶段的核心代码:
cpp
for (int i = 0; i < n; i++)
{
    count[a[i] - min]++;
}这一行非常重要,它意味着:count 数组保存的并不是原数值本身,而是"相对于最小值的偏移"。
如果 min = 2,映射关系为:
- 原数据 2 → count0
- 原数据 3 → count1
- ......
- 原数据 9 → count7
也就是: index=value-min 回填时则反过来: (value=index+min)
这也是为什么这份代码能够非常自然地处理负数 。例如数据 -3 -1 2 -3 0,min = -3,range = 6,通过偏移映射后所有下标仍然是 0 ~ range-1 的合法非负整数。
2.5 计数数组的初始化
接下来申请计数数组:
cpp
int* count = (int*)calloc(range, sizeof(int));与 malloc 不同,calloc 申请完成以后会把这片计数数组初始化为 0,非常适合统计出现次数的场景。
例如 min = 2,max = 9,最开始计数全部为 0;扫描原数组以后,对应位置累加得到各数值的出现次数。
2.6 回填数组完成排序
统计完成之后,按照计数结果从小到大回填:
cpp
int j = 0;

for (int i = 0; i < range; i++)
{
    while (count[i]--)
    {
        a[j++] = i + min;
    }
}
从最小偏移开始扫描 count,按照每个数字的出现次数重新写回原数组。由于 i 是从小到大遍历的,最终写回的数组自然就是升序。
2.7 完整代码实现
当前独立版本的核心代码可以整理为:
cpp
void CountSort(int* a, int n)
{
    if (n <= 0)
        return;

    // 找最小值和最大值
    int min = a[0];
    int max = a[0];
    for (int i = 0; i < n; i++)
    {
        if (a[i] < min)
            min = a[i];
        if (a[i] > max)
            max = a[i];
    }

    // 数据值域
    int range = max - min + 1;

    // 创建计数数组,并初始化为0
    int* count = (int*)calloc(range, sizeof(int));
    if (count == NULL)
    {
        perror("calloc fail");
        return;
    }

    // 统计每个数据出现次数
    for (int i = 0; i < n; i++)
    {
        count[a[i] - min]++;
    }

    // 按从小到大的顺序重新写回
    int j = 0;
    for (int i = 0; i < range; i++)
    {
        while (count[i]--)
        {
            a[j++] = i + min;
        }
    }

    free(count);
    count = NULL;
}
它和独立 CountSort.c 的主体逻辑完全一致。
2.8 时间与空间复杂度
定义:
cpp
N = 数据个数
R = max - min + 1(数据值域)
整个算法主要分为三部分:扫描 N 个元素找 min/max → 扫描 N 个元素统计 → 扫描 R 个计数位置回填。
因此时间复杂度: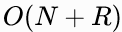
空间复杂度:
如果 R 与 N 同数量级甚至 R << N,那么它看起来几乎就是 O(N),这就是计数排序速度非常夸张的原因。它没有突破数学规律,只是它根本不属于通用的比较排序。
2.9 适用边界:值域决定效率
计数排序最大的弱点:不是 N,而是 range。
例如 N = 10000,但所有数字都只分布在 0 ~ 999,R = 1000,计数排序非常合适。但假设数据只有 2 个,分别是 -100000000 和 100000000,虽然 N 极小,但 R 达到两亿,此时为了两个整数去申请巨大的计数数组显然完全不合理。
所以判断计数排序是否适合,不能只看数据有多少个,而必须同时看数据值域有多大。因此计数排序特别适合:数据量很大,但整数值域相对集中,例如成绩、年龄、小范围 ID、类别编号等。
同时它也天然局限于离散整数。核心的下标映射要求数据值可以直接映射成数组下标,对于浮点数、字符串、结构体等无法简单映射到连续整数下标的数据,不能直接使用基础版计数排序。
2.10 稳定性说明:当前为基础不稳定版
经典计数排序可以实现为稳定排序。但是当前版本只记录一个值出现多少次,并没有记录同样值的多个元素原来的先后顺序。
如果排序的是单纯 int,这个问题看不出来;但如果每个数据还有附属信息,例如同分的不同学生,当前这种"直接根据次数重新生成值"的版本不能保留原始相对顺序。因此本文当前实现应视为不稳定版本。
如果后续需要稳定计数排序,需要通过统计次数、计算前缀和、建立输出数组、按原数组顺序定位元素的方式实现,会比当前入门版稍复杂一些。
2.11 性能测试的注意事项
当前综合工程统一生成随机数组,所有测试都先 memcpy 复原原始数据再进行排序,保证同一次运行里所有算法面对相同输入。综合测试当前的数据规模也是 10000。
但计数排序和其他算法有一个很大的不同:它的性能不仅取决于 N,还取决于随机数据的值域 R。不同平台的 RAND_MAX 不一定一样,如果随机数值域很小,CountSort 会非常快;如果随机数覆盖范围极大,就可能申请巨大的 count 数组,甚至 calloc 失败。
所以如果以后想专门做更加公平、可控的计数排序性能实验,可以显式限定值域,例如:
cpp
arr[i] = rand() % 10000;这样就可以明确研究固定值域条件下的性能,而不是让平台的 RAND_MAX 决定实验结果。
三、排序算法的更多进阶方向
3.1 快速排序的进阶优化
目前我们已经做过三数取中、小区间插入排序、双指针 Partition、挖坑 Partition、非递归显式栈等优化,当前代码确实已经把多个版本都实现出来。但 QuickSort 还能继续优化,这里先简单介绍两个方向。
3.1.1 三路划分:解决大量重复元素
普通 QuickSort 主要划分成 < key、key、> key 三段。但当数组有大量重复数据时,传统二路 Partition 的效率会受到影响。
三路划分则直接把区间分成 < key、= key、> key,等于 key 的整段区域不再参与后续递归。对于重复元素很多的数据,三路快排通常会明显更合适。
3.1.2 Introsort(内省排序):快排与堆排的混合
QuickSort 的优势是平均性能极好,但理论最坏情况为 O(N^2);HeapSort 的优势是最坏情况仍然保持 O(N logN)。
于是工程中自然产生一种思路:能不能平时用 QuickSort,发现递归已经异常深时,再切换 HeapSort?这就是 Introsort(内省排序) 思想之一。
简单理解:先用快速排序,不断统计递归深度;划分正常就继续 QuickSort,递归深度超过阈值时,当前区间改用 HeapSort。同时特别小的区间仍然可以使用 InsertSort。因此最终就形成 QuickSort + HeapSort + InsertSort 的混合排序。
这也是为什么工程级排序函数往往不是教材里某一个算法的"纯版本",而是根据不同数据状态自动切换策略。
3.2 基数排序:按"位"来排
除了计数排序之外,还有一种经典的非比较排序:基数排序(Radix Sort)。
例如十进制整数,可以先按个位排序,再按十位排序,再按百位排序。如果每一轮使用稳定排序,最终就可以得到整体有序结果。它的思想不是比较 A 和 B 谁大,而是先按某一位分类,然后一位一位处理。
基础教材里的 LSD/MSD 基数排序通常主要针对非负整数或能够拆分成固定"位"的离散关键字。对于负数、浮点数并不能直接把最基础的版本原样套上去。当然工程上可以通过正负拆分、编码映射、IEEE 浮点位模式变换等方法继续扩展,所以更准确地说:基础基数排序并不直接适用于普通负整数和浮点数,而不是理论上永远无法处理。
3.3 桶排序:分桶策略与分布假设
桶排序(Bucket Sort)的思想更加直接。假设已知数据 0 ~ 999,可以提前划分多个桶,每个元素先进入自己的桶,每个桶内部再排序,最后按桶顺序拼接。
如果数据分布非常均匀,并且桶划分得合理,性能可以非常优秀。但它对数据的先验条件依赖也更强:值域是多少、数据分布均不均匀、建多少个桶、每个桶范围多大、桶内部采用什么算法,都会影响最终表现。一旦数据严重集中,绝大多数元素都掉进同一个桶,性能就会明显退化。
因此桶排序可以理解为:用更强的数据分布假设换取更高的潜在性能。
四、排序算法全景总览
4.1 核心算法指标对比表
到这里,可以对当前排序阶段做一次比较完整的总结。设 (N) 为元素个数,(R) 为数据值域大小(max-min+1):
| 排序算法 | 最好时间 | 平均时间 | 最坏时间 | 额外空间 | 稳定性 |
|---|---|---|---|---|---|
| 冒泡排序(带 flag) | O(N) | O(N^2) | O(N^2) | O(1) | 稳定 |
| 直接插入排序 | O(N) | O(N^2) | O(N^2) | O(1) | 稳定 |
| 双向选择排序 | O(N^2) | O(N^2) | O(N^2) | O(1) | 不稳定 |
| 希尔排序 | 与增量序列有关 | 与增量序列有关 | 与增量序列有关 | O(1) | 不稳定 |
| 堆排序 | O(N logN) | O(N logN) | O(N logN) | (O(1)) | 不稳定 |
| 快速排序 | O(N logN) | O(N logN) | O(N^2) | 平均 O(log N))递归栈 | 不稳定 |
| 归并排序 | O(N logN) | O(N logN) | O(N logN) | O(N) | 可稳定 |
| 计数排序(当前实现) | O(N+R) | O(N+R) | O(N+R) | O(R) | 当前实现不稳定 |
这里有几个值得特别注意的地方:
- 希尔排序的复杂度不能简单写成一个固定值。它高度依赖 gap 序列;一些增量策略在实际测试中通常明显优于 O(N^2),但不能把某个经验上的 (N^{1.3}) 当成所有 ShellSort 的统一严格结论。
- 归并排序理论上可以稳定,但当前代码需要一个小修改 。如果要真正保持稳定性,合并时相等元素应该优先取左区间,也就是使用
<=而非<。 - 计数排序的复杂度里一定不能漏掉 R。它不是无条件的 O(N),而是 O(N+R),只有值域合适时才真正强大。
4.2 算法选型:没有最好,只有最合适
学完这么多算法以后,最容易出现的一个误区是:"到底哪个排序最好?"其实没有绝对的答案。
- 如果数据很少或者基本有序,InsertSort 可能反而非常合适。
- 如果希望通用数组排序 + 实际速度高,QuickSort 及其混合优化仍然非常重要。
- 如果要求最坏情况也必须保持 O(N logN) 且额外空间尽量小,HeapSort 有自己的价值。
- 如果需要稳定且天然适合外部排序,MergeSort 非常重要。
- 如果数据量巨大且整数值域很小,CountSort 甚至可以直接把 (N logN) 的比较排序甩开。
所以学习排序算法真正重要的并不是背出一个"最快算法",而是理解:不同算法到底利用了什么条件,又付出了什么代价。
五、阶段总结:代码工程与知识体系
5.1 SortComparison 工程现状
目前 SortComparison 中已经统一加入了全部实现:
冒泡排序
直接插入排序
堆排序

希尔排序:
    三重分组
    二重交叉
    Knuth 三重
    Knuth 二重

双向选择排序

快速排序:
    基础优化版
    挖坑法
    双指针独立版
    显式栈非递归版

归并排序:
    递归版
    非递归版

计数排序
从测试文件可以看到,所有算法都继续采用相同的 origin 数据,测试前重新 memcpy,再通过 Check() 验证是否升序,避免"速度很快但排序结果错误"的情况。目前这套工程已经足以作为后续复习排序算法的统一实验平台。
5.2 知识脉络梳理
回头看整个排序专题,其实已经不只是学了十几个函数。
- 从冒泡和插入开始,最早只是思考怎么交换数据、怎么让局部逐渐有序。
- 进入希尔排序以后,开始看到先让数据局部接近有序,再最终完成排序的思路。
- 学习堆以后,开始利用完全二叉树 + 极值维护的结构。
- 快速排序带来了 Partition、分治、递归、基准选择、小区间混合优化。
- 归并排序又进一步理解:分治并不一定都是"先处理再递归",也可以先递归、再合并。
- 到了计数排序,又第一次真正离开"元素之间必须互相比较"这条道路,变成直接利用数据本身的值域信息完成排序。
这其实就是排序学习最有价值的地方:从一种固定写法,逐渐看到算法对数据特征、空间、硬件和应用场景的利用。
写在最后
到计数排序这里,我准备先给这一阶段的排序学习做一个阶段性收尾。
从最基础的 O(N^2),到 O(N logN),再到满足特殊条件时可以做到 O(N+R),真正变化的不只是时间复杂度。每一次性能提升背后,几乎都意味着算法利用了更多信息:
- 插入排序利用已有局部有序性
- 希尔排序通过 gap 提前减少逆序
- 堆排序利用完全二叉树维护极值
- 快速排序利用 Partition 将问题分治
- 归并排序利用两个有序区间可以线性合并
- 计数排序直接利用整数值域
因此不存在一个算法能够在所有情况下同时拥有最快、最省空间、稳定、通用、实现简单、最坏性能优秀。真正的工程算法往往是在不同目标之间做取舍,甚至像 Introsort 一样,把多种算法组合起来使用。
后续如果继续深入排序,还可以再研究三路快速排序、Introsort、稳定计数排序、基数排序、桶排序以及真正的大文件外部排序。不过到这里,比较排序、分治排序、堆排序以及非比较排序的主干已经基本建立起来,可以先把这一阶段的知识整理、复盘,再继续往更深处扩展。