一张成绩单上 19 门"考试",全看懂没必要。这篇文章把它们分成三类、三层,告诉你哪 5 个必须懂、哪 6 个要学会读、剩下 7 个按需看------以及比记指标更重要的两条"读数心法"。读完你会发现:19 项指标,其实只需要记住 5 个,再加两个心眼。
核心分数速览
00 先认识这张成绩单
DeepSeek-V4.1-Flash 发布时,官方放出了一张对比图:7 个模型、19 项指标、全部是"Agentic Benchmark"(智能体能力基准)。7 个模型分别是 DeepSeek-V4.1-Flash、DeepSeek-V4-Pro、DeepSeek-V4-Flash-0731、GLM-5.3、Kimi-K3、GPT 5.6-Sol、Claude Opus 5------既有自己家的三代同堂,也有市面上最顶尖的对手。
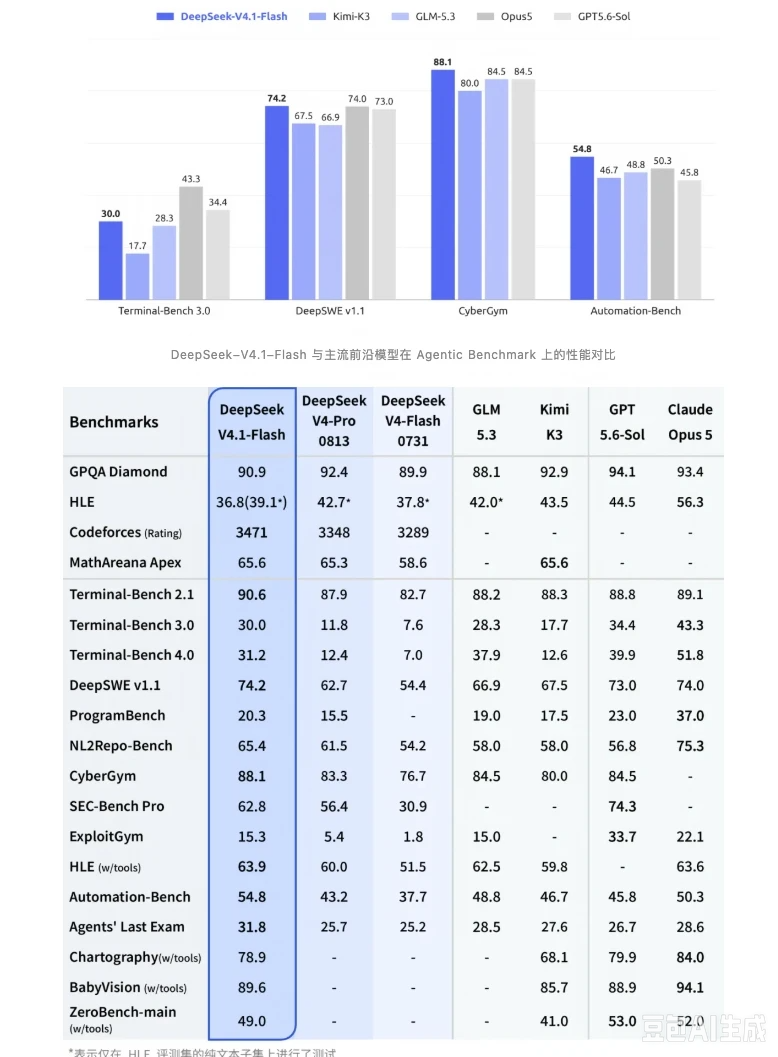
这里要先解释一个词:Agentic Benchmark 测的不是"会不会答题",而是"能不能干活"。传统大模型测评(比如问百科知识、做阅读理解)考的是"脑子",而这一张表考的是"手脚"------让模型操作电脑、写代码、攻防演练、完成一串真实任务。它更接近"把 AI 当员工用"的真实场景,也是这两年大模型竞争的主战场。
看懂这张表,先要学会 3 个记号:
| 记号 | 含义 | 例子 |
|---|---|---|
| * | 这个分数只在 HLE 评测集的纯文本子集上测过,不是全量成绩 | DeepSeek 的 39.1*、GLM 的 42.0* |
| w/tools | 允许模型调用工具(开卷考);没有它则闭卷 | HLE 36.8 → HLE (w/tools) 63.9 |
| Rating | 段位分(Elo 评分),不是百分制 | Codeforces 3471,跟 90.9 不是一个单位 |
记住这三个记号,后面所有指标都不会读错。
01 一张成绩单,19 门"考试"
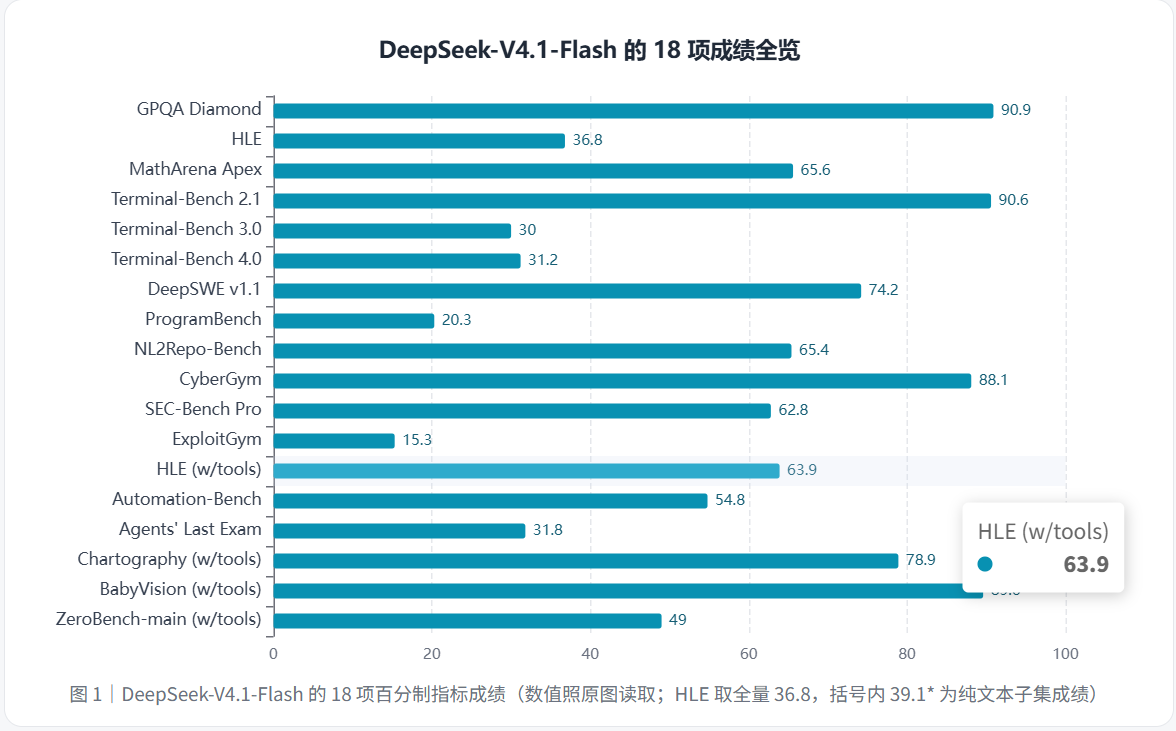
DeepSeek-V4.1-Flash 的这张对比图,本质是一份 AI 全身体检报告。19 项指标就是 19 个检查项目:有查智商的,有查"上手干活"的,有查"会不会闯祸"的,还有一项查"编程竞技段位"的。
19 项指标到底在测什么?一张总表看懂全貌(得分列取 DeepSeek-V4.1-Flash)
| 指标 | 类别 | 测什么 | 怎么考 | 得分 |
|---|---|---|---|---|
| GPQA Diamond | 考脑子 | 研究生级科学问答 | 多选题,题目防搜索引擎 | 90.9 |
| HLE | 考脑子 | 人类最难公开题集 | 2000 多道众筹难题 | 36.8 |
| MathArena Apex | 考脑子 | 数学竞技 | 竞赛级数学题 | 65.6 |
| Terminal-Bench 2.1 | 考干活 | 终端命令行操作 | 真实终端执行任务 | 90.6 |
| Terminal-Bench 3.0 | 考干活 | 终端操作(更真实) | 更贴近真实环境 | 30.0 |
| Terminal-Bench 4.0 | 考干活 | 终端操作(最新) | 最新难度版本 | 31.2 |
| DeepSWE v1.1 | 考干活 | 真实软件工程 | 改真实仓库的真实 issue | 74.2 |
| ProgramBench | 考干活 | 程序编写 | 按需求写函数 | 20.3 |
| NL2Repo-Bench | 考干活 | 自然语言生成仓库 | 一句话生成整个代码库 | 65.4 |
| Automation-Bench | 考干活 | 自动化任务 | 自主完成多步骤流程 | 54.8 |
| Agents' Last Exam | 考干活 | Agent 终极考试 | 最难的 Agent 任务 | 31.8 |
| CyberGym | 考安全 | 网络安全攻防 | 攻防演练环境 | 88.1 |
| SEC-Bench Pro | 考安全 | 安全评测 | 综合安全能力 | 62.8 |
| ExploitGym | 考安全 | 漏洞利用 | 生成可利用漏洞 | 15.3 |
| HLE (w/tools) | 考安全/工具 | 开卷版 HLE | 允许调用工具作答 | 63.9 |
| Chartography (w/tools) | 考视觉 | 图表生成与解读 | 视觉+工具 | 78.9 |
| BabyVision (w/tools) | 考视觉 | 视觉推理 | 图像理解+工具 | 89.6 |
| ZeroBench-main (w/tools) | 考视觉 | 视觉基准 | 零样本视觉任务+工具 | 49.0 |
| Codeforces (Rating) | 特殊项 | 编程竞技水平 | Elo 段位分 | 3471 |
一眼看下来,分数从 90 到 15 都有------同样是"大模型评测",不同指标差的不是一点半点。所以问题不是"考了多少分",而是这些分数各自意味着什么。
把 18 项百分制指标排开(Codeforces 段位分未纳入):
| 指标 | 得分 | 指标 | 得分 |
|---|---|---|---|
| GPQA Diamond | 90.9 | CyberGym | 88.1 |
| HLE | 36.8(纯文本 39.1*) | SEC-Bench Pro | 62.8 |
| MathArena Apex | 65.6 | ExploitGym | 15.3 |
| Terminal-Bench 2.1 | 90.6 | HLE (w/tools) | 63.9 |
| Terminal-Bench 3.0 | 30.0 | Automation-Bench | 54.8 |
| Terminal-Bench 4.0 | 31.2 | Agents' Last Exam | 31.8 |
| DeepSWE v1.1 | 74.2 | Chartography (w/tools) | 78.9 |
| ProgramBench | 20.3 | BabyVision (w/tools) | 89.6 |
| NL2Repo-Bench | 65.4 | ZeroBench-main (w/tools) | 49.0 |
02 先分成三类:考脑子、考干活、考安全
19 项看着吓人,按"考什么"分三类就清晰了。三类分别回答三个问题:它会不会思考?能不能替你干活?会不会闯祸、看不看得懂图?
| 类别 | 回答的问题 | 包含指标 | 看这一类时的要点 |
|---|---|---|---|
| 考脑子 · 知识/推理/数学 | 它会不会思考 | GPQA Diamond、HLE、MathArena Apex | 分数代表"聪明上限",最难刷分,最防背题 |
| 考干活 · Agent/代码/终端 | 能不能替你干活 | Terminal-Bench 2.1/3.0/4.0、DeepSWE、ProgramBench、NL2Repo-Bench、Automation-Bench、Agents' Last Exam | 分数代表"真实生产力",和你的实际使用场景最相关 |
| 考安全与多模态 · 风险/视觉 | 会不会闯祸 + 看不看得懂图 | CyberGym、SEC-Bench Pro、ExploitGym、Chartography、BabyVision、ZeroBench、HLE (w/tools) | 安全类分数要"反着看":能力越强越要配护栏 |
| 特殊项 · 段位分 | 编程竞技水平 | Codeforces (Rating) | Elo 段位分,只跟同类 Rating 比 |
记住每个类的"代表选手"就够了:考脑子看 HLE (最难),考干活看 Terminal-Bench 3.0 (最真实),考安全看 CyberGym(攻防最直接)。
一个更本质的读法:三类对应三种"用人方式"。考脑子,相当于看一个人学历高不高;考干活,相当于试用期看他能不能把活干出来;考安全,相当于看这个人放不放心把钥匙交给他。一个模型三类分数都高,才是真正的全才------但现实中几乎没有模型能同时做到,所以看的时候要按你的用途取舍。
03 第一梯队:5 个必懂
如果时间只够搞懂 5 个,就是下面这 5 个------它们分别回答"聪不聪明、干活行不行、安不安全"三件事。
3.1 GPQA Diamond · 90.9 ------ "研究生入学考试"
考什么: 研究生级别的科学问答,覆盖物理、化学、生物等多个学科。
怎么考: 全是选择题,但题目故意设计成"上网都搜不到答案"(这就是名字里 "Google-Proof" 的意思)------背题、检索都帮不上忙,只能靠真实理解。
分数怎么看: 90.9 说明知识底子非常扎实。但要注意:顶尖模型普遍在 93--94 分,大家都不低。它的真正价值是筛掉差的,而不是区分顶尖的------就像研究生考试,能筛掉没读过书的人,但考 95 和考 98 的人差距没那么大。
常见误区: 看到 90.9 就说"知识能力超过 Claude/GPT"------错。这张表上 GPT 5.6-Sol 是 94.1、Claude Opus 5 是 93.4,DeepSeek 是 90.9,差距在 2--3 分,属于"同一梯队,略有差距"。
3.2 HLE · 36.8(纯文本子集 39.1*)------ "人类终极高考"
考什么: HLE(Humanity's Last Exam,人类最后一考)是全网众筹出来的最难公开题集,2000 多道题横跨所有学科,号称"给超人 AI 准备的期末考试"。
怎么考: 闭卷、不调用工具,硬答。题目的设计原则就是"让最聪明的人都觉得难"。
分数怎么看: 顶尖模型也只有 40 分上下。36.8 不是"差"------这个基准存在的意义就是拉开差距。看它别问"考了多少分",要问"离天花板还有多远"。
一个细节: 39.1* 是只在纯文本子集上测的成绩(带 * 号),和全量 HLE 的 36.8 不是同一口径。表格里 GLM 的 42.0* 同理------带 * 的数字不能直接和全量分数比。
3.3 Terminal-Bench 3.0 / 4.0 · 30.0 / 31.2 ------ "让 AI 坐进工位,操作一台真的电脑"
考什么: 终端(命令行)操作能力。不是选择题,而是让模型坐到一台真实的电脑前,通过敲命令完成任务------装环境、改配置、跑脚本、排查问题。
怎么考: 给它一个真实的任务描述,看它能不能在终端里一步步完成。3.0 比 2.1 更贴近真实环境,4.0 又更难。
分数怎么看: 30.0 / 31.2,跟 2.1 版的 90.6 形成巨大反差。这不是 DeepSeek 变笨了,而是卷子改难了 ------这个反差本身就是最好的教材。分数低恰恰是最真实的写照:会聊天,不等于会干活。做 Agent 型产品,这是最该盯的指标。
横向比: 这张表上 Claude Opus 5 是 43.3、GPT 5.6-Sol 是 34.4,DeepSeek 是 30.0------在"真刀真枪的终端干活"这件事上,大家都不算高,说明这个方向还有巨大的提升空间。
3.4 DeepSWE v1.1 · 74.2 ------ "真实程序员入职考试"
考什么: 真实软件工程能力。给它一个真实开源仓库里的真实 issue,让它把代码改对、把测试跑通,再判断补丁能不能被接受。
怎么考: 比"写一道算法题"难得多------要先读懂整个项目、定位问题、修改代码、保证不破坏其他功能。
分数怎么看: 74.2 属于生产力指标,大致可以换算成"能替你完成多少真实的软件任务"。在这张表的"干活类"指标里,它是 DeepSeek 最拿得出手的一项(比 Claude 74.0、GPT 73.0 还略高)。
为什么值得懂: 代码能力是大模型落地价值最高的场景之一。DeepSWE 测的不是"会不会写",而是"能不能交付"------这是工程师最关心的。
3.5 CyberGym · 88.1 ------ "安全攻防场 + 危险品仓库"
考什么: 网络安全攻防能力。在模拟的攻防环境里,看模型能不能完成防守和进攻两类任务。
怎么考: 类似"红蓝对抗":防守是发现和修复漏洞,进攻是找到可利用的弱点。
分数怎么看: 88.1 是高分。但安全指标要两面读 :能力强是本事,说明模型对安全的理解深入;但越会攻防,越要配好护栏------做发布评估时的必看项。别只把它当"分数"看,要当"风险敞口"看。
横向比: GPT 和 Claude 都是 84.5,Kimi 是 80.0------DeepSeek 在这一项上反而是领先的。
图 2|5 个必懂指标上的五模型对比(数值照原图读取;GLM 的 HLE 42.0* 为纯文本子集成绩)
| 指标 | DeepSeek-V4.1-Flash | Kimi-K3 | GLM-5.3 | Claude Opus 5 | GPT 5.6-Sol |
|---|---|---|---|---|---|
| GPQA Diamond | 90.9 | 92.9 | 88.1 | 93.4 | 94.1 |
| HLE | 36.8 | 43.5 | 42.0* | 56.3 | 44.5 |
| Terminal-Bench 3.0 | 30.0 | 17.7 | 28.3 | 43.3 | 34.4 |
| DeepSWE v1.1 | 74.2 | 67.5 | 66.9 | 74.0 | 73.0 |
| CyberGym | 88.1 | 80.0 | 84.5 | 84.5 | 84.5 |
两个观察:Claude Opus 5 在 HLE、Terminal-Bench 3.0 上明显领先;而 DeepSeek-V4.1-Flash 在 DeepSWE、CyberGym 上并不落下风。单个指标不能定胜负,但"谁在哪类任务上强"一下子就看出来了------这也说明:没有一个模型是全能的,选型要看你的业务最吃哪类能力。
04 第二梯队:6 个应懂
为什么叫"应懂"?因为它们要么单位特殊容易读错 ,要么补全安全与泛化的画像------不会读,就可能得出错误结论。
- Codeforces (Rating) · 3471 ------ 段位分,不是百分制。 千万别拿 3471 和 90.9 比大小------它相当于"编程竞技场的围棋段位",只能和同类的 Rating 比。Codeforces 是顶级编程竞赛平台,3471 意味着已经站在全球最顶尖的竞技选手里(很多职业选手都到不了这个段位)。
- HLE (w/tools) · 63.9 ------ "开卷考"对照。 跟闭卷 HLE(36.8)放在一起看,差值 27 分就是"工具带来的增益"------允许查资料、跑代码之后,分数几乎翻倍。工具调用本身是一种能力,w/tools 就是专门测它的。以后看到任何带 w/tools 的指标,都先问一句:不开卷多少分?
- MathArena Apex · 65.6 ------ 数学竞技场。 考硬推理,和 HLE 互为补充:一个考广度,一个考深度。做数学、科研、金融类产品,这一项优先级要上调。
- SEC-Bench Pro · 62.8 / ExploitGym · 15.3 ------ 安全风险的两块拼图。 SEC-Bench Pro 测综合安全能力,ExploitGym 专测漏洞利用。注意 ExploitGym 分数低在这里是好事 (风险更低)------它是"少闯祸"指标,不是"能力强"指标,方向别读反。一个模型 ExploitGym 得 90 分,不是值得骄傲,而是需要警惕。
- Automation-Bench · 54.8 ------ Agent 泛化。 测 Agent 能不能自己完成一串自动化任务。和 Terminal-Bench 的区别:一个在终端里干,一个在多步骤流程里干(比如"订机票→订酒店→做行程表"这种长链条任务)。
05 第三梯队:7 个按需看
不是不重要,而是只在特定场景才需要关心。看你的用途,按需取用。
- Terminal-Bench 2.1 · 90.6 ------ 旧版卷子,已经"考不出差距"(饱和)。 当历史参考即可------这也是"指标饱和"的活教材:一个基准如果顶尖模型都考到 90 分以上,它就不再能区分模型了。
- ProgramBench · 20.3 / NL2Repo-Bench · 65.4 ------ 代码生成的两个细分赛道。 ProgramBench 考"按需求写函数"(20.3 偏低,说明复杂程序生成还吃力);NL2Repo 考"一句话生成整个代码仓库"(65.4)。做代码助手类产品再看它们。
- Agents' Last Exam · 31.8 ------ Agent 版"终极高考"。 和 HLE 对应:HLE 考脑子的上限,它考 Agent 干活的上限。31.8 说明离"全能 Agent"还远,看它是为了知道边界在哪。
- Chartography · 78.9 / BabyVision · 89.6 / ZeroBench-main · 49.0 ------ 多模态/视觉场景才看。 三个都带 w/tools(允许用工具):Chartography 考图表生成与解读,BabyVision 考图像理解,ZeroBench 考零样本视觉任务。做"看图/做图"类产品时,这几项是你的主战场。
06 两条读数心法(比记指标更重要)
指标记不住没关系,记住这两条,任何测评都不会读错。
心法一 · 比分数之前,先比版本难度
Terminal-Bench 2.1 → 3.0:90.6 → 30.0 。同一族基准,卷子一改难,分数直接跳水 60 分。90 分和 30 分说的根本不是一回事------看榜单先确认版本号,别被"高分"骗了。同理,MMLU 老版和 MMLU-Pro、HLE 和旧基准之间,都是"卷子难度"在变,不是模型能力在变。
图 3a|三个模型在 Terminal-Bench 2.1 / 3.0 / 4.0 上的"跳水"(数值照原图读取)
| 版本 | DeepSeek-V4.1-Flash | GPT 5.6-Sol | Claude Opus 5 |
|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 88.8 | 89.1 |
| Terminal-Bench 3.0 | 30.0 | 34.4 | 43.3 |
| Terminal-Bench 4.0 | 31.2 | 39.9 | 51.8 |
三个模型一起"跳水",说明不是某个模型的问题,而是版本难度整体抬升。所以跨版本比分数,就像拿今年的高考题和去年的比------题目变了,分数不可比。
心法二 · 看清"开卷考"还是"闭卷考"
HLE 36.8 → HLE (w/tools) 63.9:多了工具,涨了 27 分。"w/tools" 行测的是"给工具后能涨多少",跟不带工具的分数是两码事,混着比就错了。
图 3b|各模型 HLE 闭卷 vs 开卷(GPT 5.6-Sol 的 w/tools 未公布;数值照原图读取)
| 模型 | HLE(闭卷) | HLE (w/tools)(开卷) | 工具增益 |
|---|---|---|---|
| DeepSeek-V4.1-Flash | 36.8 | 63.9 | +27.1 |
| Kimi-K3 | 43.5 | 59.8 | +16.3 |
| GLM-5.3 | 42.0* | 62.5 | +20.5 |
| Claude Opus 5 | 56.3 | 63.6 | +7.3 |
| GPT 5.6-Sol | 44.5 | --- | --- |
这张表还藏着第二个信息:闭卷越强的模型,工具增益反而越小 (Claude 闭卷最高、增益最小)。这说明"基础能力强"和"会用工具"是两种不同的能力,开卷分数拉平了基础差距。如果你的产品会给模型配工具,看 w/tools 那一列;如果不配,看闭卷那列。
附:四个常见错误读法(防坑清单)
- 拿 Rating 和百分制比大小 ------ 3471 不是"3471%",跨单位比较毫无意义。
- 把带 * 的成绩当全量成绩 ------ 纯文本子集 ≠ 全量,口径不一致。
- 跨版本比分数 ------ Terminal-Bench 2.1 的 90 和 3.0 的 30 不是一个难度。
- 单指标定胜负 ------ "某个指标比我高"不等于"模型比我强",看组合、看分项、看你的场景。
07 总结:一张图看懂 DeepSeek-V4.1-Flash
把 19 项里最典型的 10 项按"强 / 弱"排开,这个模型的画像就出来了:
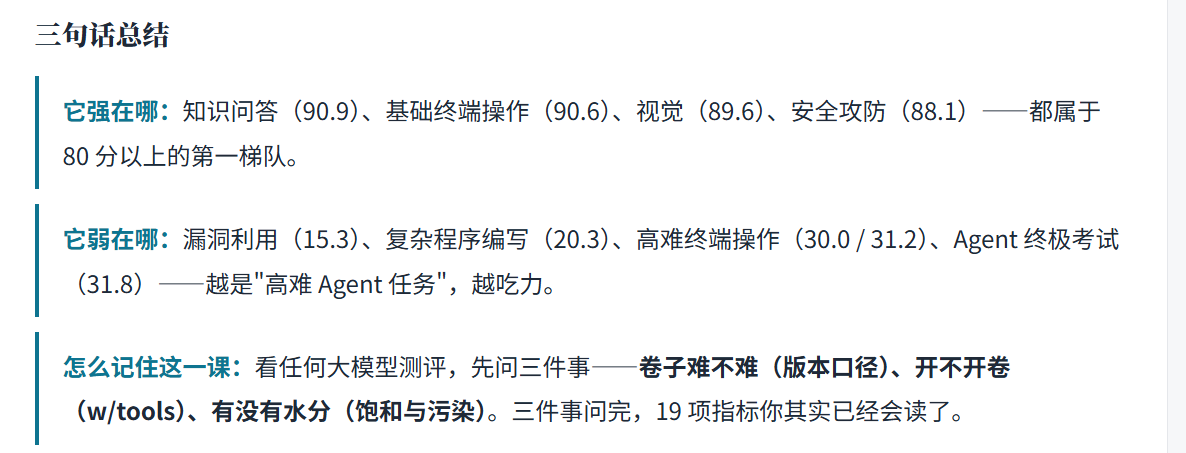
图 4|DeepSeek-V4.1-Flash 强弱画像(数值照原图读取)
| 相对偏弱 | 得分 | 相对偏强 | 得分 |
|---|---|---|---|
| ExploitGym | 15.3 | Chartography | 78.9 |
| ProgramBench | 20.3 | CyberGym | 88.1 |
| Terminal-Bench 3.0 | 30.0 | BabyVision | 89.6 |
| Terminal-Bench 4.0 | 31.2 | Terminal-Bench 2.1 | 90.6 |
| Agents' Last Exam | 31.8 | GPQA Diamond | 90.9 |
三句话总结
08 附:不同场景,重点看哪些指标(实操速查)
同样的 19 项,不同用途的人应该看不同的组合:
| 你的场景 | 重点看 | 一句话理由 |
|---|---|---|
| 通用模型选型 | GPQA Diamond + HLE + Codeforces + DeepSWE + CyberGym | 推理、代码、安全三件套,覆盖基本面 |
| 做 Agent 产品 | Terminal-Bench 3.0/4.0 + Automation-Bench + Agents' Last Exam | 直接对应"能不能替你干活" |
| 做代码类产品 | DeepSWE + ProgramBench + NL2Repo + Codeforces | 真实工程 + 生成 + 竞技段位 |
| 做安全/风控/发布评估 | CyberGym + SEC-Bench Pro + ExploitGym | 能力与风险双线并行,ExploitGym 越高越要警惕 |
| 做多模态/视觉产品 | BabyVision + Chartography + ZeroBench | 视觉推理、图表、零样本三大件 |
| 内部版本回归 | 与你业务相关的 3--5 项 + 固定版本号 | 防止"卷子变了"导致误判 |
最后一条建议: 与其盯着 19 项全看,不如锁定 5 个核心指标 + 固定版本号 + 固定评测设置,做你自己的长期跟踪表 。分数本身没有意义,趋势和相对位置才有意义------这才是测评的最终目的。
附注
- * 表示仅在 HLE 评测集的纯文本子集上进行了测试(图片底部注释)。
- "w/tools" = 允许模型调用工具作答。
- 全部数值直接读取自原图《DeepSeek-V4.1-Flash 与主流前沿模型在 Agentic Benchmark 上的性能对比》(用户提供,2026 年 9 月);Codeforces 为 Elo 段位分,未纳入百分制图表。
- 各基准的难度与定义以官方文档为准;本文为科普向梳理。
#(注:内容由AI生成)