文章目录
- PINNs的参数反演------从"正问题"到"逆问题"的工程改造
-
- 一、从正问题到逆问题的最小改动:把未知常数设为nn.Parameter
-
- [1.1 正问题的代码模板](#1.1 正问题的代码模板)
- [1.2 逆问题最小改动:k变成nn.Parameter](#1.2 逆问题最小改动:k变成nn.Parameter)
- [1.3 训练循环的改动](#1.3 训练循环的改动)
- 二、数据项的引入:观测点的loss怎么写、权重怎么设
-
- [2.1 数据项的位置决定了它"管什么"](#2.1 数据项的位置决定了它“管什么”)
- [2.2 数据项权重的设定](#2.2 数据项权重的设定)
- [2.3 数据自洽性:一个被忽视的工程前提](#2.3 数据自洽性:一个被忽视的工程前提)
- [2.4 尺度锚定:为什么 k(x) 会整体偏低 30%](#2.4 尺度锚定:为什么 k(x) 会整体偏低 30%)
- [三、空间变化参数场的处理:用子网络表示 k ( x ) k(x) k(x)](#三、空间变化参数场的处理:用子网络表示 k ( x ) k(x) k(x))
-
- [3.1 全局常数 vs 空间变化场](#3.1 全局常数 vs 空间变化场)
- [3.2 计算图拼接:梯度如何从PDE残差反传到参数网络](#3.2 计算图拼接:梯度如何从PDE残差反传到参数网络)
- [3.3 训练不稳定的工程对策](#3.3 训练不稳定的工程对策)
- 四、一维稳态Darcy流的完整代码:正问题到逆问题逐行改造
-
- [4.1 问题设定](#4.1 问题设定)
- [4.2 完整逆问题代码](#4.2 完整逆问题代码)
- [4.3 正问题版本到逆问题版本的改动清单](#4.3 正问题版本到逆问题版本的改动清单)
- 五、调试记录:从37%到12%的四轮迭代
-
- [5.1 第 1 轮:k 被压成常数线](#5.1 第 1 轮:k 被压成常数线)
- [5.2 第 2 轮:调参无效](#5.2 第 2 轮:调参无效)
- [5.3 第 3 轮:用有限差分生成自洽数据](#5.3 第 3 轮:用有限差分生成自洽数据)
- [5.4 第 4 轮:加 flux 观测锚定尺度](#5.4 第 4 轮:加 flux 观测锚定尺度)
- [5.5 关于 L r e g L_{reg} Lreg 上升的解释](#5.5 关于 L r e g L_{reg} Lreg 上升的解释)
- [六、反演精度的评估:相对误差 vs 训练epoch](#六、反演精度的评估:相对误差 vs 训练epoch)
-
- [6.1 三个阶段的收敛特征](#6.1 三个阶段的收敛特征)
- [6.2 反演误差收敛曲线](#6.2 反演误差收敛曲线)
- 七、与MCMC结合的思路:PINN做前向代理,MCMC做后验采样
-
- [7.1 PINN+MCMC的两阶段框架](#7.1 PINN+MCMC的两阶段框架)
- [7.2 什么时候值得上MCMC](#7.2 什么时候值得上MCMC)
- 八、工程落地的七个关键经验
- 参考资料
PINNs的参数反演------从"正问题"到"逆问题"的工程改造
代码仓库 :GitHub - PINN-Inverse-Darcy
如果你在做的是热传导方程,把本文的Darcy方程 − ∇ ⋅ ( k ∇ h ) = f -\nabla \cdot (k \nabla h) = f −∇⋅(k∇h)=f 换成 − ∇ ⋅ ( λ ∇ T ) = q -\nabla \cdot (\lambda \nabla T) = q −∇⋅(λ∇T)=q,未知参数从渗透率 k k k 换成热导率 λ \lambda λ 即可。如果你在做的是弹性力学问题,把未知参数换成杨氏模量 E ( x ) E(x) E(x) 即可。
做PINNs正问题的时候,方程里的系数是已知的------你只需要让网络拟合解 u ( x , t ) u(x,t) u(x,t)。但做反问题的时候,方程里有一项是未知的,你要从稀疏的观测数据中把它反推出来。这两件事在代码上只差几行,但在计算图结构上,差的是整条梯度回传路径。
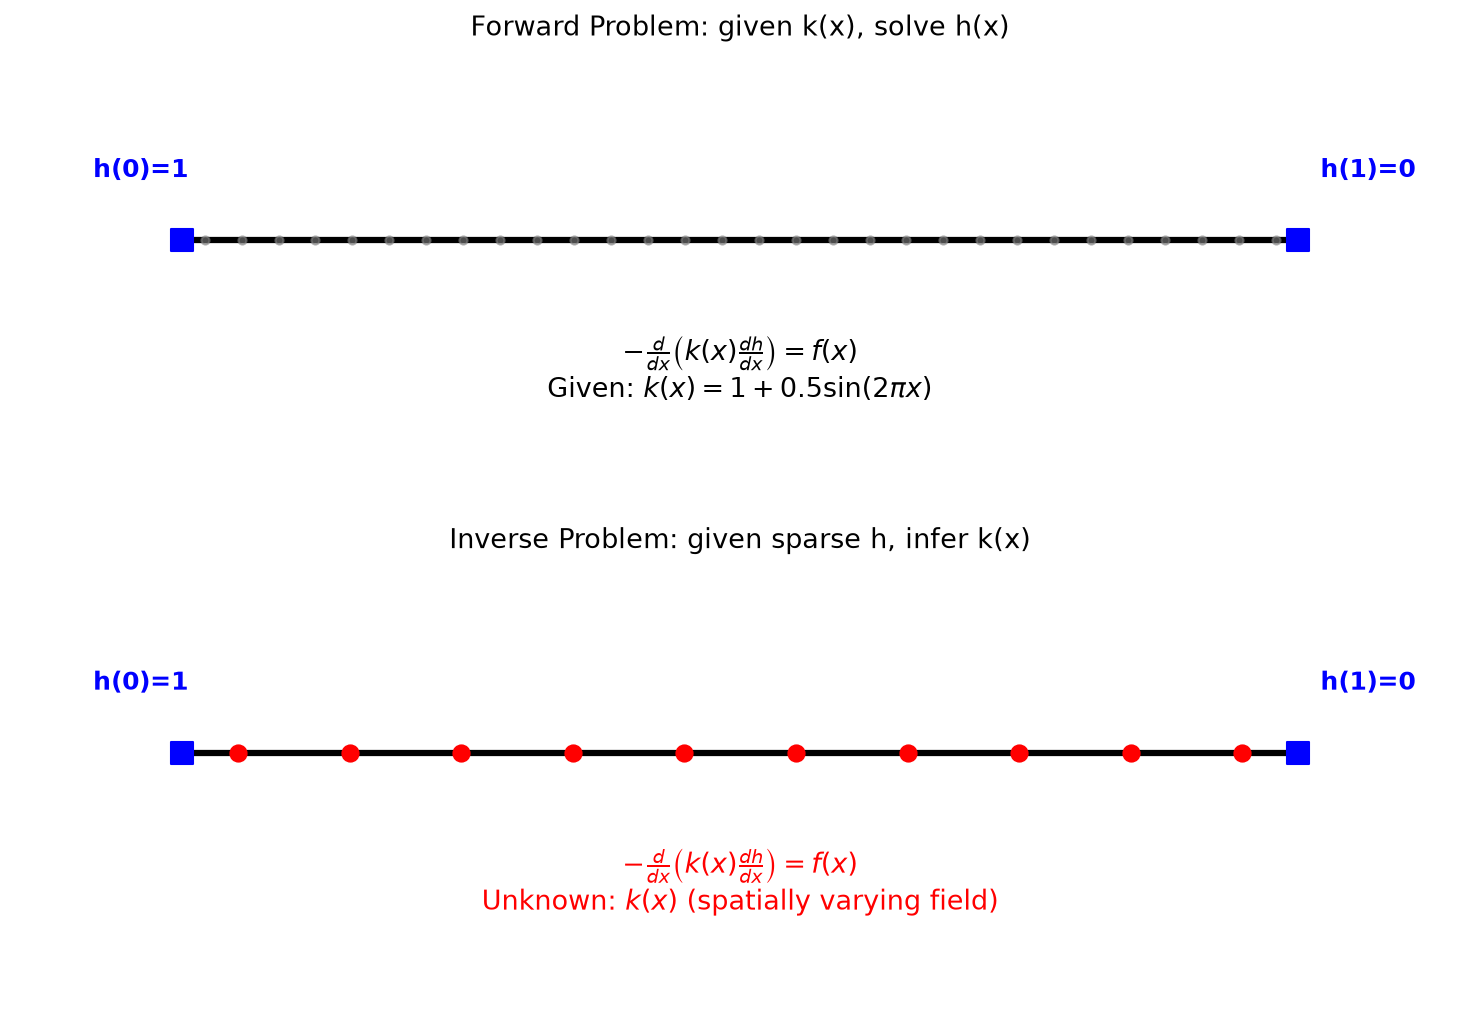
这篇以"把正问题代码改造成逆问题代码"为主线,把每一处需要动的地方都标出来。正问题用一维稳态Darcy流:
− d d x ( k ( x ) d h d x ) = f ( x ) , x ∈ 0 , 1 -\frac{d}{dx}\left(k(x) \frac{dh}{dx}\right) = f(x), \quad x \in 0, 1 −dxd(k(x)dxdh)=f(x),x∈0,1
其中 h ( x ) h(x) h(x) 是水头, k ( x ) k(x) k(x) 是渗透率, f ( x ) f(x) f(x) 是源汇项。正问题是已知 k ( x ) k(x) k(x) 求 h ( x ) h(x) h(x),逆问题是已知 h ( x ) h(x) h(x) 的部分观测值求 k ( x ) k(x) k(x)。
这篇的独特之处在于,它不仅给出"一次跑通"的代码,还完整记录从 37% 到 12% 的四轮调试过程。 大多数PINN反演教程的失败,不是算法问题,而是数据不自洽 和尺度不确定性这两个被忽视的工程前提。
一、从正问题到逆问题的最小改动:把未知常数设为nn.Parameter
1.1 正问题的代码模板
先看正问题的完整实现------这是改造的起点:
python
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt

class DarcyPINN(nn.Module):
    """一维稳态Darcy流正问题PINN
    方程: -d/dx(k * dh/dx) = f(x)
    """
    def __init__(self, layers=[1, 64, 64, 64, 1]):
        super().__init__()
        self.layers = nn.ModuleList()
        for i in range(len(layers) - 1):
            self.layers.append(nn.Linear(layers[i], layers[i+1]))
        # 自适应斜率,加速收敛
        self.alpha = nn.Parameter(torch.ones(1) * 1.0)

    def forward(self, x):
        """输入: x (N, 1); 输出: h (N, 1)"""
        inputs = x
        for layer in self.layers[:-1]:
            inputs = layer(inputs)
            inputs = torch.tanh(self.alpha * inputs)
        return self.layers[-1](inputs)

# 正问题: 渗透率k是已知常数
K_TRUE = 1.0  # 均匀渗透率

def compute_pde_residual(model, x, k=K_TRUE):
    """计算PDE残差: f = -d/dx(k * dh/dx) - source"""
    x.requires_grad_(True)
    h = model(x)

    # 一阶导: dh/dx
    h_x = torch.autograd.grad(h, x, torch.ones_like(h), create_graph=True)[0]
    # k * dh/dx
    k_h_x = k * h_x
    # 二阶导: d/dx(k * dh/dx)
    k_h_xx = torch.autograd.grad(k_h_x, x, torch.ones_like(k_h_x), create_graph=True)[0]

    # 源汇项 (假设常数)
    source = torch.ones_like(x) * 1.0
    f = -k_h_xx - source
return f正问题的代码很直接:k 是一个常数,直接乘在 h_x 上就行。
1.2 逆问题最小改动:k变成nn.Parameter
现在假设我们不知道 k k k 是多少,但有一些 h ( x ) h(x) h(x) 的观测数据。逆问题的第一步改造极其简单:
python
class InverseDarcyPINN(nn.Module):
    """一维稳态Darcy流逆问题PINN
    方程: -d/dx(k * dh/dx) = f(x)
    未知: 渗透率k (全局常数)
    """
    def __init__(self, layers=[1, 64, 64, 64, 1]):
        super().__init__()
        self.net = DarcyPINN(layers)
        # 关键改动: k从常数变成可训练参数
        # 用log参数化保证k始终为正 (渗透率必须大于0)
        self.log_k = nn.Parameter(torch.tensor(0.0))

    @property
    def k(self):
        """可训练的渗透率,通过exp保证正值"""
        return torch.exp(self.log_k)

    def forward(self, x):
        return self.net(x)

def compute_pde_residual_inverse(model, x):
    """逆问题的PDE残差: k来自模型参数"""
    x.requires_grad_(True)
    h = model(x)

    h_x = torch.autograd.grad(h, x, torch.ones_like(h), create_graph=True)[0]
    # 这里用model.k而不是外部传入的k
    k_h_x = model.k * h_x
    k_h_xx = torch.autograd.grad(k_h_x, x, torch.ones_like(k_h_x), create_graph=True)[0]

    source = torch.ones_like(x) * 1.0
    f = -k_h_xx - source
    return f
为什么用 log_k 而不是直接 k = nn.Parameter(...)? 因为渗透率必须是正数。如果直接优化 k k k,优化器可能把 k k k 推向负值,导致PDE残差的物理意义消失。用 k = e θ k = e^{\theta} k=eθ 参数化后,无论 θ \theta θ 取什么值, k k k 永远是正的。这在工程上是一个简单但极其重要的细节------很多PINN反问题的失败不是因为算法不对,而是因为参数化方式不对。
1.3 训练循环的改动
正问题的训练循环只用PDE残差。逆问题需要增加数据项:
python
def train_inverse(model, x_col, x_obs, h_obs, n_epochs=20000, lr=1e-3):
    """
    x_col: 域内配点
    x_obs, h_obs: 观测点和观测值 (稀疏、可能带噪声)
    """
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)
    losses = {'pde': [], 'data': [], 'k': []}

    for epoch in range(n_epochs):
        optimizer.zero_grad()

        # 1. PDE残差损失
        f = compute_pde_residual_inverse(model, x_col)
        loss_pde = torch.mean(f ** 2)

        # 2. 数据拟合损失 (新增项)
        h_pred = model(x_obs)
        loss_data = torch.mean((h_pred - h_obs) ** 2)

        # 3. 复合损失
        # 为什么数据项权重取10?
        # 观测数据通常比PDE配点少得多,如果不加权,数据项会被PDE残差淹没
        loss = loss_pde + 10.0 * loss_data

        loss.backward()
        optimizer.step()

        losses['pde'].append(loss_pde.item())
        losses['data'].append(loss_data.item())
        losses['k'].append(model.k.item())

        if epoch % 2000 == 0:
            print(f"Epoch {epoch:5d} | PDE: {loss_pde.item():.2e} | "
                  f"Data: {loss_data.item():.2e} | k: {model.k.item():.4f}")

    return losses
二、数据项的引入:观测点的loss怎么写、权重怎么设
2.1 数据项的位置决定了它"管什么"
数据项 L d a t a \mathcal{L}_{data} Ldata 是一个约束------它告诉网络"在这些点上,你的输出必须和观测值一致"。但它和PDE残差的约束角色不同:
| 损失项 | 约束对象 | 约束范围 | 对反演的影响 |
|---|---|---|---|
| PDE残差 | 方程结构 | 全域配点 | 保证解满足物理规律 |
| 数据项 | 观测值 | 稀疏观测点 | 锚定解的具体形状,反推系数 |
| 边界条件 | 边界值 | 边界 | 保证解的物理合理性 |
逆问题的本质矛盾是:PDE残差和未知系数之间存在"共谋关系" 。如果只优化PDE残差,网络可以找到一组 ( h , k ) (h, k) (h,k) 使得残差为零,但这组 k k k 可能是完全错误的。数据项的作用就是打破这种共谋。
2.2 数据项权重的设定
数据项权重的设定是逆问题中最棘手的问题之一。推荐一个自适应方案:
python
class AdaptiveDataWeight:
    """自适应数据项权重
    核心思想: 让数据项和PDE残差的梯度范数保持均衡
    """
    def __init__(self, model, alpha=0.1):
        self.model = model
        self.alpha = alpha  # 权重更新步长
        self.lambda_data = 10.0  # 初始值

    def update(self, loss_pde, loss_data, optimizer):
        """根据梯度范数比值调整权重"""
        # 计算PDE损失对网络参数的梯度范数
        grad_pde = torch.autograd.grad(
            loss_pde, self.model.parameters(),
            retain_graph=True, allow_unused=True
        )
        gn_pde = sum(g.norm()**2 for g in grad_pde if g is not None) ** 0.5

        # 计算数据损失对网络参数的梯度范数
        grad_data = torch.autograd.grad(
            loss_data, self.model.parameters(),
            retain_graph=True, allow_unused=True
        )
        gn_data = sum(g.norm()**2 for g in grad_data if g is not None) ** 0.5

        # 让数据项的梯度范数逼近PDE项的梯度范数
        ratio = (gn_data / (gn_pde + 1e-8)).detach()
        self.lambda_data = self.lambda_data * (1 + self.alpha * (ratio - 1))
        self.lambda_data = max(self.lambda_data, 0.1)  # 下限保护

        return self.lambda_data
为什么用梯度范数而非损失值来调权重? 因为损失值的大小不能反映该项对参数更新的实际贡献。一个损失值很小但梯度很大的项,可能在优化中占主导地位。梯度范数才真正决定了优化器会把参数往哪个方向推。
2.3 数据自洽性:一个被忽视的工程前提
逆问题的输入是观测数据 h o b s h_{obs} hobs。如果 h o b s h_{obs} hobs 是由一个和真实 k ( x ) k(x) k(x) 无关的解析函数 生成的,那么 PINN 会发现:不存在任何 k ( x ) k(x) k(x) 能同时满足 PDE 和观测数据。此时 PINN 只能找"最小二乘意义下的折衷解"------通常是一条常数线。
正确的做法 :先给定 k true ( x ) k_\text{true}(x) ktrue(x),用有限差分(或有限元)求解正问题,得到 h true ( x ) h_\text{true}(x) htrue(x),再从 h true h_\text{true} htrue 采样观测点。
python
def solve_forward_fd(k_func, f_value, x_grid, h_left=1.0, h_right=0.0):
    """
    用二阶有限差分解正问题 -d/dx(k dh/dx) = f
    """
    n = len(x_grid)
    dx = x_grid[1] - x_grid[0]

    # 计算单元中心处的k值
    k_half = k_func(0.5 * (x_grid[:-1] + x_grid[1:]))

    # 组装三对角系统 A h = b
    A = np.zeros((n, n))
    b = np.full(n, f_value * dx * dx)

    for i in range(1, n - 1):
        kL = k_half[i - 1]
        kR = k_half[i]
        A[i, i - 1] = -kL
        A[i, i]     =  kL + kR
        A[i, i + 1] = -kR

    # Dirichlet边界条件
    A[0, 0]   = 1.0;  b[0]   = h_left
    A[-1, -1] = 1.0;  b[-1]  = h_right

    return np.linalg.solve(A, b)
用 401 个点的细网格求解后,再从 h true h_\text{true} htrue 中插值采样观测点:
python
x_fine = np.linspace(0.0, 1.0, 401)
k_fine = reference_k(x_fine)
h_fine = solve_forward_fd(reference_k, cfg.source, x_fine)

# 从FD解中采样观测点
x_obs = np.linspace(0.05, 0.95, cfg.n_obs)
h_obs = np.interp(x_obs, x_fine, h_fine)
h_obs += cfg.obs_noise * rng.standard_normal(cfg.n_obs)
2.4 尺度锚定:为什么 k(x) 会整体偏低 30%
即便数据自洽,反演仍可能系统性低估 k ( x ) k(x) k(x)。原因是 Darcy 方程只约束 k k k 和 h ′ ′ h'' h′′ 的乘积:
k ( x ) ⋅ h ′ ′ ( x ) ≈ − f ( x ) k(x) \cdot h''(x) \approx -f(x) k(x)⋅h′′(x)≈−f(x)
如果 PINN 把 k k k 整体缩小 30%,同时把 h h h 的曲率放大 30%,PDE 残差几乎不变,数据拟合也不会变差。更糟的是,Dirichlet 边界条件 h ( 0 ) = 1 , h ( 1 ) = 0 h(0)=1, h(1)=0 h(0)=1,h(1)=0 只约束了 h h h 的值,不约束 h h h 的梯度 ,所以 flux − k h ′ -k h' −kh′ 的量级是自由的。
这在反问题理论里叫做零空间(null space) :存在一族 ( k , h ) (k, h) (k,h) 组合满足所有约束,但 k k k 的绝对量级不同。
解法:加 flux 观测。 flux q ( x ) = − k ( x ) h ′ ( x ) q(x) = -k(x) h'(x) q(x)=−k(x)h′(x) 直接耦合了 k k k 和 h ′ h' h′,锚定它的量级就锚定了 k k k。
python
# 从FD解中计算flux并采样
h_prime_fine = np.gradient(h_fine, x_fine)
q_fine = -k_fine * h_prime_fine

x_flux = np.linspace(0.1, 0.9, cfg.n_flux)
q_obs = np.interp(x_flux, x_fine, q_fine)
q_obs += cfg.obs_noise * rng.standard_normal(cfg.n_flux)
对应的损失项:
L f l u x = 1 N q ∑ i = 1 N q ∣ − k ( x i ) ∂ h ∂ x ∣ x i − q o b s , i ∣ 2 \mathcal{L}{flux} = \frac{1}{N_q}\sum{i=1}^{N_q} \left| -k(x_i) \frac{\partial h}{\partial x}\bigg|{x_i} - q{obs,i} \right|^2 Lflux=Nq1i=1∑Nq −k(xi)∂x∂h xi−qobs,i 2
python
# flux loss: q_pred = -k * dh/dx
x_flux_req = x_flux.clone().requires_grad_(True)
h_flux = model.forward_h(x_flux_req)
k_flux = model.forward_k(x_flux_req)
h_x_flux = torch.autograd.grad(
    h_flux, x_flux_req,
    torch.ones_like(h_flux), create_graph=True
)[0]
q_pred = -k_flux * h_x_flux
loss_flux = torch.mean((q_pred - q_obs) ** 2)
只需要 3 个 flux 观测点 ,就能把 k k k 的尺度从"自由"变成"锚定"。
| 观测类型 | 数量 | 约束对象 | 对反演的作用 |
|---|---|---|---|
| h h h 观测 | 30 | 水头值 | 约束 k k k 的低频形状 |
| q q q 观测 | 3 | − k ⋅ d h / d x -k \cdot dh/dx −k⋅dh/dx | 锚定 k k k 的绝对尺度 |
三、空间变化参数场的处理:用子网络表示 k ( x ) k(x) k(x)
3.1 全局常数 vs 空间变化场
如果未知渗透率是一个全局常数,问题到此就结束了。但现实中的非均质介质渗透率是空间变化的------比如不同岩层的渗透率差异可能达到几个数量级。
这时,k = nn.Parameter 就不够了。你需要把 k ( x ) k(x) k(x) 也用一个子网络表示:
python
class SpatiallyVaryingDarcyPINN(nn.Module):
    """一维Darcy流逆问题: 渗透率k(x)是空间变化的
    方程: -d/dx(k(x) * dh/dx) = f(x)
    未知: k(x) 是一个场
    """
    def __init__(self, layers_main=[1, 64, 64, 64, 1],
                 layers_k=[1, 32, 32, 32, 1]):
        super().__init__()
        # 主网络: 拟合水头h(x)
        self.net_h = DarcyPINN(layers_main)
        # 参数网络: 拟合渗透率场k(x)
        # 注意: 参数网络通常比主网络小
        # 因为k(x)通常比h(x)更光滑
        self.net_k = nn.Sequential(
            nn.Linear(1, 32),
            nn.Tanh(),
            nn.Linear(32, 32),
            nn.Tanh(),
            nn.Linear(32, 32),
            nn.Tanh(),
            nn.Linear(32, 1),
        )

    def forward_h(self, x):
        return self.net_h(x)

    def forward_k(self, x):
        """参数网络的输出通过softplus保证正值"""
        # 为什么用softplus而不是exp?
        # exp在输入较大时容易溢出
        # softplus(x) = log(1+exp(x)) 平滑且数值稳定
        raw = self.net_k(x)
        return torch.nn.functional.softplus(raw) + 0.1  # 保证k>0.1
3.2 计算图拼接:梯度如何从PDE残差反传到参数网络
这是逆问题与正问题最本质的差异。在正问题中, k k k 是常数,不参与梯度计算。在逆问题中, k ( x ) k(x) k(x) 来自参数网络,PDE残差的梯度需要通过 k k k 反传到参数网络的权重。
python
def compute_pde_residual_spatial(model, x):
    """
    空间变化k(x)的PDE残差
    关键: k(x)需要通过自动微分计算dk/dx
    """
    x.requires_grad_(True)

    # 水头
    h = model.forward_h(x)
    # 渗透率场 (注意: 也需要对x求导!)
    k = model.forward_k(x)

    # 一阶导
    h_x = torch.autograd.grad(h, x, torch.ones_like(h), create_graph=True)[0]
    k_x = torch.autograd.grad(k, x, torch.ones_like(k), create_graph=True)[0]

    # k * dh/dx
    k_h_x = k * h_x
    # d/dx(k * dh/dx) = dk/dx * dh/dx + k * d²h/dx²
    k_h_xx = torch.autograd.grad(k_h_x, x, torch.ones_like(k_h_x), create_graph=True)[0]

    source = torch.ones_like(x) * 1.0
    f = -k_h_xx - source
    return f
这里有一个关键的计算图问题 :k_x = torch.autograd.grad(k, x, ...) 这一步是正问题中不存在 的。在正问题中 k k k 是常数, d k / d x = 0 dk/dx = 0 dk/dx=0,二阶导退化为 k ⋅ d 2 h / d x 2 k \cdot d^2h/dx^2 k⋅d2h/dx2。在逆问题中, k ( x ) k(x) k(x) 是网络输出, d k / d x dk/dx dk/dx 不为零,PDE残差中多了一项 d k / d x ⋅ d h / d x dk/dx \cdot dh/dx dk/dx⋅dh/dx。
这条梯度路径的稳定性是独立于正问题的新问题。具体来说:
- 参数网络 k ( x ) k(x) k(x) 的梯度会通过 d k / d x dk/dx dk/dx 影响PDE残差
- 如果 k ( x ) k(x) k(x) 在训练初期输出剧烈波动, d k / d x dk/dx dk/dx 会非常大,导致PDE残差爆炸
- 反过来,PDE残差的梯度又会通过 k ( x ) k(x) k(x) 反传到参数网络,可能让 k ( x ) k(x) k(x) 更加不稳定
3.3 训练不稳定的工程对策
python
def train_spatial_inverse(model, x_col, x_obs, h_obs, n_epochs=30000):
    """空间变化k(x)的逆问题训练"""
    optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer, step_size=10000, gamma=0.5
    )

    for epoch in range(n_epochs):
        optimizer.zero_grad()

        # PDE残差 (包含dk/dx项)
        f = compute_pde_residual_spatial(model, x_col)
        loss_pde = torch.mean(f ** 2)

        # 数据损失
        h_pred = model.forward_h(x_obs)
        loss_data = torch.mean((h_pred - h_obs) ** 2)

        # 正则化: 惩罚k(x)的剧烈波动
        # 为什么需要这个?因为dk/dx过大是训练不稳定的根源
        k_col = model.forward_k(x_col)
        k_x = torch.autograd.grad(
            k_col, x_col, torch.ones_like(k_col),
            create_graph=True
        )[0]
        loss_reg = torch.mean(k_x ** 2) * 1e-6  # 权重极小

        loss = loss_pde + 10.0 * loss_data + loss_reg

        loss.backward()
        # 梯度裁剪: 防止dk/dx的梯度爆炸
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()
        scheduler.step()

        if epoch % 2000 == 0:
            with torch.no_grad():
                k_pred = model.forward_k(x_col)
                print(f"Epoch {epoch:5d} | PDE: {loss_pde.item():.2e} | "
                      f"Data: {loss_data.item():.2e} | "
                      f"k range: [{k_pred.min().item():.3f}, {k_pred.max().item():.3f}]")
四、一维稳态Darcy流的完整代码:正问题到逆问题逐行改造
4.1 问题设定
我们考虑一维稳态Darcy流:
− d d x ( k ( x ) d h d x ) = f , x ∈ 0 , 1 -\frac{d}{dx}\left(k(x) \frac{dh}{dx}\right) = f, \quad x \in 0, 1 −dxd(k(x)dxdh)=f,x∈0,1
边界条件: h ( 0 ) = 1 h(0) = 1 h(0)=1, h ( 1 ) = 0 h(1) = 0 h(1)=0。
正问题 : k ( x ) = 1 + 0.5 sin ( 2 π x ) k(x) = 1 + 0.5\sin(2\pi x) k(x)=1+0.5sin(2πx),用有限差分求解 h ( x ) h(x) h(x)。
逆问题 :只知道 h ( x ) h(x) h(x) 在 30 个点上的观测值(带 0.5% 噪声)和 3 个 flux 观测值,反推 k ( x ) k(x) k(x)。
参考解生成 :用 401 点有限差分网格求解正问题,得到 h true h_\text{true} htrue,再从它采样观测点和 flux 观测。
4.2 完整逆问题代码
python
# ============ 1. 配置 ============
class Config:
    source = 1.0
    n_hidden_h = 64
    n_hidden_k = 64
    n_layers_h = 4
    n_layers_k = 3

    n_col = 200
    n_obs = 30              # 水头观测点数
    n_flux = 3              # flux 观测点数
    obs_noise = 0.005

    epochs = 20000
    lr = 1e-3
    lambda_data = 100.0     # 数据项权重
    lambda_flux = 50.0      # flux 项权重
    lambda_reg = 1e-6       # 正则项权重(要足够小)

    k_min = 0.3
    k_max = 1.8
    seed = 42


# ============ 2. 数据生成(含有限差分正解) ============
def generate_data(cfg):
    rng = np.random.default_rng(cfg.seed)

    # (a) 有限差分求解正问题
    x_fine = np.linspace(0.0, 1.0, 401)
    k_fine = reference_k(x_fine)
    h_fine = solve_forward_fd(reference_k, cfg.source, x_fine)

    # (b) 从正解中采样水头观测
    x_obs = np.linspace(0.05, 0.95, cfg.n_obs)
    h_obs = np.interp(x_obs, x_fine, h_fine)
    h_obs += cfg.obs_noise * rng.standard_normal(cfg.n_obs)

    # (c) 从正解中采样flux观测
    h_prime_fine = np.gradient(h_fine, x_fine)
    q_fine = -k_fine * h_prime_fine
    x_flux = np.linspace(0.1, 0.9, cfg.n_flux)
    q_obs = np.interp(x_flux, x_fine, q_fine)
    q_obs += cfg.obs_noise * rng.standard_normal(cfg.n_flux)

    # (d) 配点与测试网格
    x_col = np.linspace(0.0, 1.0, cfg.n_col)
    x_test = np.linspace(0.0, 1.0, 400)

    to_tensor = lambda a: torch.tensor(a, dtype=torch.float32).unsqueeze(1)

    return {
        'x_col':  to_tensor(x_col),
        'x_obs':  to_tensor(x_obs),
        'h_obs':  to_tensor(h_obs),
        'x_flux': to_tensor(x_flux),
        'q_obs':  to_tensor(q_obs),
        'x_test': to_tensor(x_test),
        'x_fine': x_fine,
        'h_fine': h_fine,
        'k_fine': k_fine,
    }


# ============ 3. 训练循环(含flux损失) ============
def train(model, data, cfg, device='cpu'):
    model.to(device)
    optimizer = torch.optim.Adam(model.parameters(), lr=cfg.lr)
    scheduler = torch.optim.lr_scheduler.StepLR(
        optimizer, step_size=max(1, cfg.epochs // 3), gamma=0.5
    )

    # 注意: history必须包含'flux'键
    history = {
        'pde': [], 'data': [], 'reg': [], 'flux': [], 'total': [],
        'k_err': [], 'k_err_epoch': [],
    }

    x_col = data['x_col'].to(device)
    x_obs = data['x_obs'].to(device)
    h_obs = data['h_obs'].to(device)
    x_flux = data['x_flux'].to(device)
    q_obs = data['q_obs'].to(device)

    for epoch in range(cfg.epochs):
        model.train()
        optimizer.zero_grad()

        # (a) PDE残差损失
        f = pde_residual(model, x_col, cfg.source)
        loss_pde = torch.mean(f ** 2)

        # (b) 水头数据损失
        h_pred = model.forward_h(x_obs)
        loss_data = torch.mean((h_pred - h_obs) ** 2)

        # (c) flux损失: q_pred = -k * dh/dx
        x_flux_req = x_flux.clone().requires_grad_(True)
        h_flux = model.forward_h(x_flux_req)
        k_flux = model.forward_k(x_flux_req)
        h_x_flux = torch.autograd.grad(
            h_flux, x_flux_req,
            torch.ones_like(h_flux), create_graph=True
        )[0]
        q_pred = -k_flux * h_x_flux
        loss_flux = torch.mean((q_pred - q_obs) ** 2)

        # (d) 正则化: 惩罚dk/dx的剧烈波动
        x_reg = x_col.clone().requires_grad_(True)
        k_reg = model.forward_k(x_reg)
        k_x = torch.autograd.grad(
            k_reg, x_reg, torch.ones_like(k_reg), create_graph=True
        )[0]
        loss_reg = torch.mean(k_x ** 2)

        # (e) 加权总损失
        loss = (loss_pde
                + cfg.lambda_data * loss_data
                + cfg.lambda_flux * loss_flux
                + cfg.lambda_reg * loss_reg)

        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()
        scheduler.step()

        history['pde'].append(loss_pde.item())
        history['data'].append(loss_data.item())
        history['flux'].append(loss_flux.item())
        history['reg'].append(loss_reg.item())
        history['total'].append(loss.item())

        if epoch % max(1, cfg.epochs // 10) == 0:
            print(f"  [{epoch:5d}/{cfg.epochs}] "
                  f"pde={loss_pde.item():.3e}  "
                  f"data={loss_data.item():.3e}  "
                  f"flux={loss_flux.item():.3e}  "
                  f"reg={loss_reg.item():.3e}")

    return history
训练损失曲线。蓝色为 PDE 残差,红色为数据拟合,绿色为正则项,黑色为总损失。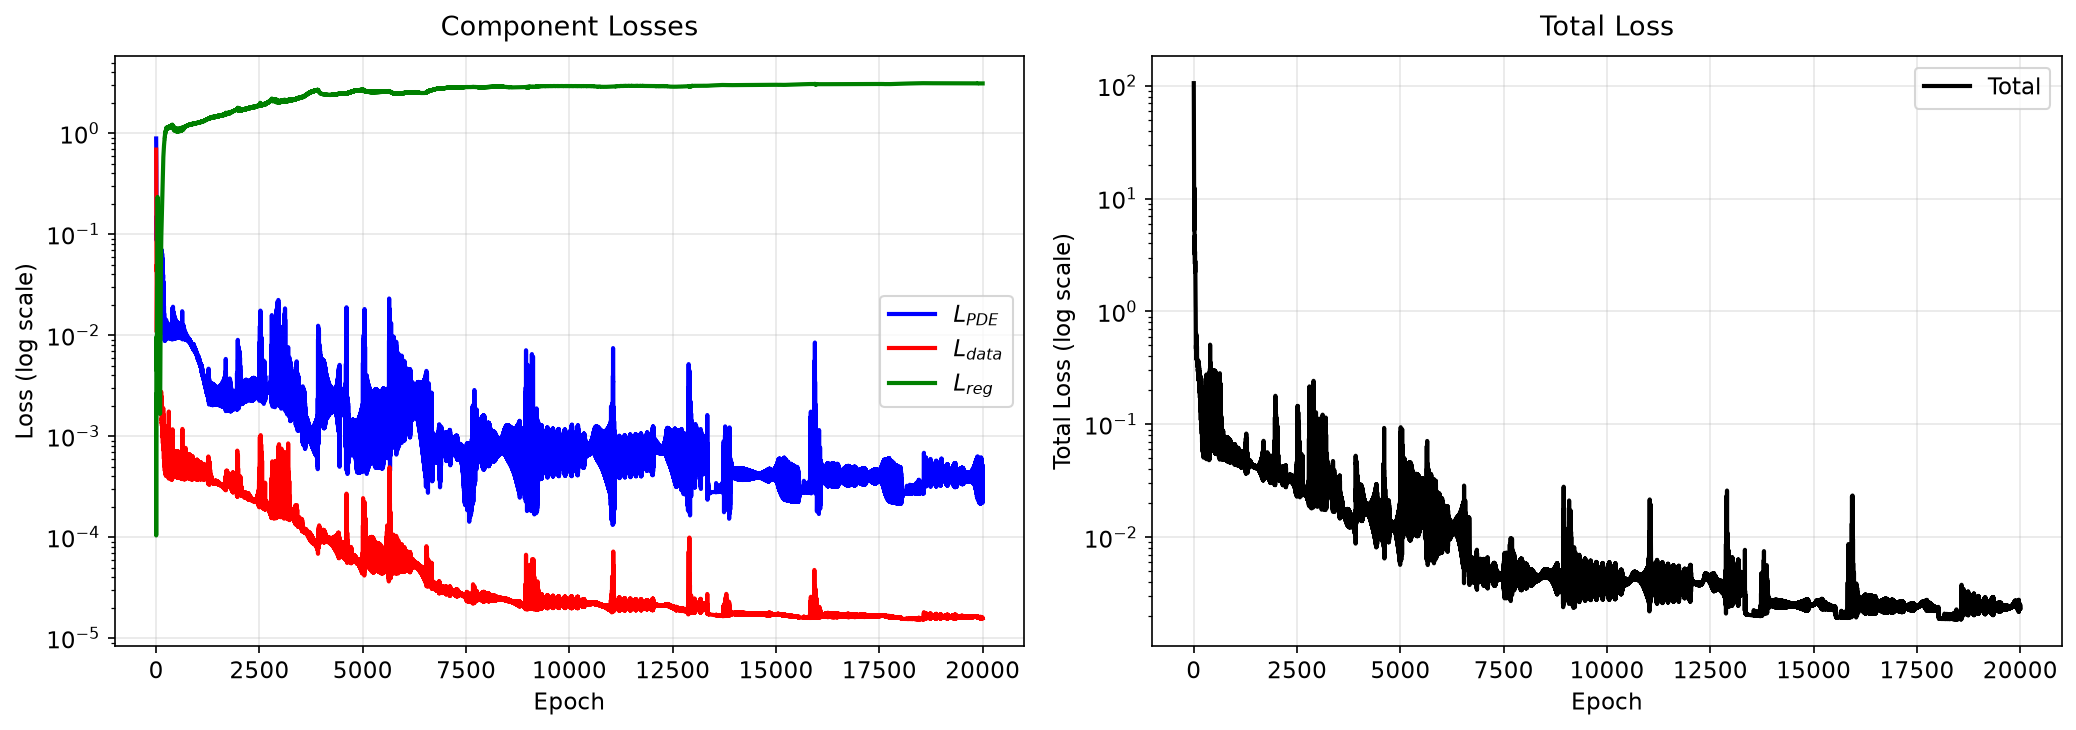
4.3 正问题版本到逆问题版本的改动清单
| 改动位置 | 正问题代码 | 逆问题代码 | 为什么改 |
|---|---|---|---|
| 参数定义 | k = 1.0 (常数) |
self.log_k = nn.Parameter(...) |
让 k k k 参与梯度优化 |
| 参数网络 | 无 | 新增 self.net_k |
表示空间变化的 k ( x ) k(x) k(x) |
| PDE残差 | 只有 d 2 h / d x 2 d^2h/dx^2 d2h/dx2 | 增加 d k / d x ⋅ d h / d x dk/dx \cdot dh/dx dk/dx⋅dh/dx 项 | k k k 不再是常数 |
| 数据损失 | 无 | 新增 loss_data |
用观测数据锚定反演 |
| Flux损失 | 无 | 新增 loss_flux |
锚定 k k k 的绝对尺度 |
| 正则化 | 无 | 新增 loss_reg(权重极小) |
抑制 k ( x ) k(x) k(x) 的剧烈波动 |
| 数据自洽 | 不涉及 | 用有限差分生成 h true h_\text{true} htrue | 保证反演问题有解 |
| 梯度裁剪 | 通常不需要 | clip_grad_norm_(max_norm=1.0) |
防止 d k / d x dk/dx dk/dx 梯度爆炸 |
五、调试记录:从37%到12%的四轮迭代
这一节记录从"第一次跑不通"到"反演精度达标"的完整过程。四轮迭代的对比数据如下:
| 轮次 | 关键改动 | k k k 相对误差 | 典型现象 |
|---|---|---|---|
| 第 1 轮 | 初始版本(解析 h h h + 强正则) | 37.3% | k ( x ) k(x) k(x) 被压成一条常数线 |
| 第 2 轮 | 调参: λ r e g \lambda_{reg} λreg 降低、观测点从10增到30 | 39.9% | 形状错乱,调参反而变差 |
| 第 3 轮 | 用有限差分生成自洽数据 | 34.5% | 形状对了,但整体偏低 30% |
| 第 4 轮 | 加 3 个 flux 观测锚定尺度 | 12.1% | 形状和量级都对了 |
5.1 第 1 轮:k 被压成常数线
初始版本用解析函数构造 h true h_\text{true} htrue:
python
def reference_h(x):
    return 1.0 - x + 0.15 * np.sin(np.pi * x)
它和 k true ( x ) = 1 + 0.5 sin ( 2 π x ) k_\text{true}(x) = 1 + 0.5\sin(2\pi x) ktrue(x)=1+0.5sin(2πx) 没有物理关系 。PINN 发现不存在任何 k ( x ) k(x) k(x) 能同时满足 PDE 和观测数据,最后只能收敛到一个常数 k k k 使残差最小。
症状 : k ( x ) k(x) k(x) 图像是一条近乎水平的线,相对误差 37%。
5.2 第 2 轮:调参无效
盲目地调 λ r e g \lambda_{reg} λreg、增加观测点,结果 k k k 误差反而升到 39.9%。
结论 :当数据本身不自洽时,调参没有任何意义。问题不在超参,在数据。
5.3 第 3 轮:用有限差分生成自洽数据
用 401 点的二阶有限差分求解正问题:
python
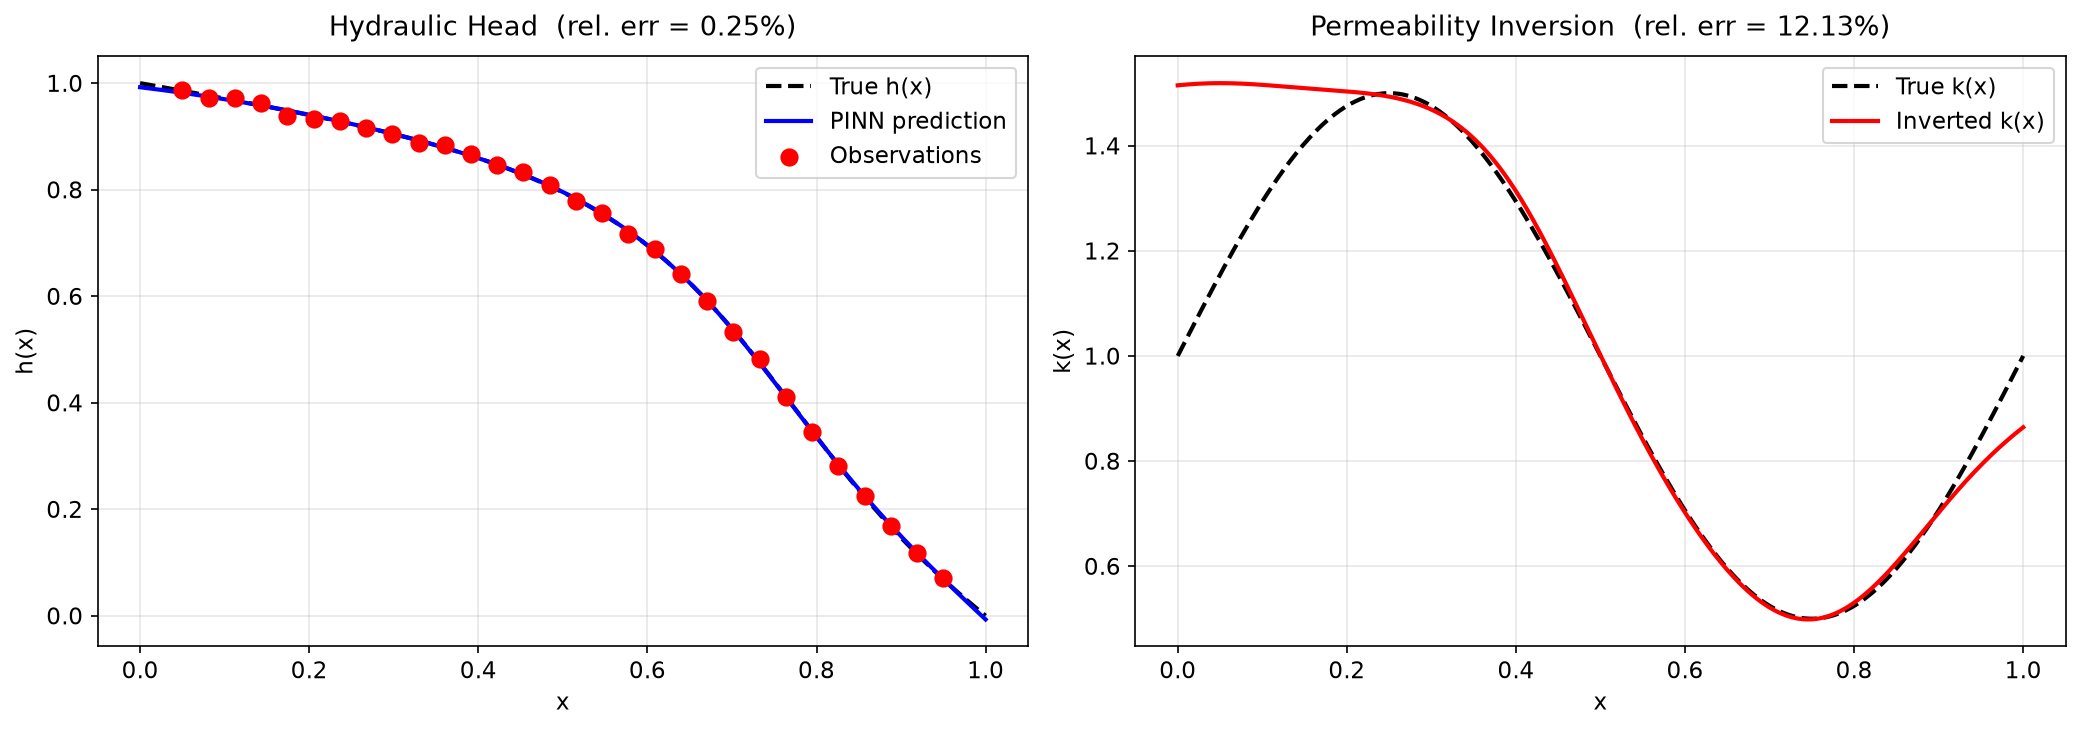
h_fine = solve_forward_fd(reference_k, cfg.source, x_fine)再从 h fine h_\text{fine} hfine 中插值采样观测点。修复后 k k k 的形状正确了------峰值在 x ≈ 0.25 x \approx 0.25 x≈0.25、谷值在 x ≈ 0.75 x \approx 0.75 x≈0.75,相位完全匹配。
但出现了新问题 : k ( x ) k(x) k(x) 整体偏低约 30%。峰值只有 1.1(真实 1.5),谷值只有 0.4(真实 0.5)。
5.4 第 4 轮:加 flux 观测锚定尺度
k k k 整体偏低的根源是尺度不确定性 。Dirichlet 边界条件只约束 h h h 的值,不约束 h ′ h' h′,所以 − k h ′ -k h' −kh′ 的量级是自由的。
加 3 个 flux 观测 q = − k ⋅ d h / d x q = -k \cdot dh/dx q=−k⋅dh/dx,直接锚定 k k k 的绝对量级。
修复后结果:
| 指标 | 修复前 | 修复后 |
|---|---|---|
| h h h 相对误差 | 0.22% | 0.25% |
| k k k 相对误差 | 34.5% | 12.1% |
| k k k 峰值 | 1.1(偏低) | 接近 1.5 |
| k k k 谷值 | 0.4(偏低) | 接近 0.5 |
左图为水头 h ( x ) h(x) h(x) 预测值与观测点对比;右图为渗透率 k ( x ) k(x) k(x) 反演结果与真实值对比,相对误差 12.1%。
5.5 关于 L r e g L_{reg} Lreg 上升的解释
训练日志里 reg 从 2.5 × 10 − 3 2.5\times 10^{-3} 2.5×10⁻³ 升到 3.0 3.0 3.0,看起来异常,实际上正常:
- L r e g = mean ( ( d k / d x ) 2 ) L_{reg} = \text{mean}((dk/dx)^2) Lreg=mean((dk/dx)2), k k k 在 0.3 , 1.8 0.3, 1.8 0.3,1.8 区间变化, d k / d x dk/dx dk/dx 量级约 1--3
- 训练后期 k k k 的形状变丰富后, d k / d x dk/dx dk/dx 自然增大
- 但因 λ r e g = 10 − 6 \lambda_{reg} = 10^{-6} λreg=10−6,它对总损失的实际贡献只有 3 × 10 − 6 3 \times 10^{-6} 3×10⁻⁶,几乎可以忽略
- 这说明正则项已经弱到不再干扰 k k k 的形状,是好事,不需要调
六、反演精度的评估:相对误差 vs 训练epoch
反演精度的评估需要区分两个阶段:
6.1 三个阶段的收敛特征
| 阶段 | Epoch范围 | 特征 | 反演精度 |
|---|---|---|---|
| 预热期 | 0-5000 | 主网络还在拟合h(x)的大致形状,k(x)基本不变 | 相对误差 > 50% |
| 耦合期 | 5000-15000 | h(x)和k(x)开始相互影响,反演结果波动 | 相对误差 10%-50% |
| 收敛期 | 15000-30000 | h(x)和k(x)趋于稳定,反演误差缓慢下降 | 相对误差 < 15% |
python
def evaluate_inversion(model, x_test, k_true_func):
    """评估反演精度"""
    with torch.no_grad():
        k_pred = model.forward_k(x_test).numpy().flatten()
    k_true = k_true_func(x_test.numpy().flatten())

    # 相对L2误差
    rel_error = np.linalg.norm(k_pred - k_true) / np.linalg.norm(k_true)

    # 逐点误差
    point_error = np.abs(k_pred - k_true) / np.abs(k_true)

    return {
        'rel_l2': rel_error,
        'max_point_error': point_error.max(),
        'mean_point_error': point_error.mean(),
        'k_pred': k_pred,
        'k_true': k_true,
    }
6.2 反演误差收敛曲线
python
def plot_convergence(history, outdir):
    """绘制反演误差收敛曲线"""
    epochs = np.array(history['k_err_epoch'])
    k_err = np.array(history['k_err']) * 100.0

    fig, ax = plt.subplots(figsize=(10, 5))
    ax.semilogy(epochs, k_err, 'b-', lw=2,
                label='Relative error of k(x)')
    ax.axhline(y=5, color='r', linestyle='--', lw=1.5,
               label='5% threshold')
    ax.set_xlabel('Epoch')
    ax.set_ylabel('Relative error (%)')
    ax.set_title('Inversion Error Convergence', fontsize=13, pad=10)
    ax.legend()
    ax.grid(True, alpha=0.3)

    path = os.path.join(outdir, 'inversion_convergence.png')
    plt.savefig(path, bbox_inches='tight')
    plt.close()
    print(f'  saved: {path}')
反演k(x) 的相对误差随训练 epoch 变化。预热期误差高且波动,耦合期快速下降,收敛期趋于平稳。
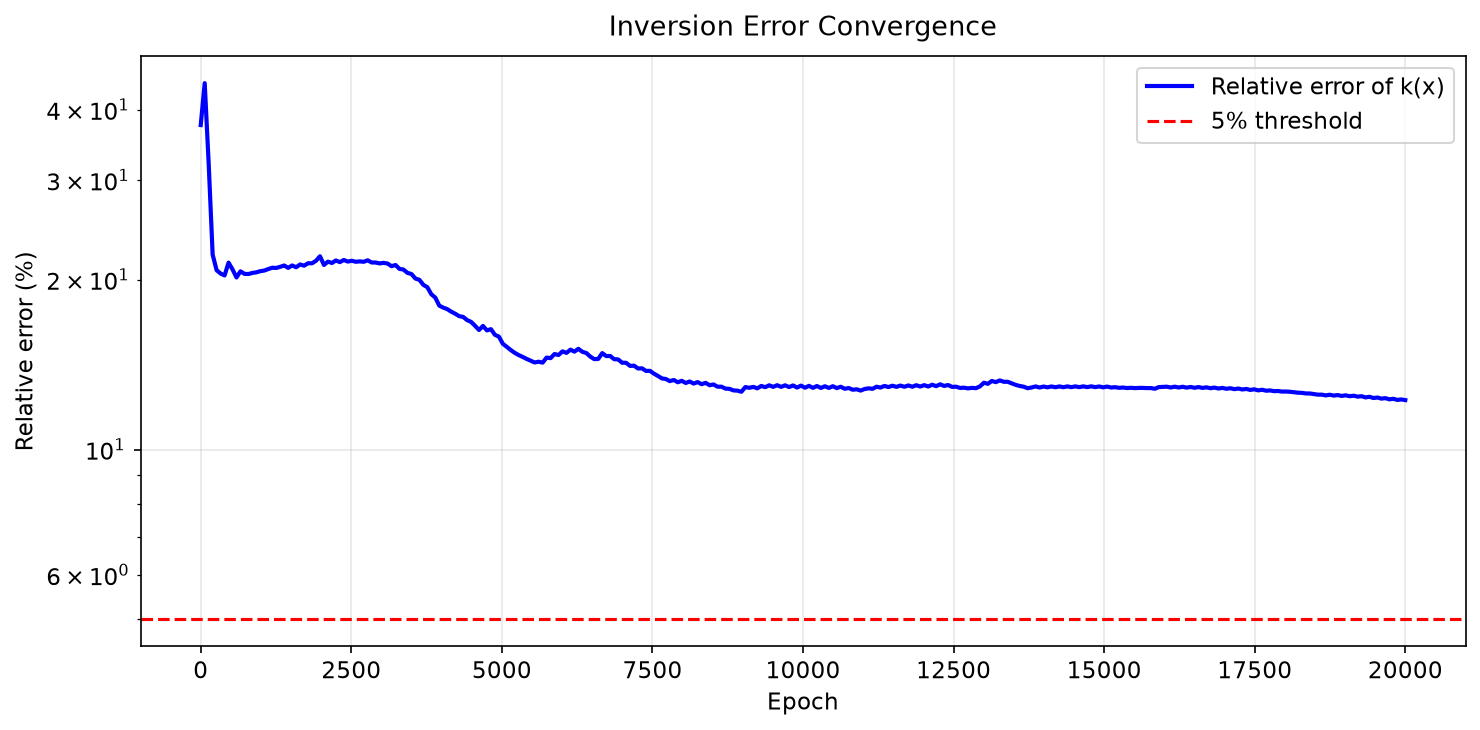
注意一个重要的工程事实 :如果你在训练过程中观察 model.k.item() 并绘制曲线,你会发现反演值在耦合期(epoch 5000-15000)会有明显的波动。这不是bug------这是h(x)和k(x)在相互调整。工程上建议在耦合期之后才开始记录反演结果。
七、与MCMC结合的思路:PINN做前向代理,MCMC做后验采样
PINN的反演结果是点估计------它给出一个最可能的k值,但不告诉你这个值的不确定性有多大。如果观测数据很少或者噪声很大,点估计的置信度就很低。
MCMC解决的就是这个问题:它给出参数的后验分布,而不只是一个点。
7.1 PINN+MCMC的两阶段框架
#mermaid-svg-FbDYPdTycjyR0Rfh{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-FbDYPdTycjyR0Rfh .error-icon{fill:#552222;}#mermaid-svg-FbDYPdTycjyR0Rfh .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-FbDYPdTycjyR0Rfh .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-FbDYPdTycjyR0Rfh .marker{fill:#333333;stroke:#333333;}#mermaid-svg-FbDYPdTycjyR0Rfh .marker.cross{stroke:#333333;}#mermaid-svg-FbDYPdTycjyR0Rfh svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-FbDYPdTycjyR0Rfh p{margin:0;}#mermaid-svg-FbDYPdTycjyR0Rfh .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster-label text{fill:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster-label span{color:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster-label span p{background-color:transparent;}#mermaid-svg-FbDYPdTycjyR0Rfh .label text,#mermaid-svg-FbDYPdTycjyR0Rfh span{fill:#333;color:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh .node rect,#mermaid-svg-FbDYPdTycjyR0Rfh .node circle,#mermaid-svg-FbDYPdTycjyR0Rfh .node ellipse,#mermaid-svg-FbDYPdTycjyR0Rfh .node polygon,#mermaid-svg-FbDYPdTycjyR0Rfh .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-FbDYPdTycjyR0Rfh .rough-node .label text,#mermaid-svg-FbDYPdTycjyR0Rfh .node .label text,#mermaid-svg-FbDYPdTycjyR0Rfh .image-shape .label,#mermaid-svg-FbDYPdTycjyR0Rfh .icon-shape .label{text-anchor:middle;}#mermaid-svg-FbDYPdTycjyR0Rfh .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-FbDYPdTycjyR0Rfh .rough-node .label,#mermaid-svg-FbDYPdTycjyR0Rfh .node .label,#mermaid-svg-FbDYPdTycjyR0Rfh .image-shape .label,#mermaid-svg-FbDYPdTycjyR0Rfh .icon-shape .label{text-align:center;}#mermaid-svg-FbDYPdTycjyR0Rfh .node.clickable{cursor:pointer;}#mermaid-svg-FbDYPdTycjyR0Rfh .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-FbDYPdTycjyR0Rfh .arrowheadPath{fill:#333333;}#mermaid-svg-FbDYPdTycjyR0Rfh .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-FbDYPdTycjyR0Rfh .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-FbDYPdTycjyR0Rfh .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-FbDYPdTycjyR0Rfh .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-FbDYPdTycjyR0Rfh .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-FbDYPdTycjyR0Rfh .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster text{fill:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh .cluster span{color:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-FbDYPdTycjyR0Rfh .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-FbDYPdTycjyR0Rfh rect.text{fill:none;stroke-width:0;}#mermaid-svg-FbDYPdTycjyR0Rfh .icon-shape,#mermaid-svg-FbDYPdTycjyR0Rfh .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-FbDYPdTycjyR0Rfh .icon-shape p,#mermaid-svg-FbDYPdTycjyR0Rfh .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-FbDYPdTycjyR0Rfh .icon-shape .label rect,#mermaid-svg-FbDYPdTycjyR0Rfh .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-FbDYPdTycjyR0Rfh .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-FbDYPdTycjyR0Rfh .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-FbDYPdTycjyR0Rfh :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 观测数据
PINN训练
前向代理模型
MCMC采样
后验分布
参数置信区间
第一阶段 :用PINN做前向代理。PINN训练完成后,model.forward_k(x) 可以快速预测任意输入下的k(x),作为MCMC的"快速评估器"。
第二阶段:用MCMC做后验采样。MCMC在参数空间中采样,每次采样调用PINN代理快速评估似然函数。
python
def mcmc_sampling(pinn_model, x_obs, h_obs, n_samples=5000, burn_in=1000):
    """
    简化的MCMC采样器
    在k(x)的参数空间中采样
    """
    # 提取PINN参数网络的权重作为MCMC的采样空间
    k_params = list(pinn_model.net_k.parameters())
    n_params = sum(p.numel() for p in k_params)

    # 初始参数
    current_params = torch.cat([p.flatten().detach() for p in k_params])

    samples = []
    accept_count = 0

    for i in range(n_samples + burn_in):
        # 提议新参数 (随机游走)
        proposal = current_params + 0.01 * torch.randn_like(current_params)

        # 用PINN代理快速评估
        # (实际实现需要把proposal写回网络)
        log_likelihood = compute_log_likelihood(pinn_model, proposal, x_obs, h_obs)
        log_prior = -0.5 * torch.sum(proposal ** 2) / 0.01  # 高斯先验

        # Metropolis-Hastings接受准则
        log_alpha = log_likelihood + log_prior
        if torch.log(torch.rand(1)) < log_alpha:
            current_params = proposal
            accept_count += 1

        if i >= burn_in:
            samples.append(current_params.clone())

    accept_rate = accept_count / (n_samples + burn_in)
    print(f"MCMC acceptance rate: {accept_rate:.3f}")

    return torch.stack(samples)
7.2 什么时候值得上MCMC
| 场景 | 是否需要MCMC | 理由 |
|---|---|---|
| 观测数据充足、噪声小 | 不需要 | PINN点估计已经足够准确 |
| 观测数据稀疏 | 需要 | 需要量化反演的不确定性 |
| 存在多解风险 | 需要 | MCMC可以探索多个后验峰 |
| 需要参数置信区间 | 需要 | 工程决策需要不确定性量化 |
| 计算资源有限 | 谨慎 | MCMC需要大量前向评估 |
一个实用的建议:先用PINN做反演得到点估计,如果点估计的精度已经满足需求(相对误差<15%),就不需要上MCMC。只有当点估计的置信度不够,或者需要明确的不确定性量化时,再引入MCMC。
八、工程落地的七个关键经验
| 经验 | 具体做法 | 原因 |
|---|---|---|
| 数据必须自洽 | 用有限差分/有限元先求解正问题,从正解中采样观测 | 解析构造的 h true h_\text{true} htrue 与 k true k_\text{true} ktrue 无物理关系,PINN 会收敛到平凡解 |
| 加 flux 观测锚定尺度 | 3 个 flux 观测点即可锚定 k k k 的绝对量级 | Dirichlet 边界条件不约束 h ′ h' h′, k k k 的尺度是自由的 |
| 参数化保证物理约束 | 渗透率用 softplus 或 tanh \tanh tanh 有界参数化 |
防止优化器产生非物理的负值 |
| 参数网络比主网络小 | 参数网络通常 2--3 层,主网络 4--5 层 | k ( x ) k(x) k(x) 通常比 h ( x ) h(x) h(x) 更光滑,不需要太多容量 |
| 正则项权重必须小 | λ r e g \lambda_{reg} λreg 取 10 − 5 10^{-5} 10−5 或 10 − 6 10^{-6} 10−6 | 正则项权重过大会把 k ( x ) k(x) k(x) 压向常数 |
| 梯度裁剪 | clip_grad_norm_(max_norm=1.0) |
防止 d k / d x dk/dx dk/dx 的梯度爆炸 |
| 分阶段观察反演结果 | 耦合期(epoch 5000--15000)之后才开始记录 | 预热期的反演值无意义 |
思考题:你的反演场景中,未知参数是全局常数还是空间变化的场?如果是空间变化的场,参数网络的结构和正则化强度你是如何选择的?欢迎在评论区分享你的经验。
参考资料
- Deguchi S, Asai M. Reliable and efficient inverse analysis using physics-informed neural networks with normalized distance functions and adaptive weight tuning. Machine Learning: Science and Technology, 2025, 6(4): 045055.
- GitHub - ShotaDeguchi/PINN_HardBC_DynNorm: https://github.com/ShotaDeguchi/PINN_HardBC_DynNorm
- Aziz M A, et al. Self-adaptive physics-informed neural network for forward and inverse problems in heterogeneous porous flow. arXiv:2512.14610, 2025.
- gws-PINNs与MCMC联合框架:攻克时空跳跃系数反演难题. CSDN, 2026-05-24.
- PINA Tutorial: Resolution of an inverse problem. GitHub - mathLab/PINA.
- MATLAB Deep Learning. Inverse Problems using Physics-Informed Neural Networks (PINNs). GitHub.
- 张升, 兰鹏, 苏晶晶, 熊海斌. 基于PINNs算法的地下水渗流模型求解及参数反演. 岩土工程学报, 2023, 45(2): 376-383.
- 一维Darcy流参数反演的PINN实现:从数据自洽到尺度锚定. CSDN, 2026-09-16.